


欢迎来到啾啾的博客🐱。
>这是一个致力于构建完善的Java程序员知识体系的博客📚,记录学习的点滴,分享工作的思考、实用的技巧,偶尔也分享一些杂谈💬。
欢迎评论交流,感谢您的阅读😄。
官网文档
1.逻辑架构🌟
MySQL是分层架构,上下层通过API互通。在SQL被解析优化后,交由存储引擎进行SQL执行。
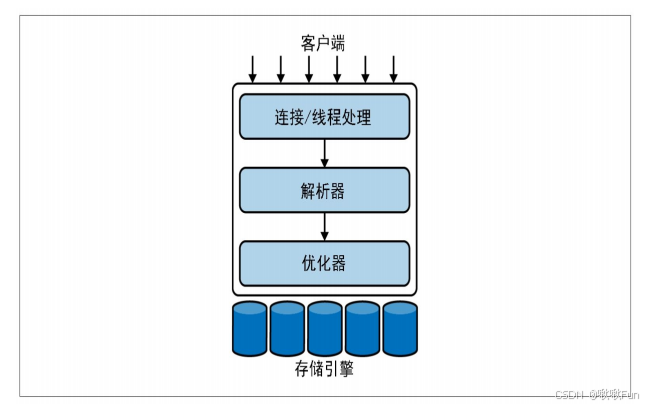
第一层:处理连接、身份校验等
第二层:SQL解析、优化、内置函数,跨存储引擎的功能实现:存储过程、触发器、视图等。
注:MySQL优化器使用的是基于成本的模型,而衡量成本得主要指标就是一个查询需要扫描多少行。
第三层:存储引擎层,数据的存储与获取。
InnoDB引擎
Mysql默认的引擎为InnoDB引擎。
InnoDB将数据存储在一系列的数据文件中,这些文件被统称为表空间tablespace。
使用MVCC来实现高并发性,默认可重复读REPEATABLE READ隔离级别,通过间隙锁next-key locking策略来防止RR级别的幻读:InnoDB不只锁定在查询中涉及的行,还会对索引结构中的间隙进行锁定,以防止幻行被插入。
数据存在形式以文件形式存在
-
InnoDB
存储的文件两钟 后缀名分别是 .frm 和 .idb
定义文件 和 数据文件
不动数据库引擎使用的编码不一样,数据存储文件和数据定义文件不一样
局部性原理:
一个数据被用到时,附近的数据也会被马上使用
2.数据结构🌟
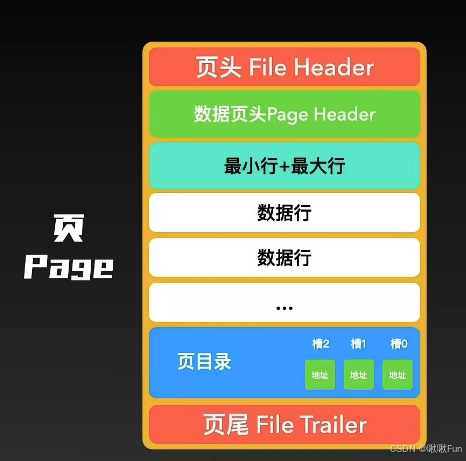
页结构
3.生命周期
查询大概的生命周期:客户端到服务器、服务器上进行语法解析、生成执行计划、执行、返回结果给客户端
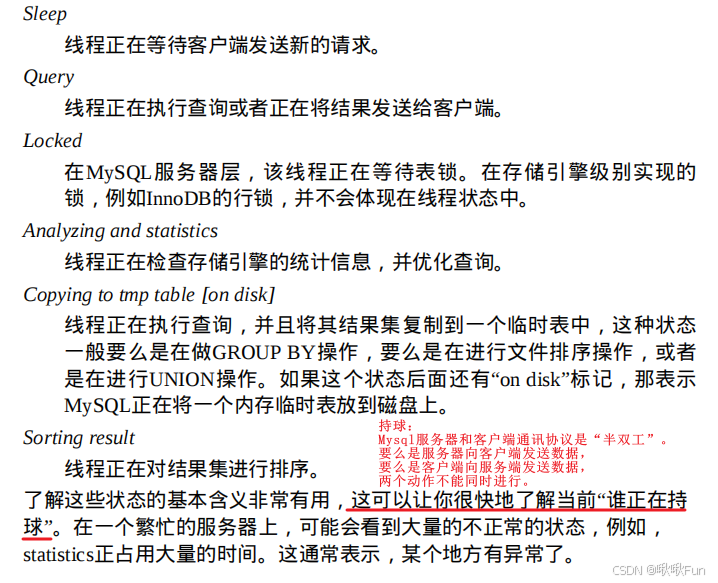
3.1 查询状态🌟
4.查询执行流程
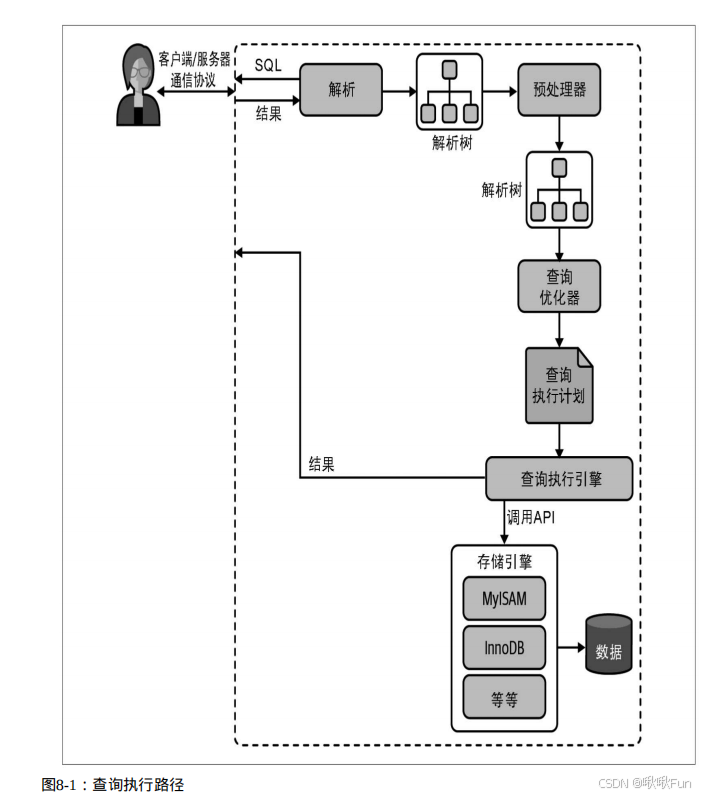
MySQL处理SQL语句的过程是一个复杂且精密的流程,它不仅涉及对SQL语句的基本解析与预处理,还包括查询优化、执行计划生成以及最终的SQL执行阶段。
4.1. 解析与预处理
当一条SQL语句被提交到MySQL时,首先会进入解析器阶段。解析器的主要任务是将SQL语句转换为可以被数据库引擎理解的形式。这一过程包括词法分析、语法分析和语义分析三个主要步骤。
-
词法分析:此阶段的功能是将输入的SQL字符串分解成一系列有意义的标记(tokens),这些标记构成了SQL语句的基本组成部分。
-
语法分析:根据SQL语法规则构建抽象语法树(Abstract Syntax Tree, AST)。如果SQL语句不符合MySQL的语法规则,则会在这一阶段抛出错误。
-
语义分析:检查SQL语句的正确性,例如表名、列名是否存在,确保没有歧义等。此外,还会验证用户是否有权限执行该操作。
接下来是预处理阶段,这里会对解析后的SQL树进行进一步的验证和调整。例如,检查表和列名是否真实存在,解决别名冲突等问题。预处理器还负责处理SQL语句中的参数化查询,允许使用占位符来代替具体的值,从而提高安全性和性能。
4.2. 查询优化器
经过解析与预处理后,SQL语句进入查询优化器阶段。查询优化器的目标是从众多可能的执行方案中选择一个成本最低的方案。为了实现这一目标,优化器需要考虑多个因素,如索引的选择、表之间的连接顺序、数据分布情况等。
-
索引选择:优化器评估不同索引的有效性,决定是否使用索引以及使用哪种类型的索引。
-
表连接顺序:在多表查询的情况下,确定以哪个表作为基准表,并定义表之间的连接顺序。
-
排序策略:如果查询涉及到排序操作,优化器会选择最有效的排序方法。
值得注意的是,MySQL使用基于成本模型的优化器(CBO),这意味着它会尝试估算每种可能执行路径的成本,并选择成本最低的那个。然而,由于计算所有可能组合的成本非常高昂,MySQL通过一些启发式规则限制了搜索空间,比如设置optimizer_prune_level和optimizer_search_depth参数来控制优化器探索的深度和广度。
4.3. 执行计划生成
一旦查询优化器完成了其工作,就会生成一份详细的执行计划。这份计划明确了如何具体执行SQL语句以获取结果,包括但不限于访问路径、连接方法、排序方式等方面的信息。执行计划通常是以一种内部数据结构的形式存在,只有通过特定工具如EXPLAIN命令才能查看其内容。
执行计划的质量直接影响到SQL语句的实际运行效率。因此,定期更新统计信息(如表大小、索引选择性等)对于保持执行计划的准确性非常重要。此外,还可以通过创建合适的索引来改善查询性能,或者利用优化器提示(Hints)指导优化器采用特定的执行策略。
4.4. 执行SQL
最后一步是按照生成的执行计划实际执行SQL语句。在此过程中,MySQL会调用存储引擎层提供的API来完成诸如读取数据、执行表连接、应用过滤条件等一系列操作。具体而言:
-
读取数据:根据执行计划中的指示,从磁盘或缓存中检索所需的数据行。
-
表连接:如果是多表查询,则依据执行计划指定的方式执行表间的连接操作。
-
排序与分组:如果有ORDER BY或GROUP BY子句,则需按要求对结果集进行排序或分组。
-
过滤数据:运用WHERE子句中的条件表达式筛选符合条件的数据记录。
在整个执行过程中,MySQL可能会遇到各种各样的挑战,比如锁争用、死锁检测、事务管理等。这些问题都需要妥善解决,以确保系统的稳定性和一致性。
综上所述,MySQL处理SQL语句的过程涵盖了从最初的解析到最后的结果返回等多个环节,每个环节都至关重要,共同决定了SQL查询的整体性能表现。
5.数据写入顺序🌟
MySQL 数据写入顺序是一个复杂的过程,涉及到多个日志和缓存机制的协调工作,以确保事务的ACID特性(原子性、一致性、隔离性和持久性)
5.1 写入 Undo Log,实现原子性的关键
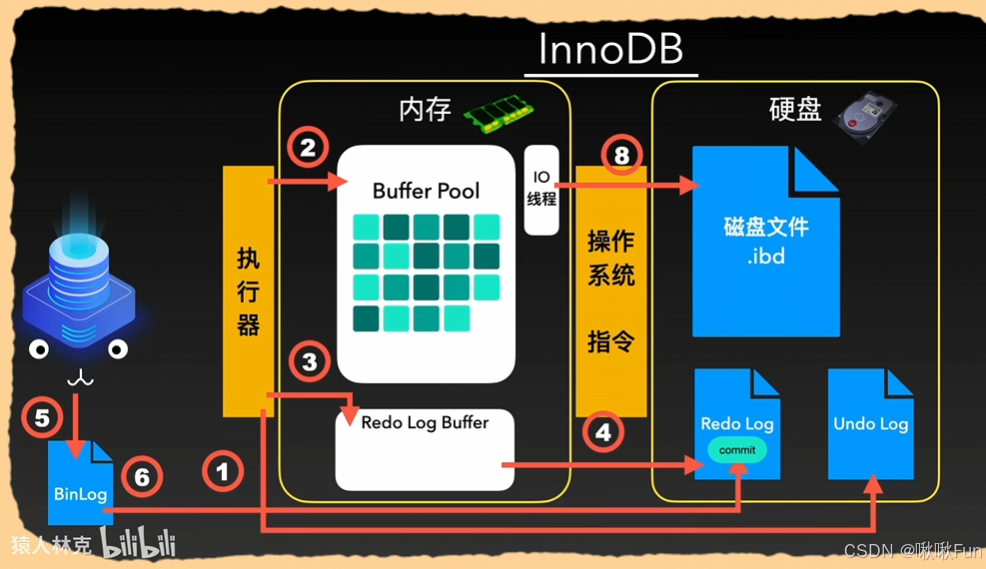
在 MySQL 中,当执行一个更新或插入操作时,首先会生成 Undo Log。这是为了支持事务的回滚操作,同时也是实现事务原子性(Atomicity)的关键部分。Undo Log 记录了数据修改前的状态,使得如果事务失败或者被显式回滚,数据库可以利用这些日志将数据恢复到修改之前的状态。
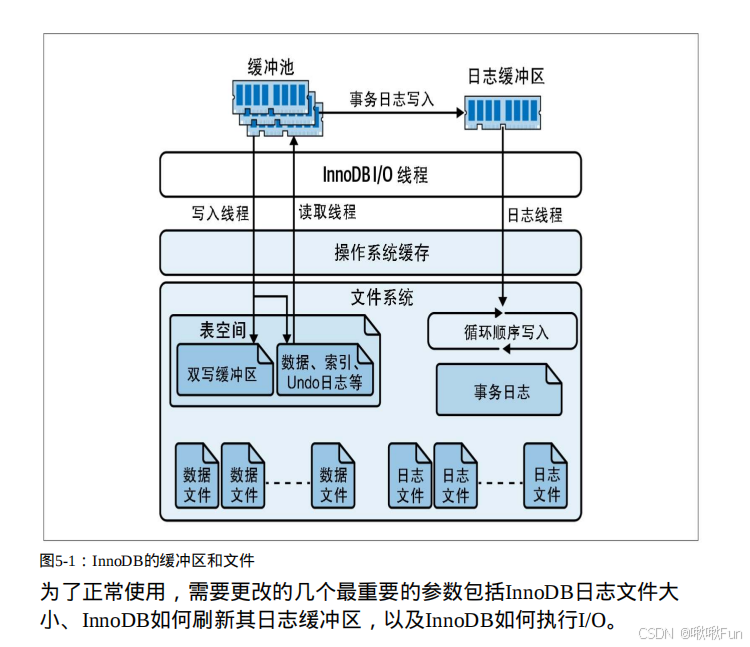
5.2 修改 Buffer Pool,配置innodb_flush_method=O_DIRECT 绕过OS缓存以减少文件系统缓存带来的额外开销
MySQL 将修改的数据页加载到 Buffer Pool 中。Buffer Pool 是 InnoDB 存储引擎用来缓存数据页的一个内存区域。所有对数据的实际修改都会先在这个内存区域中进行,而不是直接写入磁盘。这种设计极大地提高了读写性能,因为内存访问速度远高于磁盘访问速度。值得注意的是,此时的数据页被称为“脏页”(Dirty Page),意味着它们已经被修改但尚未写入磁盘。
通常情况下,MySQL 的写入操作会利用操作系统的页面缓存来提高效率,除非明确设置了 innodb_flush_method=O_DIRECT 参数以绕过 OS 缓存,O_DIRECT通常用于特定高性能需求场景下减少文件系统缓存带来的额外开销。
5.3 写入 Redo Log Buffer 并刷盘,实现持久性以确保数据一致性和完整性
为了保证事务的持久性(Durability),MySQL 还需要将更改记录到 Redo Log 中。Redo Log 是一种物理日志,它记录了对数据库的所有修改信息,MySQL重启后会从Redo Log中恢复数据。每次事务提交时,MySQL 都会将相关的 Redo Log 从 Redo Log Buffer 写入到磁盘上的 Redo Log 文件中。通过这种方式,即使系统发生故障,也可以通过 Redo Log 恢复未完成的事务,确保数据的一致性和完整性。
具体的刷盘策略由参数 innodb_flush_log_at_trx_commit 控制,它可以设置为 0、1 或 2,分别代表不同的安全性和性能权衡。例如,当该值设为 1 时,每次事务提交都会立即将 Redo Log 刷入磁盘,这是最安全但也可能是最慢的选择;而设置为 2 则允许一定的延迟,仅将日志写入 OS 缓存而非立即同步到磁盘上,从而提升性能但稍微降低了数据安全性。
5.4 Binlog 刷盘,用于主从复制、增量备份和数据恢复等
对于开启了二进制日志(Binlog)功能的 MySQL 实例来说,在完成上述步骤之后还需要处理 Binlog 的写入问题。Binlog 是一种逻辑日志,主要用于记录所有的 DDL 和 DML 操作,广泛应用于主从复制、增量备份及数据恢复等领域。与 Redo Log 不同,Binlog 是按事务顺序追加写入的,并且可以通过工具如 mysqlbinlog 查看其内容。
根据 sync_binlog 参数的不同配置,MySQL 可能会在每个事务提交后立刻将 Binlog 同步到磁盘,也可能累积一定数量后再统一执行 fsync 操作。这种灵活性让用户能够在性能与可靠性之间找到平衡点。
5.5 给事务打上 Commit 标签,标明事务结束,Redolog同步。用于重启后数据恢复
最后,在确认所有必要的日志都已经正确写入并持久化之后,MySQL 会给当前事务打上 Commit 标签。这意味着事务正式结束,其结果已经成为数据库状态的一部分。同时,这一状态也会被反映到相应的 Redo Log 中,以便在系统重启后能够准确地恢复已完成的事务记录。
综上所述,MySQL 的数据写入流程不仅包含了 Undo Log、Buffer Pool、Redo Log 和 Binlog 等多个组件之间的交互,还涉及到了多种参数调整的可能性,以满足不同应用场景下的性能与可靠性的需求。在整个过程中,MySQL 始终致力于保障事务的 ACID 特性,从而为用户提供稳定高效的服务体验。
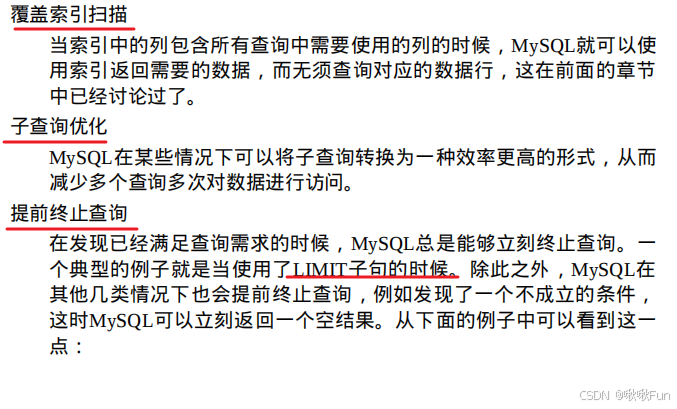
6.MySQL能处理的优化类型
7.MySQL查询优化器的局限性
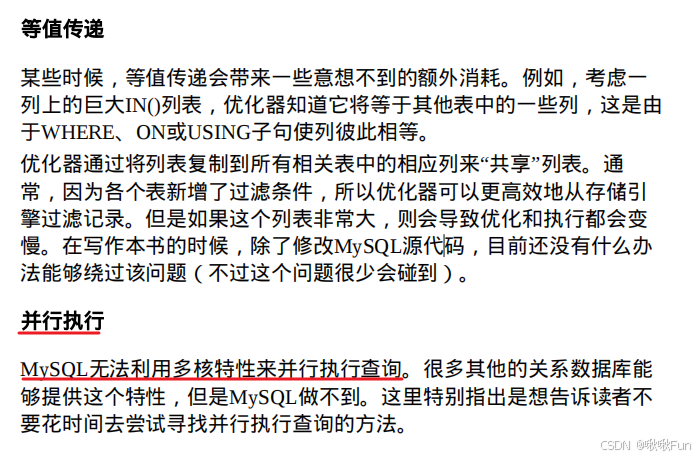
Oracle支持并行执行查询,原理是将大查询拆分成小查询分治,完成处理后合并最终结果集。
Oracle的并发技术具体来说,对于线程,Oracle有Leader和Worker,可以做到工作分配和协调;对于数据,Oracle将数据划分为多个片段,可以做到分治的前提即数据分片处理。
8.资料引用
B站《猿人林克》MySQL系列
《高性能MySQL》

 2662


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


