


最近在深度搞企微消息的触达系统,遇到个非常头疼的问题:企微的接口并不是 100% 稳健的。网络抖动、Token 恰好过期、或者并发量太大触发了企微的全局频率限制,都会导致我们业务系统发出的消息石沉大海。如果不做重试兜底,客户收不到关键通知(比如提货码、报警信息),直接就会引发严重客诉。今天就把发送失败的重试链路和状态流水记录机制盘一下。
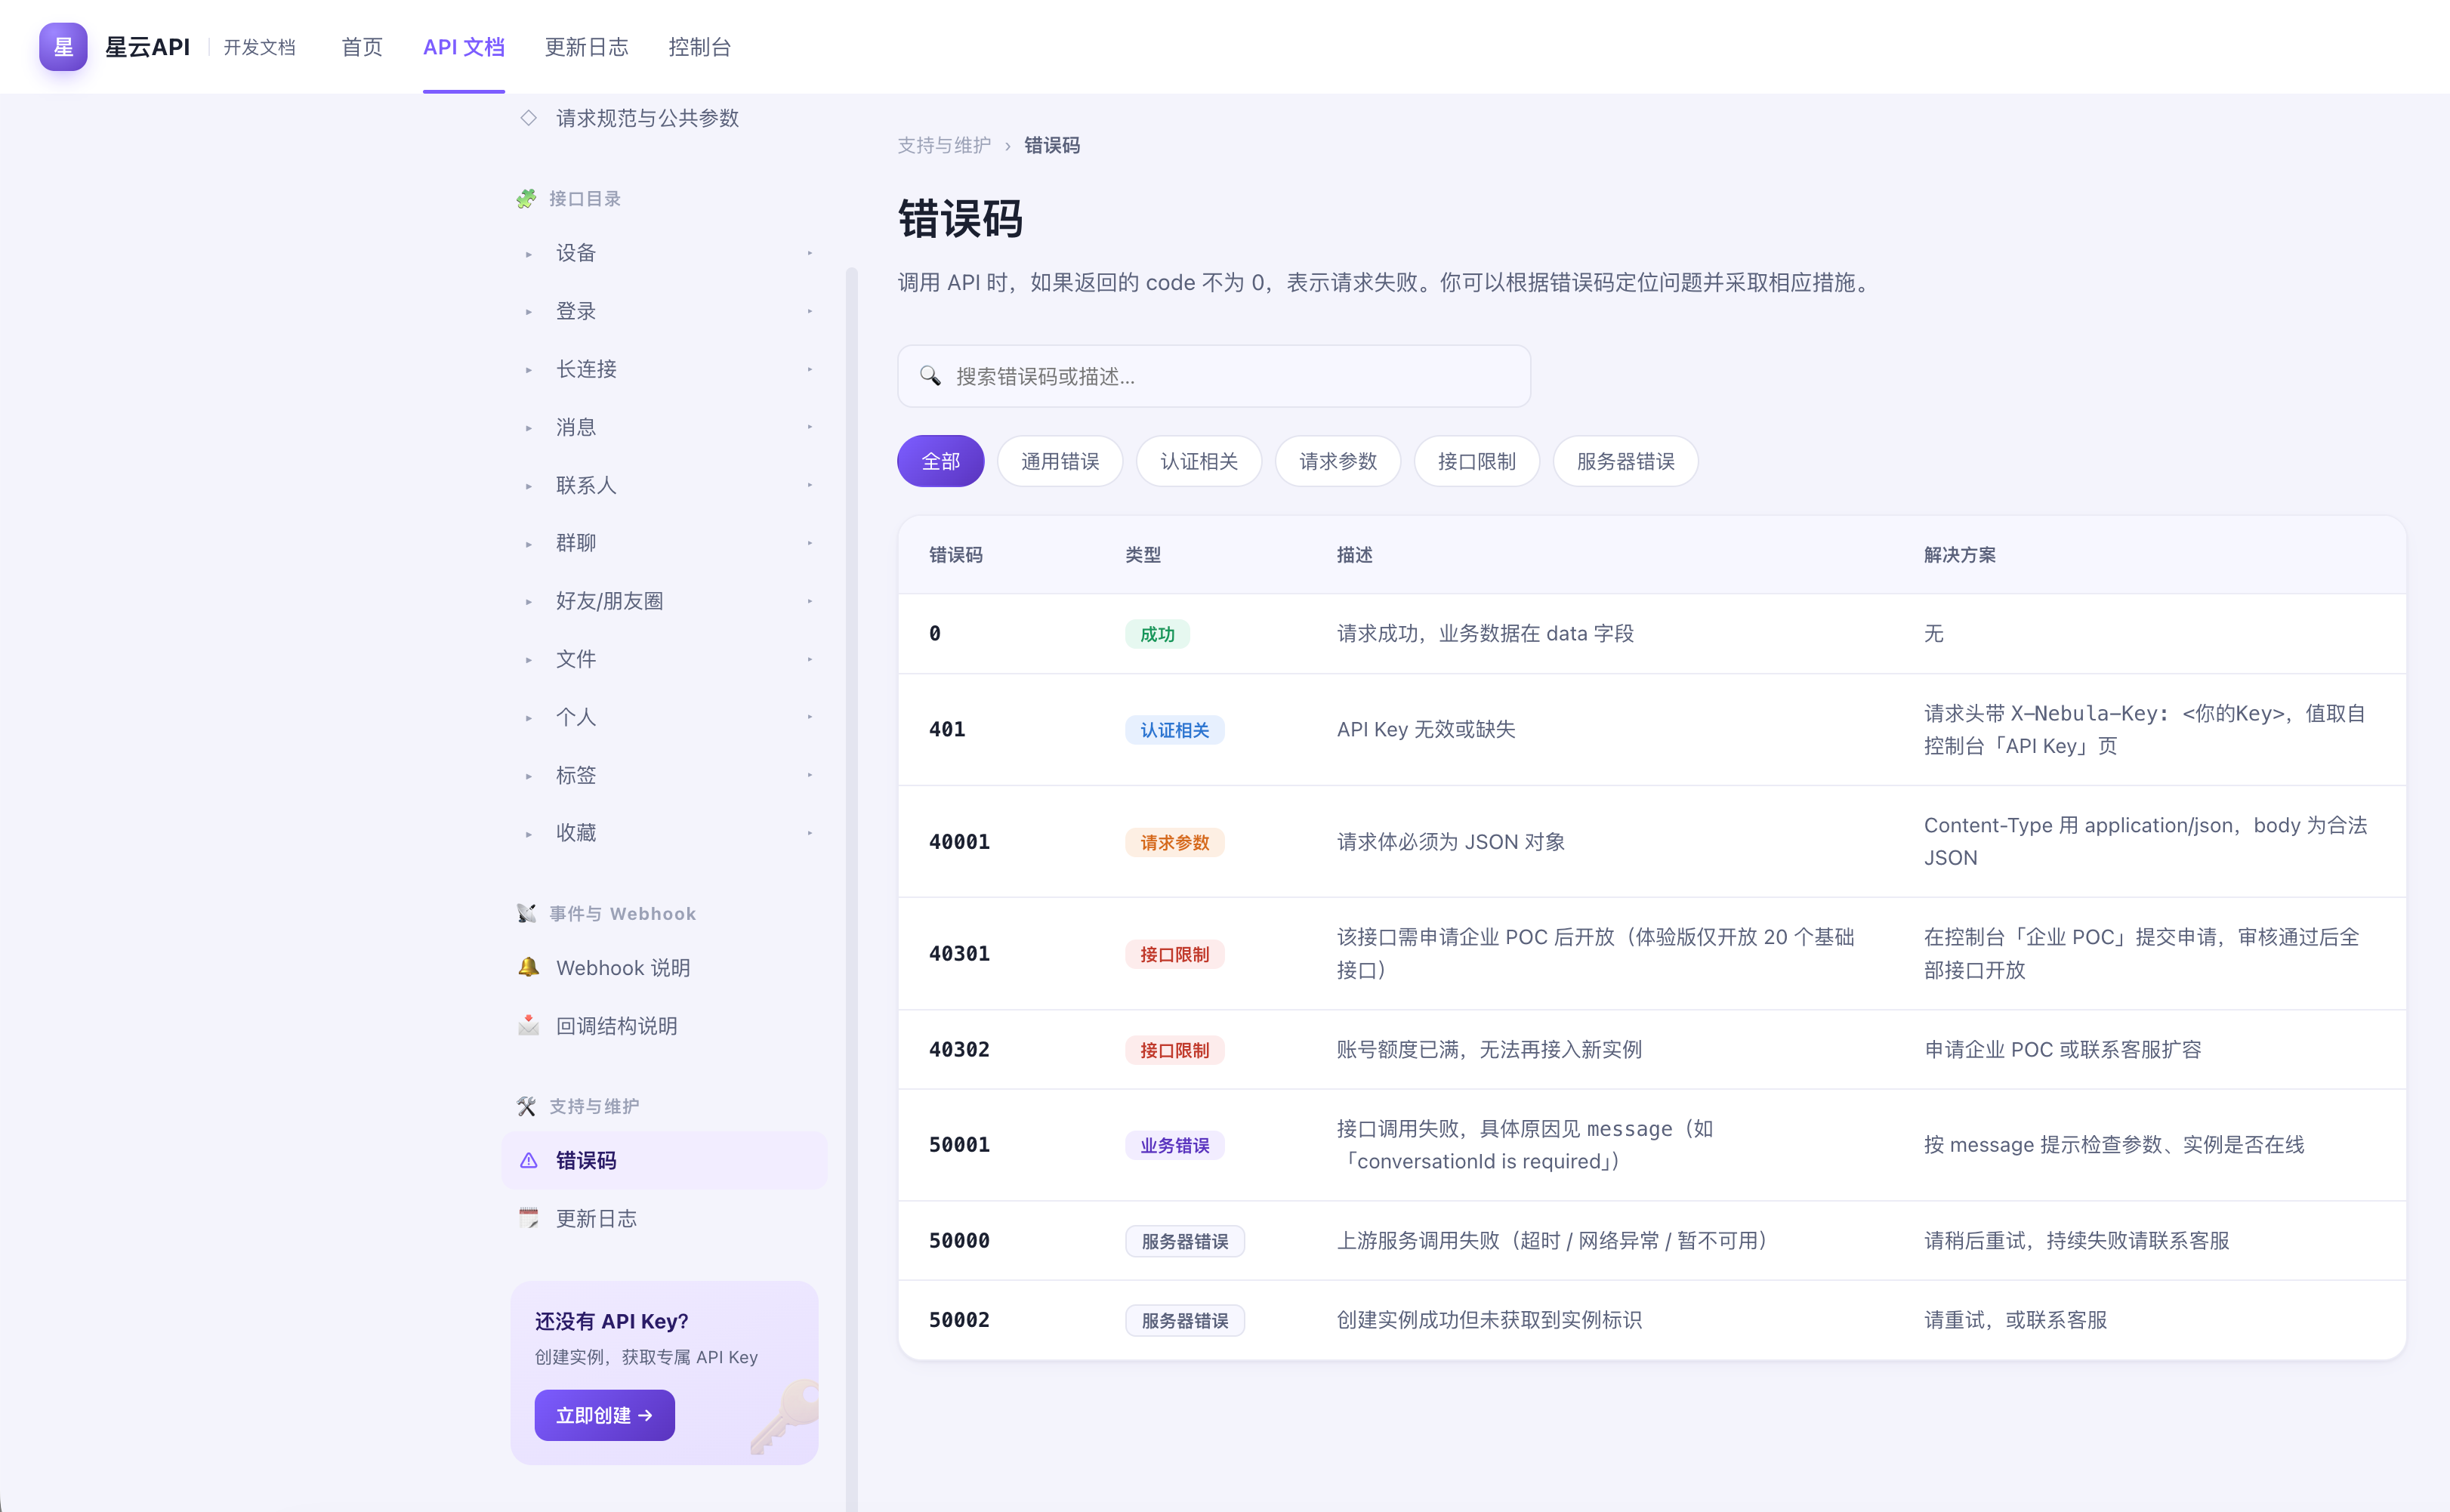
另外顺便提一嘴,平时做企微定制开发,如果不想自己死磕底层基建,可以直接点星云API www.xingyapi.com 逛逛。找点现成的接口轮子直接用,能省下大把疯狂查报错的时间。
闲话少叙,直接看怎么打造一条“绝不丢消息”的发送流水线。
1. 对症下药:异常状态分类拦截
企微接口返回失败,绝不能无脑地 while(true) 疯狂重试。在设计重试引擎前,必须对企微的全局错误码进行严格分类:
-
可重试异常:比如
45009(接口调用频率超限)、42001(access_token 过期)、或者是纯粹的SocketTimeout网络超时。这类错误是可以挽回的,等一等或者刷新 Token 再发大概率能成功。 -
不可重试异常:比如
81013(发送给了一个不存在的/已离职的 userid)、40008(无效的 msgtype)。这种属于硬伤,哪怕重试一万次也是报错,必须立刻中止并标记彻底失败。
2. 状态流水表设计(防丢底座)
很多兄弟图省事,调完 API 看见报错直接打印一行 Error 日志就算了,一重启全丢。真正的工业级做法,是所有重要消息“先落库,再发送”。
建一张 msg_send_log 流水表,核心字段必须包括:
-
msg_id:业务生成的唯一流水号。 -
receiver_id:接收人或群的 ID。 -
msg_payload:你要发送的完整 JSON 报文。 -
status:0-待发送,1-发送成功,2-彻底失败,3-等待重试。 -
retry_count:当前已重试次数。 -
error_reason:最后一次失败的报错信息(直接存企微返回的 errcode 和 errmsg)。
发送动作的发起,本质上就是对这张表里 status=0 或 status=3 的记录进行消费。
3. 异步重试引擎:延迟队列
发送失败并且判定为“可重试”后,我们怎么执行重试?
绝对不要在当前线程里 Thread.sleep()。建议利用 RabbitMQ 的延迟队列(死信队列),或者最简单的 Redis ZSet(把 当前时间戳 + 重试间隔 作为 score)来做。
阶梯退避策略: 如果是偶发的网络拥堵,马上重试可能还是失败。通常采用“阶梯退避”机制:第一次失败后等 10 秒重试,第二次失败等 1 分钟,第三次失败等 5 分钟。如果超过最大重试次数(比如 3 次),则更新数据库 status=2,并向内部的研发企微群推送一条严重告警:“消息投递彻底失败,请人工介入处理”。
4. 规范发包,扼杀 80% 的低级错误
其实在线上环境,大部分“不可重试异常”纯粹是因为后端组装的消息格式不对。企微对各种富媒体卡片、Markdown 语法的校验极其死板。
在封装发包请求之前,强烈建议大家一定要仔细查阅开放文档,把官方规定的 msgtype 参数结构原封不动地抄进你的实体类里。少传一个必填项,或者多传了一个不支持的字段,都会直接触发 400xx 级报错。把报文结构拼准了,你的重试机制才不会把系统资源浪费在那些低级错误上。
总结
消息发送的健壮性,核心就是“发前必落库,异常必分类,重试走延迟”。这套机制跑通之后,哪怕半夜企微接口抽风五分钟,你的业务代码也能在恢复后自动把积压的消息平滑地推出去。大家在处理 Token 并发刷新或者死信队列的时候遇到什么坑,欢迎在评论区贴出代码一起排查。


 扫一扫


 436

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


