


后端开发一个内部管理工具,难点往往不只在接口。表结构和业务逻辑有了,页面如何布局、表单如何交互、前后端字段如何对齐,依然需要花时间处理。尤其是一个人做项目时,写完 Java 代码距离“打开浏览器能用”,中间还有一段路。
这次我用飞算JavaAI的全栈功能,围绕一个具体需求做了一次实践:搭建本地运行的“团队工单处理平台”,用于登记和跟进团队内部的 IT 问题。流程从自然语言需求开始,先生成设计文档,确认设计后再生成前后端代码,最后查看本地运行结果。
先交代时间记录:**生成设计文档用时 10 分钟,生成前后端代码用时 22 分钟,两项合计 32 分钟。**这里统计的是上述两个阶段,不将插件安装、环境准备、完整业务验收和部署上线计入,也不据此推算相对传统开发的提效倍数。
一、为什么选团队工单平台?
我没有选择只有一张表、几个输入框的极简演示,而是给工单加入了状态流转和操作记录。它的页面不算复杂,但前后端必须对业务规则形成共同理解。
本次范围主要包括:
为了把重点放在这条流程上,我限定了项目边界:使用 Java 后端和本地数据库,处理人采用预置列表,本轮不做登录、角色权限、附件上传、邮件及即时消息集成。这是一个范围明确的本地原型,距离实际面向团队部署还有后续工作。
截图能确认的环境信息如下:
IDEA 中的相关版本:飞算 JavaAI 插件(3.9.15);IDEA (241.19416.15)。
二、先把需求说清楚,再让 AI 动手
第一轮输入中,我明确写了这样一句话:
请帮我设计一个可本地运行的“团队工单处理平台”,本轮仅生成设计文档,等待我确认后再生成代码。
这句话确定了第一阶段的产出。接下来再写项目范围、页面功能、业务规则、界面要求和设计文档要求,让后续生成有据可依。
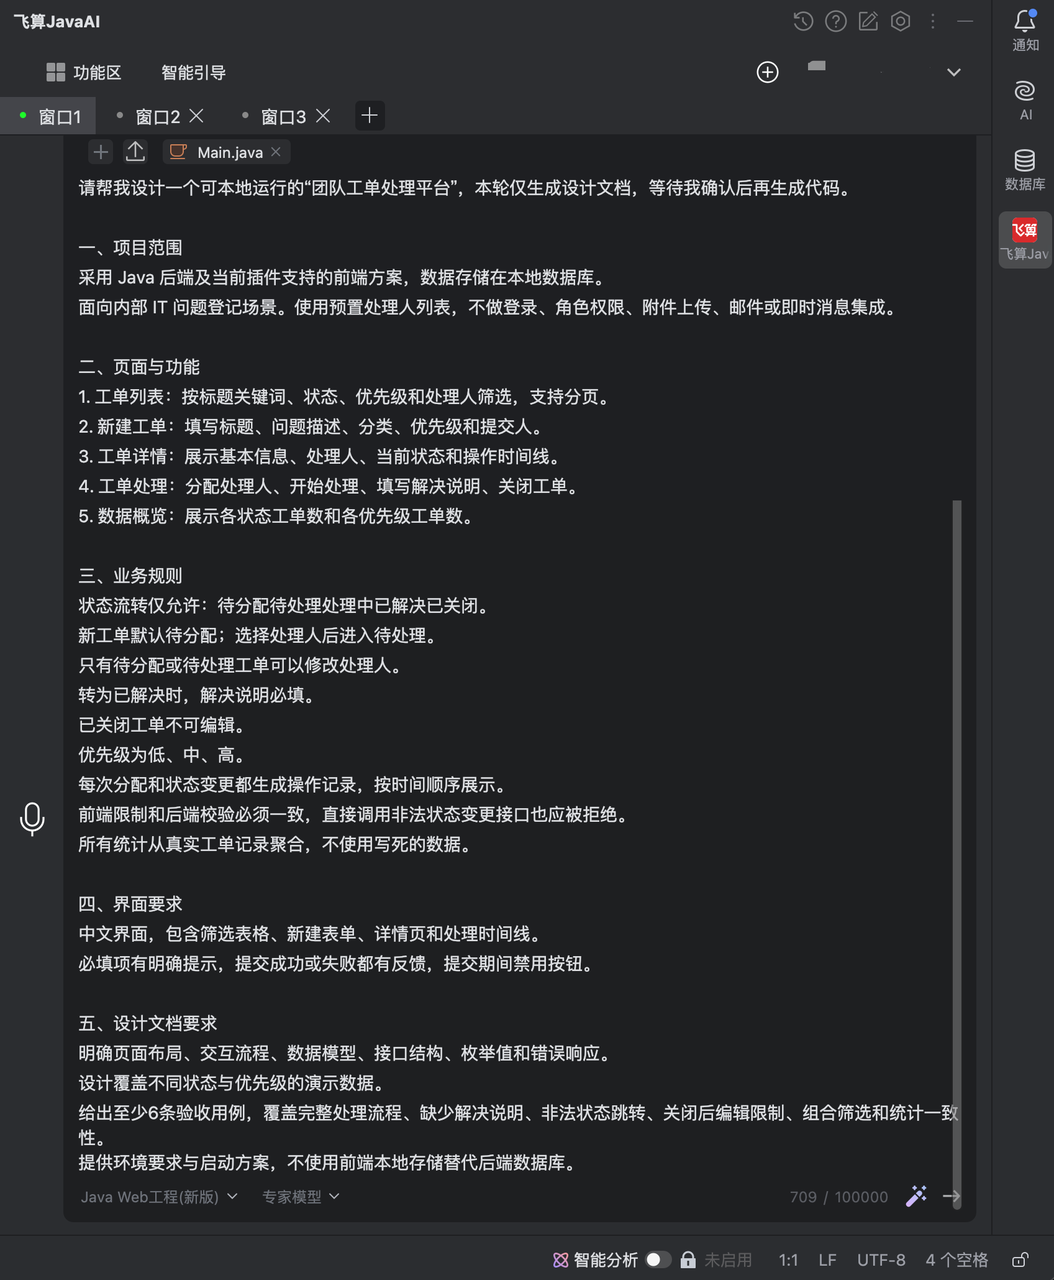
其中最重要的是状态规则。我要求工单沿着下面的路径推进:
待分配 → 待处理 → 处理中 → 已解决 → 已关闭
新工单默认“待分配”;选定处理人后进入“待处理”;只有待分配或待处理的工单可以修改处理人;转为已解决时,解决说明必填;已关闭工单不可编辑。每次分配和状态变化都要生成操作记录,并按时间顺序展示。
我还补充了两个容易被忽略的要求:前端限制和后端校验必须一致,直接调用非法状态变更接口也应被拒绝;统计数据要从实际工单记录聚合,不能用写死的数字填充页面。
这类限制比“帮我做一个好看的工单系统”更有用。按钮显示、接口校验、数据模型和验收用例,都可以围绕这些规则展开。
三、设计文档阶段:10 分钟,把需求变成可检查的方案
需求先被拆成 12 个关键点
进入生成流程后,飞算JavaAI把输入拆解成了 12 个关键点,包括处理人列表、创建和查询工单、分配处理人、状态流转、解决说明校验、关闭后编辑限制、操作记录、统计、枚举及演示数据初始化等。
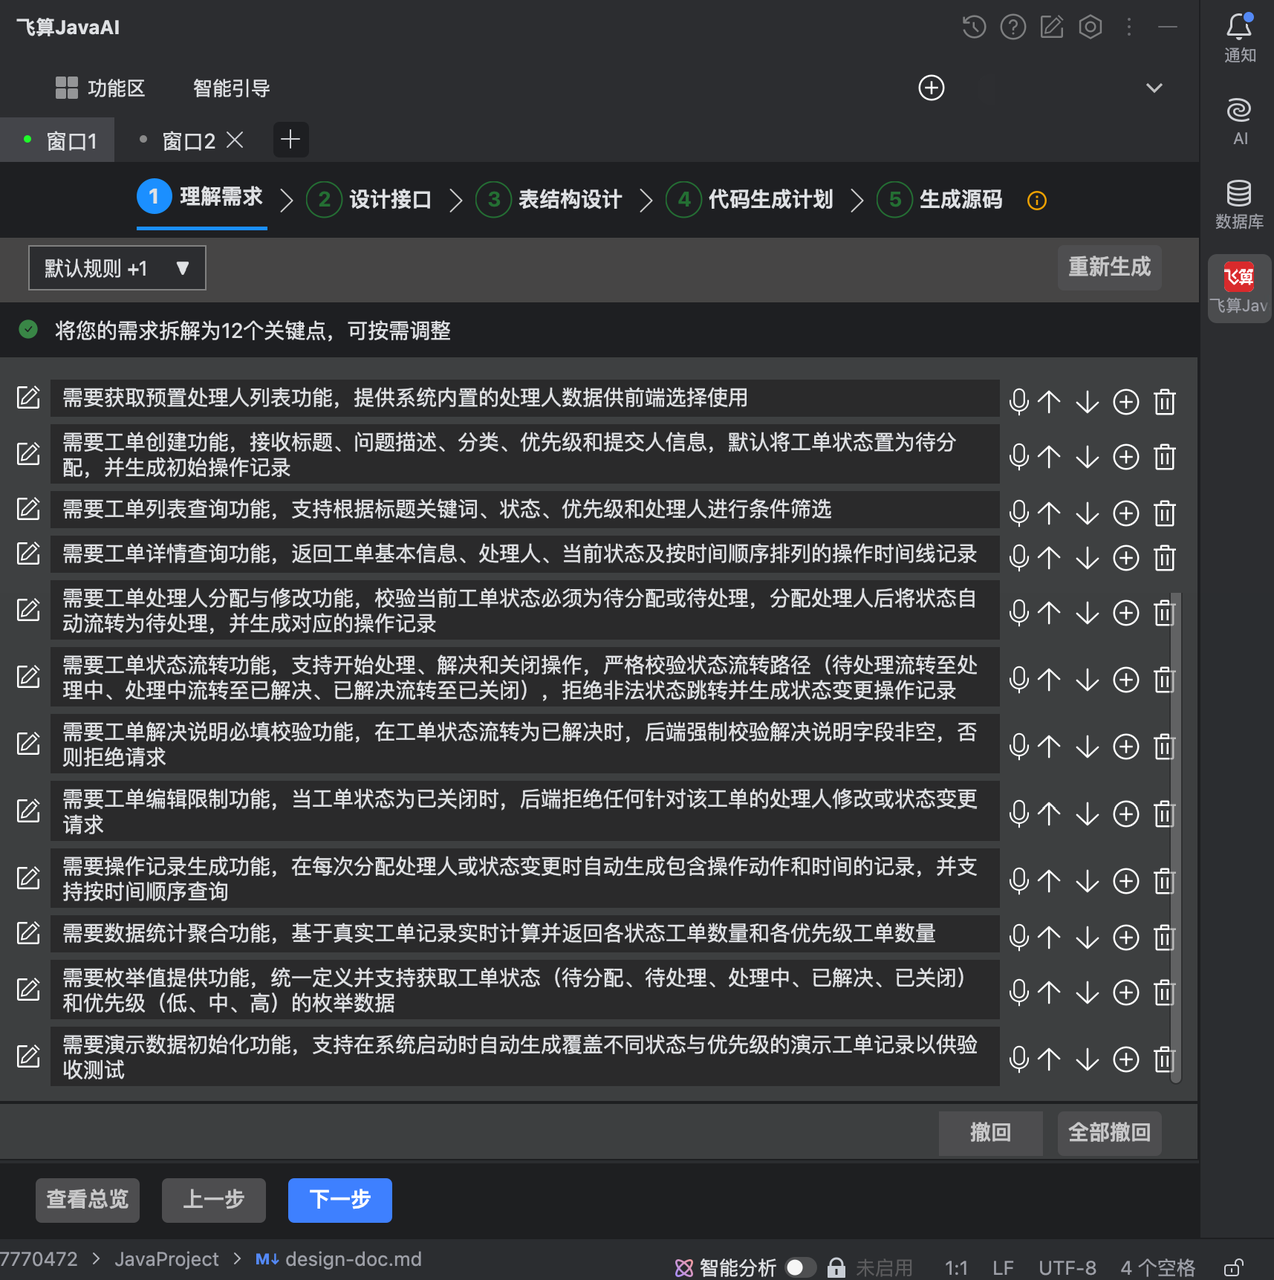
这个环节适合检查 AI 有没有漏掉规则。比如“关闭后不可编辑”如果仅体现在前端按钮上,而没有进入后端需求,就可能留下直接调用接口的漏洞。截图中的拆解结果已经把后端拒绝相关修改请求写了出来;后续仍需要通过测试确认实现是否兑现。
先对齐接口能力,再细化具体路径
下一步是接口设计。界面展示了 8 个接口方案,覆盖基础数据、创建、列表、详情、处理人分配、状态流转、统计和演示数据初始化。
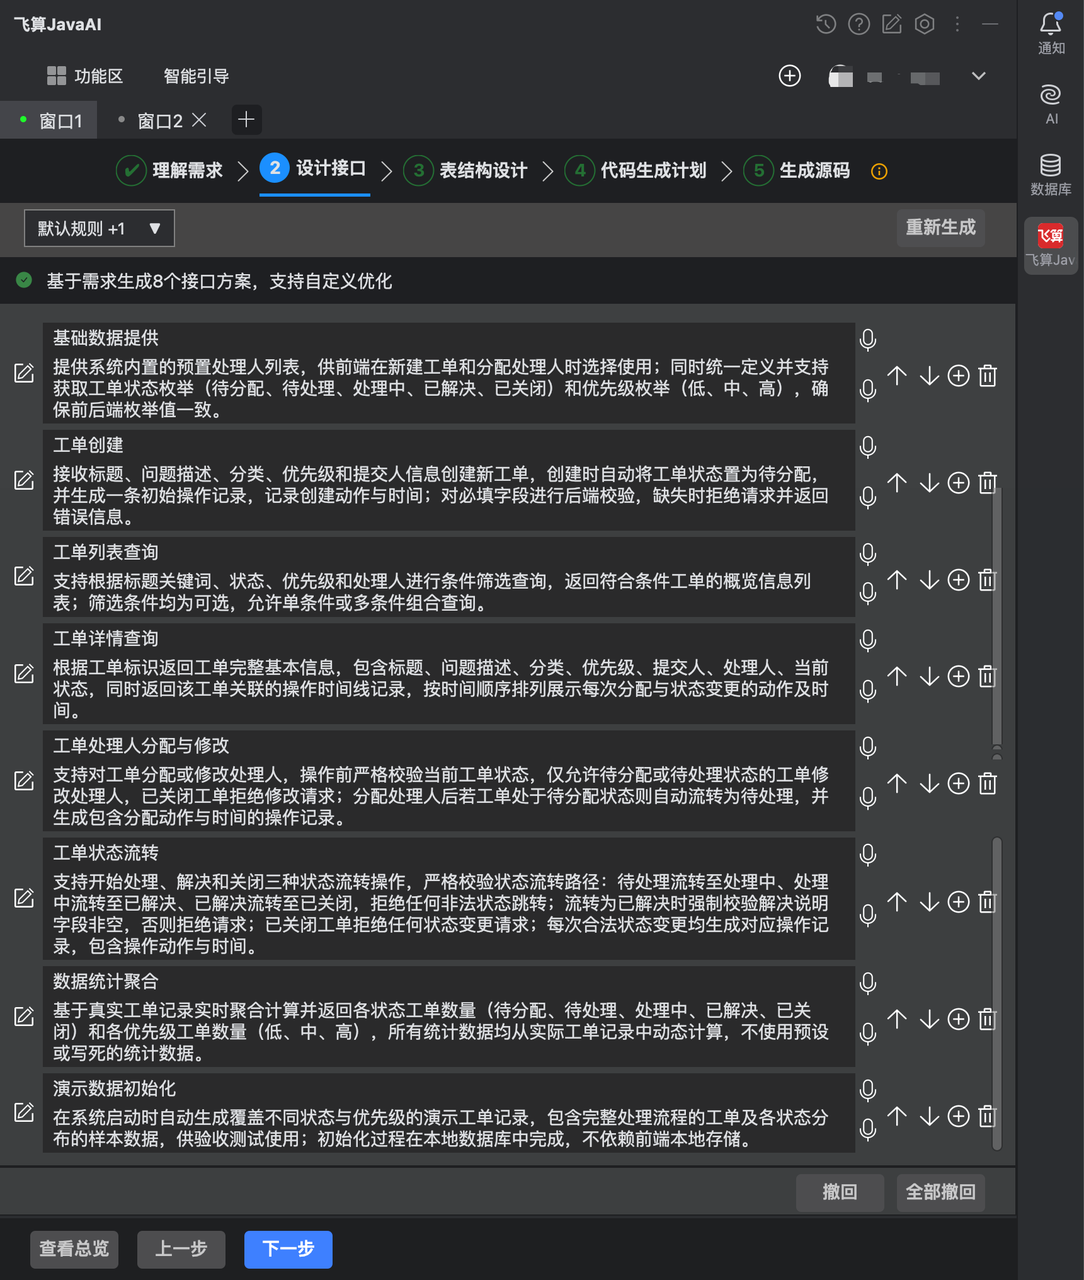
这里的“8 个方案”是功能方案分组,不能直接理解成最终只有 8 条 HTTP 接口。后面的计划又把基础数据和状态流转拆得更细,例如将开始处理、解决、关闭分别设计为接口。
以下路径整理自截图中的设计计划,用来说明接口如何分工,并非对源代码的逐项审计:
GET  /api/handlers                    获取预置处理人
GET  /api/enums                       获取状态与优先级枚举
POST /api/work-orders                 创建工单
GET  /api/work-orders                 分页与组合筛选
GET  /api/work-orders/{id}             获取详情和时间线
PUT  /api/work-orders/{id}/handler     分配或修改处理人
POST /api/work-orders/{id}/start       开始处理
POST /api/work-orders/{id}/resolve     解决工单
POST /api/work-orders/{id}/close       关闭工单
GET  /api/statistics                  获取统计数据
对于后端开发者,这一步的价值很直观:页面操作和接口能力被放在同一份方案里讨论。新建弹窗提交什么、详情页拿什么、状态按钮调用什么,都有了明确的对应关系。
数据模型围绕三张表展开
表结构设计阶段,界面选择了 MySQL,并生成 3 张表。结合后续计划,可以看到它们分别是:
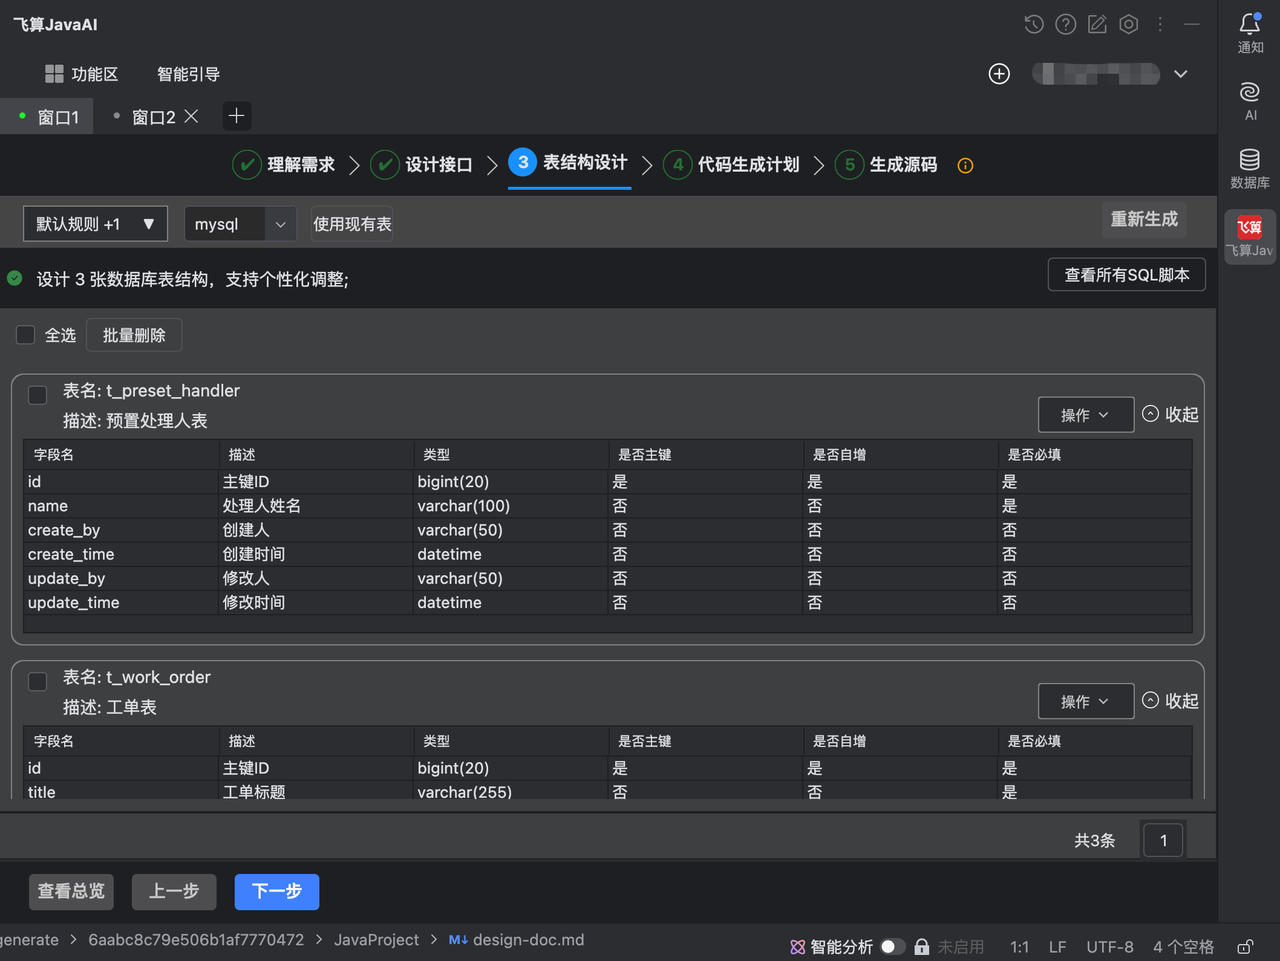
将工单当前状态与历史操作记录分开,能够同时服务列表查询和详情时间线。
18 项计划最终输出为设计文档
“代码生成计划”页面列出了 18 项任务,但本轮任务的实际内容是设计文档:项目概述、数据模型、接口、错误响应、页面交互、演示数据、验收用例以及环境和启动方案。
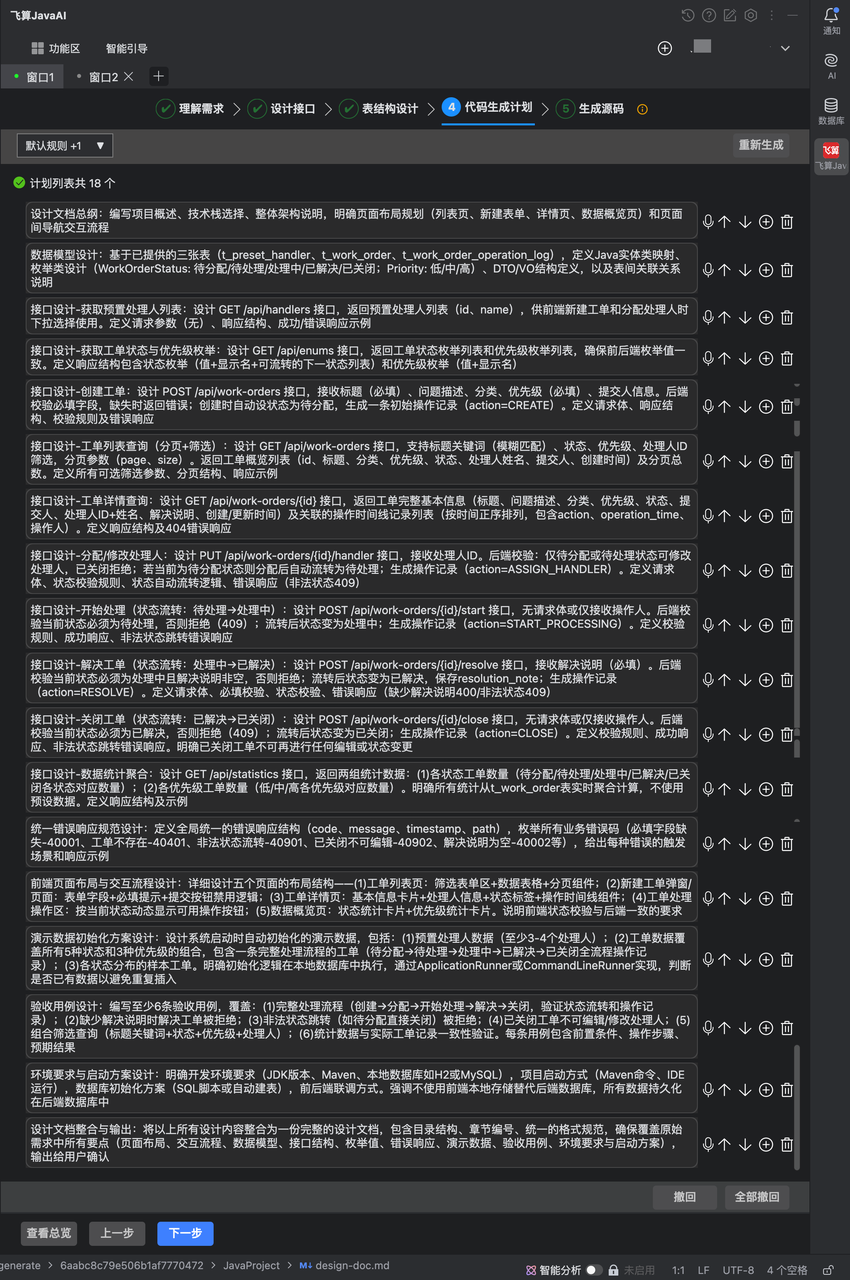
这也提醒我,不能只看流程栏的名字判断产出。虽然最后一步叫“生成源码”,这一轮执行记录明确写的是整合设计任务,最终工作区只生成了一个 design-doc.md 文件,符合“先出设计、再确认代码生成”的要求。
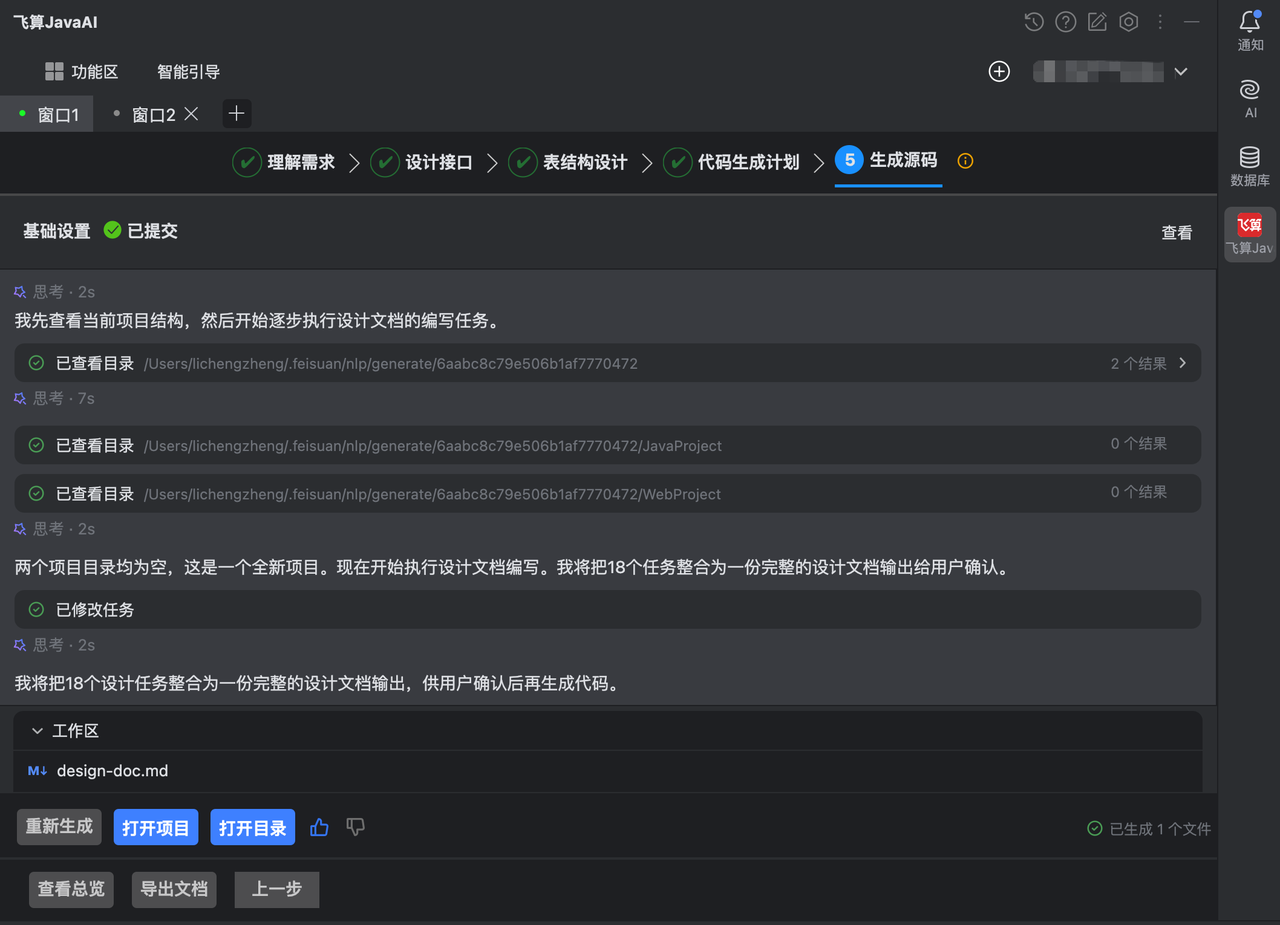
**这一阶段用时 10 分钟。**产出价值在于把抽象需求整理成了可以逐项核对的方案。确认时,我会重点看状态规则有没有遗漏、必填字段是否一致、页面动作是否都有对应接口,以及异常情况是否进入了验收计划。
四、前后端代码阶段:22 分钟,按设计继续落地
完成设计确认后,下一阶段围绕同一份方案生成前后端代码。**这一部分用时 22 分钟。**从现有截图看,过程中包含前端开发总结和后端补全总结,因此不将其描述成“首轮一次生成就全部成功”。
前端产出围绕实际操作组织
前端开发总结中列出了工单列表、新建弹窗、工单详情和数据概览四项界面产出:
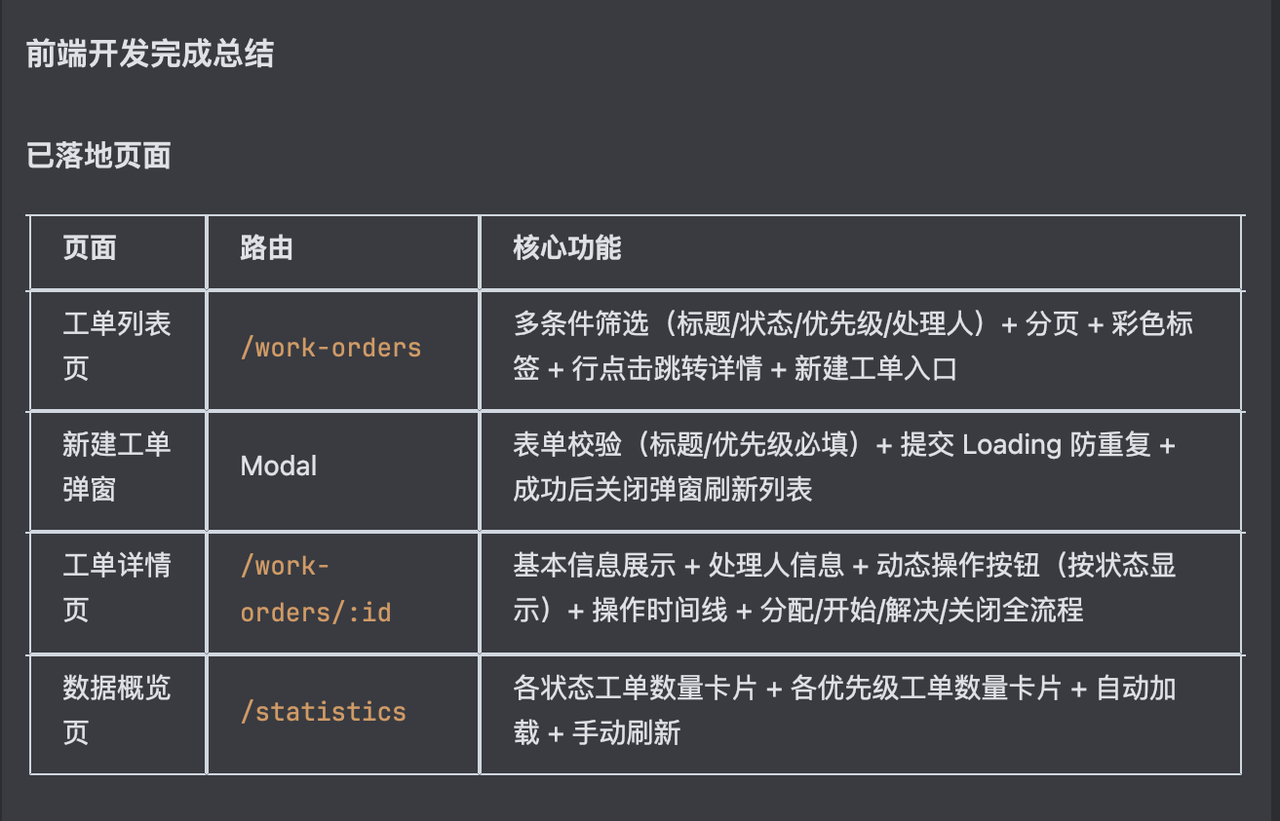
这里不能把一个弹窗也算成独立路由页面,再用“生成了四个页面”概括全部工作量。更值得关注的是页面之间能否衔接:创建完成后是否刷新列表,列表能否进入详情,详情操作后是否更新状态和时间线。
后端总结展示了数据访问、业务和接口分层
后端补全与启动总结中,列出了 Repository、Service、Controller、数据初始化和启动脚本等内容。
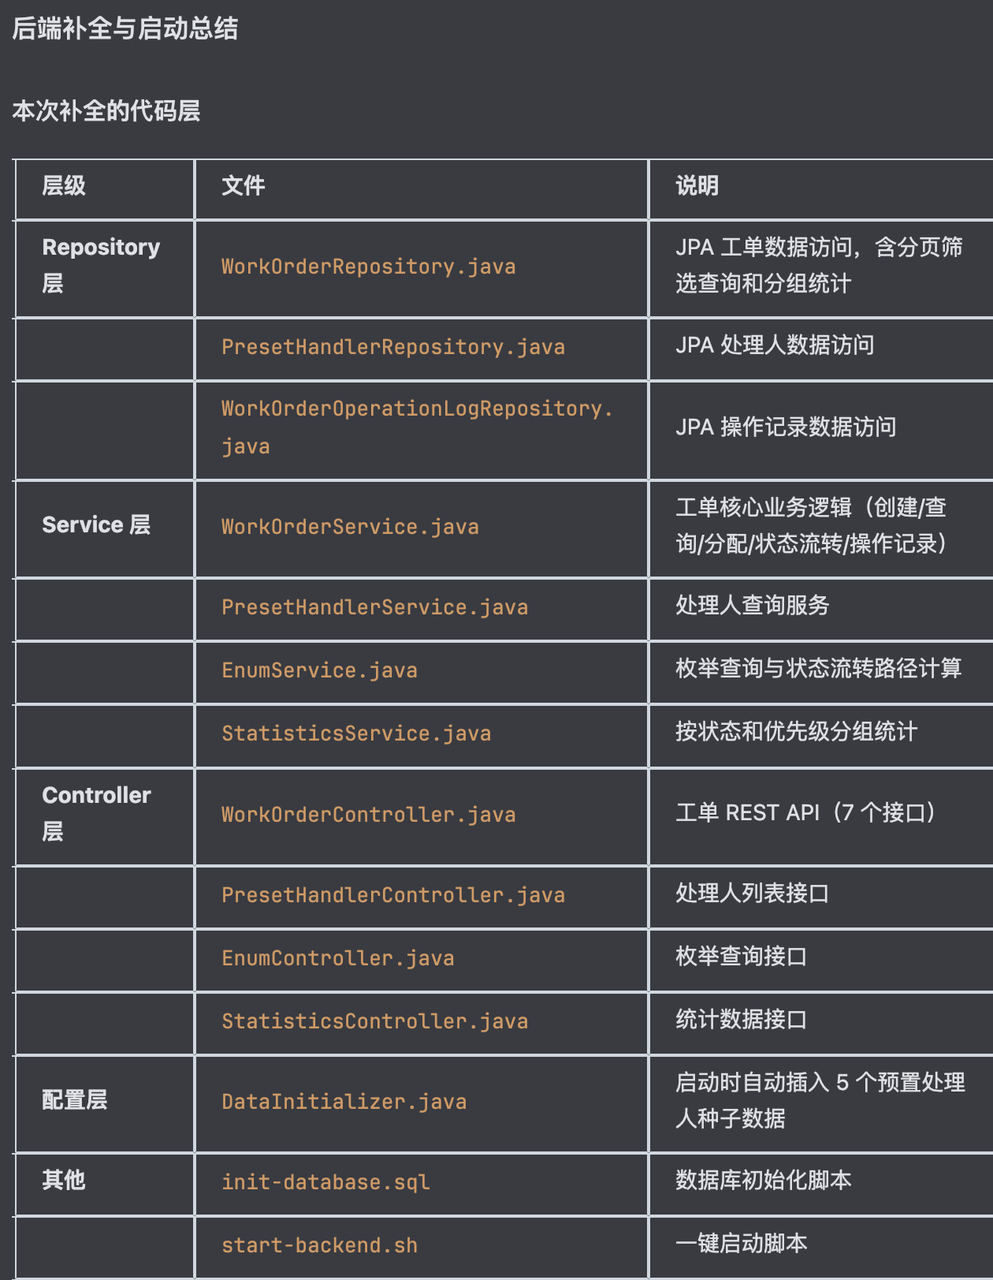
其中,WorkOrderRepository.java 对应分页筛选和分组统计的数据访问;WorkOrderService.java 对应创建、查询、分配、状态流转及操作记录;WorkOrderController.java 对应工单 REST API。枚举、处理人和统计也分别有对应服务与控制器。
对后续维护来说,这样的职责划分让检查位置更明确:状态是否合法,重点看业务层;查询和统计是否正确,重点看数据访问层;请求参数和错误响应,则结合接口层检查。
不过,生成总结是工具对产出的说明,不能代替源码审查和测试报告。比如“解决说明必填”究竟只做了空字符串判断,还是也拒绝纯空白输入,仍然需要实际检查。
五、本地运行:从生成总结走到浏览器页面
启动输出展示了什么?
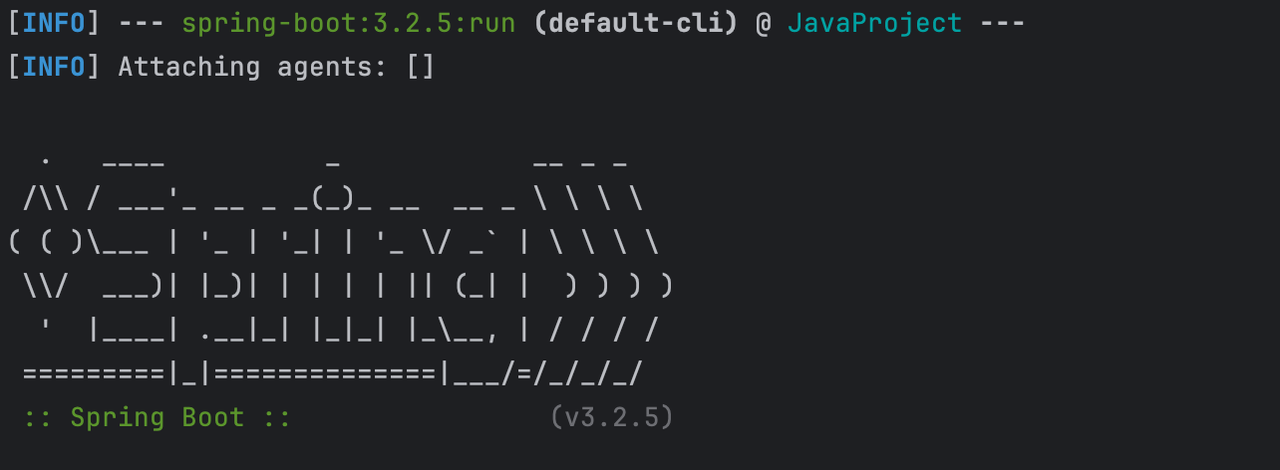
后端截图出现了 Maven 的 spring-boot:3.2.5:run 输出和 Spring Boot 3.2.5 横幅。
前端截图则明确显示 Vite 5.4.21 已就绪,访问地址为 http://localhost:5173/,同时标注了 API 代理目标。
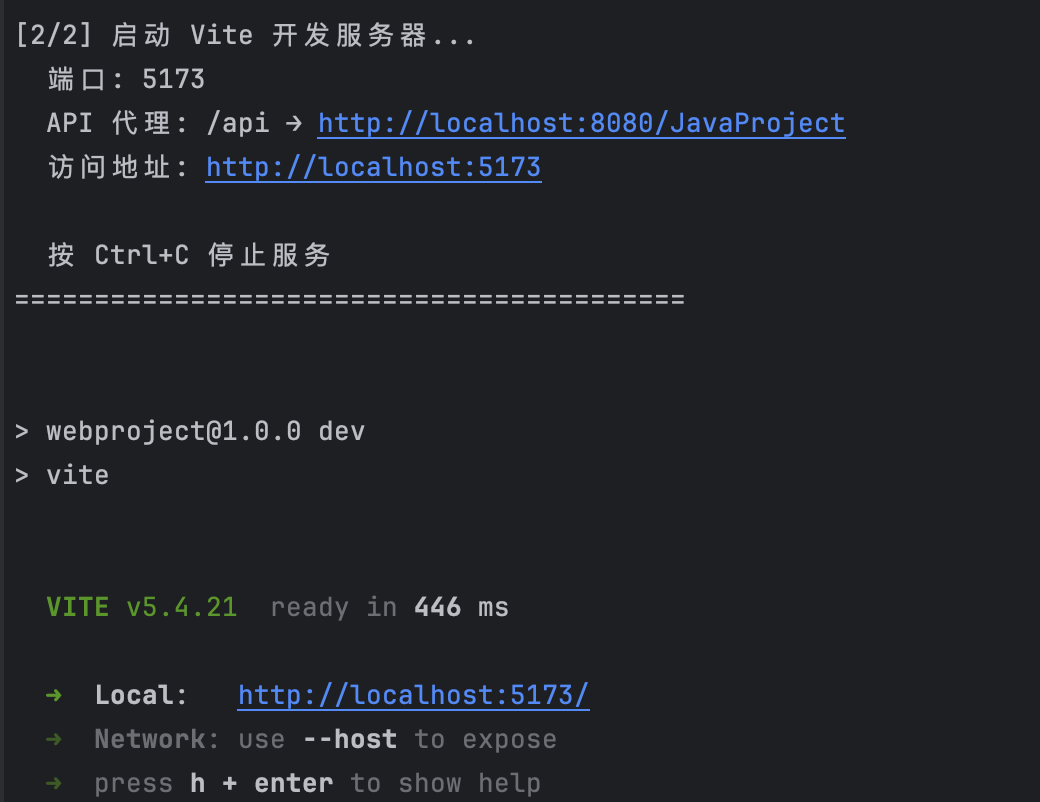
截图中的 ready in 446 ms 是这次 Vite 开发服务器的启动提示,不是页面性能指标,也不是全项目生成耗时。我的代码生成耗时仍按前文记录的 22 分钟计算。
初始列表、创建弹窗和新增记录
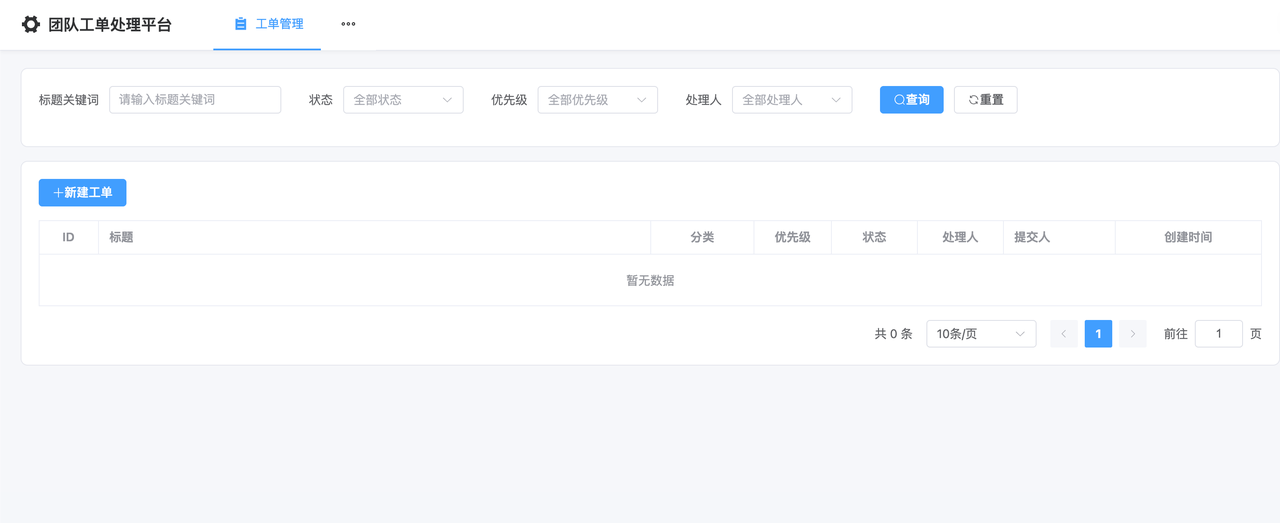
浏览器中的团队工单处理平台已经呈现出清晰的中后台布局:上方是标题关键词、状态、优先级和处理人筛选区,下方是新建按钮、工单表格和分页区。初始截图显示“暂无数据”。
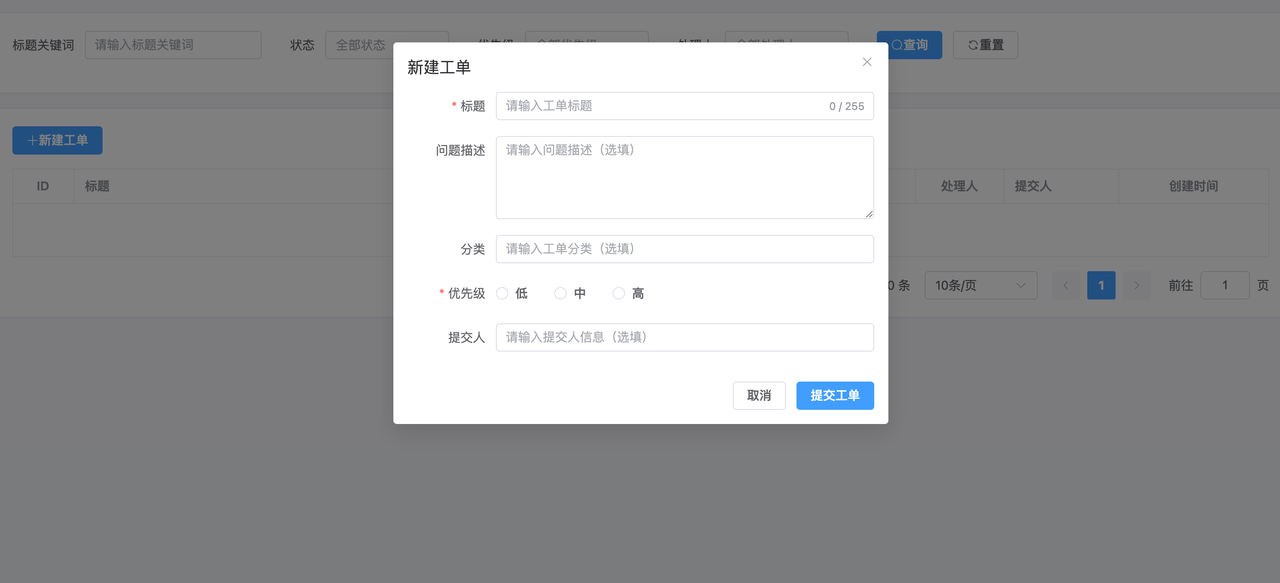
新建弹窗包含标题、问题描述、分类、优先级和提交人。标题与优先级有必填标记;问题描述、分类和提交人标注为选填;标题输入框显示了 255 字符的长度提示。
后续列表截图中出现了一条 ID 为 1 的记录,标题为测试输入“111”,优先级为“高”,状态为“待分配”,处理人为空,总条数也从 0 变成了 1。
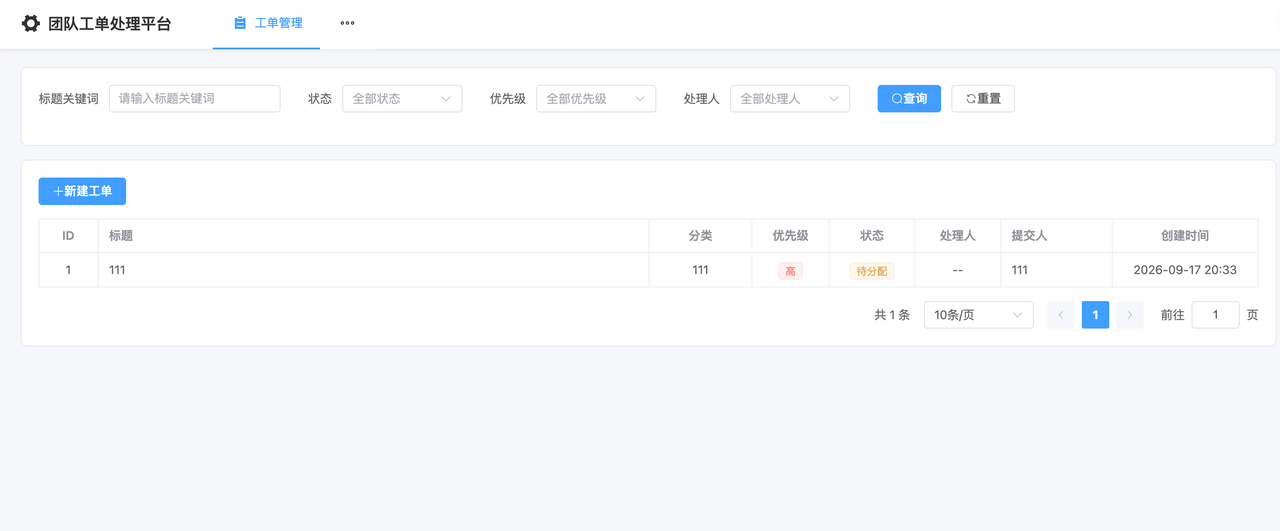
这组操作记录把展示范围推进到了新建工单后的列表结果,默认状态也与需求一致。
六、这次体验的优点、不足和下一步
优点:设计和实现有了一条共同主线
这次最有价值的产出,是需求、接口、表结构、页面交互和代码任务能够连在一起看。设计阶段就能检查业务规则,进入代码生成后,也能沿着同一份方案检查界面和后端分层。
对于主要写 Java 的开发者,新建弹窗、列表筛选、状态标签和分页等常规界面能够由工具承担初步实现,可以减少从空白页面起步的工作。浏览器截图也让结果更容易判断:布局有没有生成、表单字段是否齐全、列表里是否出现新记录,都比单看“已完成”总结具体。
前后端围绕共同接口设计生成,也提供了减少字段和路径反复对齐的可能。不过,本次记录没有独立统计联调耗时,不能据此得出“联调工作绝对归零”的结论。
不足:生成过程仍需要人把关
首先,需求必须足够明确。本次输入并非一句模糊描述,而是写出了业务范围、状态规则和验收要求。生成效果与这些约束有关,不能忽略需求整理的作用。
其次,生成计划与运行结果仍需逐项核对。设计中要求初始化覆盖不同状态和优先级的演示工单,但现有初始列表截图显示 0 条记录;后端总结明确提到的则是 5 个预置处理人的种子数据。这还不足以判断演示工单为什么没有出现,需要继续检查初始化逻辑、所连接的数据库和实际数据。
最后,当前浏览器截图集中在列表和新建弹窗。详情时间线、全部状态流转、统计页面,以及绕过前端后的非法请求拦截的相关记录。
建议:把下一轮验收落到具体用例上
针对这套工单平台,我会继续按下面的清单检查。
若要把这个本地原型用于真实团队,还需要补齐身份认证、权限控制和必要的运维措施。本次没有实现登录与角色权限,正是最初限定的范围,不能直接按生产系统交付标准评价。
七、我的结论:后端独立推进全栈原型,有了更具体的路径
回看这次过程,设计文档生成用时 10 分钟,前后端代码生成用时 22 分钟。材料展示了从需求拆解、接口和表结构设计,到生成总结、开发服务输出,再到浏览器工单页面的连续过程。
对我而言,飞算JavaAI的价值在于帮助后端开发者把工作推进到前端界面,让一个明确的业务需求更快变成可以查看和继续验证的项目。开发者的注意力也随之转向需求是否清楚、设计是否合理、业务规则是否正确,以及最终结果是否经得起验收。
如果要尝试这种开发方式,我建议从一个边界明确的中后台模块开始:先写清业务规则,让工具生成设计文档,检查后再生成代码,最后用真实操作验证结果。这次团队工单平台的实践已经提供了一个可参考的起点;是否能进一步交付使用,要由后续业务测试来回答。
#飞算JavaAI #AI编程 #Java #全栈开发 #前后端分离 #后端开发 #前端开发 #IDEA插件 #程序员 #IDEA开发 #Java开发 #SpringBoot #程序员必备


 扫一扫


 1292

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


