




智能决策的"大脑",与它的认知框架、记忆网络、神经基础。
引子:为什么大模型单独撑不起企业AI
企业AI(尤其是 Agentic AI)不再只是简单回答问题,而是需要理解业务、进行推理并执行动作。但在真实的企业场景里,AI 往往同时面对三大痛点:不可靠、不懂业务、难治理。
这三大痛点不是"调参"能解决的,因为它们根植于大模型的三个本质特征:
第一,大模型是概率生成器,不是事实数据库。
LLM 的输出是在给定上下文下对下一个 token 的条件概率采样。它优化的是"语言上合理",不是"事实上正确"。当训练数据里没有、或记忆模糊时,它会用最"顺"的方式补全——这就是幻觉(hallucination)的机制来源。2023 年斯坦福 HAI 的研究显示,在法律、医疗等专业领域,通用 LLM 的事实性错误率可达 15%–30%;即使 GPT-4 级别模型,在无检索增强的情况下,复杂多跳事实问题的错误率仍显著。
第二,大模型没有企业私有的、结构化的业务语义。
它见过"客户"和"用户"这两个词,但不知道在你的 CRM 里,"客户"特指已签约主体,"用户"特指注册账号,二者是一对多关系。企业内部的术语、口径、业务规则,几乎不可能完整出现在预训练语料里。缺少这层语义,AI 就会"张冠李戴"。
第三,大模型是黑箱,且无法审计。
你无法回答"它为什么说这笔交易有风险"。而在金融、医疗、政务等强监管场景,"不能解释"本身就等于"不能用"。欧盟 AI Act、中国《生成式人工智能服务管理暂行办法》都对高风险 AI 系统提出了可解释、可追溯要求。
结论:企业AI不能只依赖大模型的概率生成能力,必须接入一个能代表企业真实业务逻辑的"语义层"。这就是本文要讲的"三件套":Ontology(本体)、知识图谱(Knowledge Graph)和图数据库(Graph Database)。
它们之间的关系,可以理解为"智能决策的大脑"与它的"认知框架""记忆网络""神经基础"之间的关系:
|
组件 |
角色定位 |
内涵 |
|
本体(Ontology) |
认知框架 |
定义"这个世界里有什么概念、怎么分类、彼此什么关系" |
|
知识图谱(Knowledge Graph) |
记忆网络 |
把具体的实体和事实,按框架连接成一张可推理的网 |
|
图数据库(Graph Database) |
神经基础 |
提供存储与高速遍历的物理能力,让"思考"能在毫秒级发生 |
三者协同,分别对应地解决"不懂业务""不可靠""难治理"。
01 三个组件,各司其职
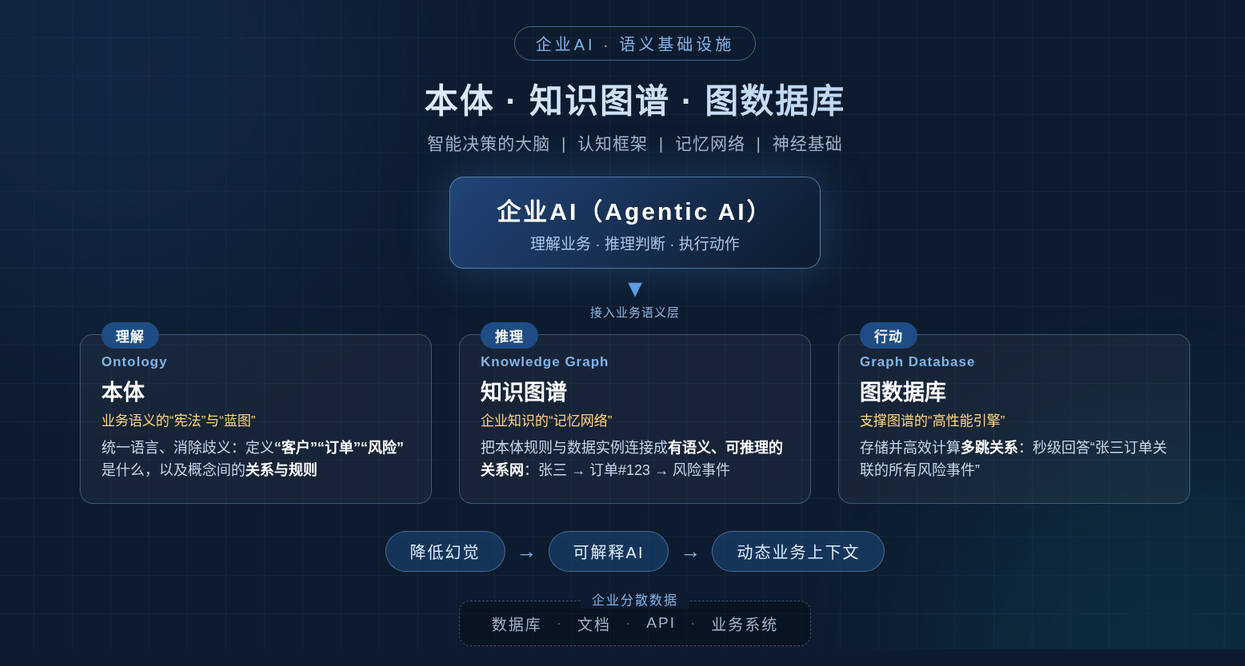
1.1 Ontology(本体)——业务语义的"宪法"
定义:本体是对某一领域概念及其关系的形式化、显式规范。它通常包含:
- 类(Class):如 Person、Organization、Loan
- 属性(Property):如 hasName、hasAmount
- 关系(Relation):如 worksFor、guarantees
- 约束(Constraint):如 worksFor 的 domain 是 Person、range 是 Organization
- 公理(Axiom):如"每个借款合同必须关联至少一个借款人"
技术标准:W3C 的 RDF/RDFS/OWL 是主流本体语言。OWL 支持描述逻辑推理,可以自动发现"这个实例其实也属于那个类"。
为什么企业AI需要它:
- 统一语言:消除跨系统歧义("客户"vs"用户"、"收入"vs"营收")。
- 支撑推理:有了公理,AI 可以从已知事实推出新事实。
- 约束校验:新数据入图谱时,自动检查是否违反业务规则。
反例边界:本体不是越全越好。过度建模会导致维护成本高、灵活性差。实践中常用"轻量本体"(只有类、关系、少量约束),把复杂规则留给业务层。
1.2 知识图谱(KG)——企业知识的"记忆网络"
定义:知识图谱是以图结构组织的、语义化的知识库,由实体(节点)和关系(边)构成。它的核心特征是"语义化"——边不是随意的连接,而是本体定义的关系类型。
T-Box 与 A-Box:
- T-Box(术语层):就是本体,定义概念和关系。
- A-Box(断言层):具体实例和事实,如
(张三) —[worksFor]→ (某公司)。
- 知识图谱 = T-Box + A-Box。
它解决什么:把散落在数据库、文档、API 里的数据,连接成一张可多跳推理的网。AI 不再面对孤立表格,而是能看到:
客户A → 购买了 → 产品B → 属于 → 高风险类别 → 触发 → 合规规则C
与"数据库"的本质区别:关系库回答"满足条件的行有哪些";知识图谱回答"这些实体之间有什么关系、能推出什么"。
1.3 图数据库(Graph DB)——支撑图谱的"高性能引擎"
定义:图数据库是以图结构为第一公民的存储与计算系统,原生支持节点、边及其属性的高效存储和遍历。
两大流派:
|
流派 |
代表 |
查询语言 |
特点 |
|
属性图(Property Graph) |
Neo4j、JanusGraph、TigerGraph |
Cypher、Gremlin |
工程灵活、性能强 |
|
RDF 三元组库(Triplestore) |
GraphDB、Virtuoso、Jena |
SPARQL |
原生支持本体/推理 |
为什么需要专门的图数据库:
- 多跳查询:在关系库里,查"朋友的朋友的朋友"需要多次 JOIN,深度一增加,性能指数级下降("join bomb")。图数据库用无索引邻接(index-free adjacency),遍历复杂度与深度近似线性。
- 图算法:最短路、社区发现、PageRank、链接预测,原生支持。
- 灵活 schema:业务变化时无需大改表结构。
反例边界:不是所有场景都需要图数据库。如果查询主要是单点、聚合统计,关系库或数仓更合适。图数据库的强项是"关系密集型"查询。
1.4 三者关系一图说清
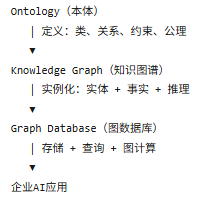
关键澄清:
- 本体 ≠ 知识图谱:本体是"定义",KG 是"实例"。
- 知识图谱 ≠ 图数据库:KG 是数据/语义资产,图数据库是工具。
- 有本体不一定用图库(小规模可用 OWL 推理机);用图库不一定有本体(很多属性图无形式化本体)。
02 协同工作流:从"理解"到"行动"
这三者不是各自为战,而是形成一条完整链条。下面用一个金融风控的完整案例贯穿说明。
场景:AI Agent 评估一笔贷款申请的风险
Step 1:本体提供"理解"的框架
本体明确定义:
- 类:借款人、资产、担保、贷款、风险事件
- 关系:借款人—拥有—资产、借款人—提供—担保、贷款—关联—借款人
- 约束:担保 必须关联至少一个 资产
- 公理:若 借款人 的 资产 被标记为 高风险,则该借款人视为 高风险主体
作用:当 AI 处理"张三申请贷款"时,它不会把"张三"当成一个字符串,而是知道他是 借款人 类的一个实例,必须按本体的规则去关联资产、担保、历史事件。
如果没有本体:AI 可能把"客户"和"用户"混为一谈,把"担保人"和"借款人"搞反,推理链从第一步就错了。
Step 2:知识图谱提供"推理"的网络
知识图谱把企业数据连成网:
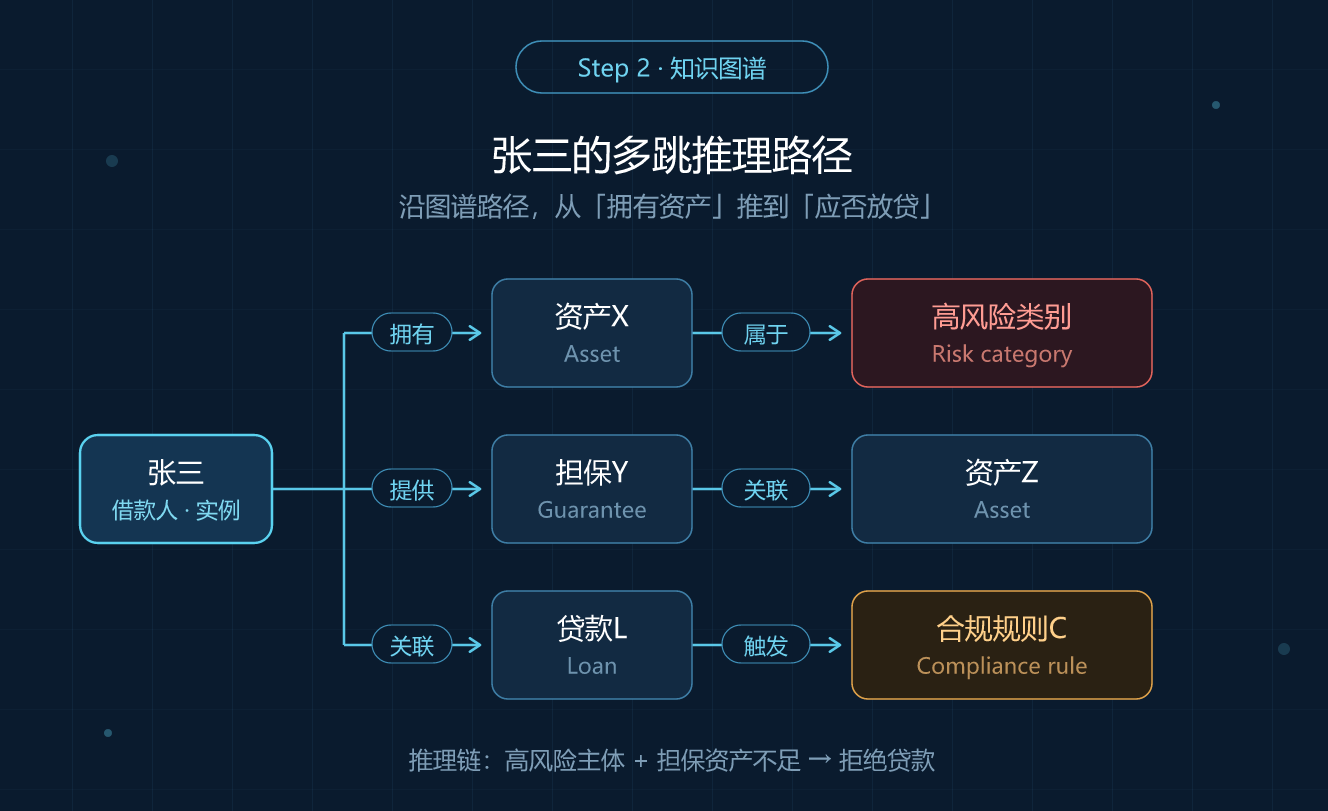
AI Agent 可以沿路径做多跳推理:
- 张三 → 资产X → 高风险类别(1 跳)
- 张三 → 担保Y → 资产Z(2 跳)
- 结合规则:高风险主体 + 担保资产不足 → 拒绝贷款
如果没有知识图谱:AI 只能拿到孤立表格,无法自动发现"张三的担保资产Z其实也被抵押给了另一笔贷款"这种跨表、跨系统的隐藏关联。
Step 3:图数据库提供"行动"的速度
当 AI 需要在毫秒级给出风控决策时,图数据库负责在庞大关系网中高效遍历。
性能对比(示意):
- 关系库做 3 跳查询:多次 JOIN,百万级数据下可能秒级到分钟级。
- 图数据库做 3 跳查询:无索引邻接,通常毫秒级。
在实时风控场景,"秒级"和"毫秒级"的差别,就是"能拦下欺诈"和"欺诈已发生"的差别。
如果没有图数据库:推理逻辑再对,响应太慢,业务上也用不了。
三者协同的本质
|
环节 |
组件 |
解决的问题 |
失效后果 |
|
理解 |
本体 |
统一语义、定义规则 |
张冠李戴、规则混乱 |
|
推理 |
知识图谱 |
连接数据、多跳发现 |
看不到隐藏关联 |
|
行动 |
图数据库 |
实时遍历、图计算 |
决策太慢、无法落地 |
03 对企业AI的关键价值
3.1 大幅降低"幻觉"
机制:GraphRAG(Graph Retrieval-Augmented Generation)用知识图谱检索替代/补充向量检索,把"已定义的、可追溯的事实和关系"注入 LLM 上下文。
为什么有效:
- 传统 RAG 检索的是文本片段,可能相关但不精确。
- GraphRAG 检索的是结构化事实,如"张三 worksFor 公司A",来源明确、无歧义。
- LLM 被约束在"基于给定事实作答",而非"凭记忆生成"。
证据:
- 微软 2024 年 GraphRAG 论文显示,在全局性、多跳问题上,GraphRAG 相比朴素 RAG 在全面性和多样性上显著提升。
- 在金融、医疗等垂直领域,多个案例报告幻觉率从两位数降到个位数百分比。
边界:GraphRAG 不能消除幻觉,只能降低。如果图谱本身有错,AI 会"自信地错"。所以数据治理仍是前提。
3.2 实现"可解释的AI"
机制:AI 的每个结论都能沿知识图谱的路径追溯。
示例:
- AI 判断:"拒绝张三的贷款申请。"
- 解释路径:张三 → 拥有 → 资产X → 属于 → 高风险类别 → 触发 → 规则R3 → 拒绝贷款。
为什么重要:
- 监管合规:欧盟 AI Act 对高风险系统要求"可解释";金融行业巴塞尔协议、银保监会规定都要求风控决策可追溯。
- 用户信任:员工/客户能理解 AI 为什么这么判断,才愿意采纳。
- 调试与改进:出错时能定位是本体定义错、图谱数据错,还是推理规则错。
对比:纯 LLM 的解释往往是"事后编造"(post-hoc rationalization),不一定反映真实推理过程;图谱路径是真实推理链。
3.3 承载"动态业务上下文"
机制:企业 AI Agent 需要处理不断变化的状态——用户实时兴趣、Agent 当前会话状态、业务实时事件。现代图数据库和知识图谱能灵活存储这些动态的、多值的上下文。
为什么图结构适合:
- 无固定 schema:新增一种上下文(如"用户最近浏览")不需要改表结构。
- 多值关系:一个用户可同时有多个兴趣、多个会话,图天然支持。
- 时序图:Neo4j、TigerGraph 等支持时间维度,可存"某时刻的状态"。
示例:客服 Agent 需要记住"用户A 3分钟前问过退款,现在问物流"——这种会话状态用图存比用表存更自然。
边界:高频更新的上下文(如每秒千次)可能更适合 Redis/内存库,图库适合"关系复杂但更新频率适中"的场景。
04 典型应用场景
4.1 金融风控
场景:识别欺诈团伙、评估贷款风险、反洗钱。
本体作用:定义 借款人、账户、交易、设备、IP 等类及关系。
知识图谱作用:
- 社区发现:用 Louvain、LPA 算法识别"共享设备/IP/联系人"的欺诈团伙。
- 链接预测:预测"两个看似无关的账户其实属于同一团伙"。
- 多跳推理:A → 转账 → B → 转账 → C,识别资金闭环。
图数据库作用:毫秒级遍历百万级交易网络,实时拦截。
案例:某银行用图数据库做反欺诈,将欺诈识别率提升 30%+,误报率下降。蚂蚁、PayPal 等都有公开的图风控实践。
4.2 智能供应链
场景:供应商风险传导、断供影响评估。
本体作用:定义 供应商、物料、产品、订单、工厂 等类及关系。
知识图谱作用:
- 当某供应商出问题,沿图谱找出所有受影响的订单、产品、客户。
- 评估替代方案:哪些其他供应商能供同种物料,切换成本多少。
图数据库作用:实时遍历多级供应链,秒级给出影响范围。
案例:疫情期间,多家制造企业用知识图谱做供应链韧性分析,把"影响评估"从数天缩短到分钟级。
4.3 企业知识管理
场景:员工/客服查询产品政策、合规要求、技术文档。
本体作用:定义 产品、政策、条款、部门 等类及关系。
知识图谱作用:
- 把散落在 Wiki、PDF、工单、邮件里的知识连成网。
- 回答"这个产品的退款政策是什么"时,能追溯到权威来源。
图数据库作用:快速检索相关知识子图,注入 LLM 生成答案。
价值:确保不同员工、不同 AI 客服给出的答案一致、权威、可追溯。
4.4 其他场景
- 医疗:疾病-症状-药物-基因知识图谱,辅助诊断和药物研发。
- 工业:设备-故障-维修-备件图谱,预测性维护。
- 公安/情报:人-地-事-物-组织图谱,案件关联分析。
- 推荐:用户-商品-行为图谱,提升推荐多样性和可解释性。
05 写在最后
企业 AI 应用的进化,正从单纯的"模型驱动"转向"语义/知识驱动"。
为什么这是趋势:
- 模型能力趋同:头部 LLM 差距在缩小,模型不再是护城河。
- 企业数据是护城河:谁的语义层建得好,谁的 AI 就更懂业务。
- 监管要求:可解释、可审计成为刚需。
Ontology、知识图谱和图数据库共同构成了企业 AI 不可或缺的"语义基础设施",让 AI 从"聪明的玩具"转变为"可信赖的生产力工具"。
评估企业 AI 方案的三个问题
下次再评估一个企业 AI 方案时,不妨先问:
- 它有没有定义清楚业务本体?——决定 AI 懂不懂业务。
- 它有没有把散落的数据连成可推理的知识图谱?——决定 AI 能不能发现隐藏关联。
- 它有没有用图数据库支撑实时的多跳查询?——决定 AI 能不能实时行动。
这三个问题的答案,往往比模型参数大小更能说明它的上限。
一个补充提醒
"三件套"是必要不充分条件。完整的企业 AI 架构还需要:
- 数据治理与实体对齐:决定图谱质量。
- 向量检索 + GraphRAG 混合:处理非结构化问题。
- Agent 编排与安全治理:让 AI 能放心自主行动。
- 评测与可观测:持续保证效果。
本体、图谱、图库是"语义底座",但不是全部。把它们放在完整架构里看,才能发挥最大价值。


 扫一扫


 309

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


