


很多团队在做 LLM 应用时,前期注意力都放在效果上:回答准不准、工具调用顺不顺、用户体验好不好。等到项目慢慢跑起来,调用量上去了,才突然发现账单涨得比预期快。这时候再回头看,很难说清楚钱到底花在哪个模型、哪条链路、哪次请求上。成本问题表面看是财务问题,实际上更像个工程可观测性问题:如果没有把成本拆到每次调用、每条 trace、每个项目上,优化就无从下手。
Opik 在这方面的设计思路比较直接:通过测量所有 trace 的 token 使用量,来追踪和监控 LLM 应用的成本。它把成本估算结果统一以 USD 显示,方便团队在不同层级上分析花费模式,也能比较快地发现成本异常。下面从仪表盘、代码接口、手动补算、支持范围几个角度,把 Opik 的成本追踪能力梳理一遍。
在仪表盘里看成本:三个层级各有各的用处
Opik 的仪表盘可以在三个层级查看成本:span、trace 和 project。每个层级提供的视角不一样,适合的问题也不一样。
Span 级成本
单个 span 会显示每个 LLM span 的计算成本,单位是 USD。也就是说,一次 LLM 调用花了多少钱,在 span 这一层就能看到。
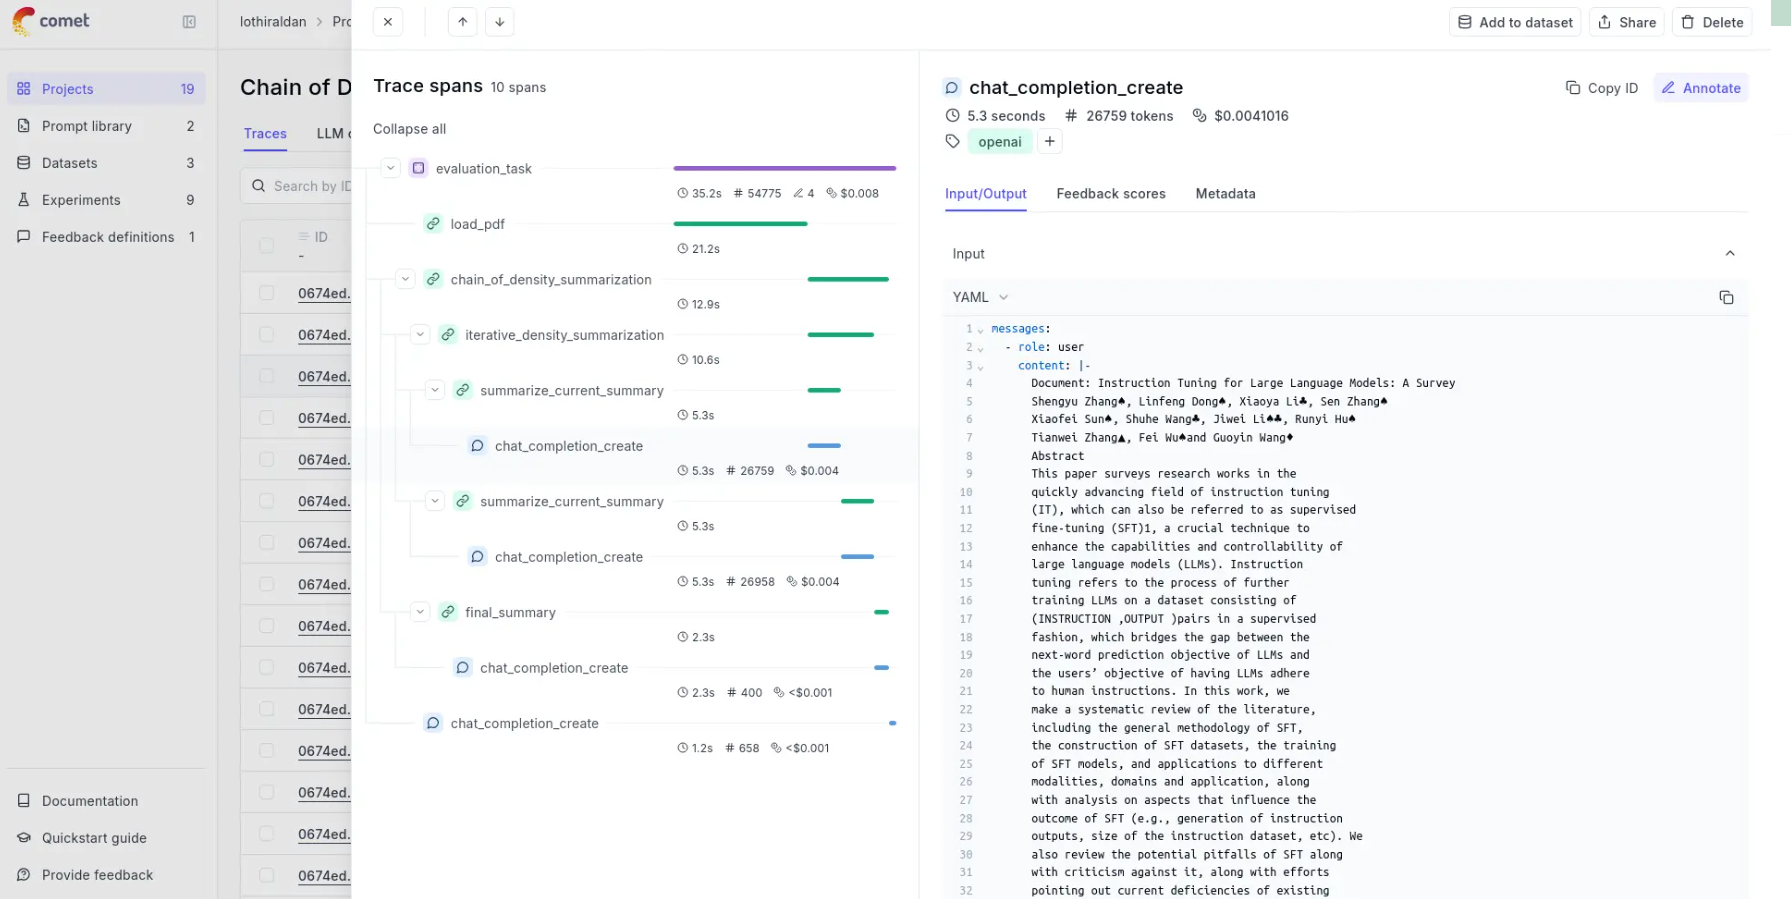
这个层级的价值在于定位。比如一个 Agent 在一次请求里调用了多个模型:一个负责意图识别,一个负责生成回答,一个负责总结。如果只看总成本,你不知道是哪个环节贵。拆到 span 级之后,就能看出是某个模型单价高,还是 token 用得多,或者是某次调用出现了异常长的输入输出。对于优化提示词、调整模型路由、限制上下文长度,span 级成本都是最细的依据。
Trace 级成本
如果你使用了 Opik 的某个集成,它会自动把一条 trace 内所有 span 的成本聚合起来,计算整条 trace 的总成本。
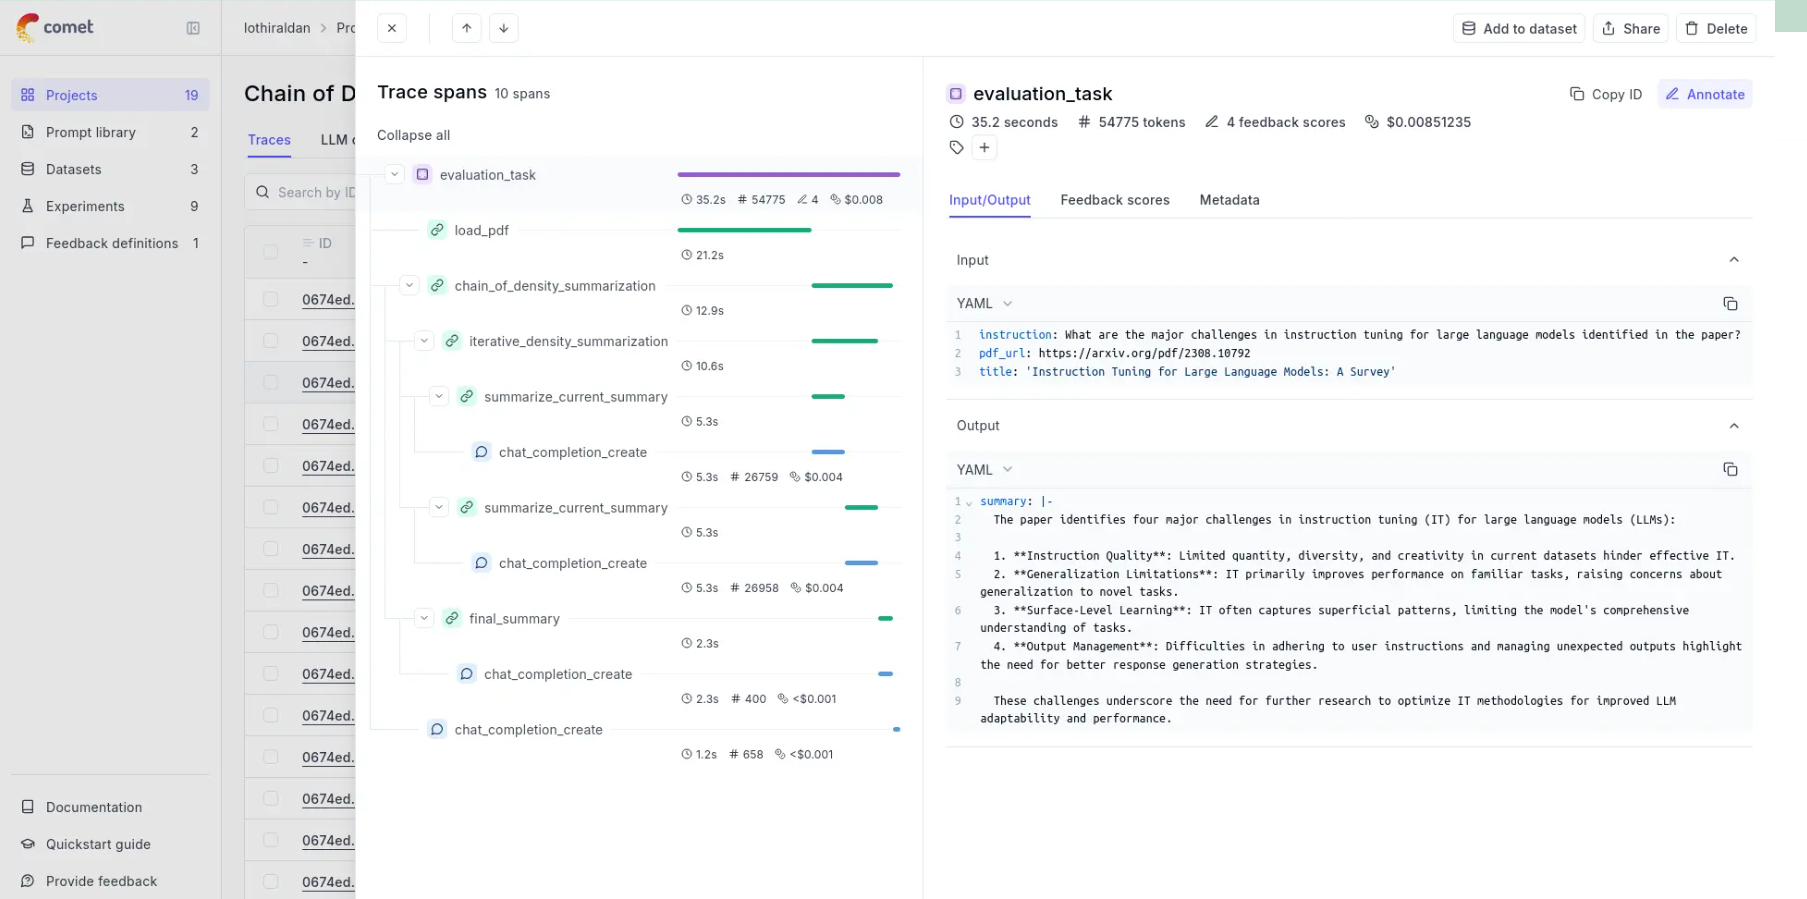
这个层级更贴近“一次用户请求”的成本。用户问一个问题,背后可能触发检索、工具调用、多轮模型生成,最终产生多个 span。trace 级成本把这些都加在一起,让你知道服务一个用户请求大概要花多少钱。对于按对话收费、按调用量估算预算、或者分析高成本用户行为,trace 级数据非常实用。
Project 级分析
想看整个项目的成本,Opik 提供了两个入口:
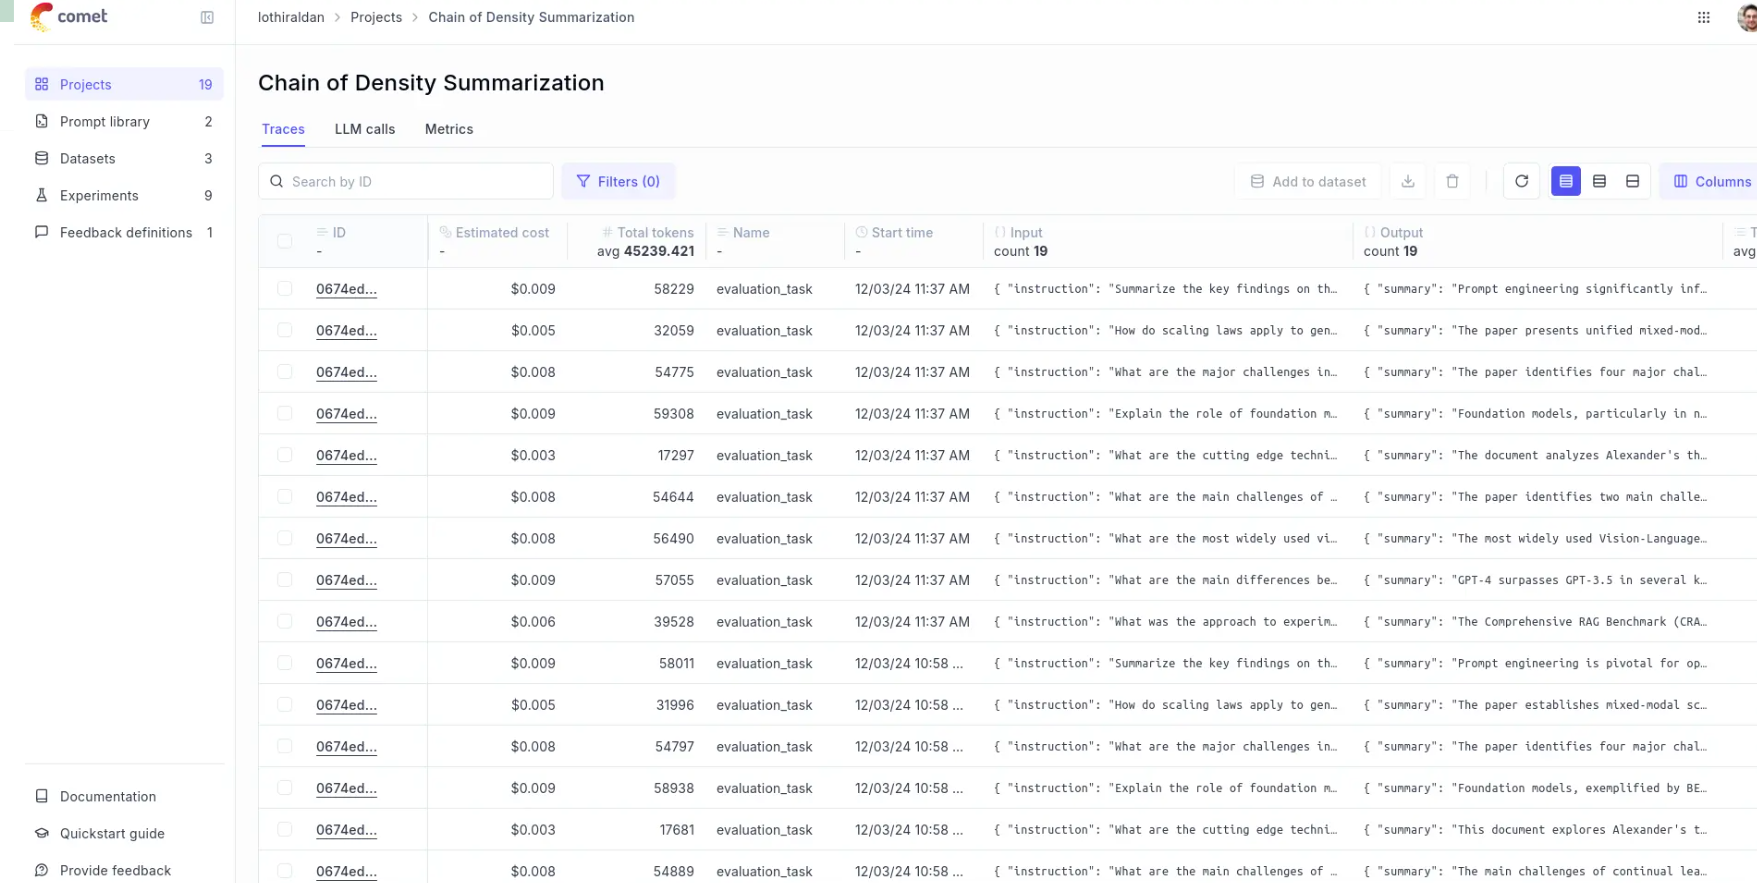
- 主项目视图里的 Estimated Cost 列:
- 项目 Metrics 标签页,这里会显示成本随时间变化的趋势:
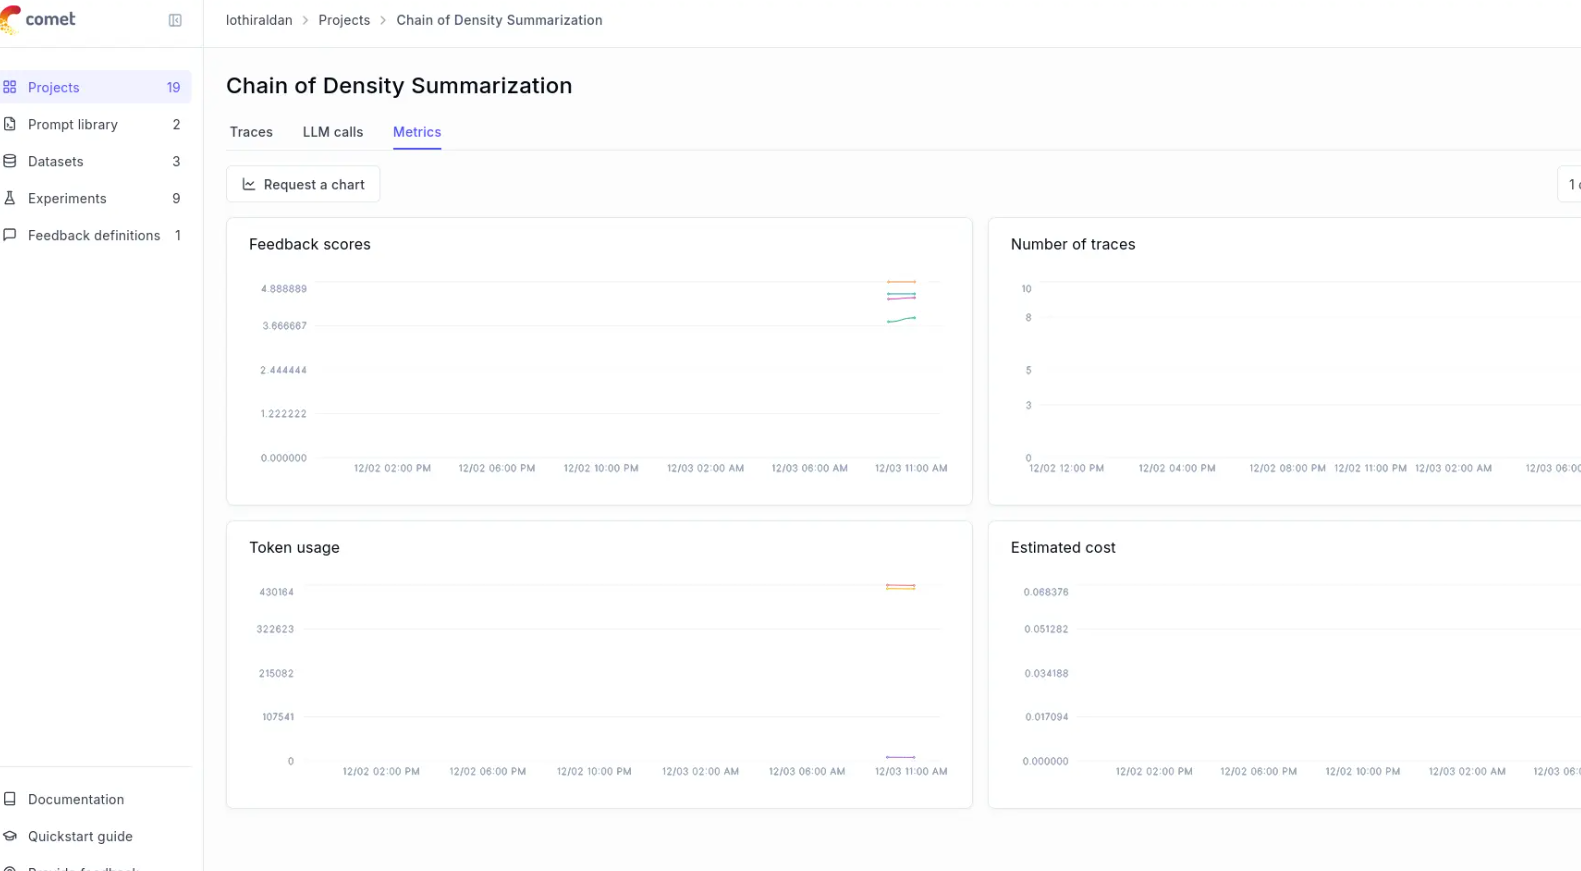
项目级视图适合回答更宏观的问题:这周比上周多花了多少?上线新功能之后成本曲线有没有明显抬头?某个模型版本切换后整体花费是升了还是降了?如果配合时间维度看,很容易发现异常。比如某天成本突然翻倍,可能是流量涨了,也可能是某个提示词变长导致 token 暴涨,或者某个集成出现了重试循环。仪表盘把趋势摆出来,排查就有了起点。
用代码获取成本:span 和 trace 都能拿到
除了在界面上看,Opik 也允许通过代码获取估算成本。这一点对自动化报表、预算告警、内部计费系统都很有用。
需要注意的是,如果 span 或 trace 使用了不支持的模型,返回的成本会是 None。所以拿到结果后,最好先判断一下,避免直接参与计算导致报错。
获取 Span 成本
import opik

client = opik.Opik()

span = client.get_span_content("<SPAN_ID>")
# Returns estimated cost in USD, or None for unsupported models
print(span.total_estimated_cost)
这段代码通过 span ID 拿到 span 内容,然后读取 total_estimated_cost。如果模型受支持,会返回估算成本;如果不支持,就是 None。
获取 Trace 成本
import opik

client = opik.Opik()

trace = client.get_trace_content("<TRACE_ID>")
# Returns estimated cost in USD, or None for unsupported models
print(trace.total_estimated_cost)
和 span 类似,trace 也有 total_estimated_cost。对于已经使用 Opik 集成的项目,这个值通常由内部 span 成本聚合而来。对于自建埋点的项目,就需要确保每个 LLM span 都带上了足够的信息,否则聚合结果可能不完整。
不用集成时,手动指定 provider、model 和 usage
如果你没有使用 Opik 的集成,Opik 仍然可以计算成本。前提是你要把关键信息传进去。具体来说,需要确保 span 类型是 llm,并且提供以下三项:
provider:提供商名称,通常是openai、anthropic、google_ai等。最新的提供商列表可以查看opik.LLMProvider枚举对象。model:模型名称。usage:这次 LLM 调用的输入、输出和总 token 数。
然后就可以在记录 trace 和 span 时把这些信息带上。根据使用方式不同,有两种写法。
函数装饰器
如果你用函数装饰器,需要在函数内部调用 update_current_span:
from opik import track, opik_context

@track(type="llm") # Note - Specifying the type is this is important
def llm_call(input):
  opik_context.update_current_span(
    provider="openai",
    model="gpt-3.5-turbo",
    usage={
      "prompt_tokens": 4,
      "completion_tokens": 6,
      "total_tokens": 10
    }
  )
  return "Hello, world!"

llm_call("Hello world!")
这里有一个细节:@track(type="llm") 里的 type 很重要。只有把 span 类型标成 llm,Opik 才会按 LLM 调用来处理成本。否则它可能只被当成普通 span,成本计算就不会触发。
低层 Python SDK
如果你直接用低层 Python SDK,可以在 client.span 或 trace.span 方法里传入这些字段:
import opik

client = opik.Opik()

trace = client.trace(
  name="custom_trace",
  input={"text": "Hello world!"},
)

# Logging the LLM call
span = trace.span(
  name="llm_call",
  type="llm",
  input={"text": "Hello world!"},
  output={"response": "Hello world!"},
  provider="openai",
  model="gpt-3.5-turbo",
  usage={
    "prompt_tokens": 4,
    "completion_tokens": 6,
    "total_tokens": 10
  }
)
这种方式适合自己控制埋点流程的项目。你可以把 provider、model、usage 当成普通字段传进去,Opik 会根据内置的价格表去估算成本。对于已经有一套自定义日志系统的团队,这种低层接口更容易接入现有链路。
手动设置 Span 成本:自定义价格和补算的出口
有些时候,自动成本追踪不一定覆盖你的情况。比如用了尚未支持的模型、和供应商签了自定义价格、或者想跟踪模型使用之外的额外成本。这时候可以手动设置 span 成本。Opik 提供了两种方式,分别对应不同时机。
创建 Span 时直接设置成本
如果你在手动创建 span,可以在创建时就把成本写进去:
from opik import track, opik_context

@track
def llm_call(input):
  opik_context.update_current_span(
    total_cost=0.05,
  )
  return "Hello, world!"

llm_call("Hello world!")
这个例子直接把 total_cost 设成 0.05。适合你已经知道这次调用成本,或者内部有另一套计价逻辑,想直接覆盖 Opik 的估算值。
Span 完成后更新成本
使用 Opik 集成时,span 往往是自动创建、自动关闭的,打开期间没法更新。但你可以等它结束之后,用 update_span 方法回头更新成本。这种方式很适合实现周期性的成本估算任务。
下面是一个完整的示例。它定义了自己的 token 成本映射,然后扫描没有估算成本的 LLM span,计算并回填成本:
from opik import Opik
from opik.rest_api.types.span_public import SpanPublic

# Define your own cost mapping for different models
TOKEN_COST = {
    ("openai.chat", "gpt-4o-2024-08-06"): {
        "input_tokens": 2.5e-06,
        "output_tokens": 1e-05,
    }
}

# This part would be custom for your use-case and is only here for example
def compute_cost_for_span(span: SpanPublic):
    provider = span.provider or span.input.get("ai.model.provider")
    model = span.model or span.output.get("gen_ai.response.model")
    usage = span.usage

    if (provider, model) in TOKEN_COST:
        model_cost = TOKEN_COST[(provider, model)]
        cost = (
            usage["input_tokens"] * model_cost["input_tokens"]
            + usage["output_tokens"] * model_cost["output_tokens"]
        )
        return cost
    return None

def update_span_costs(project_name, trace_id=None):
    opik_client = Opik()

    # Find LLM spans that don't have estimated costs
    spans = opik_client.search_spans(
        project_name=project_name,
        trace_id=trace_id,
        filter_string='type="llm" and total_estimated_cost=0',
    )

    for span in spans:
        cost = compute_cost_for_span(span)

        if cost:
            print(f"Updating span {span.id} of trace {span.trace_id} with cost: {cost}")
            opik_client.update_span(
                trace_id=span.trace_id,
                parent_span_id=span.parent_span_id,
                project_name=project_name,
                id=span.id,
                total_cost=cost,
            )

# Example usage in a CRON job
if __name__ == "__main__":
    update_span_costs("your-project-name")
这段代码有几个关键点。第一,TOKEN_COST 是自定义的价格表,你可以按自己的合同价、汇率、折扣来填。第二,compute_cost_for_span 会从 span 里取 provider、model 和 usage,然后按输入、输出 token 分别计算。第三,search_spans 里用了过滤条件 type="llm" and total_estimated_cost=0,专门找那些还没有成本的 LLM span。第四,update_span 会把算出来的成本写回去,参数包括 trace_id、parent_span_id、project_name、id 和 total_cost。
这种方案特别适合以下场景:
- 使用自动成本追踪尚未支持的模型或提供商;
- 和提供商有自定义价格协议,内置价格表不适用;
- 想跟踪模型使用之外的额外成本,比如存储、检索、第三方 API;
- 需要把成本估算实现为后台进程,而不是阻塞主流程;
- 使用的集成会自动管理 span,无法在创建时直接写入成本。
文档里还给了一个提示:可以把成本更新函数作为 CRON job 运行,自动更新那些没有成本信息的 span。在生产环境里,这一点很有价值。因为线上流量不会等你,任何漏算的成本如果没人补,最后都会变成一笔糊涂账。定时补算相当于给成本数据加了一层兜底。
支持的模型、提供商和集成
Opik 目前会为以下 Python SDK 集成中的所有 LLM 调用自动计算成本:
- Google ADK Integration
- AWS Bedrock Integration
- LangChain Integration
- OpenAI Integration
- LiteLLM Integration
- Anthropic Integration
- CrewAI Integration
- Google AI Integration
- Haystack Integration
- LlamaIndex Integration
如果你正好用这些框架或 SDK,接入之后基本不用额外操心成本字段,Opik 会自己算。
支持的提供商
成本追踪支持以下 LLM 提供商,这些定义在 opik.LLMProvider 枚举里:
- OpenAI(
openai):OpenAI 托管的模型(https://platform.openai.com) - Anthropic(
anthropic):Anthropic 托管的模型(https://www.anthropic.com) - Anthropic on Vertex AI(
anthropic_vertexai):Google Vertex AI 托管的 Anthropic 模型 - Google AI(
google_ai):Google AI Studio 托管的 Gemini 模型(https://ai.google.dev/aistudio) - Google Vertex AI(
google_vertexai):Google Vertex AI 托管的 Gemini 模型(https://cloud.google.com/vertex-ai) - AWS Bedrock(
bedrock):AWS Bedrock 托管的模型(https://aws.amazon.com/bedrock) - Groq(
groq):Groq 托管的模型(https://groq.com)
这些提供商下具体支持哪些模型,可以查看 model_prices_and_context_window.json 文件。价格表更新后,自动成本估算也会跟着变化。对于使用主流模型的团队,通常不需要自己维护价格。
文档里还有一句提示:Opik 正在积极扩展成本追踪支持。如果你需要额外的模型或提供商,可以开一个 feature request,帮助团队排优先级。这一点挺务实,因为模型市场变化太快,今天的热门模型明天可能就换了一批,靠官方单方面追进度不现实,用户反馈能加快覆盖速度。
写在最后
成本追踪这件事,很容易被当成上线之后才需要考虑的“运维问题”。但从实际经验看,越早把成本可视化,后面越省事。Opik 把成本拆到 span、trace、project 三个层级,既能看到单次调用的花费,也能看整体趋势;既支持集成自动计算,也允许通过 SDK 手动传入 provider、model、usage;对于不支持的模型或自定义价格,还能在创建时设置成本,或者事后用 update_span 补算。再加上 CRON job 这种兜底手段,成本数据不至于因为某个模型没覆盖就断掉。
对于正在做 LLM 应用的团队来说,比较稳妥的做法是:先把仪表盘用起来,知道钱花在哪;再用代码接口把成本接入内部报表或告警;最后针对不支持的模型和特殊价格,建立补算流程。这样一套组合下来,成本就不再是月底账单上的一个数字,而是可以拆解、可以比较、可以优化的工程指标。Opik 提供的这些能力,本质上就是让团队在效果和成本之间,有更清楚的判断依据。


 扫一扫


 707

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


