python你实现视频自动打码,了解妨碍你观看精彩的马赛克是怎么精准形成的

好消息!Python实现视频自动打码,不用担心透露隐私了 环境咱们还是使用 Python3.8 和 pycharm2021 (其他版本也是可以的) 阅读详情

前言

嗨喽!大家好呀,这里是魔王呐~

我们在观看视频的时候,总有一些精准得马赛克挡住我们想看得地方,严重影响我们的观影体验!!

那么这些马赛克是如何精确的加上去的呢?
本次我们就来用Python实现对视频自动打码!

前期准备工作

环境咱们还是使用 Python3.8 和 pycharm2021 即可

实现原理

  1. 将视频分为音频和画面;
  2. 画面中出现人脸和目标比对,相应人脸进行打码;
  3. 处理后的视频添加声音;

模块

手动安装一下 cv2 模块 ,

pip install opencv-python 安装

模块安装问题:

如果安装python第三方模块:

  1. win + R 输入 cmd 点击确定, 输入安装命令 pip install 模块名 (pip install requests)回车
  2. 在pycharm中点击Terminal(终端) 输入安装命令

如何配置pycharm里面的python解释器?

  1. 选择file(文件) >>> setting(设置) >>> Project(项目) >>> python interpreter(python解释器)
  2. 点击齿轮, 选择add
  3. 添加python安装路径

pycharm如何安装插件?

  1. 选择file(文件) >>> setting(设置) >>> Plugins(插件)
  2. 点击 Marketplace 输入想要安装的插件名字 比如:翻译插件 输入 translation / 汉化插件 输入 Chinese
  3. 选择相应的插件点击 install(安装) 即可
  4. 安装成功之后 是会弹出 重启pycharm的选项 点击确定, 重启即可生效

image.png

素材工具

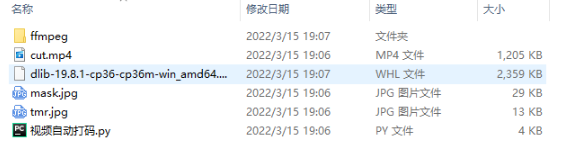
我们需要安装一下 ffmpeg 音视频转码工具
image.png

所有素材左侧或下方扫🐎即可免费领取

代码

导入需要使用的模块

import cv2  
import face_recognition  # 人脸识别库  99.7%    cmake  dlib  face_recognition
import subprocess

将视频转为音频

def video2mp3(file_name):
    """
    :param file_name: 视频文件路径
    :return:
    """
    outfile_name = file_name.split('.')[0] + '.mp3'
    cmd = 'ffmpeg -i ' + file_name + ' -f mp3 ' + outfile_name
    print(cmd)
    subprocess.call(cmd, shell=False)

打码

def mask_video(input_video, output_video, mask_path='mask.jpg'):
    """
    :param input_video: 需打码的视频
    :param output_video: 打码后的视频
    :param mask_path: 打码图片
    :return:
    """
    # 读取图片
    mask = cv2.imread(mask_path)
    # 读取视频
    cap = cv2.VideoCapture(input_video)
    # 视频  fps  width  height
    v_fps = cap.get(5)
    v_width = cap.get(3)
    v_height = cap.get(4)

    # 设置写入视频参数  格式MP4
    # 画面大小
    size = (int(v_width), int(v_height))
    fourcc = cv2.VideoWriter_fourcc('m', 'p', '4', 'v')

    # 输出视频
    out = cv2.VideoWriter(output_video, fourcc, v_fps, size)

    # 已知人脸
    known_image = face_recognition.load_image_file('tmr.jpg')
    biden_encoding = face_recognition.face_encodings(known_image)[0]

    cap = cv2.VideoCapture(input_video)

    while (cap.isOpened()):
        ret, frame = cap.read()
        if ret:
            # 检测人脸
            # 人脸区域
            源码、解答、资料、教程可加🐧:261823976免费获取~
            face_locations = face_recognition.face_locations(frame)

            for (top_right_y, top_right_x, left_bottom_y, left_bottom_x) in face_locations:
                print((top_right_y, top_right_x, left_bottom_y, left_bottom_x))
                unknown_image = frame[top_right_y - 50:left_bottom_y + 50, left_bottom_x - 50:top_right_x + 50]
                if face_recognition.face_encodings(unknown_image) != []:
                    unknown_encoding = face_recognition.face_encodings(unknown_image)[0]

                    # 对比人脸
                    results = face_recognition.compare_faces([biden_encoding], unknown_encoding)
                    # [True]
                    # 贴图
                    if results == [True]:
                        mask = cv2.resize(mask, (top_right_x - left_bottom_x, left_bottom_y - top_right_y))
                        frame[top_right_y:left_bottom_y, left_bottom_x:top_right_x] = mask
            out.write(frame)


        else:
            break

音频添加到画面

def video_add_mp3(file_name, mp3_file):
    """
    :param file_name: 视频画面文件
    :param mp3_file:  视频音频文件
    :return:
    """
    outfile_name = file_name.split('.')[0] + '-f.mp4'
    subprocess.call('ffmpeg -i ' + file_name + ' -i ' + mp3_file + ' -strict -2 -f mp4 ' + outfile_name, shell=False)

快去试试吧!欢迎在评论区讨论交流~
image.png

尾语

成功没有快车道,幸福没有高速路。

所有的成功,都来自不倦地努力和奔跑,所有的幸福都来自平凡的奋斗和坚持

——励志语录

本文章就写完啦~感兴趣的小伙伴可以复制代码去试试

你们的支持是我最大的动力!!记得三连哦~ 💕 欢迎大家阅读往期的文章呀
Python实现让视频自动打码,再也不怕出现少儿不宜的画面了 人生苦短 我用Python序言准备工作代码解析完整代码 序言 我们在观看视频的时候,有时候会出现一些奇怪的马赛克,影响我们的观影体验,那么这些马赛克是如何精确的加上去的呢? 本次我们就来用Python实现对视频自动打码! 准备工作 环境咱们还是使用 Python3.8 和 pycharm2021 即可 实现原理 将视频分为音频和画面; 画面中出现人脸和目标比对,相应人脸进行打码; 处理后的视频添加声音; 模块 手动安装一下 cv2 模块 ,pip install opencv-python 安装 安 阅读详情

相关推荐

Python实现视频自动打码,不用担心透露隐私了

Python实现自动打码,又是一个有用的知识

aliYz的博客 1万+

python_给视频打马赛克

moviepy 与 cv2 相结合对视频打马赛克(python)

qq_45301401的博客 1905

100天精通Python丨黑科技篇 —— 21、大语言模型_100天精通python快速入门到黑科技

ChatGPT 是 OpenAI 推出的一种基于 GPT-3/4 的聊天机器人。chatgpt 的颠覆性影响主要体现在提高语言交流的便捷性、个性化服务、自动化客服和教育娱乐等方面,这些应用可以为用户带来更多的便利和乐趣,同时也为企业提供了更多的服务和商机。本文收录于,是由的硬核博主倾力打造,分基础知识篇和黑科技应用两大部分,欢迎订阅本专栏,订阅后可私聊进Python全栈VIP交流群(问题解答、互相帮助)还可领取20GPython视频和100本互联网行业电子书。

m0_60452141的博客 2462

Python实现人脸识别,进行视频跟踪打码,羞羞的画面统统打上马赛克

昨天去表弟家,用了下他的电脑,不小心点到了他硬盘里隐藏的秘密,为了防止表弟被打,我用Python将他所有的视频都给打上了马赛克!

轻松学python的博客 1万+

Chrome和Firefox必备:这5款验证码自动填充插件让你告别手动输入

本文深度评测了5款适用于Chrome和Firefox浏览器的验证码自动填充插件,包括Buster、Privacy Pass等,帮助用户告别繁琐的手动输入。文章从技术原理、安装配置、使用场景及隐私安全角度进行对比分析,旨在提升用户在合法场景下的浏览效率与体验。

postgres8guard的博客 1217

Python计算机视觉:视频人脸马赛克

视频从一些方面讲其实就是一些图片,只不过图片内容的变化太快,从而使我们的眼睛觉得看到的视频是动的而已。

坚持不懈的大白的博客 783

matlab实现动态目标追踪代码_Python10行代码实现视频人脸追踪打马赛克

一、背景知识1.1、headblur简介追踪人脸打马赛克需要使用headblur函数。调用语法:headblur(clip,fx,fy,r_zone,r_blur=None)说明:其中参数fx和fy是两个函数,该函数带参数t,用于确认t时刻需要模糊化范围的中心点位置,moviepy将对以中心点为圆心半径r_zone的圆范围内的图像进行模糊化处理,模糊化处理时的卷积核大小由r_blur指定...

weixin_35760849的博客 958

手把手教你:人脸识别的视频打码(基于opencv的人脸打马赛克)

本文主要介绍如何使用python搭建:一个基于opencv和人脸识别的视频打码系统。 博主也参考过网上其他博主介绍人脸识别,或是视频加马赛克的文章,但大多是理论大于方法。很多同学肯定对原理不需要过多了解,只需要搭建出一个识别系统即可。 **本文只会告诉你如何快速搭建一个人脸识别的考勤系统并运行,原理的东西可以参考其他博主**。 也正是因为我发现网上大多的帖子只是针对原理进行介绍,功能实现的相对很少。 如果您有以上想法,那就找对地方了!

大雾的小屋的博客 6852

基于深度学习算法实现视频人脸自动打码

基于人脸检测与人脸识别实现的视频人脸自动打码功能

知来者逆的博客 3587

打码兔自动打码工具

Dama2.dll、CrackCaptcha、Dama2Interfa 注意: 软件运行前在目标机器运行"regsvr32 Dama2.dll"或调用Dama2.dll的DllRegisterServer函数注册控件

Hermes深入理解及源码解析(二):Hermes的记忆机制

源码位置:tools/memory_tool.py存储内容为两个文件,放在 ~/.hermes/memories/:MEMORY.md:Agent 自己的笔记(环境事实、项目约定、工具坑、学到的东西)—— 上限 2200 字符USER.md:关于用户的画像(角色、偏好、沟通风格)—— 上限 1375 字符作为一个独立的工具注册在系统中(为了让智能体正确使用它,System Prompt()中明确下达了禁令存储目标存储位置数据类型持久偏好/事实MEMORY.md我是谁、我喜欢什么、环境配置。

qq_41984117的博客 555

Python 图像打马赛克

图像打马赛克

CXY00000的博客 506

从零到一:用MSC Nastran Patran搞定悬臂翼颤振分析(附完整模型文件)

本文详细介绍了使用MSC Nastran和Patran进行悬臂翼颤振分析的完整流程,从几何建模、网格划分到模态分析和颤振求解。通过具体案例讲解关键参数设置和操作技巧,帮助工程师掌握气动弹性分析的核心方法,并附赠完整模型文件供实践参考。

weixin_42563415的博客 436

利用Python对图片进行马赛克处理

背景 最近项目需要用人脸检测技术把视频里面的人脸检测出来后,进行马赛克处理,人脸检测这一块就是大家熟知的利用深度学习技术来解决,之前有相关文章介绍《Python 人脸检测方法总结》,这篇文章主要介绍马赛克处理过程。 马赛克原理 图片是由一个三维数组,打马赛克就是把特定区域的值替换为其他值,项目在做的过程中经过一次升级,最开始用的是高斯马赛克,后来应客户的要求,升级为和其他软件手工打的马赛克一样的样式正规马赛克 高斯马赛克 特定区域值替换为高斯分布数值,可以利用numpy中的np.random.normal

DataShare 4821

IROS 2025机器人技术解析:从诡异设计到硬核应用

机器人技术正从传统的结构化环境应用,迈向复杂非结构化场景的深度交互。其核心原理在于通过仿生设计、多模态感知与智能控制算法,赋予机器人类似生物的适应性与交互能力。这一技术演进的价值在于突破传统机器人在极端环境、精密操作和自然交互中的瓶颈。例如,结合深度强化学习的全身动力学控制,使机器人能在废墟、管道等复杂地形中自主导航;而软体机器人技术则通过材料变形实现安全、柔顺的抓取操作。这些技术最终服务于极端环境巡检、精密装配和高端陪护等刚性应用场景,推动机器人从功能实现迈向与环境、人进行深度、智能交互的新阶段。

weixin_34006468的博客 441

MIMIC-IV数据库中患者院内死亡的单因素生存分析

目的 由易到难,对mimic-iv的查询进行实际操作,体现先前文章中提到的mimic-iv数据查询的规律。 数据分析计划 死亡,是重症患者最重要的结局指标,在MIMIC数据库中收录了院内死亡的数据,以及进出ICU的时间(和进出医院的时间),所以我们可以获得是否死亡,以及从入ICU(或入院)到死亡发生之间的时间,有了这两个指标,我们可以通过Cox单因素(参数和非参数)模型来观察ICU(和医院)内死亡的趋势,以及某个变量(比如,性别和种族等)对死亡趋势的影响,以为后续的分析奠定基础。 数据的获取 我们需要数个变

skyskytotop的博客 3182

自动打码脚本

根据位置,自动打码 # 注意!需使用python3来运行当前代码, 需要安装requests库。 # coding:utf-8 """ 工作需要整理的打码代码,这里修改了一下,让其功能更强大一点。 """ import numpy as np from PIL import Image import requests from io import BytesIO def m

funnyPython的博客 5156

AI 算力基础设施深度系列(一):从容器到 Kubernetes——算力底座的诞生

1. 容器 = Namespace(视图隔离) + Cgroup(资源限制) + Union FS(镜像分层)└── 不是虚拟机!共享内核,接近零开销2. K8S 三大设计哲学:└── 声明式 API + 控制循环 + 可扩展架构3. K8S 架构:└── 控制面 (API Server / etcd / Scheduler / Controller Manager)

warm3snow的博客 528

谷歌浏览器插件开发接口自动打码【2022年07月05日更新一下修改的点】

谷歌浏览器插件开发平台自动打码,基与python+CNN+flask一、字符验证码的训练谷歌浏览器插件的开发首先。谷歌浏览器插件必须存在的就是 **manifest.json**这个文件如何插入一段漂亮的代码片 一、字符验证码的训练 这里不再过多阐述验证码的生成以及训练,部署等情况,参考资料字符验证码识别 里面完整的封装了一套封装了比较通用的校验、训练、验证、识别、API模块,极大的减少了识别字符型验证码花费的时间和精力。 谷歌浏览器插件的开发 首先。谷歌浏览器插件必须存在的就是 manifest.json

贰月的博客 2066

斑马打印机状态监控进阶:不用SDK也能获取打印状态的3种野路子

本文介绍了三种不依赖官方SDK的斑马打印机状态监控方法,包括SGD命令、TCP端口嗅探和共享打印机日志分析。这些方案适用于老旧系统或网络受限环境,帮助运维人员实时掌握打印状态,提升设备管理效率。特别适合工业自动化和物流仓储场景中的应急处理。

weixin_42628688的博客 421

别再为模糊的3D重建头疼了!手把手教你用3DSlicer处理DICOM数据,搞定医学影像三维可视化

本文详细解析了医学影像三维重建中常见的模糊问题,并手把手教你使用3DSlicer处理DICOM数据,实现精准的三维可视化。从层厚设置到数据格式转换,再到重建算法选择和渲染参数微调,提供了一套完整的优化方案,特别适合临床医生和医学影像处理人员提升工作效率。

weixin_28693447的博客 241

《Python实战之图像马赛克创建》

cug-jdc的博客 859

3D视觉-激光三角测量法的概述和原理

激光三角法位移测量的原理是,用一束激光以某一角度聚焦在被测物体表面,然后从另一角度对物体表面上的激光光斑进行成像,物体表面激光照射点的位置高度不同,所接受散射或反射光线的角度也不同,用。激光三角测量法是一种通过图像采集系统采集被测物表面漫反射的激光轮廓,进而基于设备已知的相对位置通过算法处理,获得被测物表面的三维轮廓数据,进而还原目标物体三维空间信息的方法。采用激光三角原理和回波分析原理进行非接触位置、位移测量的精密传感器, 广泛应用于位置、位移 、厚度、半径、形状、振动、距离等几何量的工业测量。

qq_20660115的博客 3897

Web自动化---通过打码平台解决页面随机验证码

像我们之前做过UI自动化的同学就知道,自动输入账号和密码,这个简单,但是怎么样来识别验证码呢?验证码的形式有多种,有纯数字的,纯字母的,有字母和数字的,有计算的等等;而且每次都是随机出现的,这种情况我们怎么来识别呢?如何解决这个难题?

人生不怕起点低,就怕没追求 1239

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

社区版Dify实现文生视频 LLM+ComfyUI+混元视频

这个图就是我的Dify实现LLM+ComfyUI+混元视频的整个方案和思路,下面详细说说为什么可以这样做:(这部分可以结合我之前写的文章一起看,我会给出超链接)其实文生视频的开源模型其实有很多,比如:Sora,Dynamicrafter,VideoCrafter,混元视频,CogVideo等等模型。 这些模型大部分都是支持ComfyUI,这里自己去找一找就好。本方法用的是混元视频的ComfyUI这部分还不懂的强烈推荐看一下我前面写的社区版DifyLLM+ComfyUI+代码执行的方

weixin_44119512的博客 5979

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

计算机毕设推荐:基于深度学习的动物图像识别方法研究(Python+Django+PyTorch)

本文围绕基于深度学习的动物图像识别方法研究,介绍一套从数据到网站都能跑通的完整方案。数据用Kaggle公开数据集,共15类动物,按原图分组划分训练、验证和测试集,避免相近图片跨集让指标虚高。模型用PyTorch做迁移学习,主模型选ResNet-50,另训ViT和EfficientNet两个对比模型,在相同条件下评估。网站用Django加Vue搭建,支持图片、视频、摄像头三种识别,带识别历史和统计大屏。

WEIXIN_JSJBSZDS的博客 243

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

上一篇: 美女谁都爱看,跳舞的美女更是,python批量采集(含源码)
下一篇: 关于我在编程里学表白这件事。。。。【python表白代码】
魔王不会哭
博客等级 码龄5年 6002粉丝 394原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值