视频怎么自动翻译成中文字幕?AI 视频翻译的三道坎和一条捷径

基于开源AI模型的视频翻译与配音全流程自动化工具pyVideoTrans实战指南 语音识别(ASR)与语音合成(TTS)是人工智能在多媒体处理领域的核心应用,它们分别负责将语音转换为文本和将文本转换为自然语音。其原理在于利用深度神经网络模型对音频信号进行特征提取、模式识别与生成。这项技术的核心价值在于极大地提升了音视频内容的生产与本地化效率,实现了从人工逐句处理到自动化流水线的跨越。在工程实践中,通过整合如Whisper、Edge TTS等开源模型,并结合FFmpeg进行音视频流处理,可以构建出高效、低成本的多语言视频生成管道。这种技术方案广泛应用于内容创作、在线教育、企业培训及跨文化传 阅读详情

为什么 AI 视频翻译总翻车?

刷外语教程、油管采访、海外纪录片,想加中文字幕,传统做法是:先听写英文、再一句句翻译、最后把字幕条对齐回时间轴。一集 20 分钟的访谈,手动做下来 3-4 个小时起步。AI 视频翻译(video translation / video subtitle translation)听上去完美——上传视频、选源语言和目标语言,一键出字幕。但你真去试,会发现准确率忽高忽低、专有名词乱翻、字幕条和画面老是对不齐。

这不是工具不行,而是视频翻译这条流水线上有三道绕不开的坎。今天就把这三道坎讲透,再给你一条不用每个工具都试一遍的捷径。

约束一:识别这步就翻车——背景音乐和环境噪音

视频翻译的第一步,是把视频原声里的语音识别成文字(Automatic Speech Recognition, ASR)。这一步听起来已经是个"老问题",主流云厂商的中文 ASR 在干净录音上准确率能做到 95% 以上。但视频原声几乎不可能是干净录音:

  • 配着背景音乐的访谈、综艺片段
  • 多人抢话的会议录像、圆桌讨论
  • 地铁、街道、咖啡馆里录的 vlog
  • 加上片头片尾的音效和配乐

ASR 引擎遇到这些情况,准确率会从 95% 一路掉到 70-80%,口音重的甚至更低。人耳在这种场景下能依赖"鸡尾酒会效应"(cocktail party effect)挑出主讲人,但单声道音频里没有空间信息可用——这是上一篇文章讲过的老问题,视频翻译也躲不开。

工程上的兜底是:先把视频里的音频单独提出来降噪,再用 ASR 转写。这一步很多在线工具会自动做,但做得糙——一刀切降噪会把高频辅音也磨掉,反而进一步降低识别率。能拆出"人声轨 + 背景轨"分别处理的工具(典型如 AIFooler 的人声伴奏分离),识别前的音频质量明显高一个档次。

约束二:翻译质量与字幕时序,是两件不能糊弄的事

识别出源语言文字之后,下一步是翻译成目标语言。这一步表面是 NLP 翻译问题,实际上是两个独立问题:

问题 A:翻译质量

大模型翻译流畅度已经很高,但视频翻译的常见坑:

  • 专有名词错翻。人名、地名、机构名、商标——LLM 经常会"创造性翻译",把"Elon Musk"翻成"埃隆·马克斯"还行,把一个不太常见的研究员名字直接音译到失真是常态。
  • 上下文脱节。视频里的代词("他"、"这件事"、"刚刚说的那个")依赖前几秒的视觉与听觉上下文,纯文本翻译会丢语境。
  • 俚语和双关。"break a leg"这种俚语直译过来观众一脸问号。

问题 B:字幕时序

源语言一句话的长度通常和目标语言不一样长度。英文 "How are you doing today?" 六个词,翻译成中文"你今天怎么样"五个字;反过来中文长句翻英文可能差一倍。字幕必须按目标语言的句长重新切分,才能和画面口型对齐。

很多工具只做"识别 + 翻译",但不重排时间戳——结果就是字幕条全堆在视频开头,或全堆在结尾,因为引擎按源语言时间戳硬贴过去了。

真正可用的视频翻译必须在最后一步重新对齐时间戳。判断一个工具靠不靠谱,就看它支不支持「不生成时间戳 / 生成时间戳」的开关(其实是给个选项让用户根据目标语言习惯切分)以及导出的字幕文件能不能直接导入到主流剪辑软件里。

约束三:批量与一致性的工程难题

单条短视频翻译翻车还能手动修,但下面几种场景会让任何"一键工具"现原形:

  • 系列教程(10 集、20 集)。术语翻译要前后一致——第 1 集翻成"卷积神经网络",第 5 集突然变成"卷积神经网"——观众立刻出戏。
  • 多人协作。翻译一人、字幕一人、剪辑一人。中间需要传递的不只是字幕文件,还有术语表、风格指南。
  • 跨平台分发。同一段视频要发 YouTube(英文字幕)、B 站(中文字幕)、TikTok(带字幕视频)。导出格式至少要支持 SRT、VTT 和"带字幕视频"三种。

普通在线视频翻译工具一集一传,术语靠运气;专业工具会带翻译记忆(Translation Memory, TM)功能,把第 1 集翻译过的术语自动复用到后续集数里。

捷径:把识别、降噪、翻译、对齐打包成一键的工具

讲完三道坎,重点来了——有没有一个工具把上面的活都干了?

有的。云音雀的「视频翻译」(yunyinque.com/video-translator)走的就是"流水线封装"路线: 识别视频原声 → 翻译成目标语言 → 自动对齐时间戳 → 输出 TXT 字幕文件或带字幕的 MP4 视频。

整个流程 5 步搞定,下面是我用一段 1 分 25 秒的中文短视频翻成英语的实操:

Step 1:进入视频翻译页

打开云音雀官网,顶部导航点「视频翻译」。
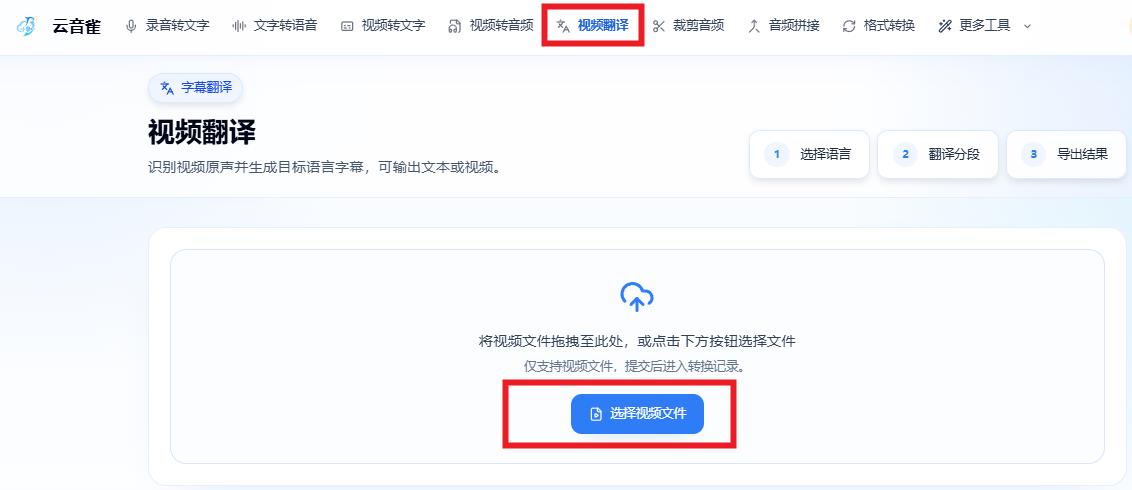
页面顶部给了三个步骤指示:① 选择语言 → ② 翻译分段 → ③ 导出结果。中间是上传区,直接把视频文件拖拽进去,或者点「选择视频文件」按钮选一个——懒得打字的人(比如我)会拖。

Step 2:上传完成 → 处理列表出现文件

视频上传完成后,页面下方会出现「处理列表」,显示文件名、大小和时长。点这个区域可以展开设置。
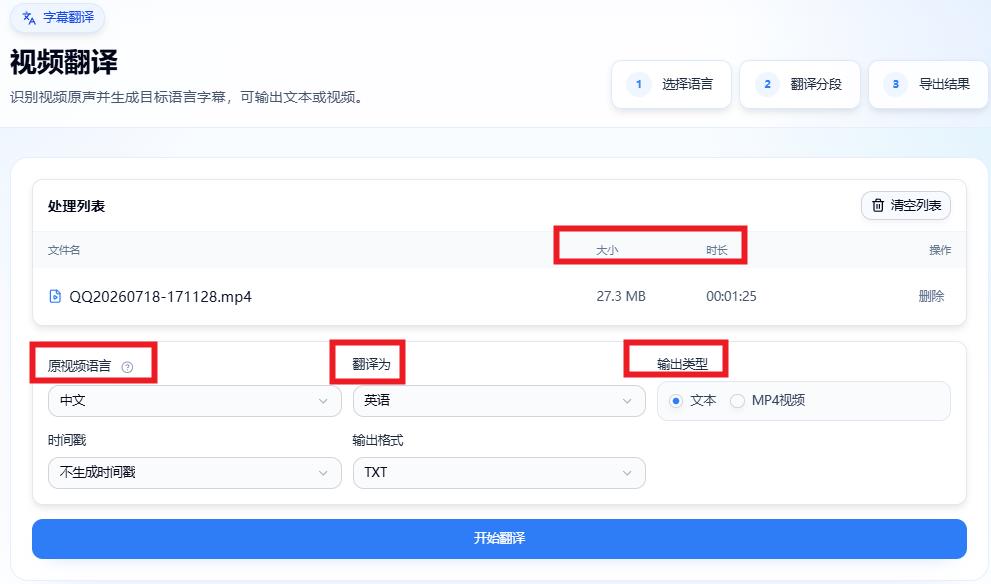
这里有三个关键下拉:

  • 原视频语言:中文(系统会自动判断,但建议手动选一下,能省一轮识别错误)
  • 翻译为:英语(目前支持中英互译以及十几种常见语种)
  • 输出类型:文本(只要字幕文件)或 MP4 视频(字幕烧进画面,适合直接发平台)

Step 3:时间戳和输出格式
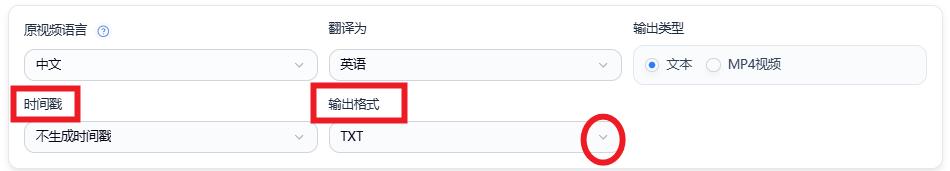
这一行两个下拉看似不起眼,其实是字幕能不能用的关键:

  • 时间戳:默认「不生成时间戳」——把整段视频识别成一个长文本,不带时间信息;如果选了「生成时间戳」,输出就是标准的 SRT 字幕文件,可以直接导入剪辑工具。
  • 输出格式:TXT(轻量,纯文字)/ DOCX(带格式,方便二次编辑)/ SRT(带时间轴的字幕)——按你的用途选。

我个人偏好:先选「生成时间戳 + SRT」,把字幕文件丢进剪映/PR/Final Cut 二次精修,比工具自动对齐来得稳。

Step 4:点「开始翻译」

设置都点完了,蓝色的「开始翻译」按钮一按,剩下的交给云端。

Step 5:上传任务创建提示
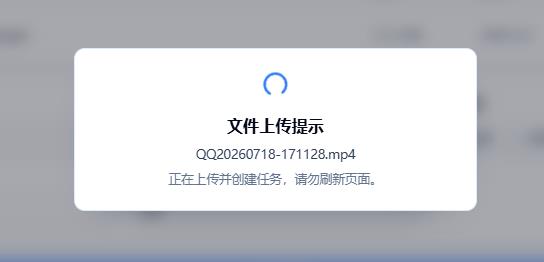
点完按钮会弹一个提示框:"文件上传提示 - 正在上传并创建任务,请勿刷新页面。" 这句提醒一定要听——刷新页面任务就丢了,前面传的视频得重新来。视频大的话上传会比较慢,1 分多钟的视频约几十秒;超过 200MB 建议先去云音雀的「视频转音频」功能把音轨单独提出来,转完再走音频翻译流程,能省一半时间。

任务创建完成后,进「转换记录」等处理,处理完就能预览、下载字幕文件或带字幕的视频。

拿到结果后还要做一件事:人工对一遍专有名词

工具再准,专有名词和俚语必须人工过一遍。这一关省不掉。专业译员的标准流程里叫 LSO(Language Service Operator)环节,对工具输出做 QA(Quality Assurance):

  • 人名、地名、品牌名对照原文修正
  • 长句按口语节奏拆成短句
  • 检查时间戳是否真的对齐(特别是快速对话段)

建议在剪映里把 SRT 字幕导入后,逐条听一遍,时间戳偏差超过 0.5 秒的手动微调。这一步 5 分钟,比让观众看着错位字幕吐槽强。

决策框架:什么时候用什么工具

最后给一张速查表——按你的场景直接对号入座:

场景

推荐路径

1-3 分钟的短视频,只为发个平台

云音雀视频翻译直接出 MP4 视频,零剪辑

5-20 分钟的访谈/教程,要精细字幕

云音雀视频翻译出 SRT → 导入剪映/PR 精修

半小时以上的纪录片/课程

先用 AIFooler 人声伴奏分离 提音轨 → 用云音雀进行视频翻译。多绕两步,准确率能上 10 个百分点

多集系列(术语要统一)

翻译完第一集后,把术语整理成对照表;后续每集翻译完成后做一次术语校对

完全离线场景

工具帮不了,自己上 Whisper + 离线翻译模型 + Aegisub 对齐——这是另一篇文章的故事了

视频翻译这件事,不要指望找到一个 100% 一键到位的工具,但可以把"识别 + 翻译 + 对齐 + 导出"这条流水线拆成几个靠谱的环节串起来。最省心的组合就是云音雀的"视频翻译"+"视频转音频"两个工具联动:先提取音轨(可选降噪),再走视频翻译出字幕文件,最后人工对一遍专有名词。一个 20 分钟的访谈,整个流程大概 30 分钟。

下一篇我会写怎么把翻译后的字幕用 AI 配音生成中英双语版本——也就是很多人问的"AI 配音 + 双语字幕"组合怎么搭。

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

相关推荐

存储&AI行业每日要闻(2026-10-25

影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题;

惠惠软件 84

云音雀(yunyinque.com)深度技术测评:一个被高估想象、被低估实用的中文音频工具箱

【摘要】云音雀(yunyinque.com)是一个面向中小创作者的网页端音视频处理工具箱,核心功能包括录音转文字、文字转语音及基础音视频编辑。该平台采用纯网页交互,支持常见格式转换和中文TTS合成(单一预设音色"擎苍"),但不具备多语种支持、情绪控制、声音克隆等进阶功能。评测显示其优势在于零部署易用性和2万字文本处理能力,适合短视频配音、会议转写等轻量需求,但与专业语音大模型平台存在代差。产品定位明确为开箱即用的实用工具,而非底层技术平台。

qq370409341的博客 928

第33章 YOLO+OpenCV:视频流网络传输

本案例演示用视觉处理库连接网络视频流并逐帧显示画面。程序先打开流地址,再循环取帧、显示、等待按键退出,并用重试计数应对连接失败与读取中断。验证时关注窗口能否稳定出画、是否长时间卡顿黑屏、退出后终端有无报错。🌈

小哥谈 539

视频转MP3怎么弄?亲测「云音雀」在线提取音频:MP4/MOV/AVI/MKV 一键转,课程采访素材整理必备

【150字摘要】云音雀「视频转音频」是一款免安装的在线工具,支持通过浏览器快速提取MP4/MOV等视频中的音频,输出MP3/WAV等格式。只需3步:上传视频→选择音质→下载音频,适合课程转听、BGM提取、采访转写等场景。相比专业软件,它无需下载、跨设备通用,尤其适合轻量需求。支持多格式输入输出,音质可调,转换记录云端保存。注意商用需确认版权,大文件建议后台处理。工具地址:yunyinque.com/video-to-audio

qq370409341的博客 486

【深度学习3】ubuntu22.04从零开始搭建深度学习环境

ubuntu22.04从零开始搭建深度学习开发环境

weixin_43387635的博客 1万+

从零构建虚幻引擎体积云:参数调优与性能平衡的艺术

本文深入探讨了在虚幻引擎中构建逼真体积云系统的关键技术,包括Sky Atmosphere、Volumetric Cloud和Exponential Height Fog三大核心组件的协同工作。重点解析了体积云材质的高级控制、光照阴影的物理模拟以及性能优化策略,帮助开发者在视觉效果与性能之间找到最佳平衡点。

weixin_29012677的博客 933

不想装软件又要字幕?5 款在线音频转写工具实测对比

做开发的人,录个技术分享要出纪要;做自媒体的,剪视频得挂字幕;学生上网课,想把老师讲的变成笔记。音视频转文字这事,几乎人人都躲不掉。 但市面上的工具,槽点一个接一个:有的必须下载客户端,几百兆装完只用一次;有的免费额度抠门,单次限十分钟,长录音得切成四五段;有的只导出 txt,想做字幕还得自己对齐时间轴;还有的按分钟收费,重度用户一个月下来比会员还贵。挑工具的时间,够把活干完了。 所以这次我拉了几款主流在线转写工具做横评,重点聊聊云音雀(yunyinque.com)

qq370409341的博客 385

Webots+UR机械臂仿真全流程:手把手教你用Python实现Pick-and-Place轨迹规划

本文详细介绍了使用Webots和Python实现UR六自由度机械臂的Pick-and-Place轨迹规划全流程。从环境搭建、运动学正逆解计算到轨迹规划实战技巧,涵盖工业场景中的关节补偿、末端校准等实际问题解决方案,帮助开发者快速掌握机械臂精准控制技术。

weixin_29083649的博客 280

刷到外语视频看不懂?云音雀一键翻译,中英字幕自己就“长“出来了

【短视频创作者的语音救星:云音雀文字转语音工具实测】 核心功能: 一键将2万字内中文文案转为MP3/WAV格式语音,支持50字试听调试 提供多音色选择,可调语速/音量/语调,满足不同场景需求 6大实用场景: 短视频口播替代重复录音 网课教程稳定旁白输出 客服/设备语音播报 长文转听书音频 多平台内容语音化 个性化语音祝福制作 优势总结:操作三步完成,音质适配剪辑软件,特别适合需要批量生成语音的自媒体、教育、客服场景。虽无法完全替代真人情感表达,但能显著提升有声内容制作效率。

qq370409341的博客 229

Windows服务器SSL漏洞修复实战:如何一键禁用TLS 1.0/1.1避免SWEET32攻击

本文提供了Windows服务器修复SWEET32漏洞的实战指南。通过组策略编辑器,详细讲解如何一键禁用不安全的TLS 1.0/1.1协议,并优化密码套件顺序,以消除由3DES等弱加密算法带来的安全风险。文章还涵盖了应对SQL Server等应用兼容性挑战的解决方案,以及企业级批量部署的脚本化方法,帮助管理员系统性地提升服务器TLS/SSL安全配置。

weixin_29310631的博客 239

PyTorch实战(7)——循环神经网络

本节介绍了循环神经网络 (RNN) 及其在序列数据处理中的应用。首先对比了卷积神经网络 (CNN) 与 RNN 的差异,指出 RNN 通过循环连接建模时序依赖关系。随后详细梳理了 RNN 的发展历程,包括基础 RNN、双向 RNN、LSTM、GRU 等变体的结构特点及改进动机,其中 LSTM 通过门控机制解决长程依赖问题,GRU 则进一步简化结构。接着通过 IMDb 情感分析实战,演示了如何使用 PyTorch 实现文本预处理、RNN 模型构建及训练评估流程,最后探讨了注意力机制如何提升 RNN 性能。

盼小辉丶的博客 1万+

MP4转MP3到底难在哪?我把云音雀的“视频转音频“拆开揉碎测了一遍

每个做视频的人,迟早都会收到这样一条消息: "视频挺好的,就是我要的是音频,你发个视频是什么意思?" 发消息的可能是导师、主编、甲方,也可能是你自己——三年前你把课程录成了MP4,今天只想在地铁上闭着眼睛"看"完它。 于是你开始搜"MP4 转 MP3"。然后你会发现,这个需求的搜索结果,一半是让你下载一个800 MB 的桌面软件,顺带全家桶;另一半是让你敲一行 FFmpeg 命令。今天来讲清楚一个纯在线的"视频转音频"工具,到底能把这些事简化到什么程度?音质会不会缩水?有没有隐藏的坑?

qq370409341的博客 539

人工智能在软件测试中的广泛应用领域

人工智能在软件测试中的应用领域涵盖了自动化测试、缺陷预测和缺陷检测、智能化测试报告生成等方面。以上提供的示例代码只是其中的一小部分,实际上,人工智能在软件测试中还有许多其他的应用。通过结合人工智能和软件测试,可以提高测试效率和质量,减少测试工作的人力成本,并帮助开发人员更好地理解和改进软件产品。人工智能(Artificial Intelligence,简称AI)在软件测试领域的应用越来越广泛。下面将介绍几个人工智能在软件测试中的主要应用领域,并提供一些相关的源代码示例。

FycPerformance的博客 452

AI 配音 + 双语字幕怎么合成 MP4 成片?字幕烧录与音画对齐的三道坎和一条捷径

AI 配音 + 双语字幕怎么合成 MP4 成片?字幕烧录与音画对齐的三道坎和一条捷径。视频合成之后最常见的是三种翻车——配音和画面对不上嘴(音画不同步)、字幕要么没有要么位置跑偏(烧录失败)、发到平台上字幕被 UI 挡住或者画面被裁(尺寸不合规)。这不是剪辑软件不行,而是成片这最后一公里有三道绕不开的坎。这篇把它们讲透,再给你一条从"三个文件"到"一键发平台"的捷径——顺带把整个系列串到终点。

qq370409341的博客 987

从 Token 到 Agent:一文串起 AI 大模型核心概念

摘要:本文系统解析了现代AI系统的八大核心概念:Token(语言处理的最小单位)、Context(AI的短期记忆)、Prompt(指令接口)、Tool(能力扩展器)、MCP(工具生态协议)、Agent(自主智能体)和AgentSkill(专业技能封装)。文章揭示了这些概念如何共同构成AI从基础语言理解到自主决策的技术脉络,重点阐述了Token对计算成本的影响、Prompt工程的重要性、Tool如何突破AI的能力边界,以及Agent如何通过"感知-规划-执行-反思"循环完成复杂任务。最后指

jundao1997的专栏 245

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

视频转文字实战:从视频提取音频到带时间戳字幕稿,聊聊ASR语音识别的门道

很多人以为「视频转文字」就是把声音变成字,一键完事。真上手才知道,它和我做音频降噪、人声分离是同一类问题——都是在跟信号较劲,只是目标不同。云音雀的「视频转文字」走三步:选视频→设参数→进转换记录等结果。它把「设参数」单独拎出来这点是合理的,因为真正影响成品的不是工具多花哨,而是这几个旋钮:识别语言:中文/英文/方言,选错整篇都歪。时间戳粒度:按句还是按词。我要做字幕就选细粒度,后期对轴省事。文本导出格式:纯文本、SRT、VTT、带时间轴的JSON等。SRT给剪辑软件吃,TXT给我自己读,JSON留着二次处

qq370409341的博客 486

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

「大车小标」自动稽核怎么落地:识别车型与计费车型如何自动比对、争议如何排除

在高速公路货车逃费里,"大车小标"是最高频、也最难缠的一类:实际是更大车型、更多轴数的货车,却按更小车型交费,跑同样的路交更少的钱。单次差额可能不大,但放到长距离、高频次、规模化运营的路网里,累积的通行费流失相当可观。自动稽核"大车小标",核心不是"识别出这是什么车"这么简单,而是要把多个来源的车型判断和最终计费车型自动比对,并在大量正常交易里把真正可疑的少数挑出来,同时把设备误差、遮挡污染造成的误判排除掉。本文拆解这条链路的工程落地思路,全文定性,不涉及具体识别率与金额。

weixin_53898122的博客 357

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 149

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 346

把GeoReady九维当工程项做:储能管理官网的AI就绪度改造笔记

GeoReady把1900多个网站的审计数据摊开,做成实时基准(State of GEO):AI搜索就绪度平均56.7/100,中位数59,一半以上卡在地基档。这篇用工程视角拆解这份基准:九维权重分别对应哪些工程项(robots.txt放行AI爬虫、llms.txt部署、Schema JSON-LD注入、Meta标签规范化、品牌实体清晰),哪些是「白给的分」,以及怎么把就绪度检查纳入CI流水线。先说结论——56.7分测的是机器可读性,是卫生指标不是排名;工程上先补最便宜的两块(llms.txt+JSON-L

RoseMarketing的博客 255

什么是AI、模型和token、vibecoding介绍、ClaudeCode环境搭建

AI是用计算机模拟人类思维与行为的技术,不具意识,仅作为能力放大器。模型是其核心,参数量决定智能水平,大模型历经文本、多模态到全模态演进。大模型按任务表现排名,如千问、DeepSeek等。收费以token为单位,按使用量或套餐计费。Vibecoding通过自然语言生成代码,工具包括ClaudeCode、Cursor等。安装可选CLI或GUI版本,需配置Python、Git、Node及大模型账号,提升开发效率。

2501_91966873的博客 262

LDR6100 智能遥控器精品软文:Type-C 充电口与低功耗量产维护

当 USB-C 接口从单纯的结构升级,变成整机供电稳定性、待机续航、量产一致性的核心瓶颈,智能遥控器、语音遥控器、手持控制器这类小型手持设备的硬件开发,早已不再是 “换一个 Type-C 座子” 那么简单。大量项目在试产阶段反复踩坑:不同品牌适配器识别失败、热插拔瞬间掉电死机、整机休眠待机电流超标导致电池续航缩水、产线测试时端口状态无法捕捉、兼容性参差不齐。乐得瑞 LDR6100 作为单路 USB-C/PD 专用控制芯片,专为小体积手持设备的 Type-C 供电入口量身打造。

LDR006的博客 411

【论文解读】DMH-Net:用深度曼哈顿霍夫变换从全景立方图估计3D房间布局

想象一个空房间,把所有面都去掉,只剩下棱┌─────────────┐ ← 墙与天花板的交界线/│ /│/ │ / │ ← 墙与墙的交界线(竖直)│ │ │ ││ / │ /└─┘───────────┘ ← 墙与地板的交界线论文的房间线框只有三类线线类型是什么在 3D 空间中的方向墙-天花板交界线​墙顶那条边水平,在天花板平面上墙-地板交界线​墙脚那条边水平,在地板平面上墙-墙交界线​两面墙相交的竖棱竖直​为什么用线框?​ 论文给的动机很有说服力:人类感知 3D 世界时,靠的是。

拜小白的成长之路,告别小白 354

Python 浏览器自动化:Selenium vs Playwright 底层原理、实现细节 + Codex 大模型为什么能自主操控浏览器登录填表

Selenium。缺点维护成本高,不适合对接 AI。Playwright,CDP+AX 语义树是核心优势。用自然语言代替硬编码选择器,让 AI 看懂网页语义,自主完成多步网页任务。传统自动化是 “人告诉程序每一步点击哪里”;AI 浏览器 Agent 是 “人告诉程序目标,AI 自己观察页面,决定点哪里,自主完成任务”。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 327

8G 显存本地部署 AI 漫剧流水线:分镜提示词版本管理、批量归档与角色提示词隔离实战教程

本文针对8G显存本地部署的AI漫剧生产中提示词混乱、版本丢失、角色画风漂移等痛点,设计并实现一套轻量化本地提示词管理系统。系统基于纯JSON文件存储,支持角色提示词隔离、分镜模板复用、项目版本快照、批量校验与导入导出,与ComfyUI流水线无缝对接,实现画风一致性与高效复现。所有功能均无需数据库,可常驻后台运行,显著提升红果短剧系列化生产的稳定性与可维护性。

2603_96706877的博客 153
上一篇: 音频合并拼接|几十段访谈拼成一集播客怎么听不出接缝?电平、底噪与留白的四个统一
下一篇: 模型解析|同一个模型分离人声为什么处理不干净?混音密度与母带压缩的三个影响
台风护盾
博客等级 码龄14年 0粉丝 91原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值