【HDFS】系统架构与存储机制

系统架构与存储机制

HDFS系统架构

img

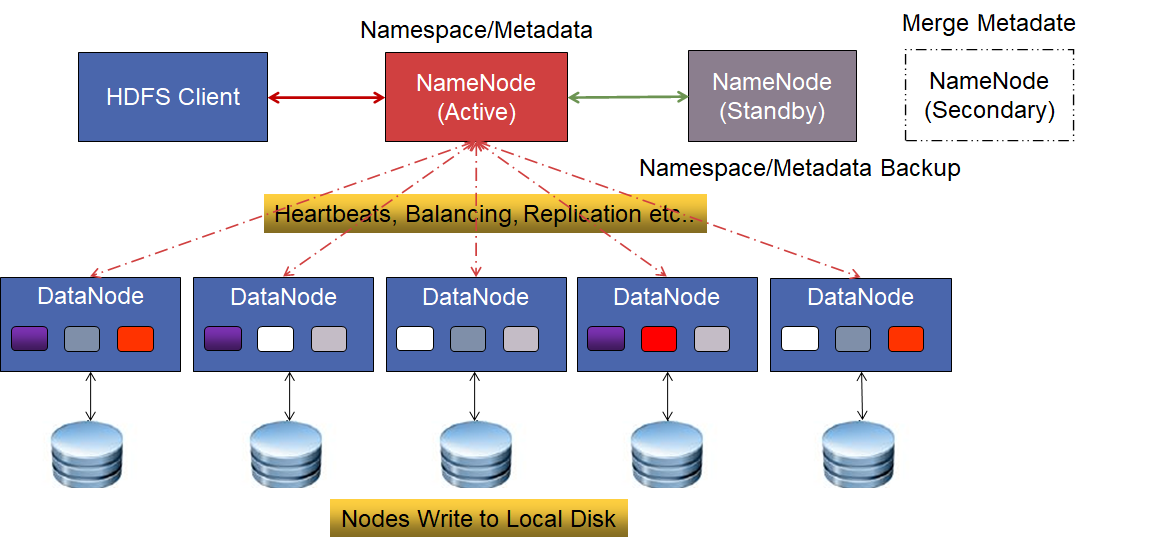
HDFS是主从架构(Master/Slave),当然这也是大数据产品最常见的架构。主节点为NameNode,从节点为DataNode。其中DataNode用于存储数据,存储的数据会被拆分成Block块(默认按照128M进行切分),然后均匀的存放到各个DataNode节点中,为了保证数据安全性,这些Block块会进行多副本的存储,备份到不同的节点。而NameNode则负责管理整个集群,并且存储数据的元数据信息(记录数据被拆分为哪几块,分别存储到了哪个DataNode中)。DataNode会通过心跳机制,与NameNode进行通信(默认3秒),汇报健康状况和存储的Block数据信息,如果NameNode超过一定时间没有收到DataNode发送的心跳信息,则认为DataNode宕机,会启动容灾机制。

HDFS Client是客户端,客户端通过与NameNode进行交互,从而实现文件的读写等操作。

NameNode在没有实现高可用的时候,会存在两个角色,NameNode和Secondary NameNode,其中Secondary NameNode并不是NameNode的热备节点,它只用于辅助NameNode的工作(元数据合并),之后会详细讲到。

NameNode如果实现了高可用,则NameNode(Active)和NameNode(Standby)互为热备节点,其中备用节点S

hdfs3.1.3——数据是怎么在DataNode上存储的? 由于面试时被问到过这个问题,那么今天就从源码角度分析下是如何存储的? 阅读详情

相关推荐

HDFS 原理代码实例讲解

HDFS 原理代码实例讲解 1. 背景介绍 1.1 问题的由来 随着大数据时代的发展,企业及个人对于数据存储的需求日益增长,传统的单机文件系统无法满足大规模数据存储需求。Hadoop Distributed File System(HDFS)应

AI天才研究院 1161

HDFS存储原理

hdfs中,文件是被划分了一堆堆的block块,那如果文件很大、以及文件很多,Hadoop是如何记录和整理文件和block块的关系呢?对于已经存在HDFS的文件,修改dfs.replication属性不会生效,如果要修改已存在文件可以通过命令。edits文件,是一个流水账文件,记录了hdfs中的每一次操作,以及本次操作影响的文件其对应的block。除了配置文件外,我们还可以在上传文件的时候,临时决定被上传文件以多少个副本存储。将全部的edits文件,合并为最终结果,即可得到一个FSImage文件。

weixin_49107940的博客 1615

Hive进阶Day05

希望对大家有帮助,谢谢大家的支持!!❤️❤️❤️

DrKYQ的博客 1288

HDFS存储机制(读写流程)

HDFS存储机制,包括HDFS的写入过程和读取过程两个部分读取过程客户端向namenode请求上传文件,namenode检查目标文件是否已经存在,父目录是否存在。Namenode向客户端返回是否可以上传。客户端请求第一个block块上传到哪些datanode服务器上。Namenode返回三个datanode节点,分别为dn1,dn2,dn3.客户端请求dn1上传数据,dn1收到请求会继续调用dn2,然后dn2调用dn3,将这个通信管道建立完成。dn1、dn2、dn3逐级应答客户端。

Clittle225的博客 2109

六、深度剖析 Hadoop 分布式文件系统(HDFS)的数据存储机制读写流程

HDFS 是一种高度分布式的文件系统,其专门为在大规模的集群环境之下存储和管理海量规模的数据而精心设计。它具备着极高的容错性、极为可靠的稳定性以及强大的可扩展性等显著特点,能够轻松处理 PB 级乃至更加庞大的数据量。HDFS 采用了主从架构的模式,主要是由 NameNode 和 DataNode 共同组成。NameNode 负责对文件系统的元数据进行管理,其中涵盖了文件名、文件的目录结构以及文件块的位置信息等等;而 DataNode 则承担着实际的数据存储任务。

DarrylDen的博客 2559

hdfs是nas_hadoop-HDFS-HA的详解

1 Hadoop 系统架构1.1 Hadoop1.x和Hadoop2.x 架构在介绍HA之前,我们先来看下Hadoop的系统架构,这对于理解HA是至关重要的,Hadoop1.x之前,其官方架构如图1所示:[ 图1.Hadoop 1.x架构图 ]从图中可看出,1.x版本之前只有一个Namenode,所有元数据由惟一的Namenode负责管理,可想而之当这个NameNode挂掉时整个集群基本也就不可用...

weixin_39939993的博客 262

HDFS架构概述

HDFS架构概述

enchantedowl的博客 5398

hadoop-HDFS-HA的详解

1 Hadoop 系统架构 1.1 Hadoop1.x和Hadoop2.x 架构 在介绍HA之前,我们先来看下Hadoop的系统架构,这对于理解HA是至关重要的,Hadoop 1.x之前,其官方架构如图1所示: [ 图1.Hadoop 1.x架构图 ] 从图中可看...

weixin_30545285的博客 198

HDFS系列 -- HDFS预研

HDFS系列 -- HDFS预研 目录 1 HDFS概述 1.1 HDFS基本特性 1.2 HDFS不足之处 1.3 HDFS系统架构 1.4 HDFS基本组成 1.4.1 NameNode 1.4.2 DataNode 1.4.3 Secondary NameNode 2.1 HDFS运行原理 2.2 HDFS数据流程 2.3 HDFS读数...

stillcoolme 958

HDFS分布式文件系统

目录 1.HDFS概述及应用场景 HDFS适合什么场景? HDFS不适合什么场景? 2.HDFS在FusionInsight产品的位置 3.HDFS系统架构 HDFS写流程: HDFS的读流程: 4.关键特性介绍 HDFS的高可靠性(HA) 元数据持久化 HDFS联邦(Federation) 数据副本机制 配置HDFS数据存储策略 分级存储 标签存储 节点组存...

小宫主的博客 871

HDFS的基本概念介绍

1. HDFS的设计思路?   hdfs是分布式的文件系统,用来在廉价的集群上做大数据量的存储。1.大文件被切割成小文件,使用分而治之的思想让很多服务器对同一个文件进行联合管理2.每个小文件做冗余备份,并且分散存到不同的服务器,做到高可靠不丢失 2. HDFS的架构? namenode:集群老大,掌管文件系统目录树,处理客户端读且请求SecondaryNamenode:持久化元数据,主要给 nam...

weixin_33860722的博客 203

hadoop,HDFS基础使用

一、HDFS前言      1、 设计思想          分而治之:将大文件,大批量文件,分布式的存放于大量服务器上。以便于采取分而治之的方式对海量数据进行运算分析     2、 在大数据系统架构中的应用         为各类分布式运算框架( MapReduce, Spark, Tez, Flink, …)提供数据存储服务     3、 重点概念: 数据块, 负载均衡, 心跳机制, 副本...

牛逸凡的博客 443

全面解析HDFS

一、介绍 1.1 什么是HDFS? HDFS(Hadoop Distributed File System),作为Google File System(GFS)的实现,是Hadoop项目的核心子项目,是分布式计算中数据存储管理的基础,是基于流数据模式访问和处理超大文件的需求而开发的,可以运行于廉价的商用服务器上。它所具有的高容错、高可靠性、高可扩展性、高获得性、高吞吐率等特征为海量数据提供了不怕故障的存储,为超大数据集(Large Data Set)的应用处理带来了很多便利。 1.2 特点 优点 存储

Alanyungz的博客 638

HDFS基础

HDFS基础

weixin_50722238的博客 589

HBase 实现原理以及系统架构详解

好用的东西,总能找到对应的开源实现,这就是开源得魅力。下面一张图看下Hbase的前世今生:HBase是一个构建在HDFS上的分布式列存储系统; HBase是基于Google BigTable模型开发的,典型的key/value系统; HBase是Apache Hadoop生态系统中的重要一员,主要用于海量结构化数据存储; 从逻辑上讲,HBase将数据按照表、行和列进行存储hadoop一

半僧 6901

HDFS技术原理

HDFS技术原理 1.HDFS的概述及应用场景 (1)HDFS基于Google发布的GFS论文设计开发。 (2)其除具备其他分布式文件系统相同特征外,还有自己特有的特性: 高容错性:认为硬件总是不可靠的。 高吞吐量:为大数据访问的应用提供高吞吐量支持。 大文件存储:支持存储TB-PB级别数据。 (3)HDFS是Hadoop技术框架中的分布式文件系统,对部署在多台独立物理机器上的文件进行管理。 (4)可用于多种场景,如: 网站用户行为数据存储 生态系统数据存储 气象数据存储 2.HDFS在Fusionlnsi

m0_46513211的博客 365

HDFS架构——NameNode

在学习NameNode之前,我们先回顾一下 HDFS 的整个系统构架。          在上一篇文章中我们讲过了 NameNode 是管理节点,里面存放元数据,那么我们先来看看元数据存储细节。 元数据存储细节     HDFS 为了保证数据的快速读写,并且要保证数据的安全,它就将元数据存在内存一份,还保存在磁盘一份,来看看元数据在内存中是如何存储的。          我们举个例

常敲代码手不抖 1320

Hadoop HDFS, YARN ,MAPREDUCE,MAPREDUCE ON YARN

HDFS 系统架构图 NameNode 是主节点,存储文件的元数据,如文件名,文件目录结构,文件属性(生成时间,副本数,文件权限),以及每个文件的块列表和块所在的DataNode等。NameNode将这些信息加载到内存并进行拼装,就成为了一个完整的元数据信息 NameNode的启动过程: 第一次启动: NameNode存储的元数据放置在: ...

weixin_30701575的博客 144

hadoop之hdfs基本原理(二)

hadoop

一个真实、有温度的无名小卒 514
上一篇: 【HDFS】分布式文件系统HDFS
下一篇: 【HDFS】读写机制与安全模式
桥路丶
桥路丶 领域专家: 大数据技术领域 领域专家: 大数据技术领域
博客等级 码龄11年 638粉丝 238原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

桥路丶

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值