



一、数据库对象介绍及基本操作

数据库下有多种模式schema,schema的表、对象。同一个schema下不能有相同名称的对象。
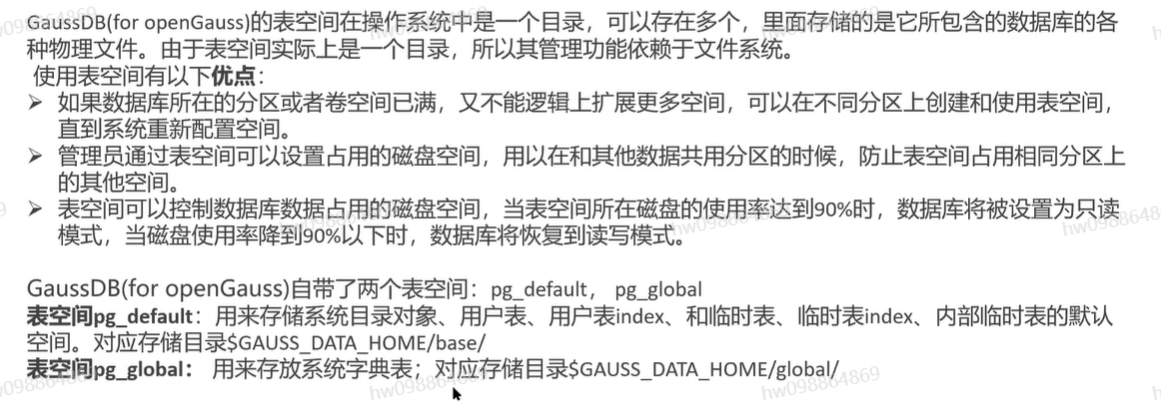
表空间就是一个存储目录,用来存放数据的位置。
个人理解:
一个GaussDB集群中有多个database,相当于一个Oracle CDB容器
每个database相当于Oracle中的PDB,
而每个库中存在多个schema,用schema做逻辑上的数据隔离,相当于Oracle中的用户。
而GaussDB中的用户可以认为是一种权限的体现。
(一)模式(schema)
概述,什么是模式?
1)GaussDB适用schema的方式对数据库进行逻辑分割。Schema功能上类似于目录,但是目录不能嵌套。
2)Schema不是严格分割的,所有的数据库对象都建立在模式的下面用户可以根据自己的权限,访问数据库中一个或多个Schema的对象。创建用户时,数据库会自动为用户创建一个Schema,同时用户也可以单独创建模式,指定其他的模式。
3)创建用户时会自动为用户创建一个同名的模式,数据库对象默认创建在Search_path路径上的第一个Schema中。数据库默认具有一个public的Schema,所有用户Search_path都有一个public的Schema。
所以到底什么是模式?
通俗的理解,模式就是类似于一个容器,用于存放不同类型的对象。可以按照业务模块或者其他方式进行划分。这样的好处是便于管理,权限控制方便,避免命名冲突。
PS :不同命名空间可以有相同的对象名称。
搜索路径
在进行查询和创建对象时,会按照search_path进行查询创建。
show search_path;

set search_path to public;
SET search_path = sch2,sch1,public;
search_path是会话级生效,创建对象时,如果没有指定schema,对象将默认创建在search_path中第一个schema中。
在没有指定schema的情况下,
开发建议
如果用户不具有sysadmin权限和不是该schema的所有者,需要授予该用户schema的使用权限和对应对象的操作权限。如果要在该schema创建对象的话,需要授予对用户授予该schema的CREATE权限。
模式管理
#创建Schema
create schema sch1;
create schema sch2 authorization user_jack; --指定owner

#修改Schema
alter schema sch1 rename sch3;
alter schema sch1 owner to user_jack;

#删除Schema及其下面所有的对象
DROP SCHEMA myschema CASCADE;

#如果schema下没有对象则删除这个schema
DROP SCHEMA IF EXISTS myschema;


注意:
不建议使用,pg_或gs_为前缀进行创建对象。
每次创建新用户都会默认创建一个同名的Schema,其他数据库如果要使用同名的Schema需要单独创建。
每个数据库都有pg_catalog schema,他包含系统所有的类型、函数、操作符。search_path始终以pg_temp(TEMP表空间)和pg_catalog作为搜索顺序中的前两位。

#切换schema
alter session set current_schema=sch3;

#收回user_jack用户在sch3模式下创建对象的权限
REVOKE CREATE ON SCHEMA sch3 FROM user_jack;

#将myschema模式的使用权交给用户jack
GRANT USAGE ON schema myschema TO jack;

#将myschema模式的使用权从用户jack回收;
REVOKE USAGE ON schema myschema FROM jack;
相关系统表或视图
pg_namespace
(二)用户
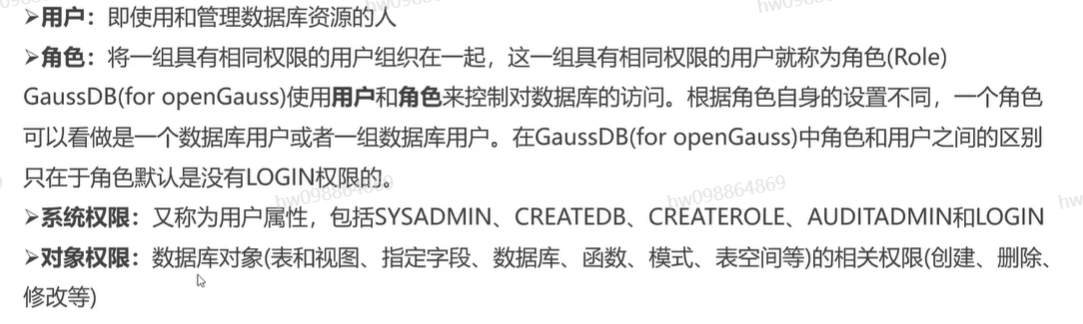
用户概述
:::info
:::
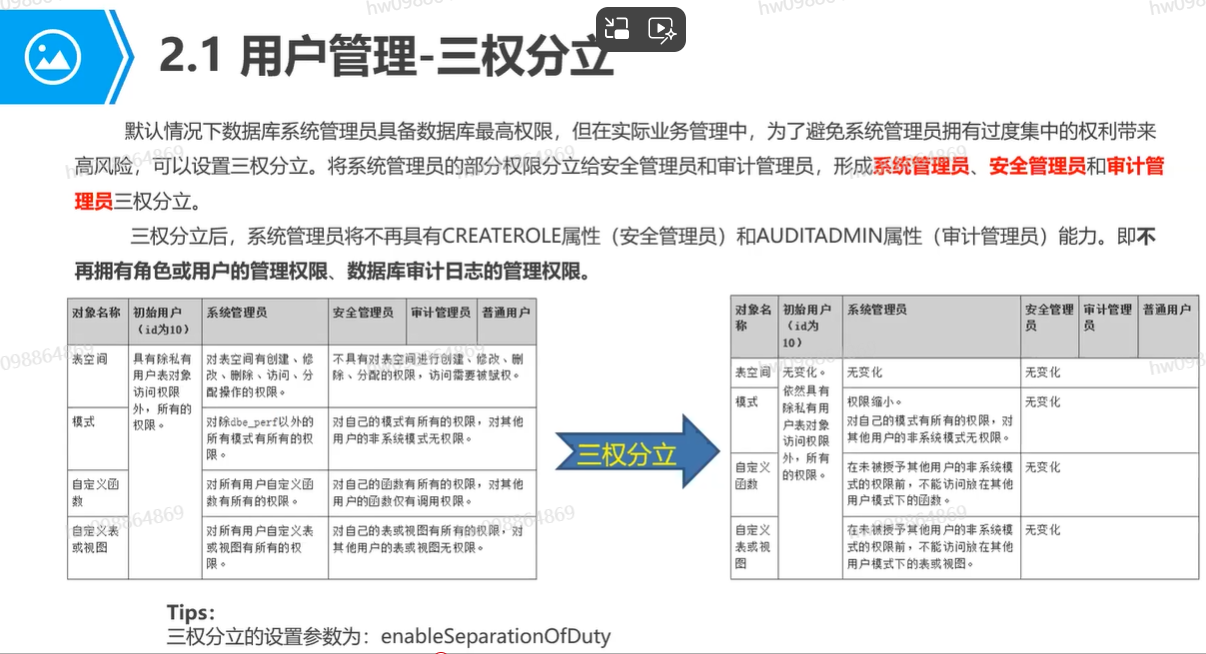
三权分立
设置GUC参数:enableSeparationOfDuty=on
SYSADMIN、CREATEROLE、AUDITADMIN三种权限相互独立,一个用户只能有以上三种权限的一种。数据库默认情况下是不开启三权分立的。
SYSADMIN:系统管理员权限,不具有创建、修改、删除用户或角色的权限,不具有查看和维护审计日志的权限
CREATEROLE:安全管理员权限,具有创建、修改、删除用户或角色的权限
AUDITADMIN:审计管理员权限,具有查看和维护审计日志的权限
:::info
:::
用户管理
#创建用户
CREATE USER user1 IDENTIFIED BY 'GaussDB@123';
CREATE USER user2 WITH SYSADMIN 'GaussDB@123'; --创建具有SYSADMIN权限的用户
CREATE USER user3 VALID BEGIN '2024-12-11 00:00:00' VALID UNTIL '2025-01-01 00:00:00' CONNECTION LIMIT 100;

#修改用户
alter user user1 with sysadmin;
alter user user2 rename user4;

#开启三权分立
$ gs_guc reload -N all -I all -c "enableSeparationOfDuty=on"
$ gs_om -t stop && gs_om -t start

#删除用户
drop user user4 ;  --GaussDB删除用户需要加cascade吗?加


#将Schema中的表或者视图对象授权给其他用户或角色时,需要将表或视图所属Schema的USAGE权限同时授予该用户或角色。否则用户或角色将只能看到这些对象的名称,并不能实际进行对象访问。
GRANT USAGE ON SCHEMA tpcds TO joe;
GRANT SELECT ON TABLE tpcds.* to joe;
默认权限机制
数据库默认情况下,三权分立功能是未开启的,数据库管理员具有与对象所有者相同的权限。可以进行**查询、创建、修改、删除对象**以及将对象授权给其他用户。
对象所有者的权限(alter、drop、grant、revoke)是隐式的,无法进行撤销和删除。即只要拥有对象,就可以具有对象的所有权限。
数据库提供对对象的隔离机制,对象隔离机制开启时,数据库会为系统表PG_CLASS、PG_ATTRIBUTE、PG_PROC、PG_NAMESPACE、PGXC_SLICE、PG_PARTITION自动添加行级访问控制策略,普通用户只能查看这些系统表中有权限访问的对象(表、视图、函数、字段)。
相关系统表或视图
pg_user
pg_roles
pg_authid
(三)表空间
概述
表空间管理
#创建表空间
create tablespace tbs1 relative location 'tablespace/tbs1' maxsize 100G ;  --相对路径存放
##若指定该参数,表示使用相对路径,LOCATION目录是相对于各个CN/DN数据目录下的。
##目录层次:CN和DN的数据目录/pg_location/相对路径。相对路径最多指定两层。
##若没有指定该参数,表示使用绝对表空间路径,LOCATION目录需要使用绝对路径。

create tablespace tbs2 location ''/gussdb/tbs/tbs2';


#查询表空间
\db
select * from pg_tablespace_location((select oid from pg_tablespace where spcname='tbs2'));
select oid,* from pg_tablespace;


#修改表空间
alter tablespace tbs3 rename tbs4;
alter tablespace tbs4 owner to jack;
alter tablespace tbs4 resize maxsize unlimited;
alter tablespace tbs4 reset (random_page_cost);   --重置random_page_cost 参数为默认值


#删除表空间
drop tablespace [if exists] tbs3;
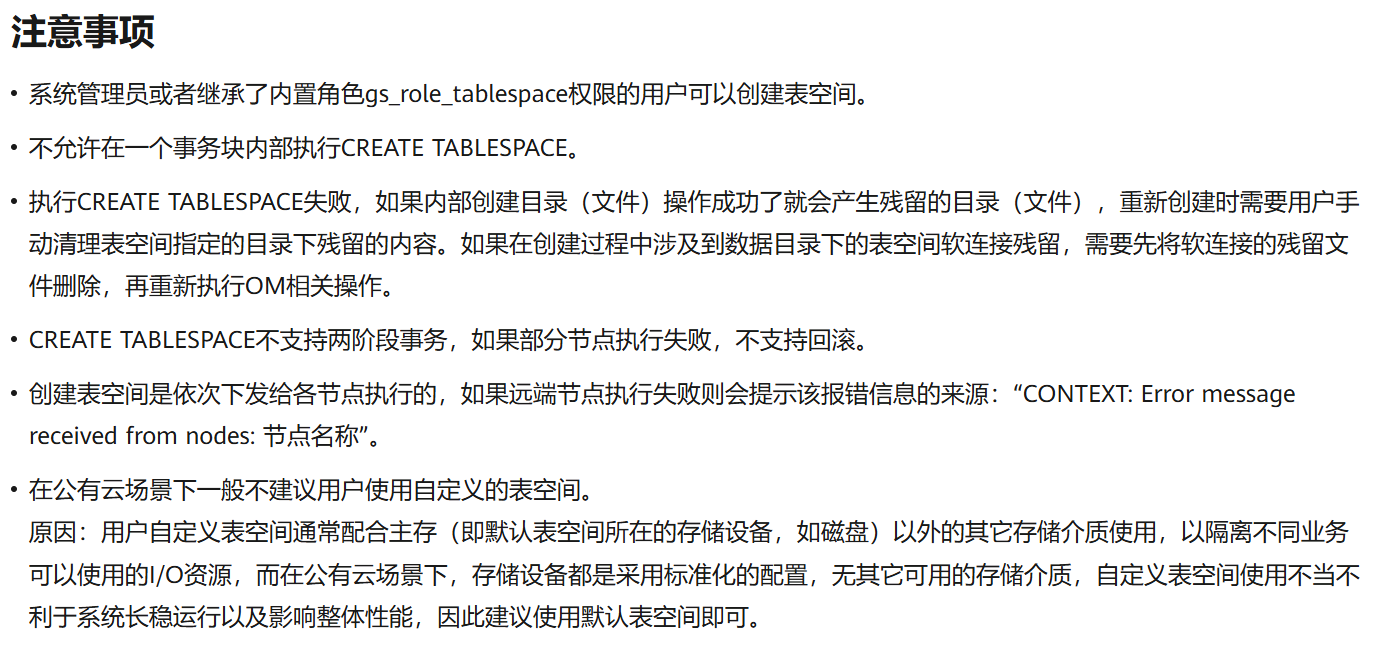
##在删除一个表空间之前,表空间里面不能有任何数据库对象,否则会报错。
##如果执行DROP TABLESPACE失败,需要再次执行一次DROP TABLESPACE IF EXISTS。
相关系统表或视图
pg_tablespace
(四)数据库管理
概述
**数据库创建:**数据库用户必须具有数据库用户创建权限或者系统管理员权限才能创建数据库。
初始时,GaussDB包含两个模版数据库template0、temolate1,以及一个默认的用户数据库postgres。CREATE DATABASE命令实际上是通过拷贝模版的方式进行创建,默认情况下拷贝template0。
我的问题:在GaussDB中数据库用户、数据库之间的关系?
一个数据库用户可以访问多个数据库,一个数据库可以被多个用户访问。
**注意事项:**如果数据库编码为SQL_ACSII,则在创建数据库时,如果对象名中包含多字节字符(例如中文),超过数据库对象名限制(63位)时,数据库会将最后一个字节截断,会出现半个字节的情况。
创建数据库遵循条件:
保证数据库对象名称不超过限制长度。
修改数据库的默认存储编码集(server_encoding)为utf-8
不要使用多字节字符作为对象名。
数据库管理
#创建数据库
CREATE DATABASE mydb2;
CREATE DATABASE mydb3 template templatea;
CREATE DATABASE mydb4 with owner=jack encoding='utf-8' LC_COLLATE='zh_CN.UTF-8' LC_CTYPE='zh_CN.UTF-8' DBCOMPATIBILITY='A' TABLESPACE=tbs1 CONNECTION LIMIT=1000;
##owner 拥有者、encoding 编码、LC_CLLATE 字符集、LCCTYP 字符分类、DBCOMPATIBILITY 兼容模式、TABLESPACE 默认表空间、CONNECTION LIMIT 并发连接限制

#修改数据库属性
alter database mydb3 rename mydb5;
alter database mydb2 owner owner1;
alter database mydb1 set tablespace tbs1;

#删除数据库
drop tablespace tbs3;

#查询数据库
\l
select * from pg_database;
相关系统表或视图
pg_database
(五)普通表管理
表的存储方式,存储规划
概述
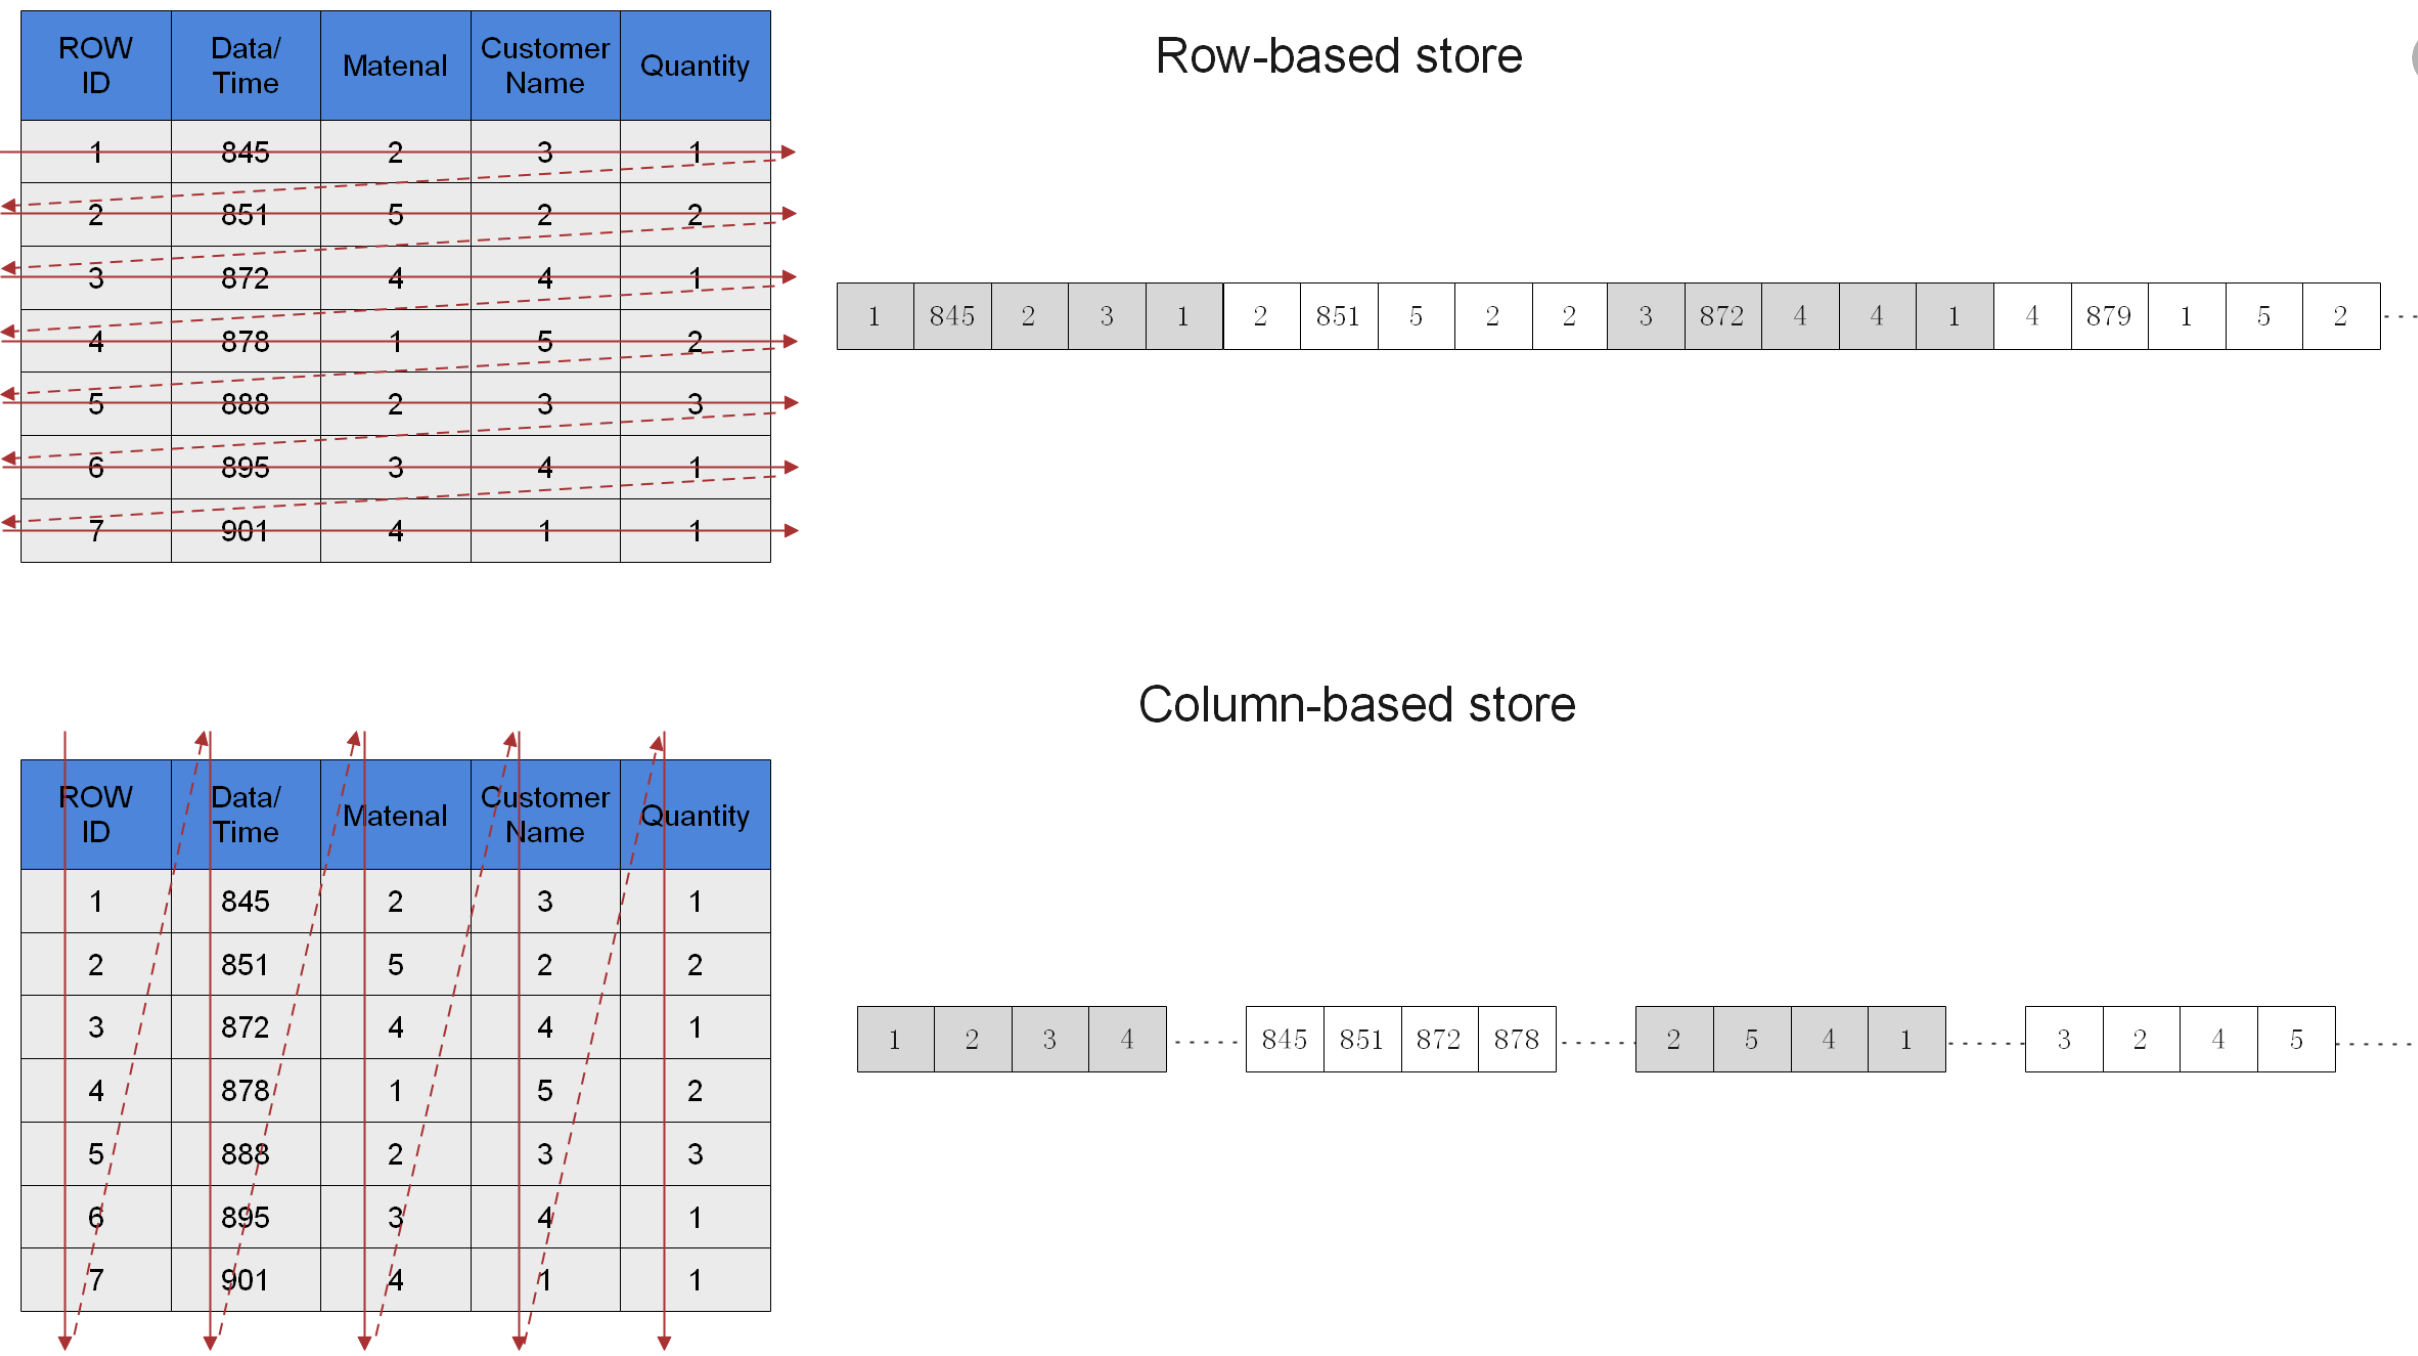
GaussDB支持行列混合存储,行列存储模型各有优势。默认情况下创建的表为行存储。
**行存储:**将表按照行存储到硬盘分区上
**列存储:**将表按照列存储到硬盘分区上
:::info
:::
行存储和列存储的优缺点
| 存储模型 | 优点 | 缺点 |
|---|---|---|
| 行存 | 数据被保存在一起。INSERT/UPDATE容易。 | 选择(Selection)时即使只涉及某几列,所有数据也都会被读取。 |
| 列存 | + 查询时只有涉及到的列会被读取。 + 投影(Projection)很高效。 + 任何列都能作为索引。 | + 选择完成时,被选择的列要重新组装。 + INSERT/UPDATE比较麻烦。 |
适用场景
| 存储类型 | 适用场景 |
|---|---|
| 行存 | + 点查询(返回记录少,基于索引的简单查询)。 + 增、删、改操作较多的场景。 |
| 列存 | + 统计分析类查询 (关联、分组操作较多的场景)。 + 即席查询(查询条件不确定,行存表扫描难以使用索引)。是否有具体的场景? |
行存表和列存表的选择
- 更新频繁程度
数据如果频繁更新,选择行存表。
- 插入频繁程度
频繁的少量插入,选择行存表。一次插入大批量数据,选择列存表。
- 表的列数
表的列数很多,选择列存表。
- 查询的列数
如果每次查询时,只涉及了表的少数(<50%总列数)几个列,选择列存表。
- 压缩率
列存表比行存表压缩率高。但高压缩率会消耗更多的CPU资源。
普通表管理
#创建普通表
CREATE TABLE EMP1 AS SELECT * FROM EMP WHERE 1=2;
CREATE TABLE EMP2 AS TABLE EMP;
##默认情况下为行存表,使用WITH (ORIENTATION = COLUMN) 表示指定当前表为列存表
##WITH(fillfactor=70) 设置表的填充因子,预留部分空间用于更新。一个表的填充因子(fillfactor)是一个介于10和100之间的百分数。在Ustore存储引擎下,该值的默认值为92,在Astore存储引擎下默认值为100(完全填充)。如果指定了较小的填充因子,INSERT操作仅按照填充因子指定的百分率填充表页。

#创建临时表
CREAET TEMPORARY TABLE (...) ON ROW COMMIT DELETE ROWS;


#修改表的属性
alter table emp1 modify sal number(10,2);
alter table emp1 rename column ename to name ;
alter table emp1 add primary key (empno);
alter table emp1 add constraint chk_dept check (empno is not null);
alter table emp1 add constraint fk_dept foreign key(deptno) references dept(deptno);
alter table emp1 modify sal constraint check not null;
alter table emp1 set schema jack;

#行级访问控制
CREATE USER alice PASSWORD 'XXXX';
CREATE TABLE ALL_DATA(ID INT,role varchar(100),date varchar(100));
INSERT INTO ALL_DATA VALUES(....);
GRANT SELECT ON ALL_DATA TO alice;
ALTER TABLE ALL_DATA ENABLE ROW LEVEL SECURITY; --开启行级访问控制
CREATE ROW LEVEL SECURITY POLICY ALL_DATA_RLS ON ALL_DATA USING(ROLE=CURRENT_USER);
\C alice
select * from all_data;


#删除表
drop table emp1;
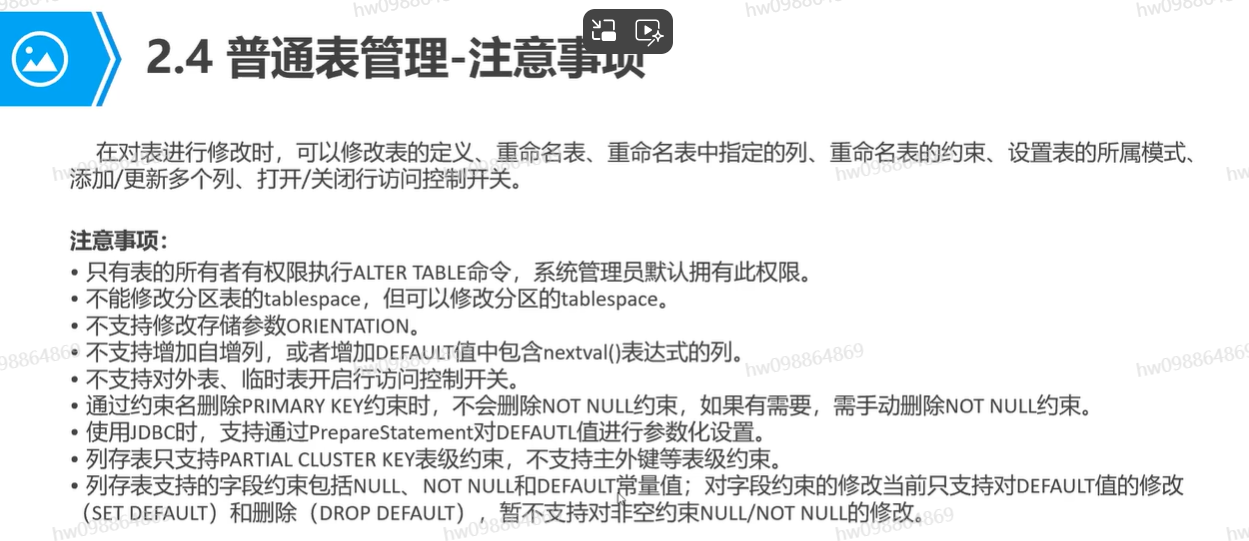
注意事项
相关系统表或视图
pg_tables
pg_stats
PG_STAT_ALL_TABLES
ADM_TAB_HISTOGRAMS
ADM_TAB_STATISTICS
DB_TAB_MODIFICATIONS
(六)分区表
概述
分区表是把逻辑上的一张表根据某种方案分成几个物理块进行存储。这张逻辑上的表称为分区表。物理块称为分区。分区表是一个逻辑表不存储数据,数据实际存放在分区上。
分区表管理
#创建分区表
CREATE TABLE t1_part_dup PARTITION BY RANGE(a)
(
    PARTITION p1 VALUES LESS THAN(10),
    PARTITION p2 VALUES LESS THAN(20),
    PARTITION p3 VALUES LESS THAN(MAXVALUE)
) AS SELECT * FROM t1;

#删除分区
alter table pt1 drop partition p3;

#新增分区
alter table pt1 add partition p3 values less than(95);

#修改分区
alter table pt1 rename partition p3 to pmax;
alter talbe pt1 move partition p3 tablespace tbs1;
alter table pt1 split partition p3 at (90) into (partition p4 ,partition p5);
alter table pt1 merge partitions p4,p5 into partition p3 ;
alter table pt1 exchange partition (p3) with table t1 ;

#查看分区表信息
pg_partition
pg_tab_partition

#查看分区大小
SELECT pg_size_pretty(pg_partition_size(oid,oid));    ----第一个oid为表的OID,第二个oid为分区的OID
SELECT pg_size_pretty(pg_partition_size('text', 'text'));     ----第一个text为表名,第二个text为分区名
相关系统表或视图
ADM_TAB_PARTITIONS
ADM_PART_TABLES
(七)索引
索引管理
在GaussDB中分区表维护是否会对索引造成影响?
#创建索引
CREATE INDEX IDX_NO ON EMP1(EMPNO);
#创建部分索引
CREATE INDEX IDX_NO ON EMP1(EMPNO) WHERE EMPNO<10;
#创建全局/本地索引
CREATE INDEX IDX_NO ON EMP1(EMPNO) GLOBAL/LOCAL;

#修改索引
alter index idx_no unusable;
alter index idx_no rebuild;

#修改分区索引
alter index idx_no rebuild partition p1;
alter index idx_no modify partition p1 unusable;
alter index idx_no move partition p1 tablespace tbs1;

#删除索引
drop index idx_no;
相关系统表或视图
pg_indexes
adm_indexes
(八)视图
概述
虚表,数据库只保存视图相关的定义,数据仍存放在数据库基表中。基表数据改变,查询数据也会改变。
物化视图:实体表,手动或定时的根据SQL将查询结果更新到实体表中。
视图管理
#创建视图
CREATE VIEW V1 AS SELECT ......
CREATE MATERIALIZED VIEW MV1 TABLESPACE TBS1 AS SELECT ......

#查询视图定义
select pg_get_viewdef('viewname');

#管理视图
alter view v1 rename v2;
alter view v1 owner own2;
refresh materialized view v1 ;

#删除物化视图
drop view v1 ;
drop materialized view mv1;
相关系统表或视图
pg_views
adm_views
(九)序列
概述
序列是数据库产生一组唯一整数的数据库对象。序列的值是按照一定规则自增的。
序列管理
#创建序列
CREATE [ LARGE ] SEQUENCE name [ INCREMENT [ BY ] increment ]
    [ MINVALUE minvalue | NO MINVALUE | NOMINVALUE ] [ MAXVALUE maxvalue | NO MAXVALUE | NOMAXVALUE]
    [ START [ WITH ] start ] [ CACHE cache ] [ [ NO ] CYCLE | NOCYCLE ]
    [ OWNED BY { table_name.column_name | NONE } ];

##name
##将要创建的序列名称。
##取值范围: 仅可以使用小写字母(a~z)、 大写字母(A~Z),数字和特殊字符"#","_","$"的组合。
##
##increment
##指定序列的步长。一个正数将生成一个递增的序列,一个负数将生成一个递减的序列。
##缺省值为1。
##
##MINVALUE minvalue | NO MINVALUE| NOMINVALUE
##执行序列的最小值。如果没有声明minvalue或者声明了NO MINVALUE,则递增序列的缺省值为1,递减序列的缺省值为-2的63次方-1。NOMINVALUE等价于NO MINVALUE
##
##MAXVALUE maxvalue | NO MAXVALUE| NOMAXVALUE
##执行序列的最大值。如果没有声明maxvalue或者声明了NO MAXVALUE,则递增序列的缺省值为2的63次方-1,递减序列的缺省值为-1。NOMAXVALUE等价于NO MAXVALUE
##
##start
##指定序列的起始值。缺省值:对于递增序列为minvalue,递减序列为maxvalue。
##
##cache
##为了快速访问,而在内存中预先存储序列号的个数。
##缺省值为1,表示一次只能生成一个值,也就是没有缓存。
##说明:不建议同时定义cache和maxvalue或minvalue。因为定义cache后不能保证序列的连续性,可能会产生空洞,造成序列号段浪费。
##
##CYCLE
##用于使序列达到maxvalue或者minvalue后可循环并继续下去。
##如果声明了NO CYCLE,则在序列达到其最大值后任何对nextval的调用都会返回一个错误。
##NOCYCLE的作用等价于NO CYCLE。
##缺省值为NO CYCLE。
##若定义序列为CYCLE,则不能保证序列的唯一性。
##
##OWNED BY
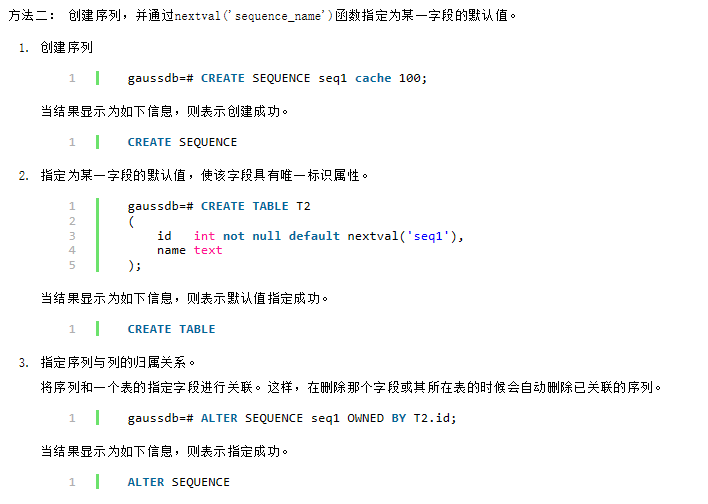
##将序列和一个表的指定字段进行关联。这样,在删除那个字段或其所在表的时候会自动删除已关联的序列。关联的表和序列的所有者必须是同一个用户,并且在同一个模式中。需要注意的是,通过指定OWNED BY,仅仅是建立了表的对应列和sequence之间关联关系,并不会在插入数据时在该列上产生自增序列。
##缺省值为OWNED BY NONE,表示不存在这样的关联。
##须知:通过OWNED BY创建的Sequence不建议用于其他表,如果希望多个表共享Sequence,该Sequence不应该从属于特定表。


#修改序列
ALTER [ LARGE ] SEQUENCE [ IF EXISTS ] name
    [MAXVALUE maxvalue | NO MAXVALUE | NOMAXVALUE | CACHE cache]
    [ OWNED BY { table_name.column_name | NONE } ] ;

#删除序列
DROP SEQUENCE serial;


#使用序列
select nextval('seq1');
select seq1.nextval;       ---获取一个新的sequence
select currval('seq1');
select seq1.currval;       ---查看当前sequence

查看序列
\d seq1
\ds seq1
(十)同义词
概述
synonym同义词是数据库对象的别名,用来记录与其他数据库对象间的映射关系,用户可以使用同义词访问关联的数据库对象。
同义词管理
#创建同义词
CREATE [ OR REPLACE ] SYNONYM synonym_name FOR object_name;
##synonym
##创建的同义词名字,可以带模式名。
##取值范围:字符串,要符合标识符的命名规范。
##
##object_name
##关联的对象名字,可以带模式名。
##取值范围:字符串,要符合标识符的命名规范。

#修改同义词
ALTER SYNONYM synonym_name OWNER TO new_owner;

#删除同义词
DROP SYNONYM [ IF EXISTS ] synonym_name [ CASCADE | RESTRICT ];
相关系统表或视图
pg_synonym
adm_synonyms


 扫一扫


 1102

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


