ambari2.8.0与bigtop编译与制作镜像源

Ambari+Bigtop大数据平台安装部署指南(Centos7)二 上篇文章已经完成ambari界面化操作前的所有操作,本篇将从ambari界面化安装bigtop大数据组件开始。 阅读详情

记录一次编译ambari2.8.0与bigtop遇到的问题,ambari的官方文档链接:https://cwiki.apache.org/confluence/display/AMBARI/Installation+Guide+for+Ambari+2.8.0

ambari源码包地址:https://github.com/apache/bigtop/tree/branch-3.2

下载完源码包后先传到服务器中

在编译源码包前先安装环境
安装依赖防止报错

yum install -y python-devel
yum install fuse
yum install ant

安装R语言和对应包,不然编译sparkr的时候会报错

#先执行命令安装EPEL仓库
yum install epel-release
#再安装R语言
yum install R

#进入R语言环境安装以下包
install.packages(“knitr”)
install.packages(“rmarkdown”)
install.packages(“e1071”)
install.packages(“testthat”)

安装 setuptools:

yum install -y wget
wget https://pypi.python.org/packages/2.7/s/setuptools/setuptools-0.6c11-py2.7.egg#md5=fe1f997bc722265116870bc7919059ea
sh setuptools-0.6c11-py2.7.egg

安装 nodejs 环境

sudo yum install epel-release -y
sudo yum install nodejs -y

安装npm

sudo yum install npm

升级nodejs

sudo npm install n -g
sudo n stable

检查npm和nodejs是否安装成功

node -v
npm -v

编译之前需要先安装maven(安装的版本需要3.6.3以上不然编译spark会报错),maven仓库建议用华为的镜像maven仓库

<mirror>
		<id>huaweicloud</id>
		<mirrorOf>*</mirrorOf>
		<name>华为云公共仓库</name>
		<url>https://mirrors.huaweicloud.com/repository/maven/</url>
</mirror>

编译ambari2.8.0源码
```powershell
cd apache-ambari-2.8.0-src
mvn clean install rpm:rpm -DskipTests -Drat.skip=true 

编译完成后
从 ambari-server/target/rpm/ambari-server/RPMS/noarch/ 安装rpm包:yum install ambari-server*.rpm

安装完后,依次执行以下命令
先在mysql中建立ambari数据库和ambari的mysql用户

#创建数据库

mysql -uroot  -pabcd1234 -e "create database ambari;create database hive;"

#创建用户并授权

mysql -uroot  -pabcd1234 -e "use ambari; create user 'ambari'@'%' identified by 'ambari123' ;GRANT ALL PRIVILEGES on *.* To 'ambari'@'%' IDENTIFIED BY 'ambari123'; FLUSH PRIVILEGES;"

mysql -uroot  -pabcd1234 -e "use hive; create user 'hive'@'%' identified by 'ambari123' ;GRANT ALL PRIVILEGES on *.* To 'hive'@'%' IDENTIFIED BY 'ambari123'; FLUSH PRIVILEGES;"
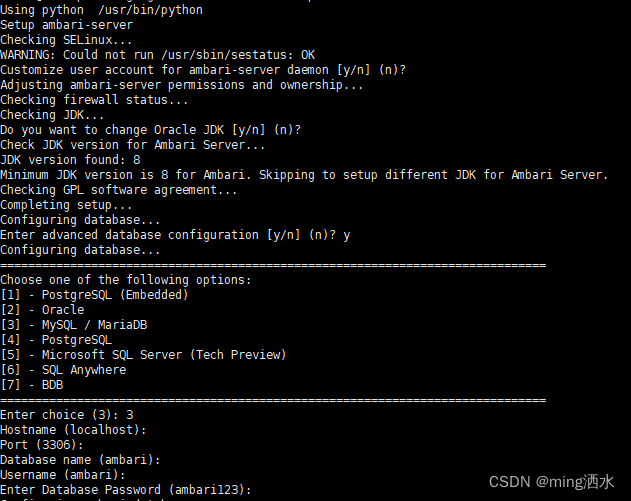
ambari安装命令
ambari-server setup
在这里插入图片描述
按照他的英文一步步走,最后需要输入mysql-connector-java的jar包地址

安装完后在mysql的ambari数据库中运行Ambari-DDL-MySQL-CREATE.sql这一sql文件
/var/lib/ambari-server/resources/Ambari-DDL-MySQL-CREATE.sql

启动命令:ambari-server start

在每一台主机上都安装这个
从 ambari-agent/target/rpm/ambari-agent/RPMS/x86_64/ 复制 rpm 包并运行:yum install ambari-agent*.rpm

编辑

/etc/ambari-agent/ambari.ini

确保 [server] 部分下的主机名指向实际的 Ambari Server 主机,而不是“localhost”
然后运行命令:ambari-agent start

编辑

/etc/profile.d/my.sh
这个my.sh文件是自建的不是系统自带的
在my.sh文件里填入
export buildNumber=2.8.0.0

【支持Ubuntu22】Ambari3.0.0+Bigtop3.2.0——Step1—基础环境准备 本文介绍了在Ubuntu 22.04 LTS上配置多节点集群的注意事项和详细步骤。主要内容包括:1)规范化修改所有节点主机名并同步维护/etc/hosts文件;2)配置国内APT镜像源(推荐自建私服或使用阿里云等公有镜像);3)批量安装大数据平台所需的基础系统工具和开发依赖包,涵盖编译工具、安全认证、网络监控等组件。文章特别强调Ubuntu系统与其他Linux发行版的差异,提供了完整的命令和配置示例,并详细说明了各依赖包的作用场景。 阅读详情

相关推荐

BigTop3.2.0 大数据组件编译--组件编译

接上篇环境准备,环境准备好以后就可以开始bigtop大数据组件编译了,建议使用科学上网方式,降低网络连接报错,主要网络报错出现在nodejs npm yarn bower等前端资源的下载上。搞定网络问题后,按本文的方式可以完成大数据相关组件的编译,编译后生成的rpm包在output目录中,包含源码rpm和二进制rpm。

m0_48319997的博客 6176

19、大数据处理:Apache Bigtop与内存计算技术深度解析

本文深入探讨了Apache Bigtop框架及其在大数据处理中的应用,重点解析了其集成测试框架iTest的故障注入机制和简化测试流程的烟雾测试。同时,文章对比了传统磁盘优先与现代内存优先的计算模型,介绍了Apache Ignite、Spark和HBase等技术的优势与应用场景。特别强调了Apache Ignite在加速MapReduce、实现状态共享和快速SQL查询方面的高级功能,并讨论了HDFS内存缓存策略。整体内容涵盖大数据处理架构、测试验证、性能优化及实际行业应用,为构建高效、可靠的大数据系统提供了全

python9snake的博客 140

17、基于 Apache Bigtop 的 Hadoop 数据处理栈开发与部署

本文深入探讨了基于 Apache Bigtop 构建、验证、部署和管理 Hadoop 数据处理栈的完整流程。从基础概念入手,介绍了 Hadoop 生态系统中各组件的集成与版本管理,并详细阐述了 Bigtop 的四大子系统:物料清单(BOM)、Gradle 构建系统、iTest 集成测试框架和 Puppet 部署层。文章还展示了如何配置开发环境、定义组件依赖、构建二进制包、部署分布式集群,并通过 iTest 和 Jenkins 实现自动化测试与持续集成。结合流程图和实际操作示例,为开发者、数据科学家和企业供应

python9snake的博客 207

从零到千兆:KSZ9031 PHY芯片在Zynq PS端的驱动移植心路历程

本文详细记录了在Xilinx Zynq-7000平台(基于XC7Z020芯片)上,为KSZ9031千兆以太网PHY芯片移植LwIP协议栈驱动的完整过程。从硬件连接配置、Vivado工程设置到LwIP库的深度修改与调试,分享了解决PHY识别、自协商及性能优化等关键问题的实战经验,助力开发者实现稳定的千兆网络连接。

honey的博客 1094

STM32F4驱动ADS1220高精度ADC:从SPI配置到数据校准的完整实战指南

本文详细介绍了如何使用STM32F4微控制器驱动ADS1220高精度ADC,涵盖从SPI接口配置、寄存器设置到数据采集与校准的全过程。通过实战代码示例和硬件设计要点,帮助开发者快速构建高精度数据采集系统,适用于工业测量和精密仪器等应用场景。

weixin_26918763的博客 217

ADF4002分频器避坑指南:常见配置错误及解决方案

本文深入解析了ADF4002分频器在实战应用中的常见陷阱与解决方案。内容涵盖寄存器配置逻辑、硬件PCB布局要点、软件驱动时序细节及系统化调试方法,重点阐述了如何避免因配置错误导致芯片无法正常工作的问题,帮助工程师高效完成高精度频率合成系统设计。

weixin_29192141的博客 90

想重装OpenClaw?先执行这4步彻底卸载,避免配置冲突

在重装OpenClaw之前,彻底卸载是非常重要的一步。如果不彻底卸载,可能会导致: - 残留的配置文件与新安装的版本冲突 - 旧的依赖包干扰新的安装过程 - 服务冲突导致启动失败 - 数据混乱影响系统稳定性

一键难忘的博客 1034

栅格数据做相关性分析前的预处理(批量定义投影、栅格投影、重采样)

最近在做两个栅格数据的相关性分析,这个最主要的是两个栅格数的行列号是一致的(也就是说坐标系、分辨率一致),那么标准的栅格数据的分辨率是以米的形式存在的,但是有一些栅格数据是以度为单位存在的,所以在做分析前,一定要先把其转换为米,否则在重采样的时候就会出错。(相关文章——栅格数据以度为单位变为以米为单位的简单做法)当然,在变其分辨率的单位前,一定要将其坐标系转换为一致。所以就有以下的步骤(如何将两个栅格数据的坐标系、分辨率的单位和分辨率一致) 1.首先,要看两个栅格数据的坐标系是否一致,如果不一致,要先统一到

qq_41828818的博客 8342

2ED2410-EM的使用

2ED2410-EM的使用

让你爱上电路设计 949

在Qt中集成VTK和PCL:实现数据可视化的完整指南

在现代软件开发中,数据可视化至关重要。将VTK(Visualization Toolkit)和PCL(Point Cloud Library)集成到Qt环境里,能为开发者提供强大的可视化解决方案。本文将深入讲解如何在Qt中读取PCL文件,展示VTK模型和PCL数据,适合想要在Qt项目中实现数据可视化的开发者。

轩宇的博客 910

从SOMEIP看SOA,汽车电子电器架构的转变

从SOMEIP看SOA,汽车电子电器架构的转变

天赐好车的博客 235

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

上一篇: apache镜像网站
ming洒水
博客等级 码龄8年 1粉丝 7原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值