


代码逐句分析
一、文章来源
初学WGCNA,觉得博主的代码写的很不错,但其中很多代码在第一遍看的时候有很多地方不理解,后查阅了很多资料,终于看明白了,于是写了一篇笔记,记录自己的学习心得,有不准确的地方,还望各位大佬们不吝赐教~
原文链接:WGCNA简明指南
二、基因共表达网络构建及模块识别
1.数据导入、清洗及预处理
示例数据下载:https://horvath.genetics.ucla.edu/html/CoexpressionNetwork/Rpackages/WGCNA/Tutorials/FemaleLiver-Data.zip
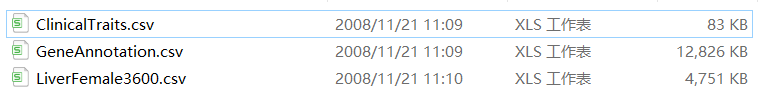
打开后是这样的,一共包括三个文件,依次是:
①临床性状文件,里面有样本名,各性状数据,其他无用数据
②基因注释文件,包含基因ID与基因名之间的对应关系,方便后面转换
③基因表达矩阵,样本名以及各基因的表达量构成的表达矩阵
三个文件可以自己打开看一下
注:如果library(‘WGCNA’)出现问题,请转链接:WGCNA包安装
# BiocManager::install("WGCNA")
library('WGCNA')
# 在读入数据时,遇到字符串之后,不将其转换为factors,仍然保留为字符串格式
options(stringsAsFactors = FALSE)
# 导入示例数据,这里填写自己存放表达矩阵的路径
femData = read.csv("D:\\desktop\\FemaleLiver-Data\\LiverFemale3600.csv")	# femData代表该文件
# 查看数据
dim(femData)	# dim查看矩阵形状
names(femData)	# names查看列标,即每一列的标题
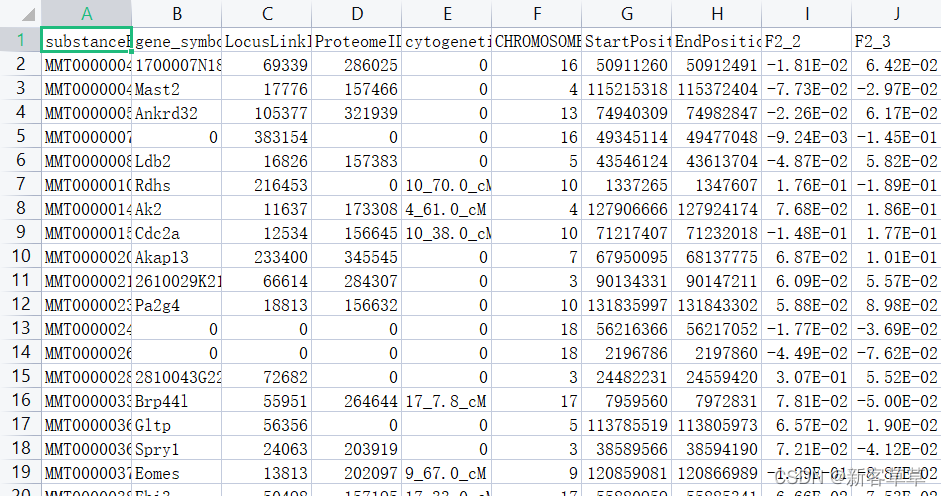
*** 此时femData存放的是带有其他信息的各样本的基因表达量
如下图,行标MMT…表示基因名,列标F2_2这种表示样本名,但还有其他的无用的列,所以需要把这些列删除
# 提取样本-基因表达矩阵
datExpr0 = as.data.frame(t(femData[, -c(1:8)]))
# 删除femData矩阵第1到8列,再转置,再变为数据格式,将所得用datExpr0表示
# 第一列是基因名,也删除了,即要以所有列标都是样本名的形式做转置
names(datExpr0) = femData$substanceBXH
# 转置后,行标变成了样本名,然后重新加入基因名作为列标
# femData$substanceBXH表示在femData矩阵里面依次取substanceBXH列的值
# names表示列标,即将这些值(基因名)作为datExpr0的列标
rownames(datExpr0) = names(femData)[-c(1:8)]
# 将femData列标的第1到8个删除后,其余的列标依次作为datExpr0的行标,但本步可以不用,因为在定义datExpr0时就已经完成了这不
***names是列标,rownames是行标
至此,我们得到的datExpr0是一个列表为样本名,行标为基因的一个基因表达矩阵,按如下代码观察其前六行六列
> datExpr0[1:6,1:6]
      MMT00000044 MMT00000046 MMT00000051 MMT00000076 MMT00000080 MMT00000102
F2_2   -0.0181000     -0.0773 -0.02260000    -0.00924 -0.04870000  0.17600000
F2_3    0.0642000     -0.0297  0.06170000    -0.14500  0.05820000 -0.18900000
F2_14   0.0000644      0.1120 -0.12900000     0.02870 -0.04830000 -0.06500000
F2_15  -0.0580000     -0.0589  0.08710000    -0.04390 -0.03710000 -0.00846000
F2_19   0.0483000      0.0443 -0.11500000     0.00425  0.02510000 -0.00574000
F2_20  -0.1519741     -0.0938 -0.06502607    -0.23610  0.08504274 -

 6000


 扫一扫















 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


