


中文,计算机辅助设计与图形学学报,第 32 卷 第 8 期,2020 年 8 月。
DOI: 10.3724/SP.J.1089.2020.18059
摘要:
为实现自动准确地检测路面裂缝, 提升路面裂缝检测效果, 提出了一种基于注意力机制的裂缝检测网络 (attention-based crack networks, ACNet). 该网络采用编码器-解码器网络构架, 编码器采用 ResNet34 为骨干网, 提取路面裂缝特征; 在编码器和解码器间加入基于注意力机制的特征模块(attention-based feature module, AFM), 以利用全局信息和增加对检测不同尺度裂缝的鲁棒性, 更好地提取裂缝特征和定位裂缝位置; 在解码阶段也引入注意力机制, 设计了基于注意力机制的解码模块(attention-based decoder module, ADM), 实现对裂缝的准确定位. 在公共裂缝 数据集 CFD 和 CRACK500 上, 与U-Net 等其他 8 种方法进行了比较, 结果表明, ACNet 裂缝检测效果更理想, 在主观视觉上, 裂缝定位更准确, 细节更丰富; 在实验指标 F1和重合率上, 检测结果都有明显提升, 说明了该网络的有效性。
研究背景
基于图像的路面裂缝检测, 可以看成是从图像中分割出裂缝区域,图像分割时, 一般以图像(单通道或多通道)为输入, 输出是带有标签的分类后的图像, 而图像的大小保持不变。
传统方法
基于直方图估计、梯度方向直方图、局部二值模式、Gabor 滤波和多特征融合。
局限性:对输入图像的质量要求较高, 往往在外界环境发生变化、光线不均和有噪声干扰时, 裂缝检测的性能将受到极大影响。
基于深度学习的方法
1.以像素为单位, 利用周围的像素对该像素进行分类。基于卷积神经网络框架, 以每个像素点得到一个相应的图像块, 输入网络训练, 图像的分割被看成像素点的二分类问题。
第一种方法像是以每一个像素点作为一张图片的图像分类问题,得到的结果只有两种:是裂缝和不是裂缝。问题在于,对于一张图片而言,若某一像素点是我们需要检测的目标,那么该像素点周围大概率也是我们需要检测的目标(即相邻像素点得到的图像块相似度高),不仅计算量大,且高度冗余。
2.以图像为整体进行分割, 一般采用 FCN 或 U-Net 网络框架, 即采用编码器-解码器结构。encoder通过下采样进行特征提取, 包括底层、中层和高层特征;decoder通过上采样将特征还原到原图像的尺寸, 从而得到最终的分割结果。
这种方法为端到端的图像分割方法,是目前深度学习中常用的一种方法。在此基础上,有许多改进的模块。例如:
金字塔池化模块(Pyramid Pooling Module)它能够聚合不同区域的上下文信息,从而提高获取全局信息的能力。该模块的具体实现过程为,先对feature map 进行下采样,得到不同尺度的输出,再通过1*1卷积改变通道,再分别对不同尺寸的feature map进行上采样,最后将上采样结果concat。
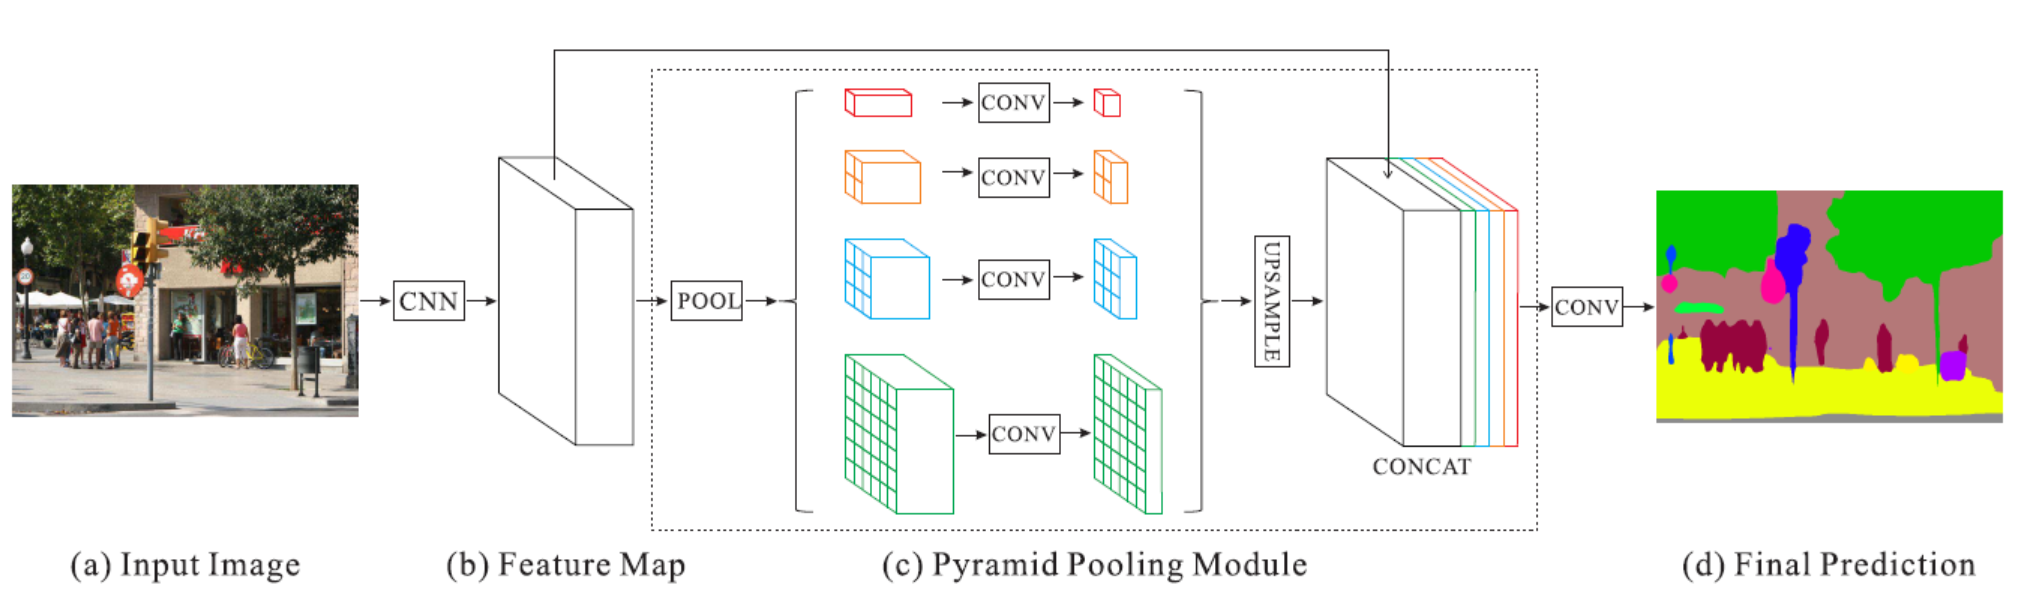
图1.PSPNet网络结构
空洞空间卷积池化金字塔(Atrous Spatial Pyramid Pooling)对所给定的输入以不同采样率的空洞卷积并行采样。与PPM相比,区别在于PPM对feature map使用了4次池化操作。ASPP采用了4次卷积操作(包括1次1*1卷积和3次3*3卷积)和一次池化操作。
ASPP模块详细信息可见我的这篇博客:ASPP模块
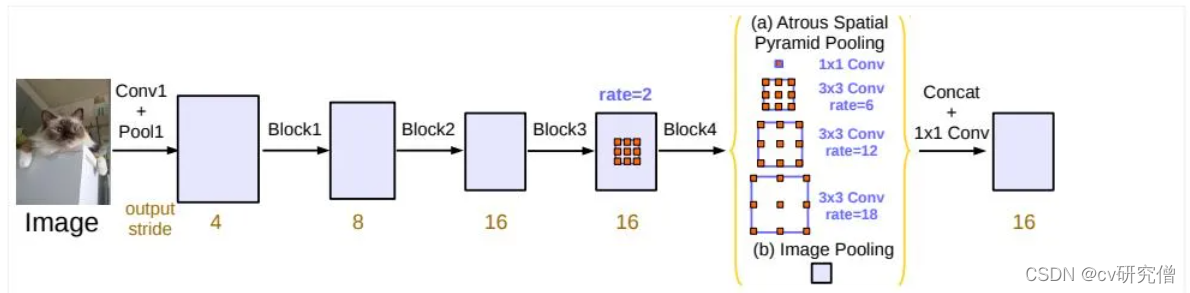
图2.ASPP模块
空洞卷积(dilated convolut


 2068


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


