


1.认识微服务
1.1单体架构
单体架构:将业务的所有功能集中在一个项目中开发,打成一个包部署。
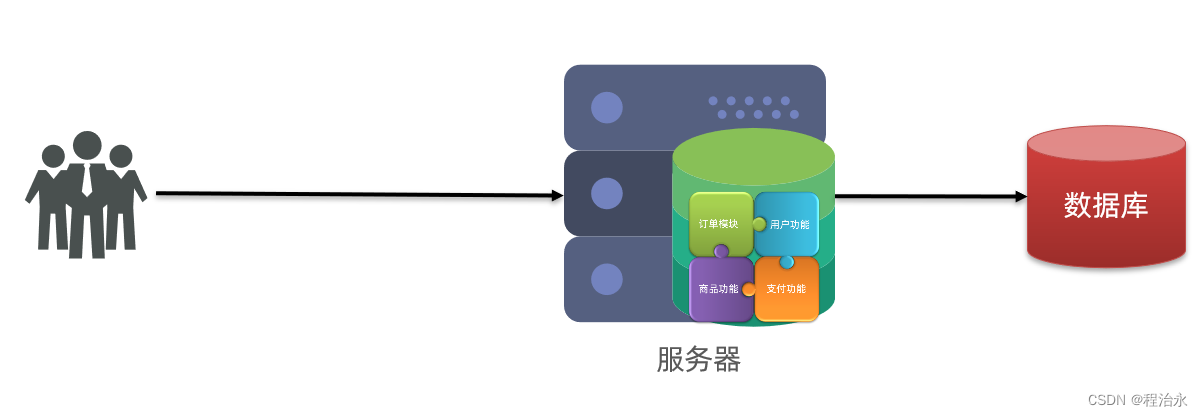
单体架构的优缺点如下:
优点:
- 架构简单
- 部署成本低
缺点:
- 耦合度高(维护困难、升级困难)
1.2 分布式架构
分布式架构:根据业务功能对系统做拆分,每个业务功能模块作为独立项目开发,称为一个服务。
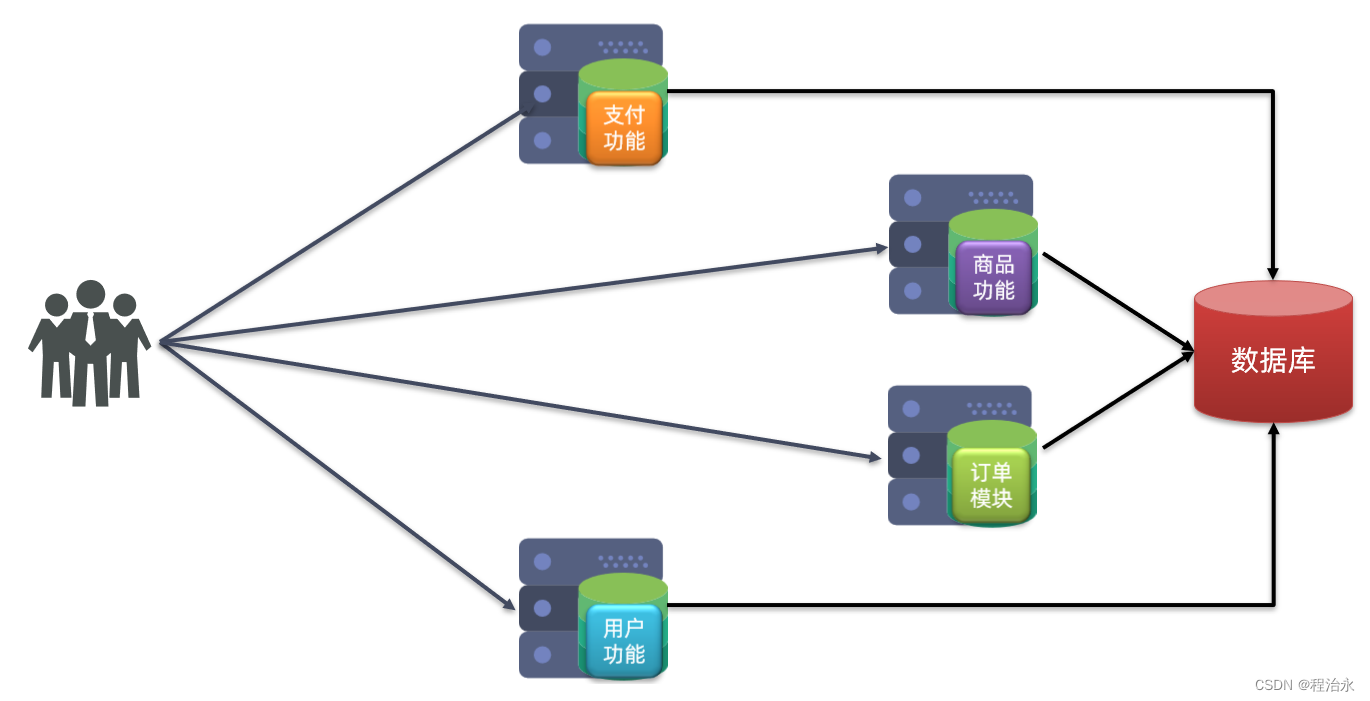
分布式架构的优缺点:
优点:
- 降低服务耦合
- 有利于服务升级和拓展
缺点:
- 服务调用关系错综复杂
分布式架构虽然降低了服务耦合,但是服务拆分时也有很多问题需要思考:
- 服务拆分的粒度如何界定?
- 服务之间如何调用?
- 服务的调用关系如何管理?
1.3 微服务
微服务的架构特征:
- 单一职责:微服务拆分粒度更小,每一个服务都对应唯一的业务能力,做到单一职责
- 自治:团队独立、技术独立、数据独立,独立部署和交付
- 面向服务:服务提供统一标准的接口,与语言和技术无关
- 隔离性强:服务调用做好隔离、容错、降级,避免出现级联问题
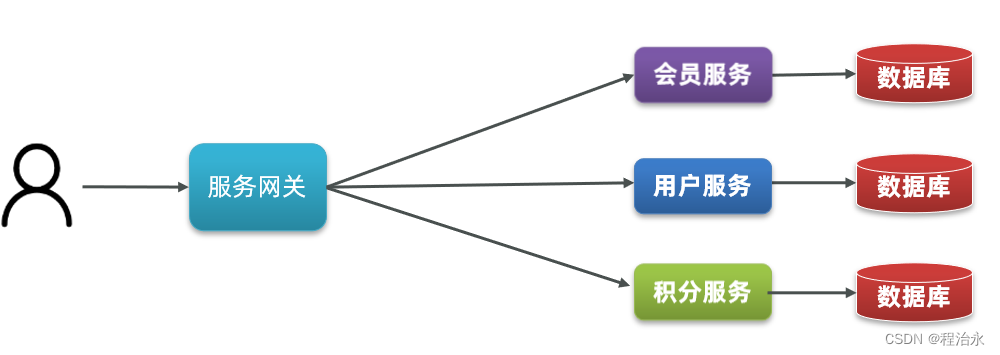
微服务的上述特性其实是在给分布式架构制定一个标准,进一步降低服务之间的耦合度,提供服务的独立性和灵活性。做到高内聚,低耦合。
因此,可以认为微服务是一种经过良好架构设计的分布式架构方案 。
但方案该怎么落地?选用什么样的技术栈?全球的互联网公司都在积极尝试自己的微服务落地方案。
其中在Java领域最引人注目的就是SpringCloud提供的方案了。
1.4 SpringCloud
SpringCloud是目前国内使用最广泛的微服务框架。官网地址:https://spring.io/projects/spring-cloud。
SpringCloud集成了各种微服务功能组件,并基于SpringBoot实现了这些组件的自动装配,从而提供了良好的开箱即用体验。
其中常见的组件包括: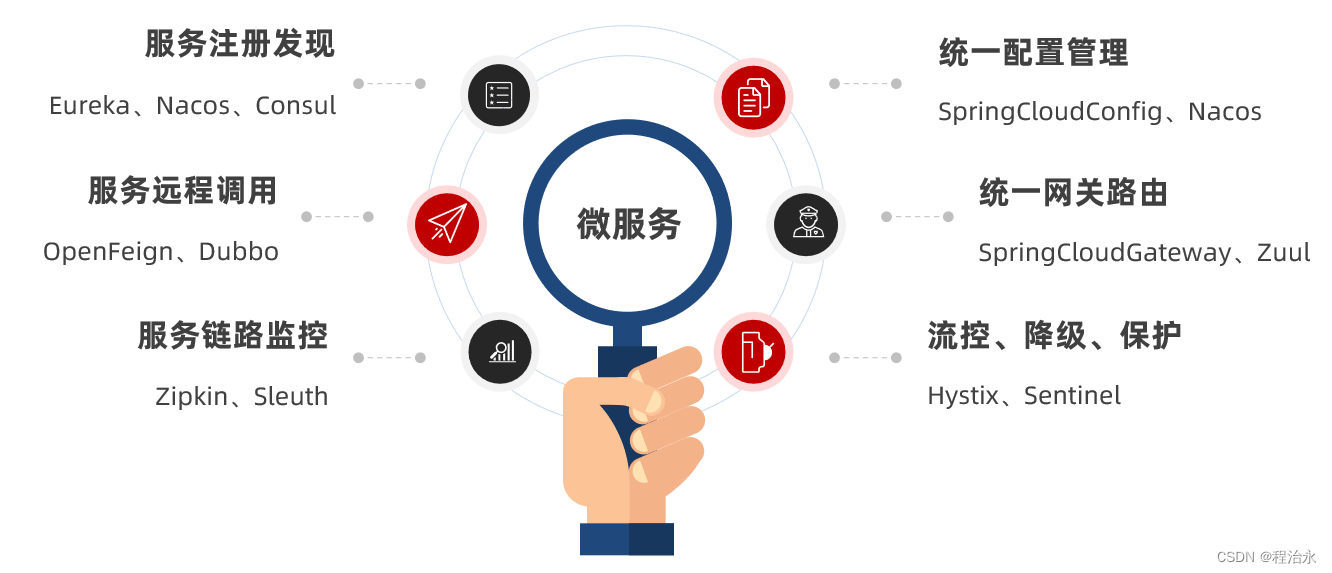
另外,SpringCloud底层是依赖于SpringBoot的,并且有版本的兼容关系,如下:
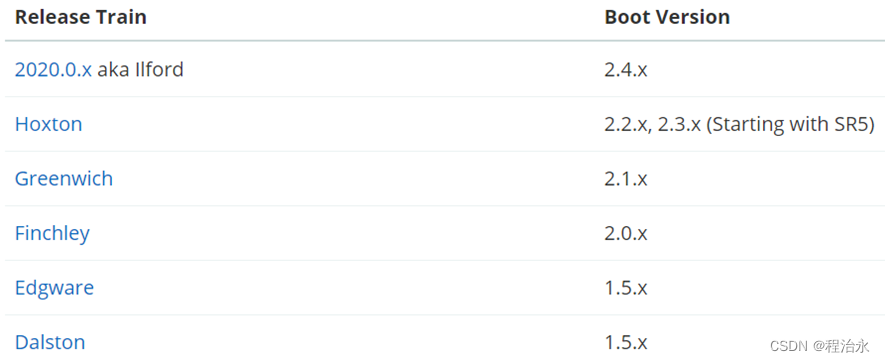
springCloud的版本一开始是由伦敦的地铁站命名的,ABC开头的版本过老了,官网已经不建议使用了。
1.5 总结一下
- 单体架构:简单方便,高度耦合,扩展性差,适合小型项目。
- 分布式架构:松耦合,扩展性好,但架构复杂,难度大,适合大型互联网项目,例如:京东、淘宝
- 微服务:一种良好的分布式架构方案
①优点:拆分粒度更小、服务更独立、耦合度更低
②缺点:架构非常复杂,运维、监控、部署难度提高 - springCloud是微服务架构的一站式解决方案,集成了各种微服务功能组件。
2.服务拆分和远程调用
任何分布式架构都离不开服务的拆分,微服务也是一样。
2.1 服务拆分原则
- 不同微服务,不要重复开发相同业务
- 微服务数据独立,不要访问其它微服务的数据库
- 微服务可以将自己的业务暴露为接口,供其它微服务调用
2.2 服务拆分示例
demo的地址:https://gitee.com/cheng-zhiyong/cloud-demo.git
其结构如下:
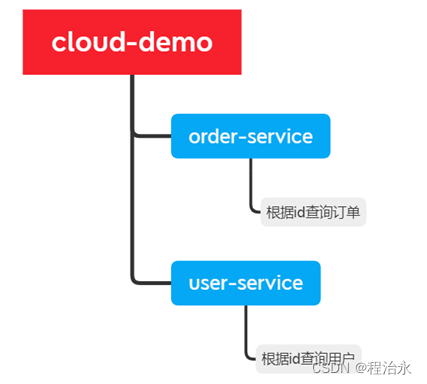
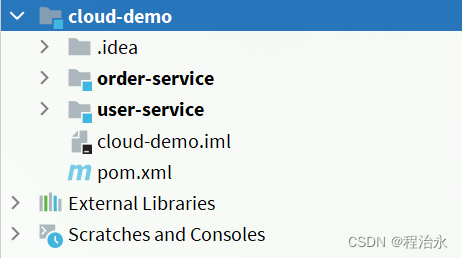
cloud-demo:父工程,管理依赖
- order-service:订单微服务,负责订单相关业务
- user-service:用户微服务,负责用户相关业务
要求:
- 订单微服务和用户微服务都必须有各自的数据库,相互独立
- 订单服务和用户服务都对外暴露Restful的接口
- 订单服务如果需要查询用户信息,只能调用用户服务的Restful接口,不能查询用户数据库
2.2 导入sql语句
分别在mysql中创建 cloud_order订单库 cloud_user 用户库
DROP TABLE IF EXISTS `tb_order`;
CREATE TABLE `tb_order`  (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT '订单id',
  `user_id` bigint(20) NOT NULL COMMENT '用户id',
  `name` varchar(100) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL COMMENT '商品名称',
  `price` bigint(20) NOT NULL COMMENT '商品价格',
  `num` int(10) NULL DEFAULT 0 COMMENT '商品数量',
  PRIMARY KEY (`id`) USING BTREE,
  UNIQUE INDEX `username`(`name`) USING BTREE
) ENGINE = InnoDB AUTO_INCREMENT = 109 CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;

-- ----------------------------
-- Records of tb_order
-- ----------------------------
INSERT INTO `tb_order` VALUES (101, 1, 'Apple 苹果 iPhone 12 ', 699900, 1);
INSERT INTO `tb_order` VALUES (102, 2, '雅迪 yadea 新国标电动车', 209900, 1);
INSERT INTO `tb_order` VALUES (103, 3, '骆驼(CAMEL)休闲运动鞋女', 43900, 1);
INSERT INTO `tb_order` VALUES (104, 4, '小米10 双模5G 骁龙865', 359900, 1);
INSERT INTO `tb_order` VALUES (105, 5, 'OPPO Reno3 Pro 双模5G 视频双防抖', 299900, 1);
INSERT INTO `tb_order` VALUES (106, 6, '美的(Midea) 新能效 冷静星II ', 544900, 1);
INSERT INTO `tb_order` VALUES (107, 2, '西昊/SIHOO 人体工学电脑椅子', 79900, 1);
INSERT INTO `tb_order` VALUES (108, 3, '梵班(FAMDBANN)休闲男鞋', 31900, 1);
DROP TABLE IF EXISTS `tb_user`;
CREATE TABLE `tb_user`  (
  `id` bigint(20) NOT NULL AUTO_INCREMENT,
  `username` varchar(100) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL COMMENT '收件人',
  `address` varchar(255) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL COMMENT '地址',
  PRIMARY KEY (`id`) USING BTREE,
  UNIQUE INDEX `username`(`username`) USING BTREE
) ENGINE = InnoDB AUTO_INCREMENT = 109 CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;

-- ----------------------------
-- Records of tb_user
-- ----------------------------
INSERT INTO `tb_user` VALUES (1, '柳岩', '湖南省衡阳市');
INSERT INTO `tb_user` VALUES (2, '文二狗', '陕西省西安市');
INSERT INTO `tb_user` VALUES (3, '华沉鱼', '湖北省十堰市');
INSERT INTO `tb_user` VALUES (4, '张必沉', '天津市');
INSERT INTO `tb_user` VALUES (5, '郑爽爽', '辽宁省沈阳市大东区');
INSERT INTO `tb_user` VALUES (6, '范兵兵', '山东省青岛市');
注意:两张表分别创建在不同的数据库下
2.3 实现远程调用案例
案例需求:
在order-service服务中调用查询订单业务,要求在查询订单的同时,根据订单中包含的userid查询出用户信息一起返回。
这就涉及到服务之间的调用,需要在order-service中向user-service发起一个http请求,调用user-service暴露的接口。
那么如何实现服务之间的远程调用呢?
spring提供了restTemplate发送http请求:
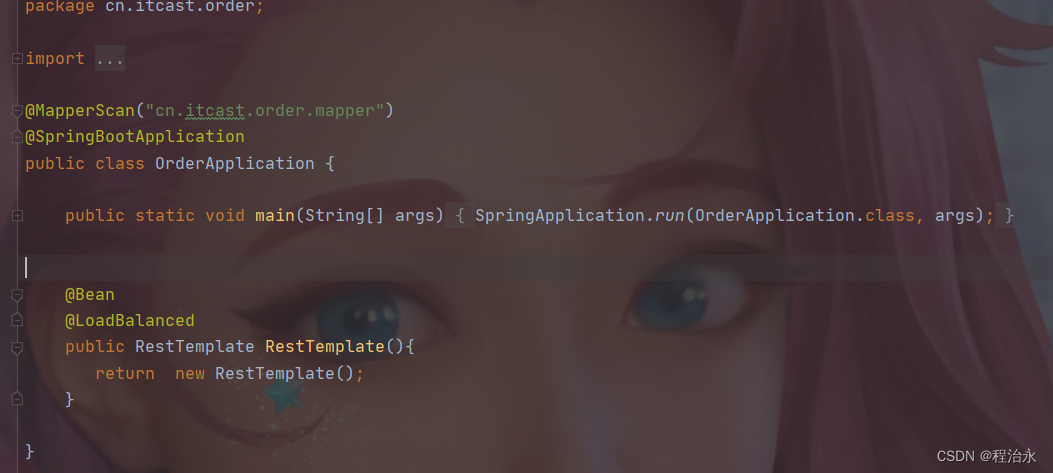
2.3.1 注册RestTemplate
在order-service服务中启动类中(也可以写一个配置类),注册RestTemplate实例:
2.3.2 实现远程调用
修改service包下的orderService类中的queryOrderById()方法:
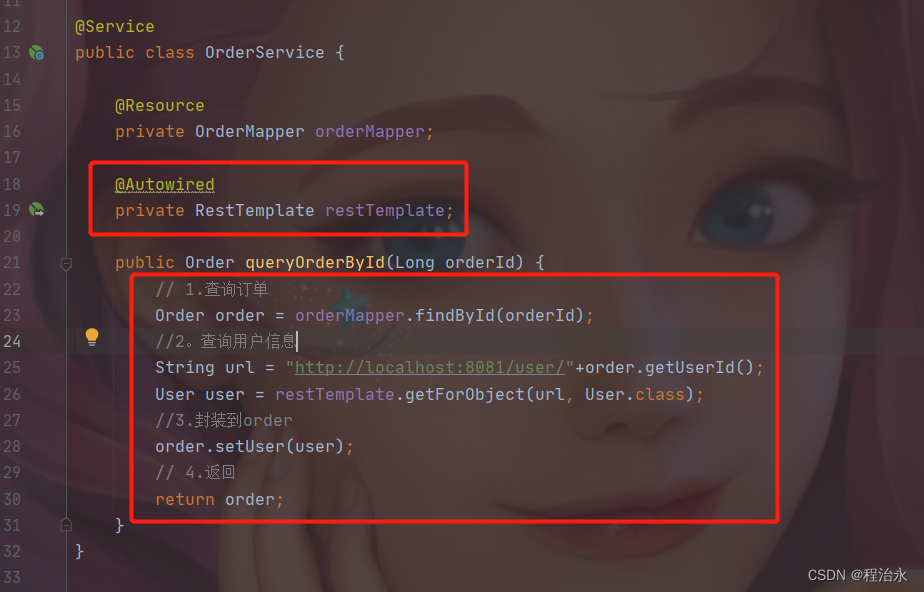
通过restTemplate远程调用user-service服务接口,等到user对象,封装到order对象中。
2.4 提供者和消费者
在服务调用关系中,会有两个不同的角色:
服务提供者:一次业务中,被其它微服务调用的服务。(提供接口给其它微服务)
服务消费者:一次业务中,调用其它微服务的服务。(调用其它微服务提供的接口)
但是,服务提供者与服务消费者的角色并不是绝对的,而是相对于业务而言。
如果服务A调用了服务B,而服务B又调用了服务C,服务B的角色是什么?
- 对于A调用B的业务而言:A是服务消费者,B是服务提供者
- 对于B调用C的业务而言:B是服务消费者,C是服务提供者
因此,服务B既可以是服务提供者,也可以是服务消费者。
3.Eureka注册中心
假如服务提供者user-service部署了多个实例:
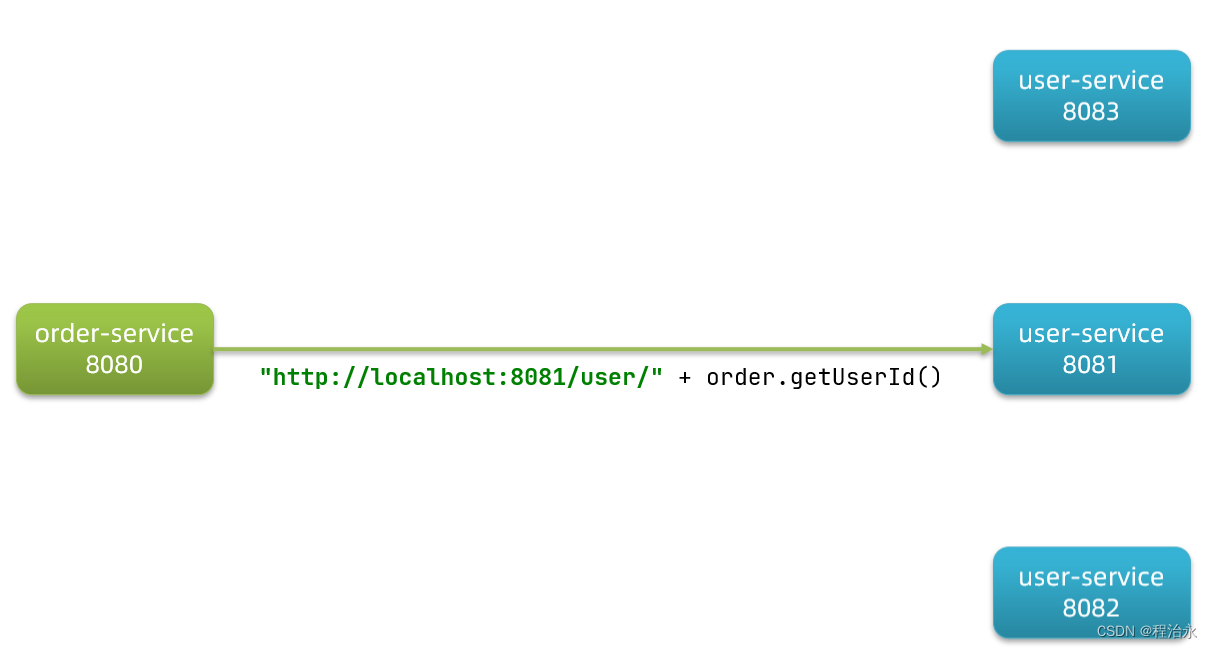
那么就会有几个问题:
- order-service在发起远程调用的时候,该如何得知user-service实例的ip地址和端口?
- 有多个user-service实例地址,order-service调用时该如何选择?
- order-service如何得知某个user-service实例是否依然健康,是不是已经宕机?
3.1 Eureka的结构和作用
这些问题都需要利用springCloud的注册中心来解决,其中最广为人知的注册中心就是Eureka,其结构如下:
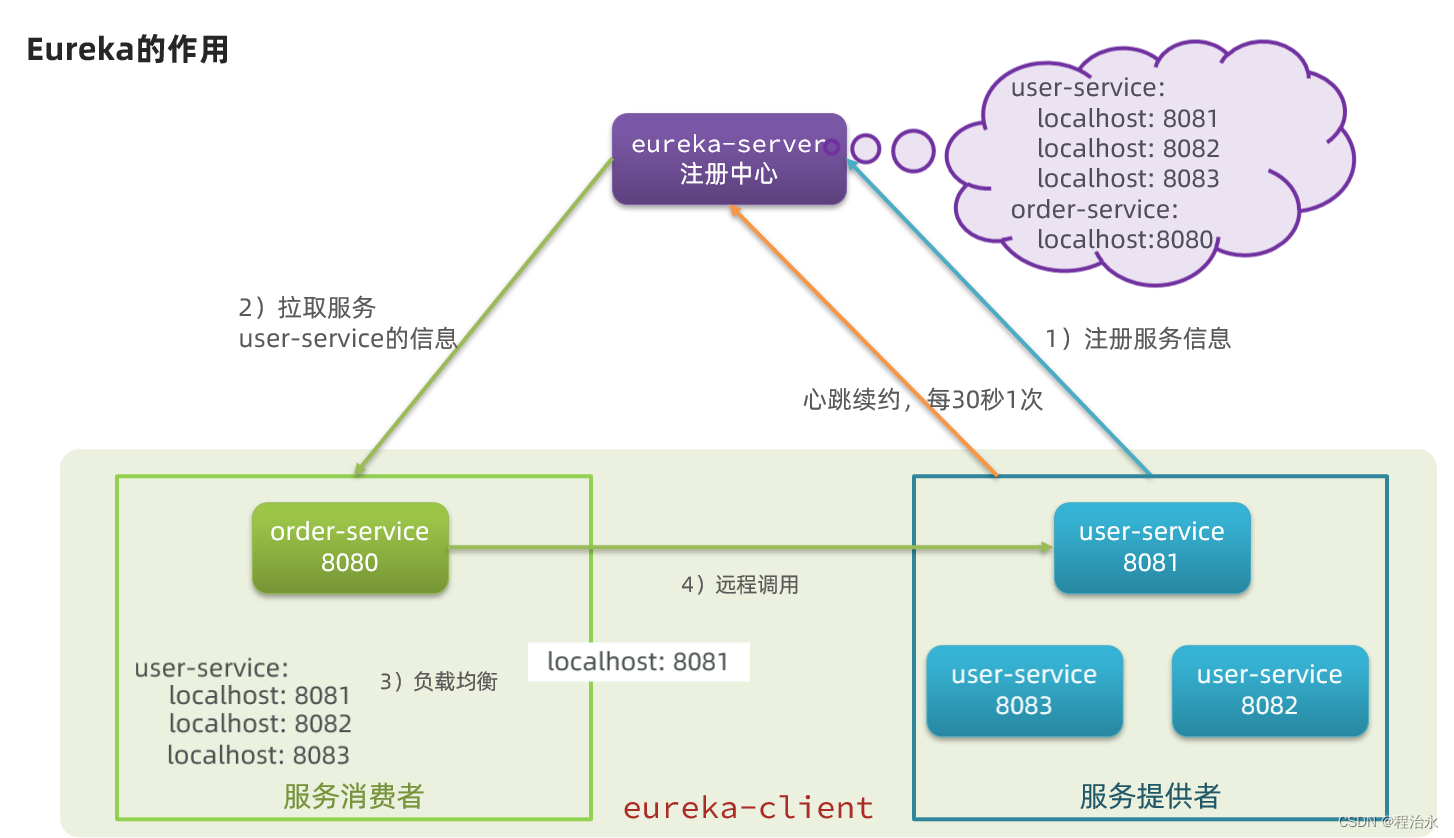
解答问题:
问题一:order-service如何得知user-servcie实例地址?
获取地址信息的流程如下:
- user-service服务实例启动后,会将自己的信息注册到eureka服务端,这个叫服务注册。
- eureka-server保存服务名称到服务实例地址列表的映射关系
- order-service根据服务名称,拉取实例地址列表。这个叫服务发现或服务拉取
问题二:order-service如何从多个user-service实例中选择具体的实例?
- order-service从实例列表中利用负载均衡算法选中一个实例地址
- 向该实例地址发起远程调用
问题三:order-service如何得知某个user-service实例是否依然健康,是不是已经宕机?
- user-service会每隔一段时间(默认30秒)向eureka-server发起请求,报告自己状态,称为心跳
- 当超过一定时间没有发送心跳时,eureka-server会认为微服务实例故障,将该实例从服务列表中剔除
- order-service拉取服务时,就能将故障实例排除了
3.2 搭建eureka-service服务
注意:注册中心服务端:eureka-server,这必须是一个独立的微服务
在cloud-demo父工程下,创建一个子模块,引入SpringCloud为eureka提供的starter依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId>
</dependency>
编写启动类:给eureka-service服务编写一个启动类,一定要在启动类上添加@EnableEurekaServer注解,开启eureka注册中心功能
@SpringBootApplication
@EnableEurekaServer  //开启eurekaserver服务
public class Application {
    public static void main(String[] args) {
        SpringApplication.run(Application.class, args);
    }
}
编写一个application.yml文件,内容如下:
server:
  port: 10086  #默认8671
spring:
  application:
    name: eureka

eureka:
  client:
    service-url:
      defaultZone: http://localhost:10086/eureka # 注册中心地址
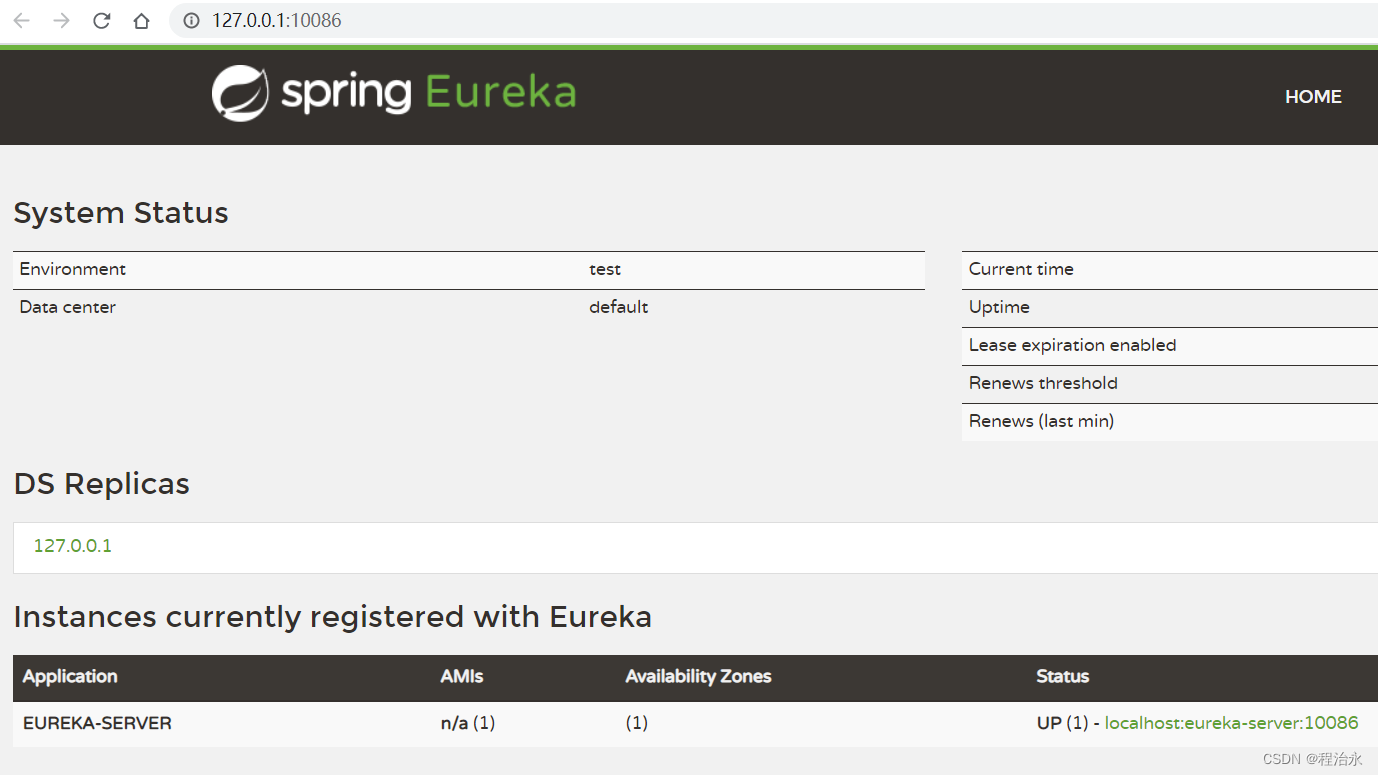
启动微服务,然后在浏览器访问:http://127.0.0.1:10086
3.3 服务注册
将user-service注册到eureka-server中去。
引入依赖:
在user-service的pom文件中,引入下面的eureka-client依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId>
</dependency>
配置文件:
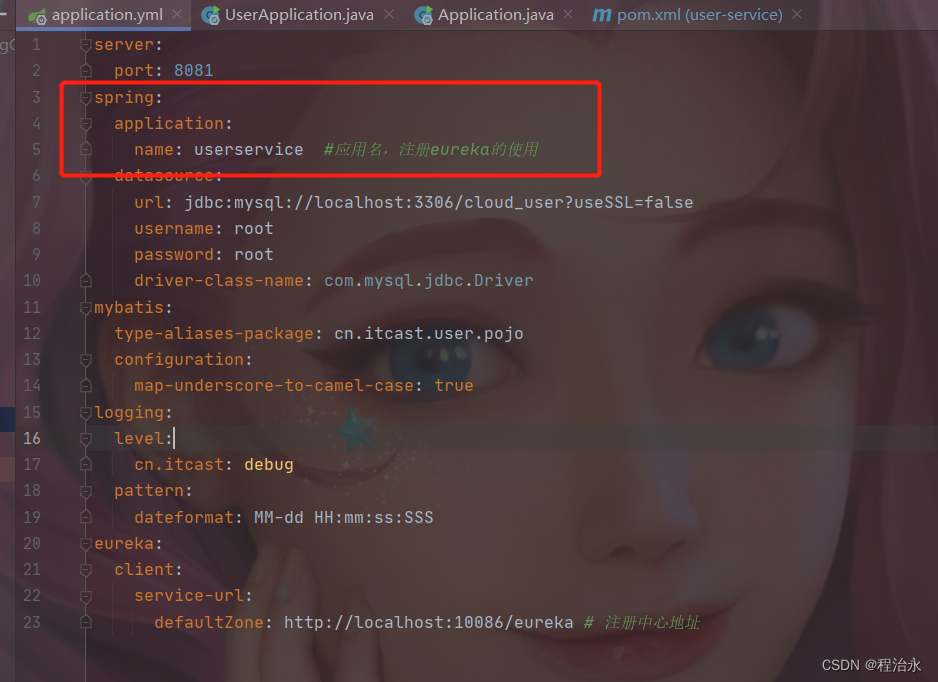
在user-service中,修改application.yml文件,添加服务名称、eureka地址:
spring:
  application:
    name: userservice
eureka:
  client:
    service-url:
      defaultZone: http://127.0.0.1:10086/eureka
3.3.1 启动多个user-service实例
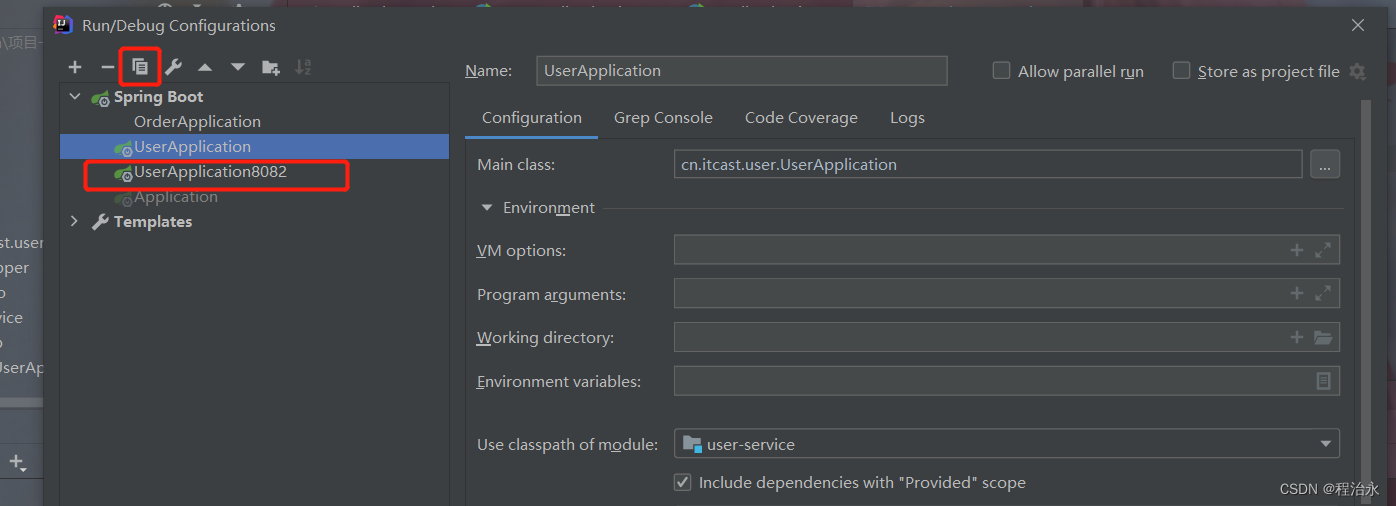
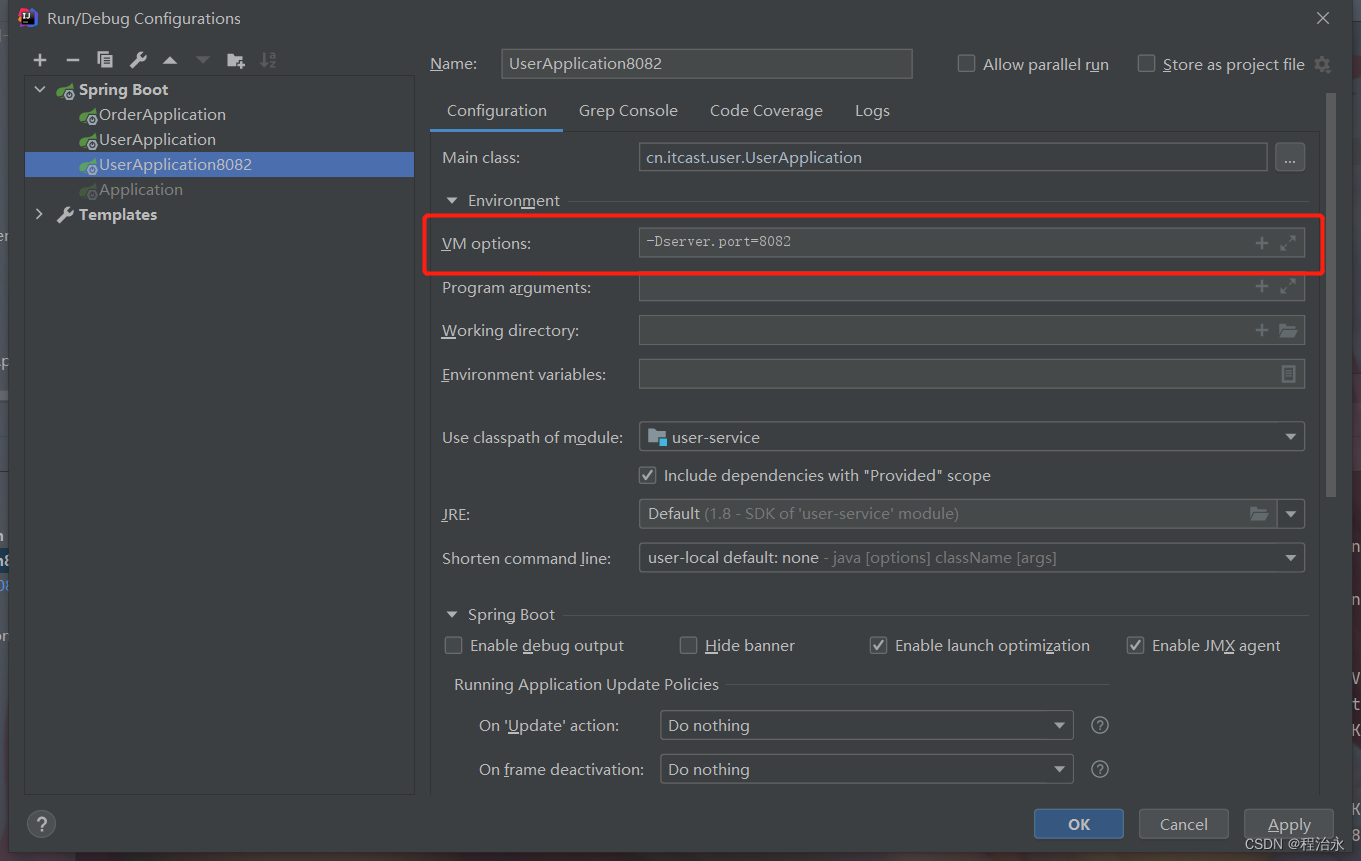
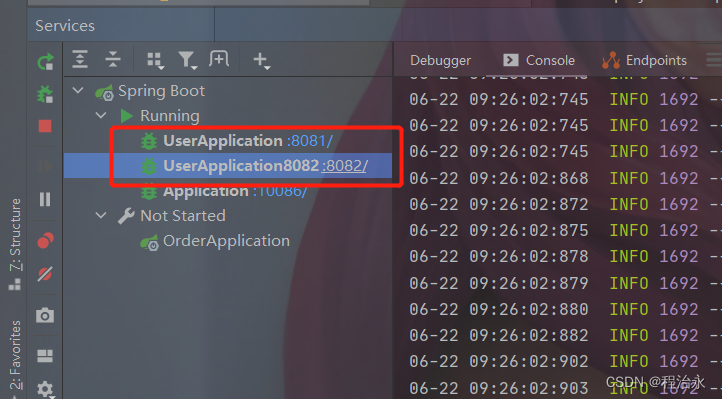
为了演示一个服务有多个实例的场景,我们添加一个SpringBoot的启动配置,再启动一个user-service。
复制一个启动配置
修改端口号
启动服务
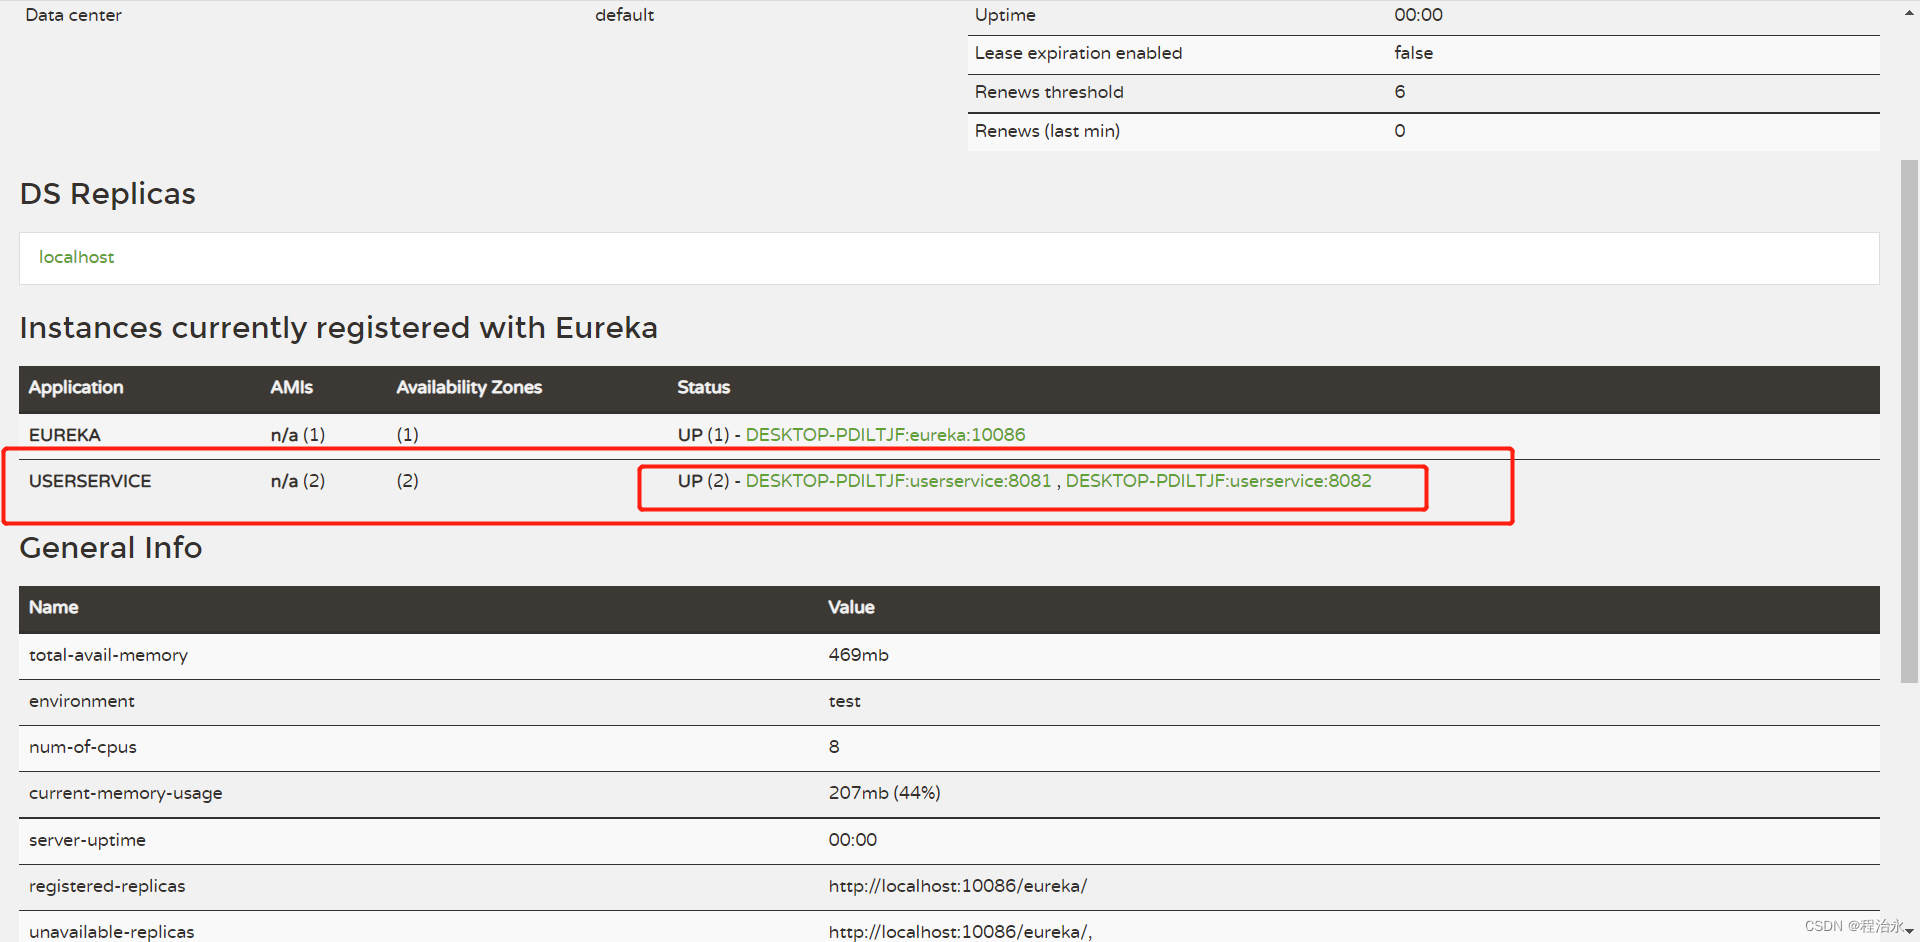
在eureka的管理页面可以看到注册的服务
注意:在注册服务的时候,服务提供者要在配置文件中配置服务名称:
3.4 服务的发现
将order-service的逻辑修改:向eureka-server拉取user-service的信息,实现服务发现。
引入依赖:
服务的发现和注册都统一封装到了eureka-client依赖中
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId>
</dependency>
配置文件
spring:
  application:
    name: orderservice
eureka:
  client:
    service-url:
      defaultZone: http://127.0.0.1:10086/eureka
服务拉取和负载均衡
去eureka-service中拉取user-service服务的实例列表,并且实现负载均衡。
这些动作都不需要我们操作,只需要添加一些注解即可。
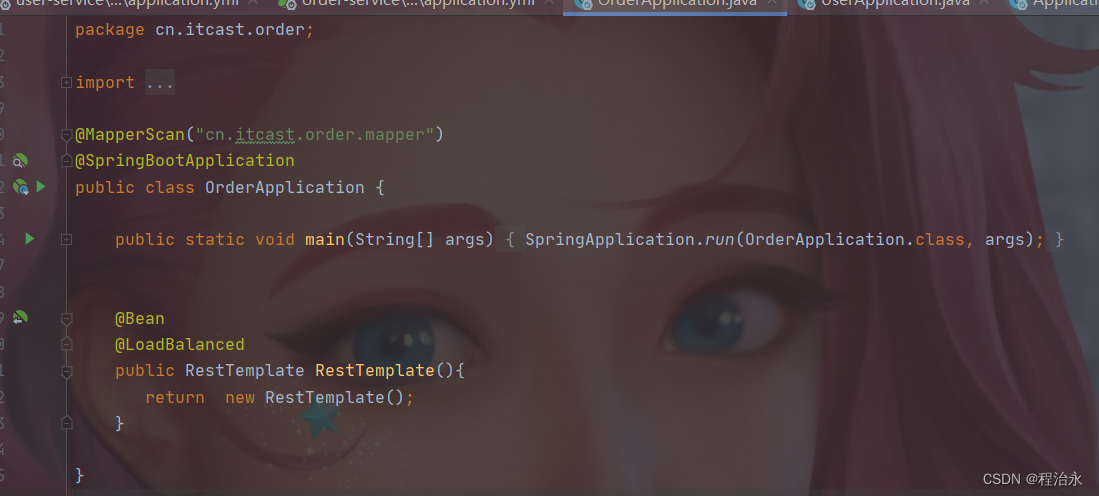
在order-service的OrderApplication中,给RestTemplate这个Bean添加一个@LoadBalanced注解:
修改order-service服务中的cn.itcast.order.service包下的OrderService类中的queryOrderById方法。修改访问的url路径,用服务名代替ip、端口:
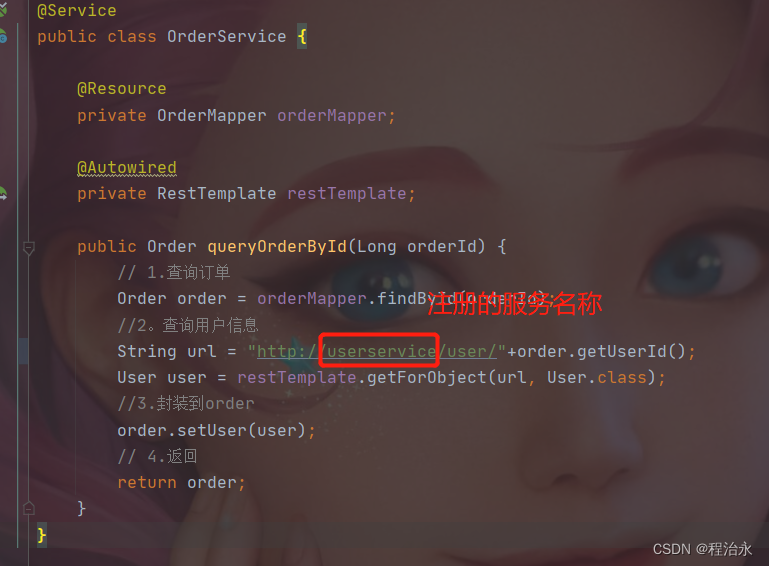
spring会自动帮助我们从eureka-server端,根据userservice这个服务名称,获取实例列表,而后完成负载均衡。
注意:要在restTemplate实例上加上@LoadBalanced注解,才能解析userservice,获取实例。
4.Ribbon负载均衡
上面我们只要加上一个@LoadBalanced注解,就可以实现负载均衡功能,这是什么原理呢?
4.1 负载均衡原理
SpringCloud底层其实是利用了一个名为Ribbon的组件,来实现负载均衡功能的。
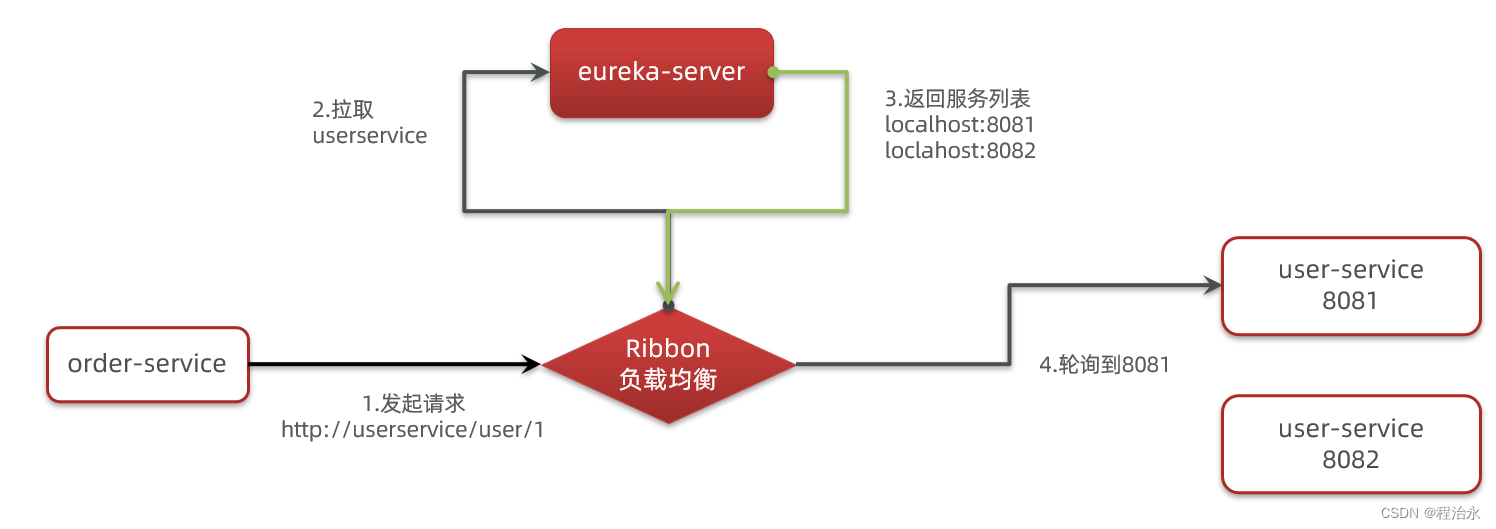
那么为什么请求的是http://userservice/user/1,怎么变成的http://localhost:8081呢?
4.2 源码分析
为什么我们只输入了service名称就可以访问了呢?之前还要获取ip和端口。
答案就是LoadBalancerInterceptor,这个类会对restTemplate的请求进行拦截(前提是在restTemplate实例上加上@LoadBalanced注解),然后从eureka服务中根据服务id获取服务列表,随后利用负载均衡算法得到真实的服务地址信息,替换服务id。
LoadBalancerIntercepor:
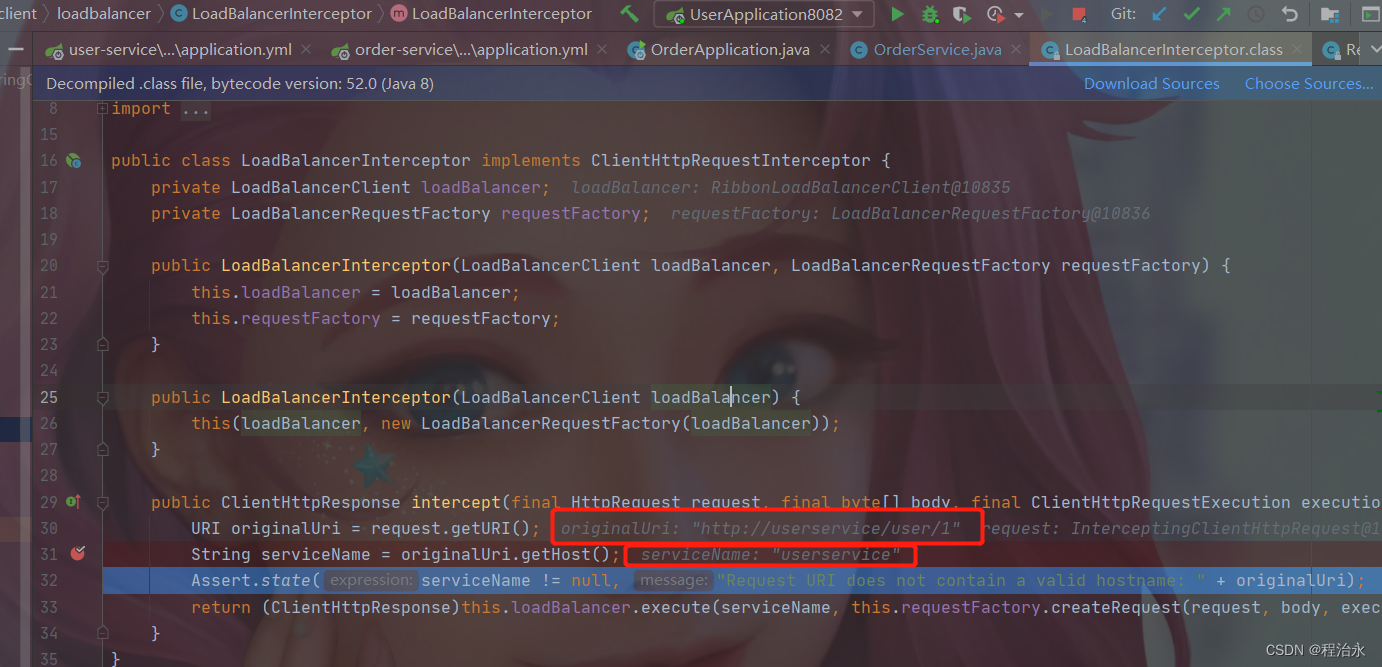
可以看到intercept()方法对httpRequest请求进行了拦截,然后做个下面几件事:
- request.getURLI():获取请求的uri,http://userservice/user/1
- orignalUri.getHost():获取host主机名,起始就是服务id:userservice
- this.loadBalance.execute():处理服务id,和请求。
继续跟入execute方法:
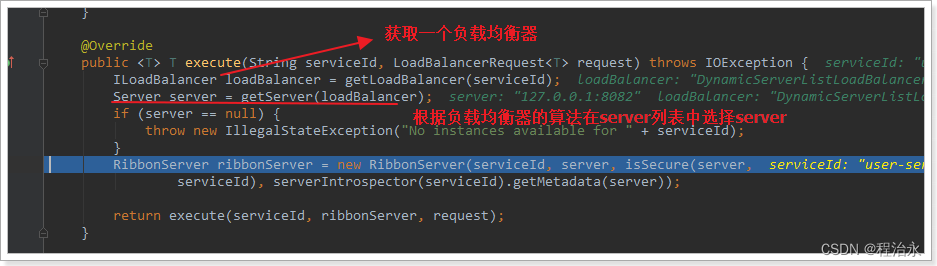
- getLoadBalancer(serviceId):根据服务id获取ILoadBalancer,而ILoadBalancer会拿着服务id去eureka中获取服务列表并保存起来。
- getServer(loadBalancer):利用内置的负载均衡算法,从服务列表中选择一个。本例中,可以看到获取了8082端口的服务
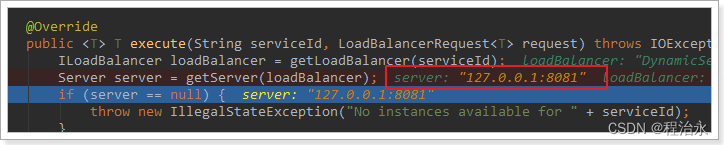
放行后,再次访问并跟踪,发现获取的是8081:
负载均衡策略IRule
在刚才的代码中,可以看到获取服务使通过一个getServer方法来做负载均衡:
继续跟入:
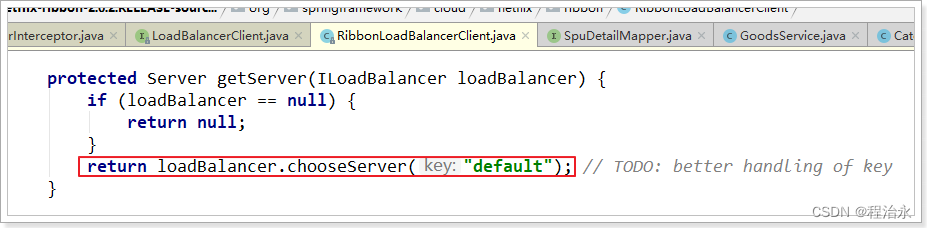
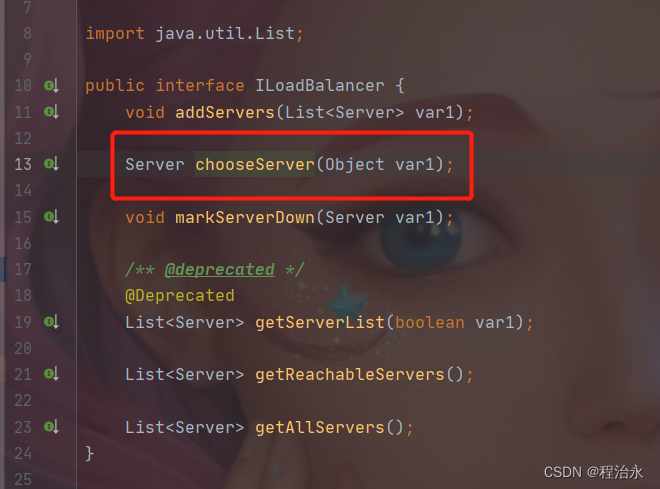
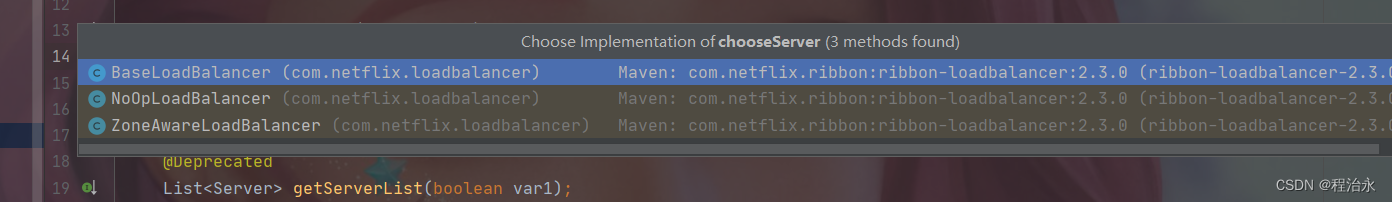
继续跟踪源码chooseServer方法,发现有三个实现类:
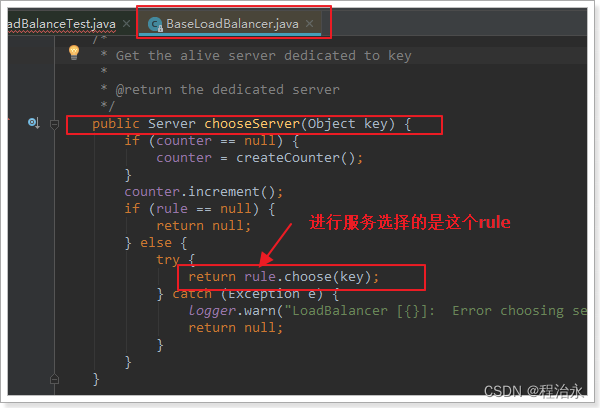
看看这个rule是谁:
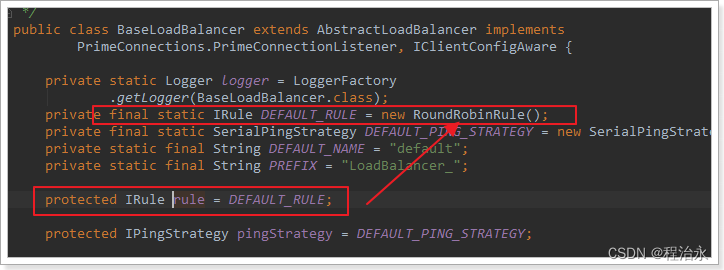
这里的rule默认值是一个RoundRobinRule,看类的介绍:
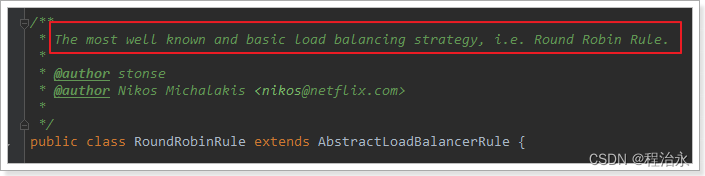
也就是轮询的意思。
总结:

基本流程:
- 拦截我们的restTemplate请求
- RibbonLoadBalancerClient会从请求uri中获取服务名称,userservice
- DynamicServerListLoadBalancer会根据服务名称到eureka拉取服务列表
- eureka返回列表,
- IRule利用负载均衡规则,从列表中选择一个
- RibbonLoadBalancerClient修改请求地址,用localhost:8081替代userservice,得到http://localhost:8081/user/1,发起真实请求
4.3 负载均衡策略
负载均衡的规则都定义在IRule接口中,而IRule有很多不同的实现类:
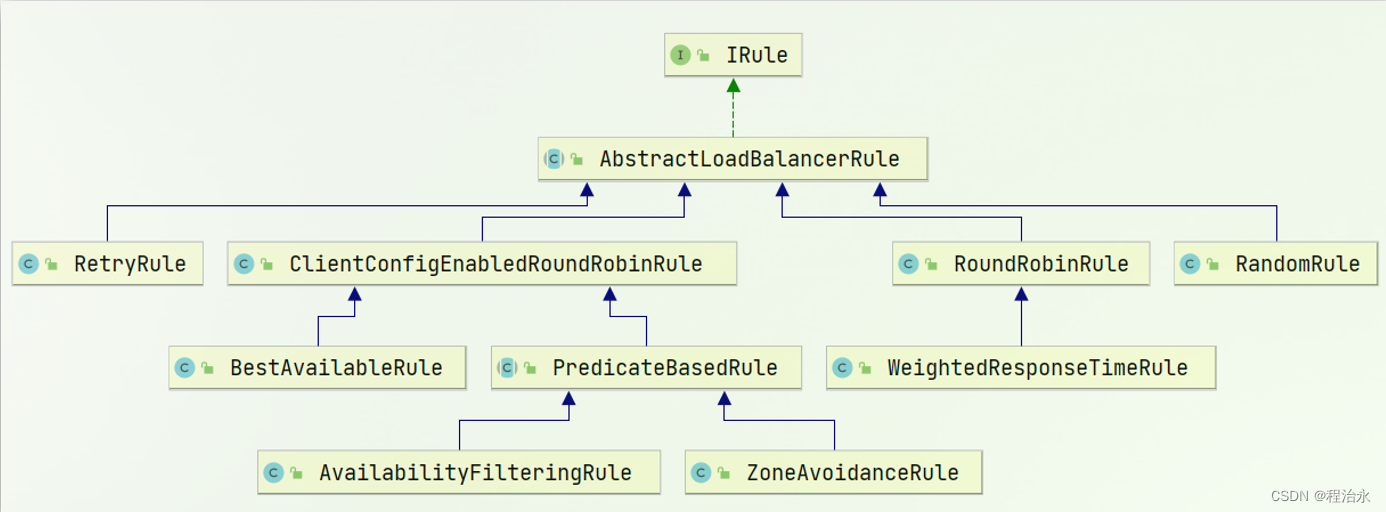
不同规则的含义如下:
| 内置负载均衡规则类 | 规则描述 |
|---|---|
| RoundRobinRule | 简单轮询服务列表来选择服务器。 |
| AvailabilityFilteringRule | 对以下两种服务器进行忽略: (1)在默认情况下,这台服务器如果3次连接失败,这台服务器就会被设置为“短路”状态。短路状态将持续30秒,如果再次连接失败,短路的持续时间就会几何级地增加。 (2)并发数过高的服务器。如果一个服务器的并发连接数过高,配置了AvailabilityFilteringRule规则的客户端也会将其忽略。并发连接数的上限,可以由客户端的..ActiveConnectionsLimit属性进行配置。 |
| WeightedResponseTimeRule | 为每一个服务器赋予一个权重值。服务器响应时间越长,这个服务器的权重就越小。这个规则会随机选择服务器,这个权重值会影响服务器的选择。 |
| ZoneAvoidanceRule | 以区域可用的服务器为基础进行服务器的选择。使用Zone对服务器进行分类,这个Zone可以理解为一个机房、一个机架等。而后再对Zone内的多个服务做轮询。 |
| BestAvailableRule | 忽略那些短路的服务器,并选择并发数较低的服务器。 |
| RandomRule | 随机选择一个可用的服务器。 |
| RetryRule | 重试机制的选择逻辑 |
默认的实现就是ZoneAvoidanceRule,是一种分区域的轮询方案。
自定义负载均衡策略
通过定义IRule实现可以修改负载均衡规则,有两种方式:
- 代码方式:在order-service中的OrderApplication类中,定义一个新的IRule:
@Bean
public IRule randomRule(){
    return new RandomRule();
}
- 配置文件方式:在order-service的application.yml文件中,添加新的配置也可以修改规则:
userservice: # 给某个微服务配置负载均衡规则,这里是userservice服务
  ribbon:
    NFLoadBalancerRuleClassName: com.netflix.loadbalancer.RandomRule # 负载均衡规则
注意,一般用默认的负载均衡规则,不做修改。
饥饿加载
Ribbon默认是采用懒加载,即第一次访问时才会去创建LoadBalanceClient,请求时间会很长。
而饥饿加载则会在项目启动时创建,降低第一次访问的耗时,通过下面配置开启饥饿加载:
ribbon:
  eager-load:
    enabled: true
    clients: userservice
5. Nacos注册中心
Nacos是阿里巴巴的产品,现在是SpringCloud中的一个组件。相比Eureka功能更加丰富,在国内受欢迎程度较高。
5.1 服务注册到nacos
Nacos是SpringCloudAlibaba的组件,而SpringCloudAlibaba也遵循SpringCloud中定义的服务注册、服务发现规范。因此使用Nacos和使用Eureka对于微服务来说,并没有太大区别。
主要差异在于:
- 依赖不同
- 服务地址不同
- eureka需要创建一个微服务启动,nacos不需要,在window中,解压启动就能使用
引入依赖:
在cloud-demo父工程的pom文件中的<dependencyManagement>中引入SpringCloudAlibaba的依赖:
<dependency>
                <groupId>com.alibaba.cloud</groupId>
                <artifactId>spring-cloud-alibaba-dependencies</artifactId>
                <version>2.2.6.RELEASE</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
然后在user-service和order-service中的pom文件中引入nacos-discovery依赖:
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
注意:nacos和eureka依赖有冲突,当我们用nacos时,不要忘了注释掉eureka的依赖。
配置nacos地址:
在user-service和order-service的application.yml中添加nacos地址:
注意:注释掉eureka的配置信息
spring:
  cloud:
    nacos:
      discovery:
     	 server-addr: localhost:8848
配置完成之后,重启微服务,登录nacos管理页面:localhost:8848/nacos;用户和密码都是nacos,可以看到微服务信息:
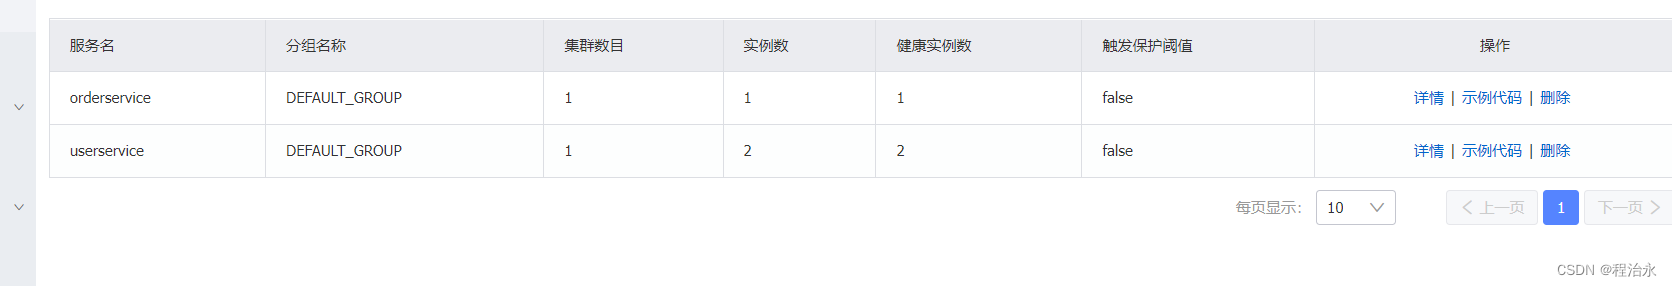
可以看到,nacos的可视化界面,比eureka的看着舒服,而且功能也比eureka的多。
5.2 服务分级存储模型
一个服务可以有多个实例,例如我们的user-service,可以有:
- 127.0.0.1:8081
- 127.0.0.1:8082
- 127.0.0.1:8083
假如这些实例分布于全国各地的不同机房,例如:
- 127.0.0.1:8081,在上海机房
- 127.0.0.1:8082,在上海机房
- 127.0.0.1:8083,在杭州机房
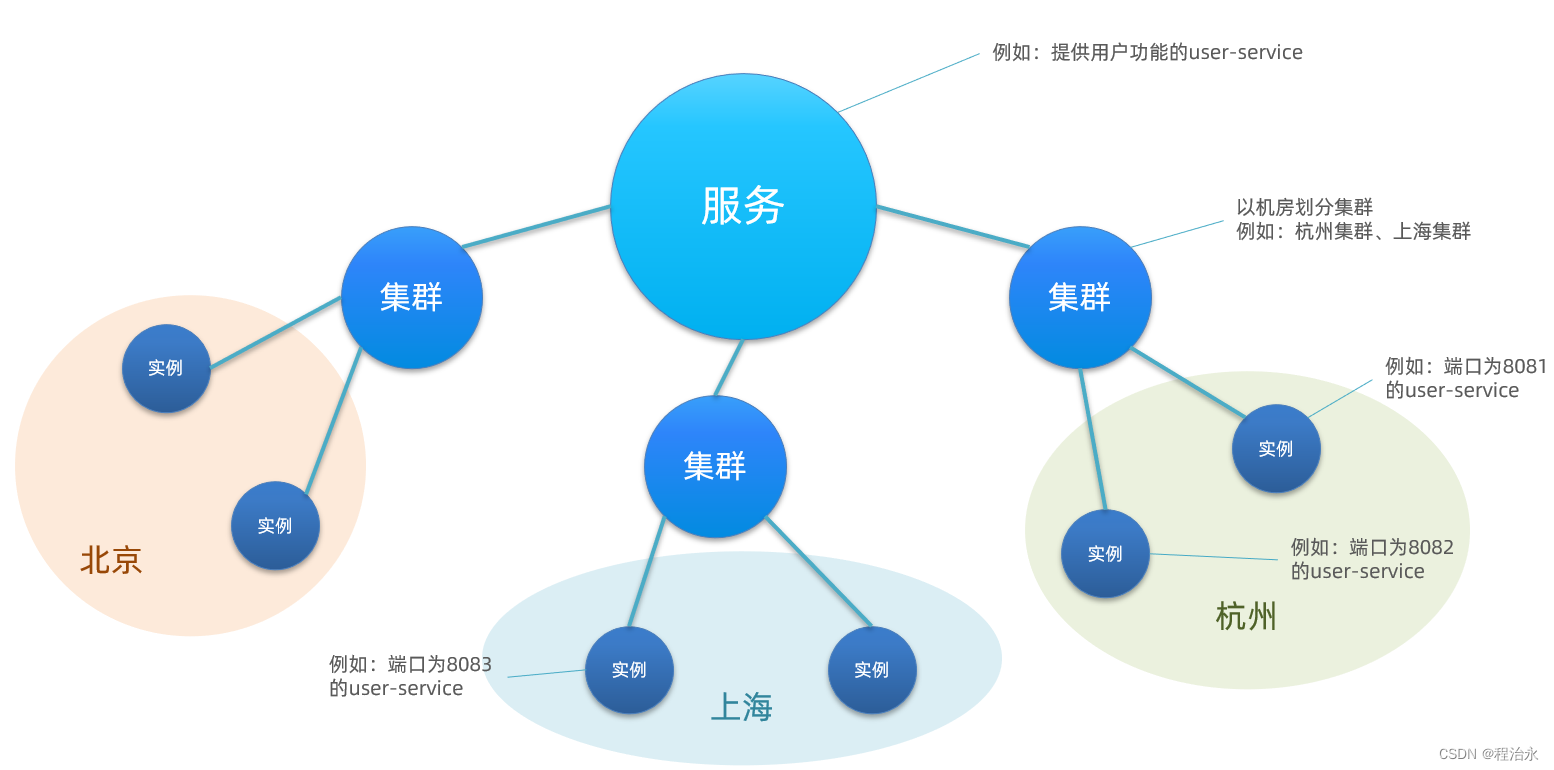
Nacos就将同一机房内的实例 划分为一个集群。
也就是说,user-service是服务,一个服务可以包含多个集群,如杭州、上海,每个集群下可以有多个实例,形成分级模型,如图:
微服务互相访问时,应该尽可能访问同集群实例,因为本地访问速度更快。当本集群内不可用时,才访问其它集群。例如:
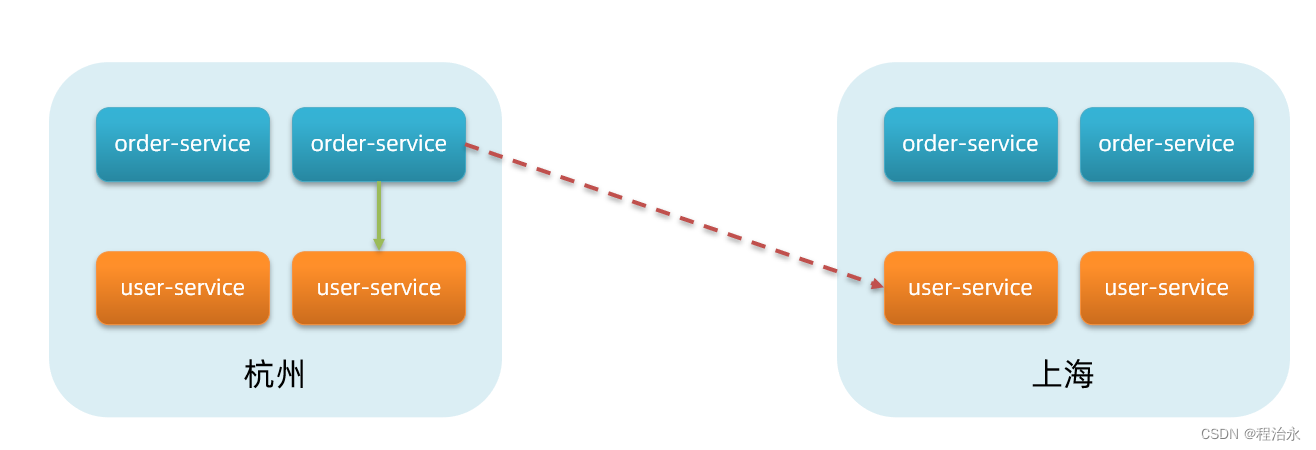
杭州机房内的order-service应该优先访问同机房的user-service。
5.3 给user-service配置集群
在user-service的application.yaml文件中修改:
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
     	 cluster-name: SH # 集群名称
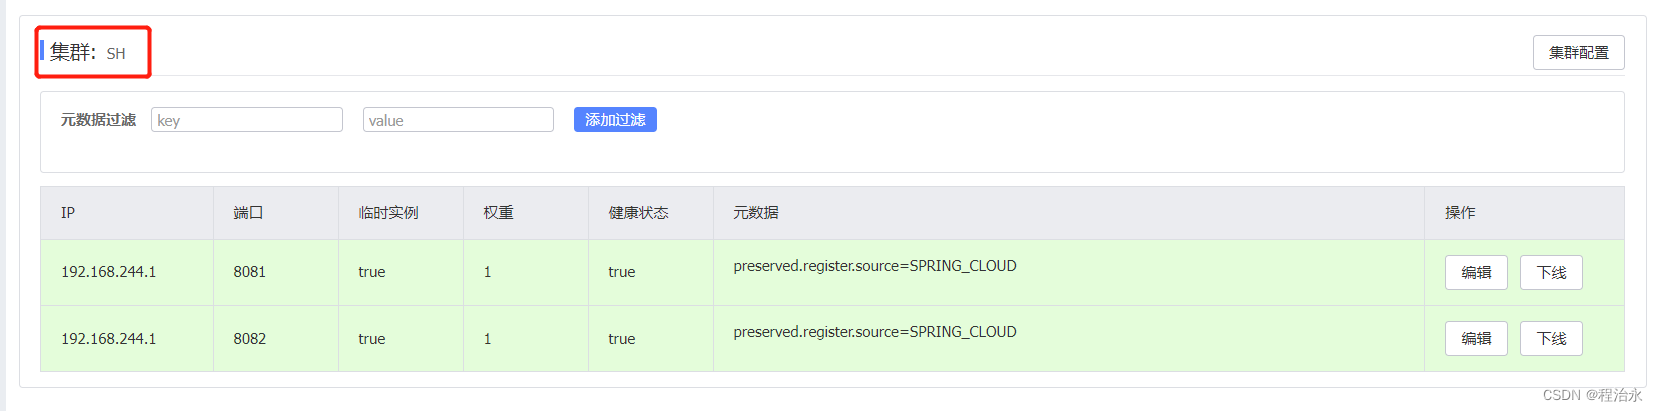
重启两个user-service实例后,我们可以在nacos控制台看到下面结果:
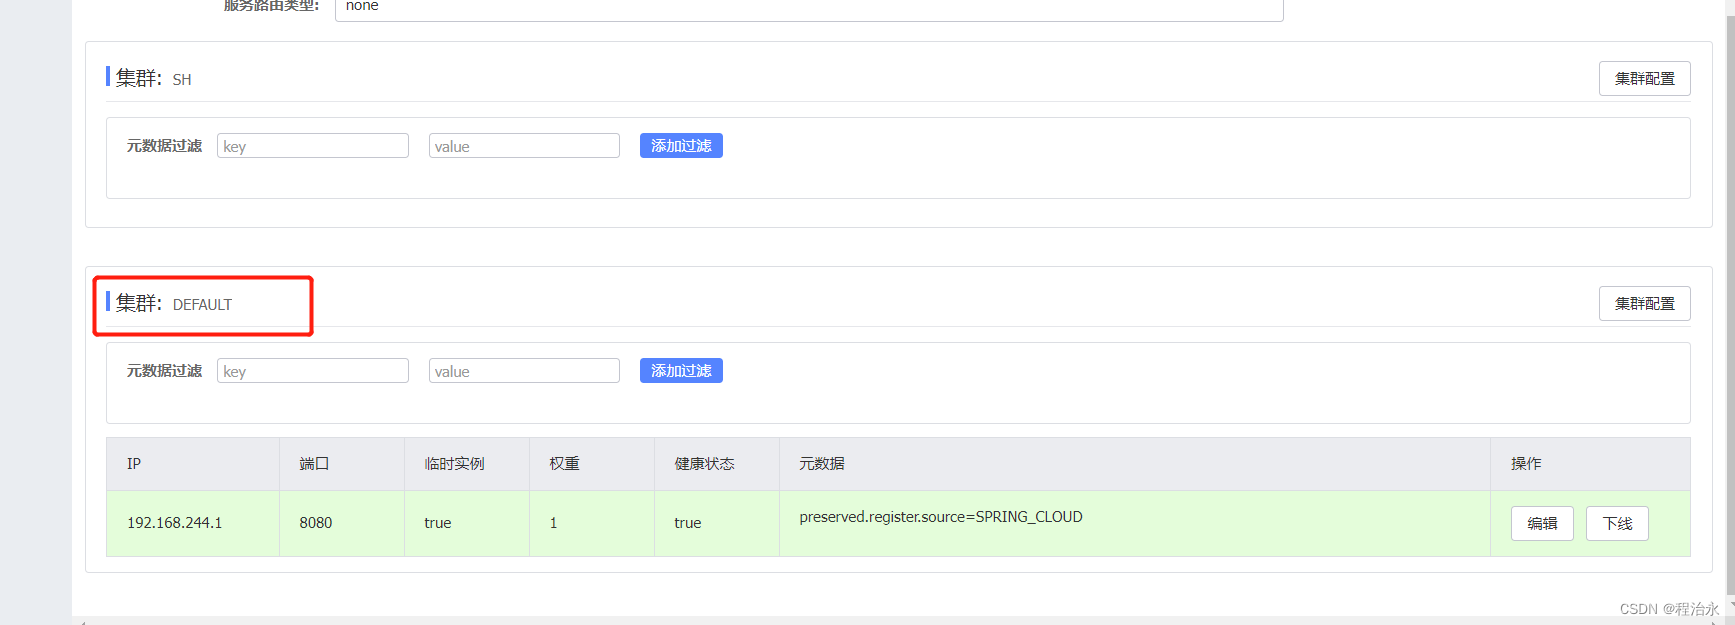
而默认的集群是default,比如order-service
我们再次复制一个user-service启动配置,添加属性:
-Dserver.port=8083 -Dspring.cloud.nacos.discovery.cluster-name=SH
启动项目后,是这样的:
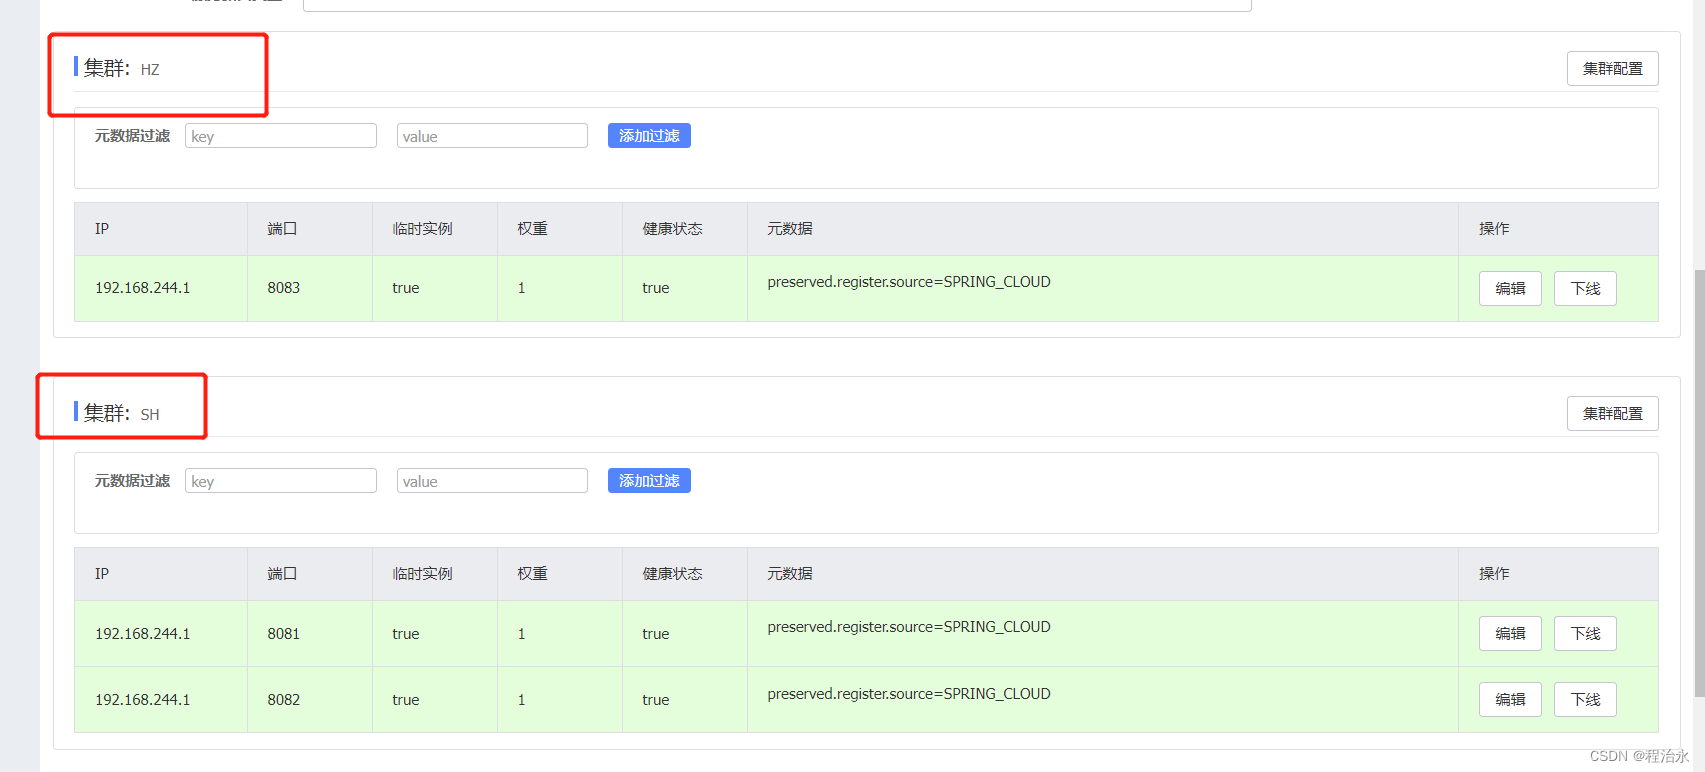
5.3.1 同集群优先的负载均衡
默认的ZoneAvoidanceRule并不能实现根据同集群优先来实现负载均衡
如图:
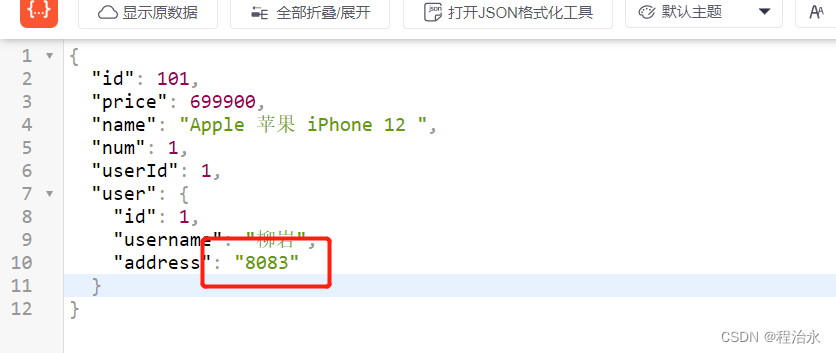
order-service的集群是SH, 应该优先选择SH 集群的user-service,而现在会出现轮询选择非同集群下的服务。
因此nacos提供了一个NacosRule的实现,可以优先从同集群中挑选实例。
给order-service配置集群信息
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
        cluster-name: SH # 集群名称
修改负载均衡规则:
修改order-service的application.yml文件,修改负载均衡规则:
userservice:
  ribbon:
    NFLoadBalancerRuleClassName: com.alibaba.cloud.nacos.ribbon.NacosRule # 负载均衡规则
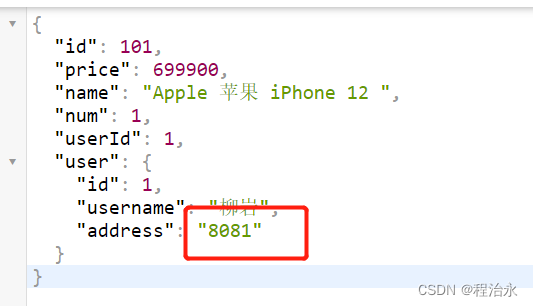
同集群的服务正常运行的情况下,不会访问其他集群的服务。
如果同集群下的服务都停止运行,才会去调用其他集群的服务。
5.4 权重配置
实际部署中会出现这样的场景:
服务器设备性能有差异,部分实例所在机器性能较好,另一些较差,我们希望性能好的机器承担更多的用户请求。
但默认情况下NacosRule是同集群内随机挑选,不会考虑机器的性能问题。
因此,Nacos提供了权重配置来控制访问频率,权重越大则访问频率越高。
在nacos控制台,找到user-service的实例列表,点击编辑,即可修改权重:
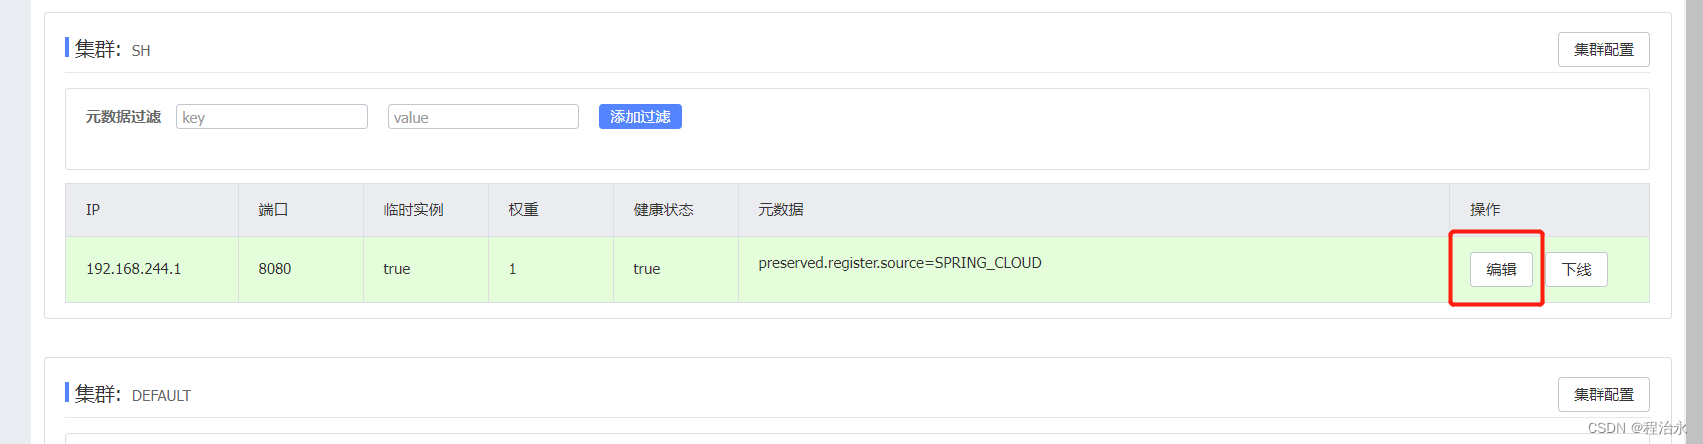
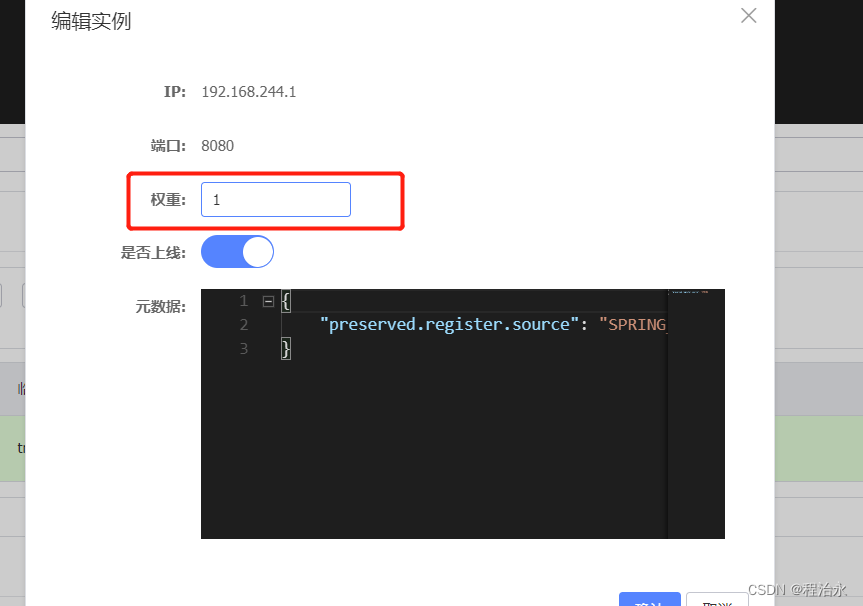
注意:如果权重修改为0,则该实例永远不会被访问,最大值为1
5.5 环境隔离
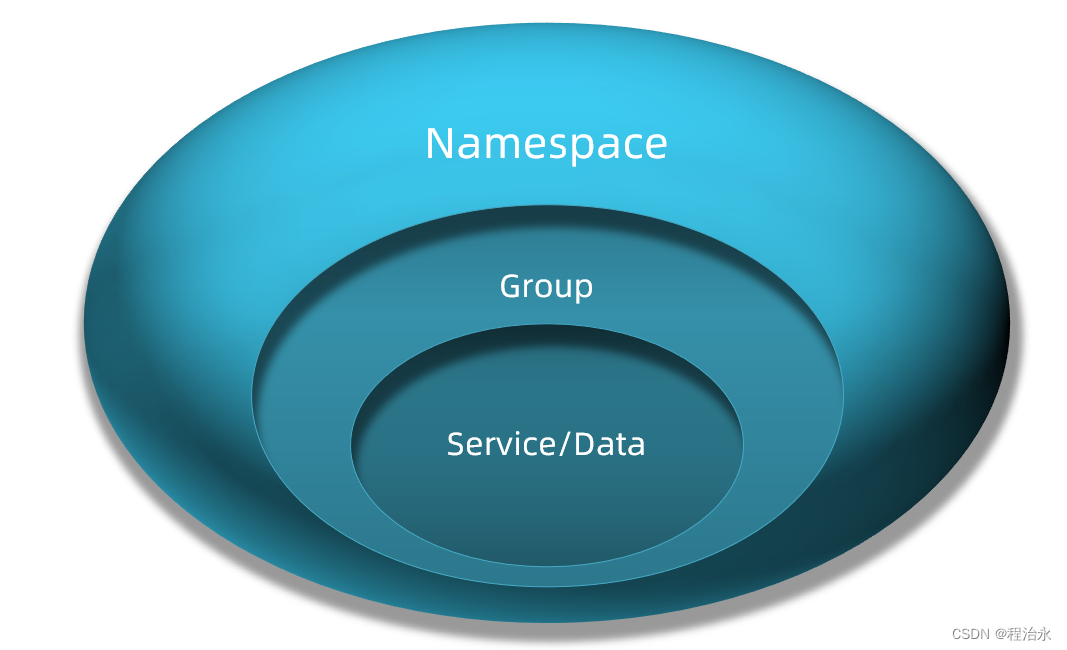
Nacos提供了namespace来实现环境隔离功能。
- nacos中可以有多个namespace
- namespace下可以有group、service等
- 不同namespace之间相互隔离,例如不同namespace的服务互相不可见
5.5.1 创建命名空间
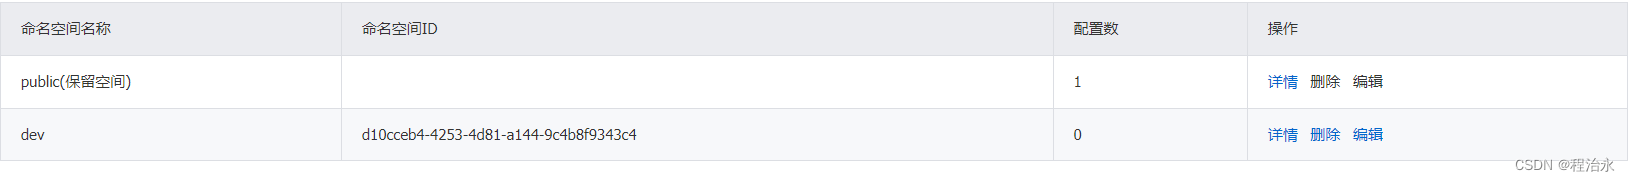
默认情况下,所有service、data、group都在同一个namespace,名为public:
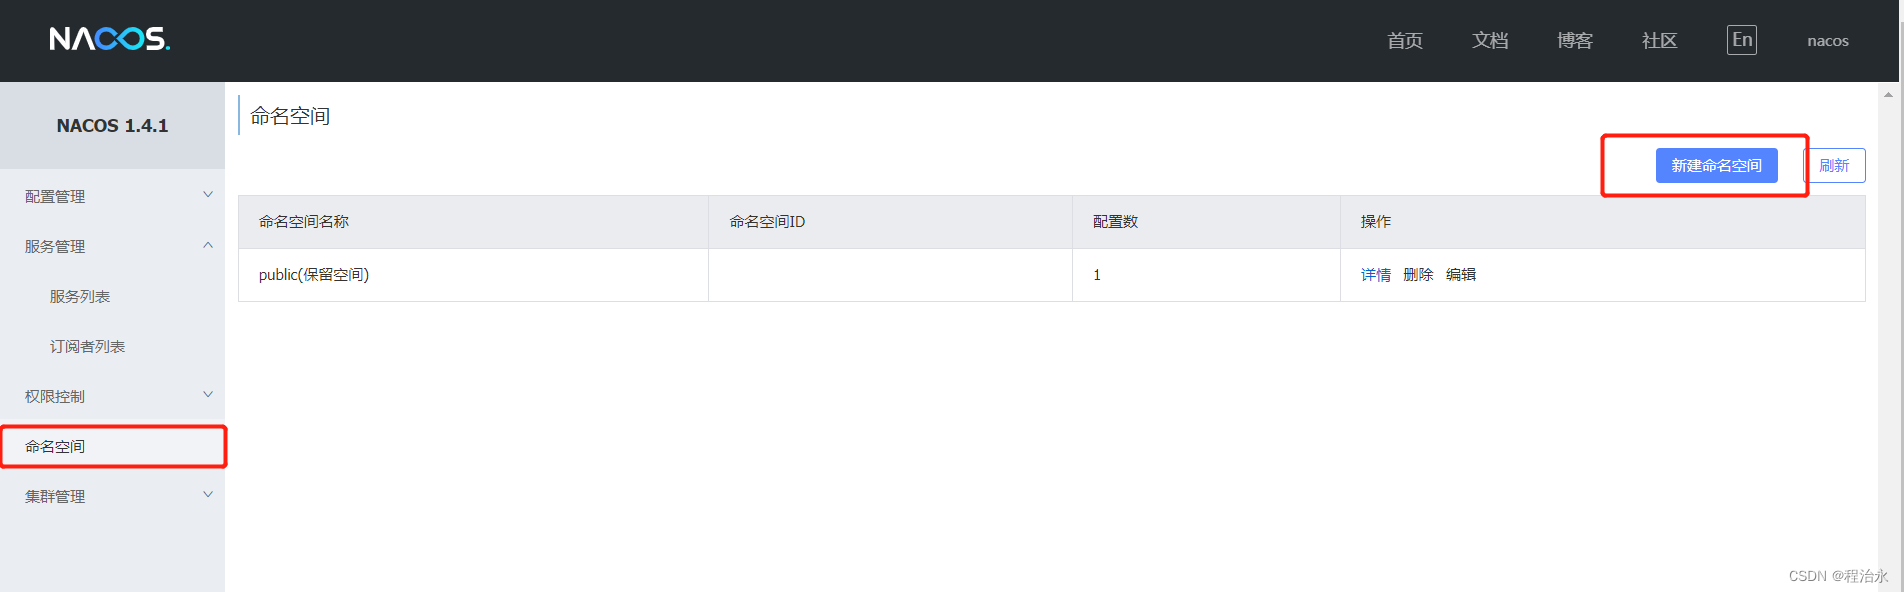
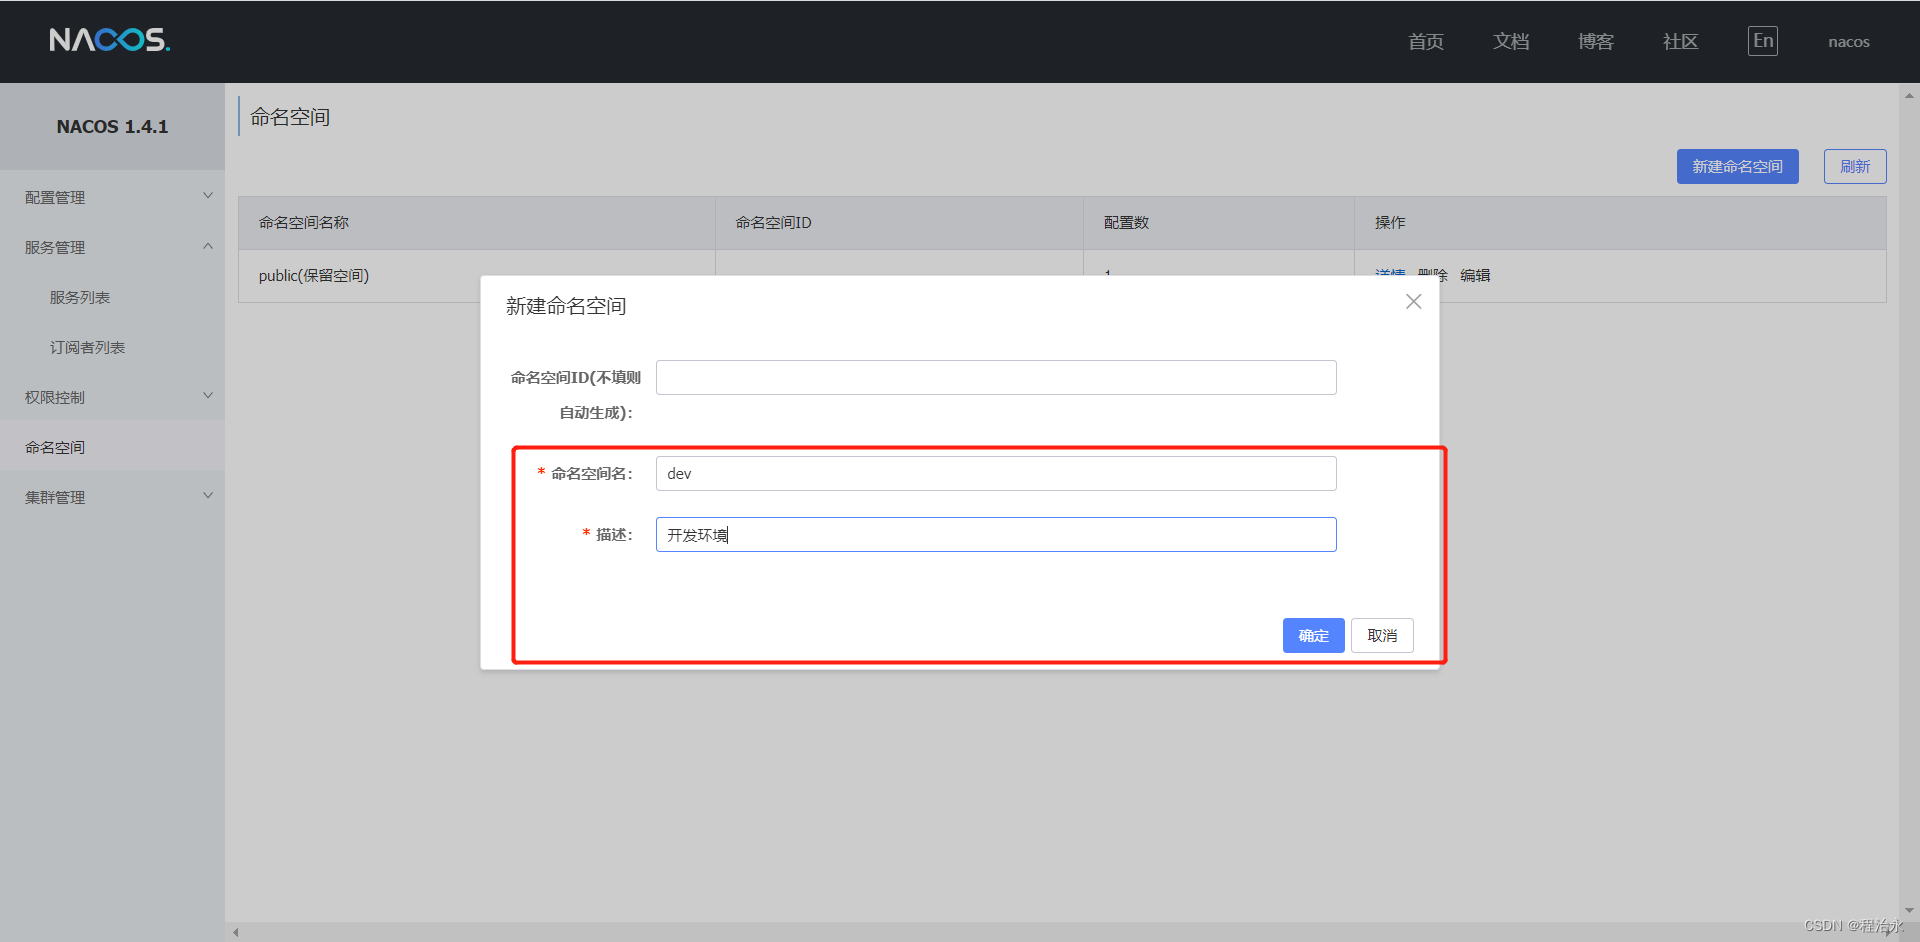
就能在页面看到一个新的namespace:
5.5.2 给微服务配置namespace
修改order-service的application.yml文件:
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
        cluster-name: HZ
        namespace: 492a7d5d-237b-46a1-a99a-fa8e98e4b0f9 # 命名空间,填ID
重启order-service后,访问控制台,可以看到下面的结果:
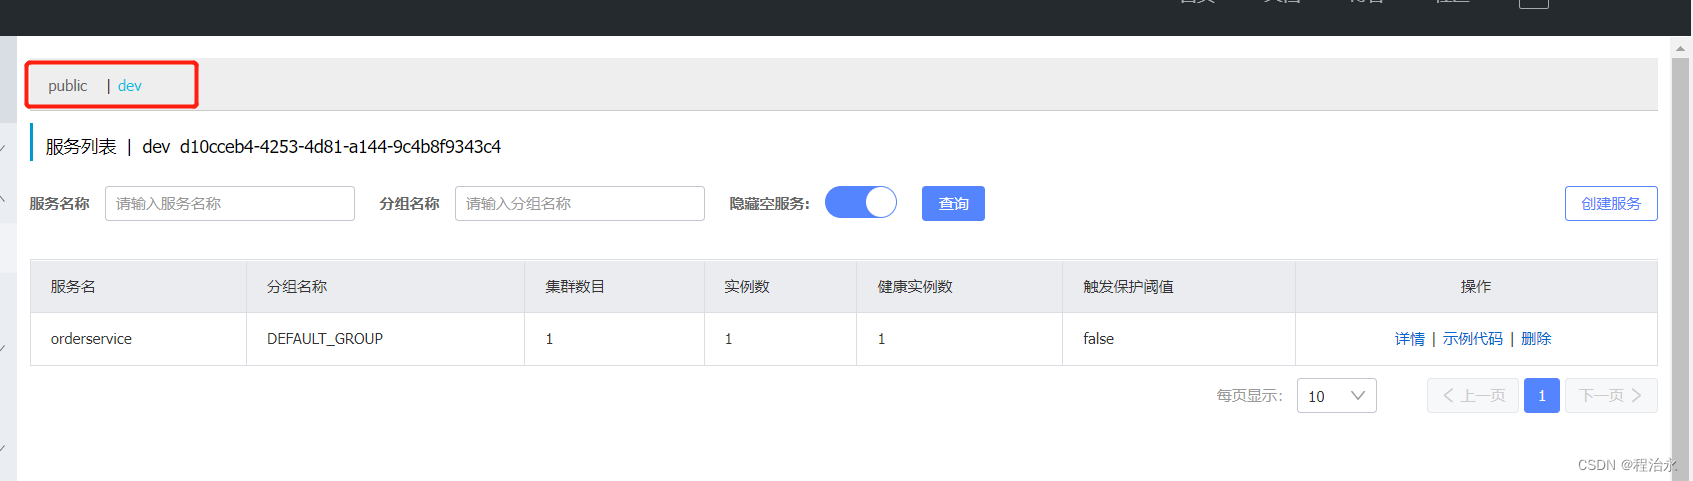
没有设置namespace的默认就是public,这个时候访问localhost:8080/order/1会报错,因为user-service和order-service不在同一个namespace,无法访问。
Eureka和Nacos的区别
Nacos的服务实例分为两种类型:
- 临时实例:如果实例宕机超过一定时间,会从服务列表剔除,默认的类型
- 非临时实例:如果实例宕机,不会从服务列表删除
配置一个服务实例为永久实例:
spring:
  cloud:
    nacos:
      discovery:
        ephemeral: false # 设置为非临时实例
Nacos和Eureka整体结构类似,服务注册,服务发现,心跳等待,但是也存在一些差异:
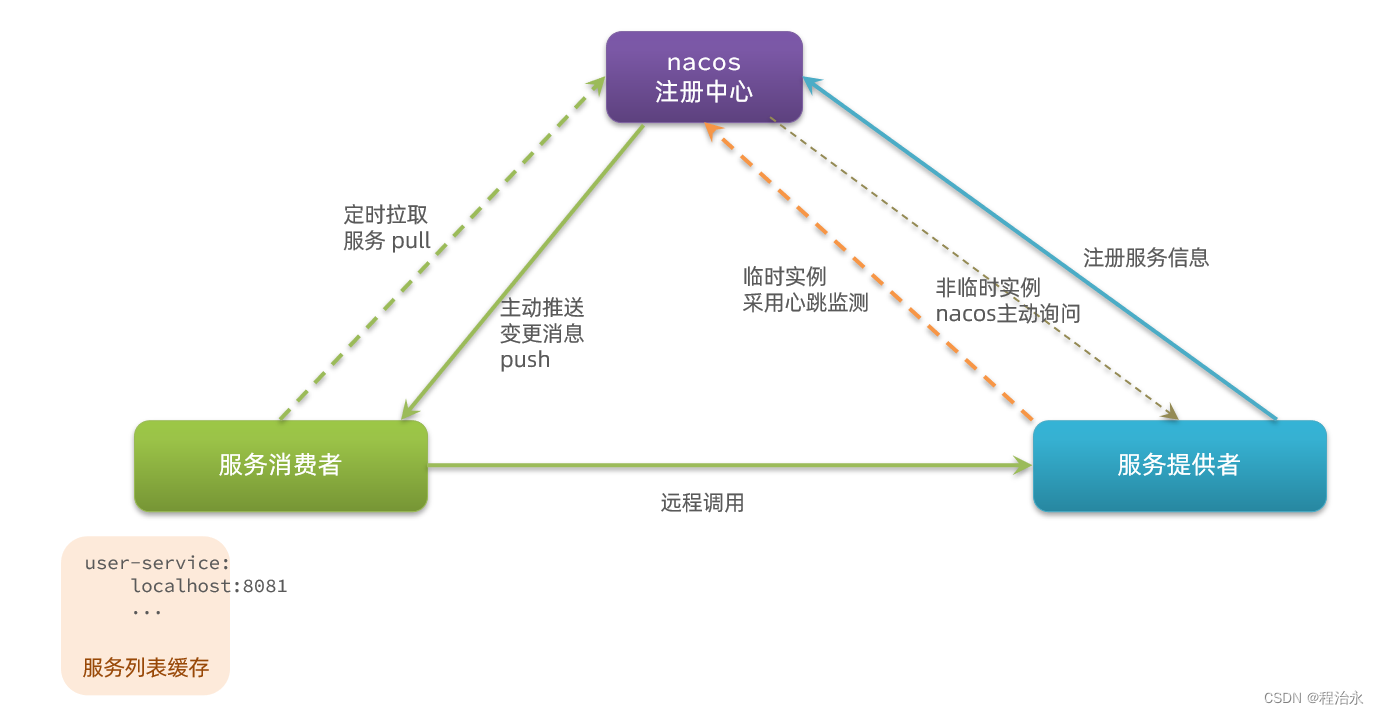
Nacos与eureka的共同点
- 都支持服务注册和服务拉取
- 都支持服务提供者心跳方式做健康检测
Nacos与Eureka的区别
- nacos支持服务端主动检测提供者的状态:临时实例采用心跳机制,非临时实例采用主动检测模式
- 临时实例会剔除心跳不正常的服务,非临时实例不会剔除
- nacos支持服务列表变更消息推送模式,服务列表更新及时
- Nacos集群默认采用AP模式,当集群中存在非临时实例时,采用CP模式,Eureka采用AP模式
6. Nacos配置管理
Nacos除了可以做注册中心,同样可以做配置管理来使用。
6.1 统一配置管理
当微服务部署的实例越来越多时,如果一个一个的修改配置文件很麻烦,而且很容易出错,所以就需要一种统一配置管理的方案,可以集中管理配置。
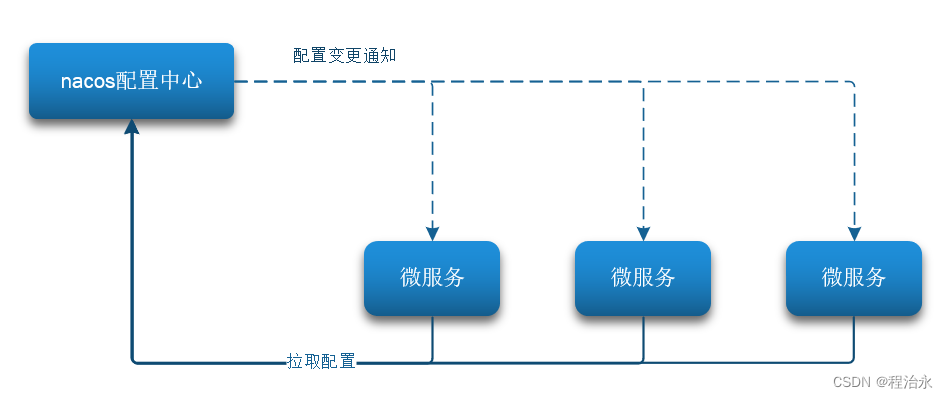
Nacos一方面可以将配置集中管理,另一方可以在配置变更时,及时通知微服务,实现配置的热更新。
6.1.1 在nacos中添加配置文件
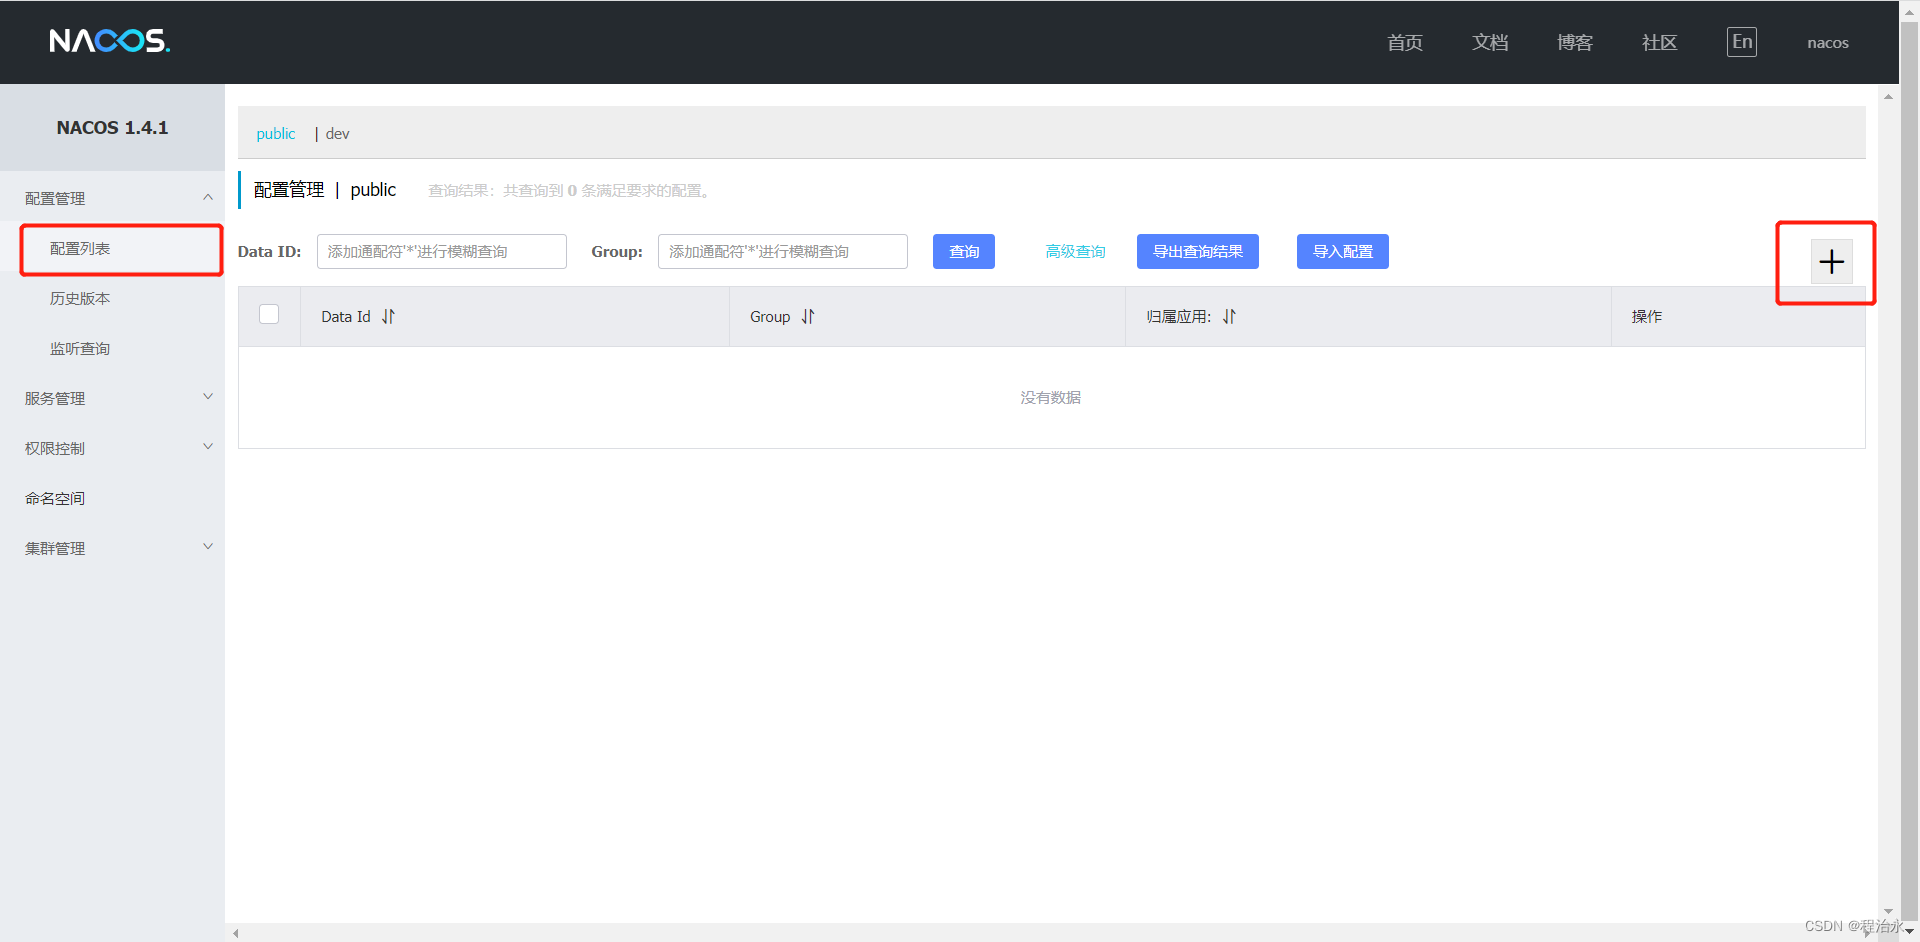
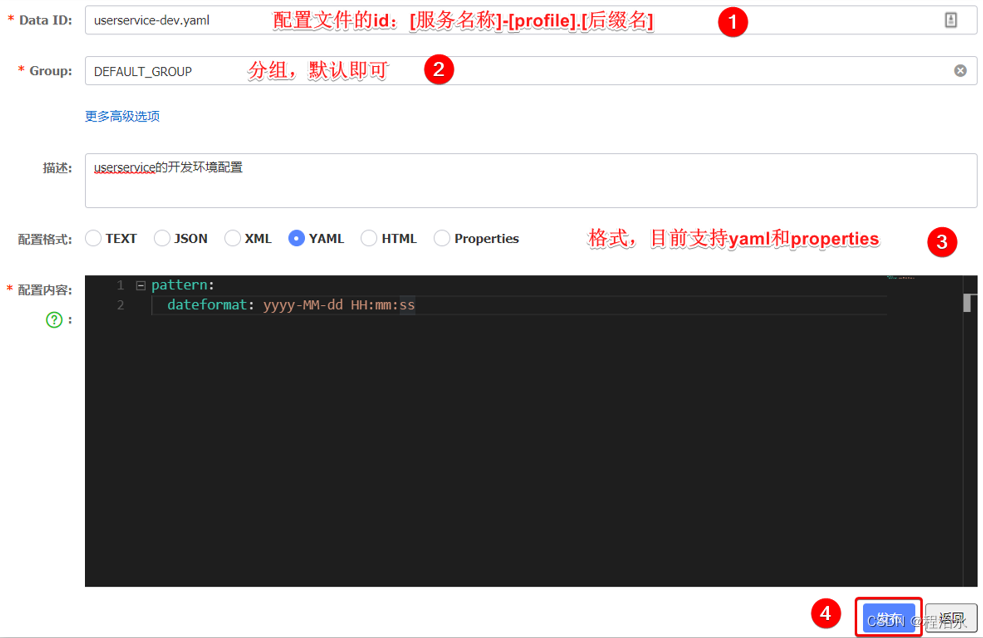
Data ID 的完整规则格式如下:
{prefix}-{spring.profile.active}.{file-extension}
- prefix默认为所属工程配置spring.application.name 的值
- spring.profile.active 即为当前环境对应的 profile ,注意:当 spring.profiles.active 为空时,对应的连接符 - 也将不存在,Data ID 的拼接格式变成 {prefix}.{file-extension}
- file-extension:为配置内容的数据格式,目前支持yaml和properties
注意:项目的核心配置,需要热更新的配置才有放到nacos管理的必要。基本不会变更的一些配置还是保存在微服务本地比较好。
6.1.2 从微服务拉取配置
微服务要拉取nacos中管理的配置,并且与本地的application.yml配置合并,才能完成项目启动。
但如果尚未读取application.yml,又如何得知nacos地址呢?
因此spring引入了一种新的配置文件:bootstrap.yaml文件,会在application.yml之前被读取,流程如下:
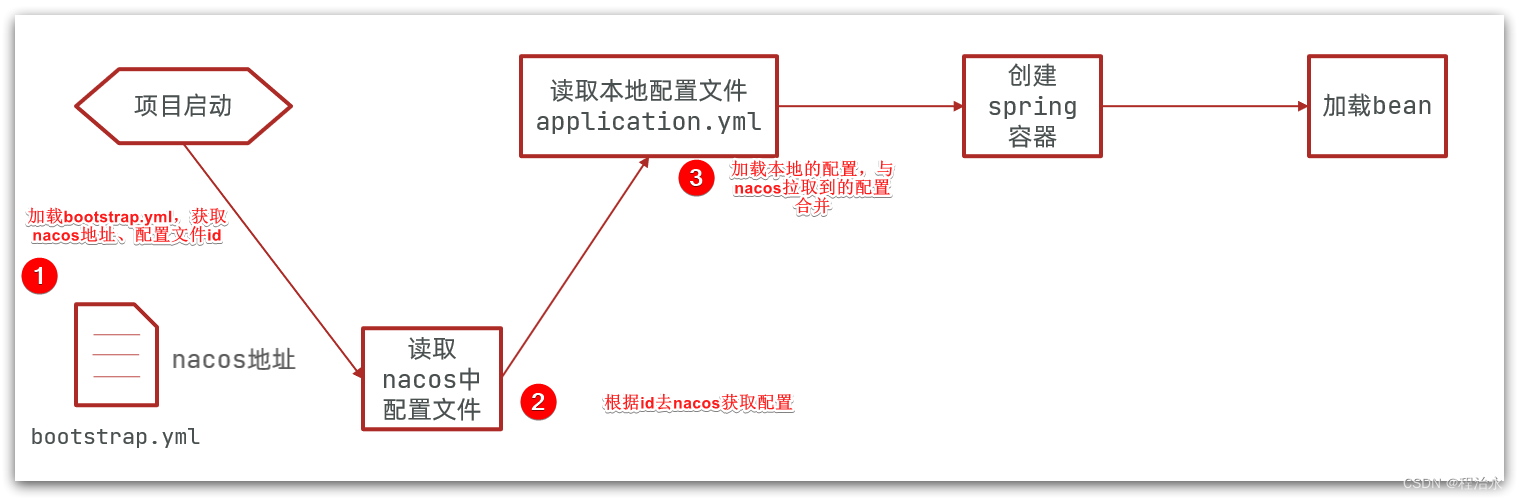
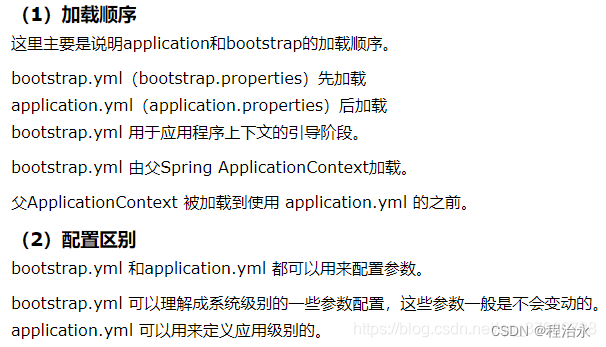
ps:springboot配置文件的加载顺序:
其实yml和properties文件是一样的原理,且一个项目上要么yml或者properties,二选一的存在。推荐使用yml,更简洁。
bootstrap与application
引入nacos-config依赖
首先,在user-service服务中,引入nacos-config的客户端依赖:
<!--nacos配置管理依赖-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
</dependency>
创建bootstrap.yml配置文件
spring:
  application:
    name: userservice # 服务名称
  profiles:
    active: dev #开发环境,这里是dev
  cloud:
    nacos:
      server-addr: localhost:8848 # Nacos地址
      config:
        file-extension: yaml # 文件后缀名
这里会根据spring.cloud.nacos.server-addr获取nacos地址,再根据
${spring.application.name}-${spring.profiles.active}.${spring.cloud.nacos.config.file-extension}作为文件id,来读取配置。
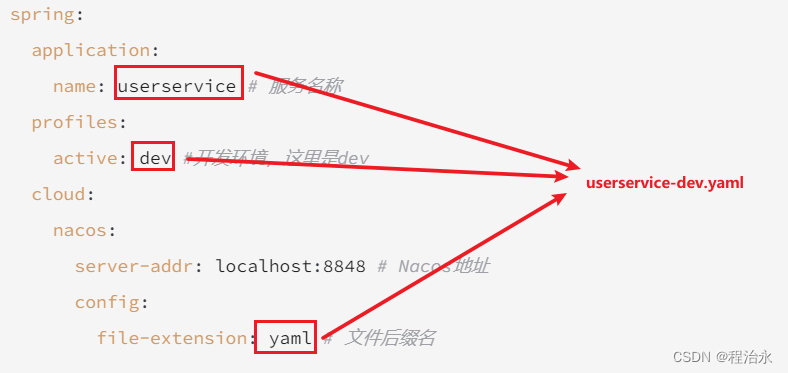
这样配置会去nacos中找userservice-dev.yaml配置文件
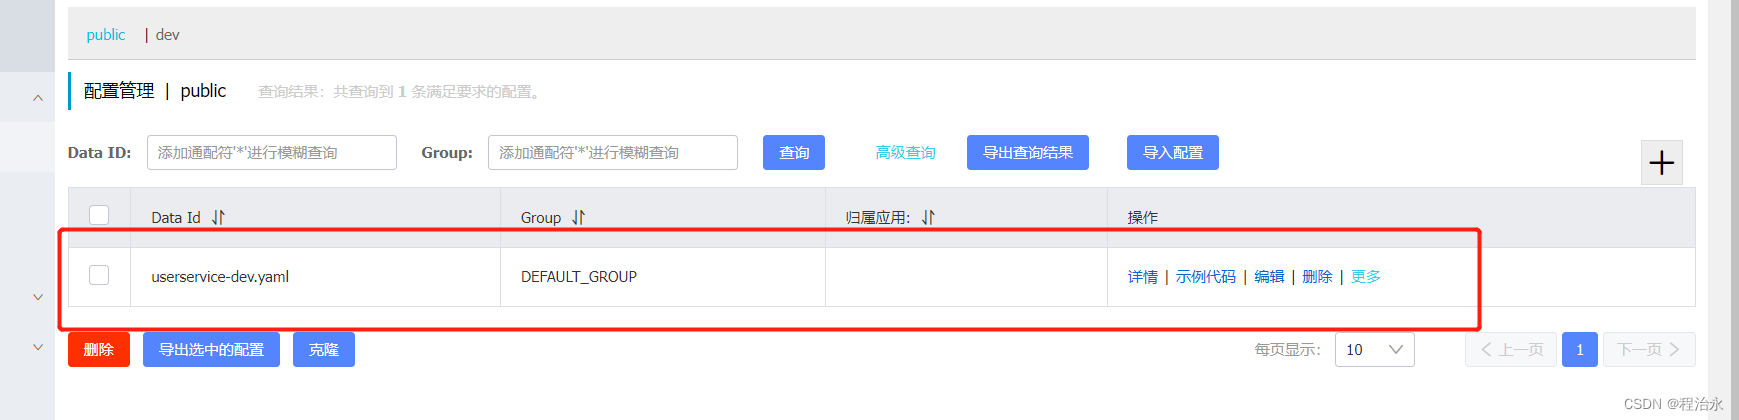
读取配置文件
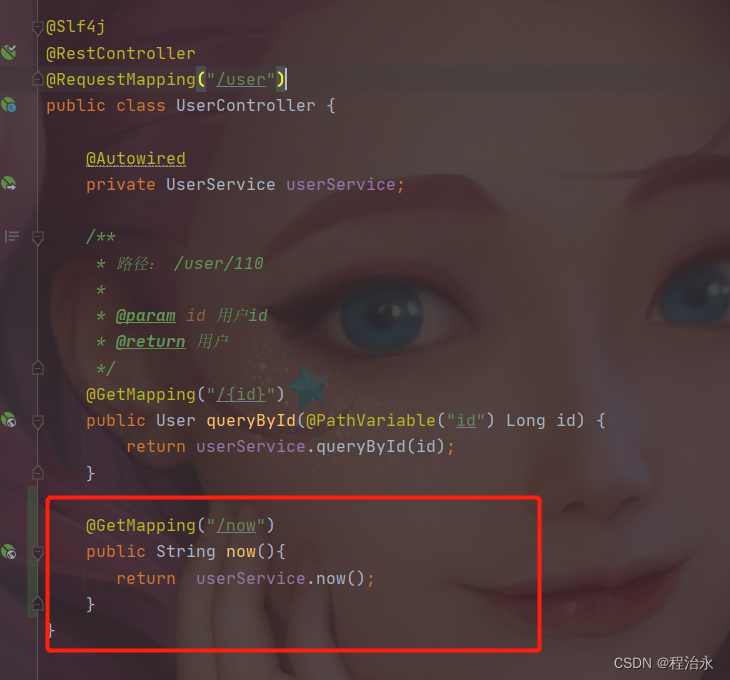
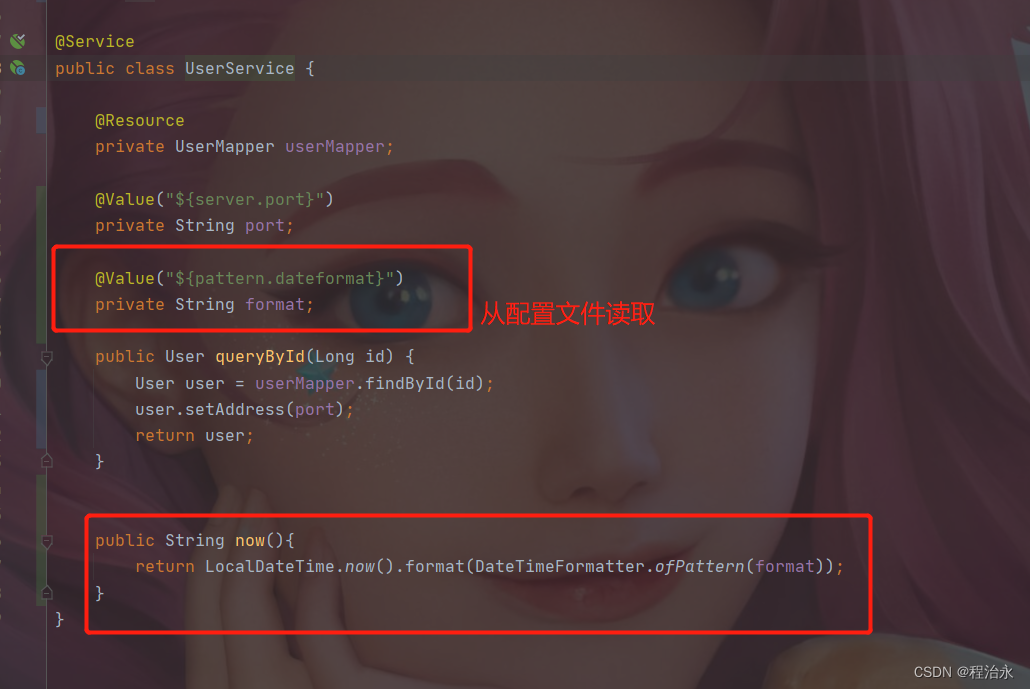
在user-service中的UserController中添加业务逻辑,读取pattern.dateformat配置:
controller:
service:
结果:
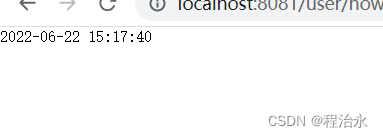
按照nacos配置文件中的格式输出。
6.2 配置热更新
使用nacos管理配置文件的最终目的是在nacos修改之后,微服务无需重启直接可以让配置生效,也就是配置热更新。
实现配置热更新有两种方式:
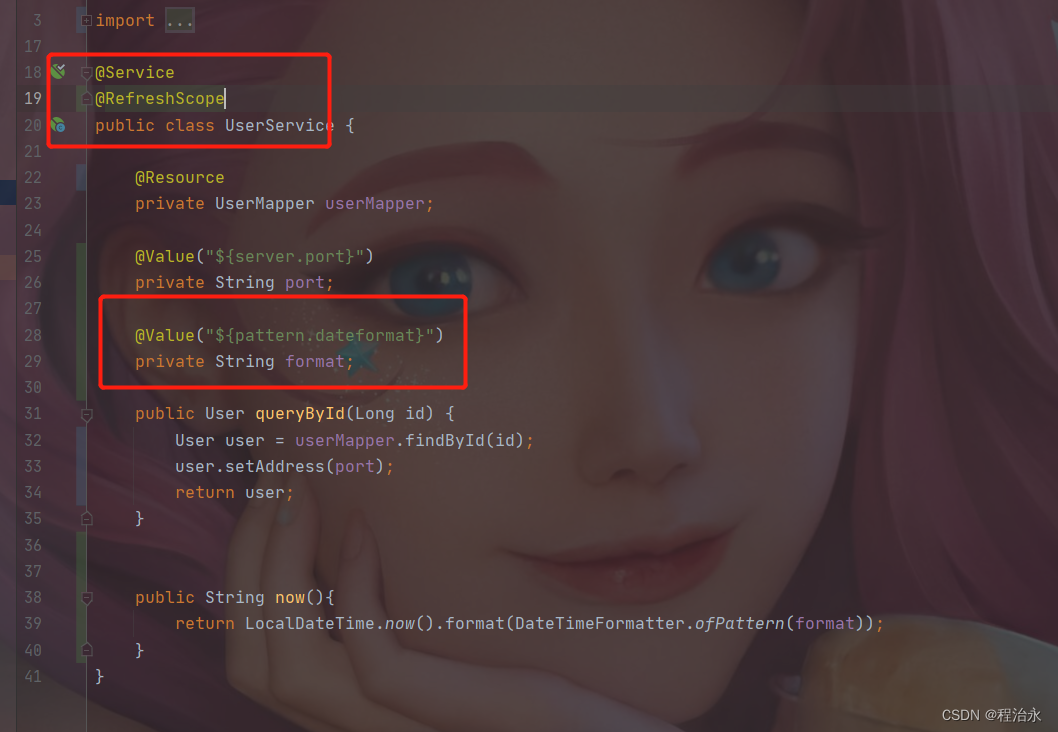
方式一:
在@Value注入的变量所在类上添加注解@RefreshScope:
方式二:
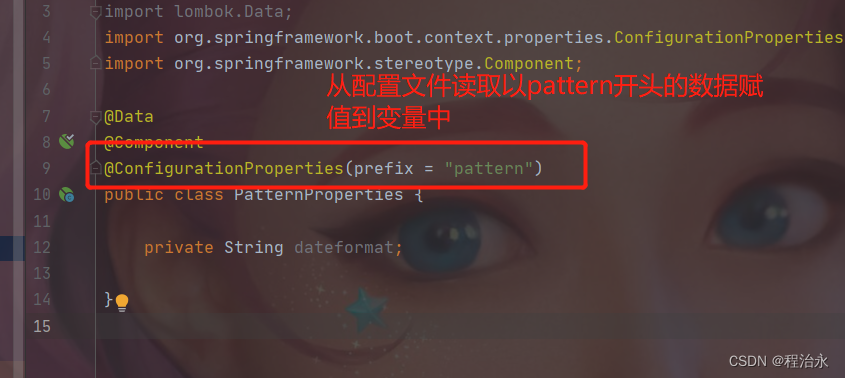
使用@ConfigurationProperties注解代替@Value注解。
在user-service服务中,添加一个类,读取patterrn.dateformat属性:
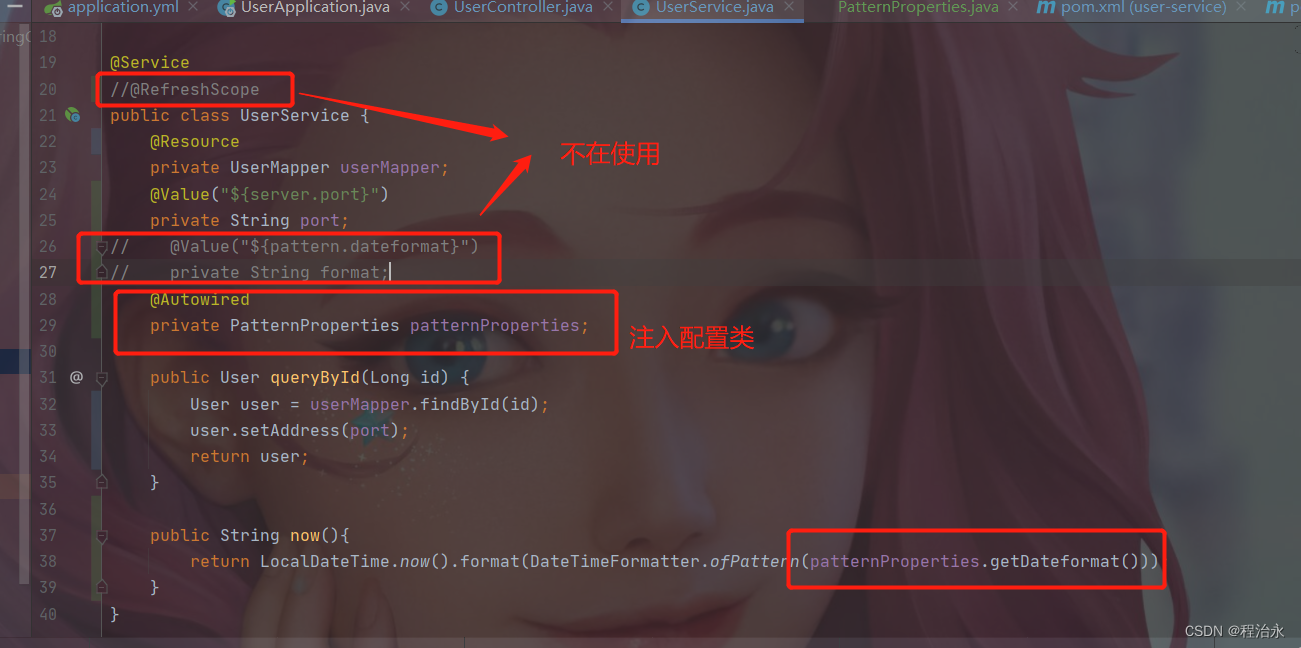
servie修改:
6.3 配置共享
其实微服务启动时,会去nacos读取多个配置文件,例如:
-
[spring.application.name]-[spring.profiles.active].yaml,例如:userservice-dev.yaml -
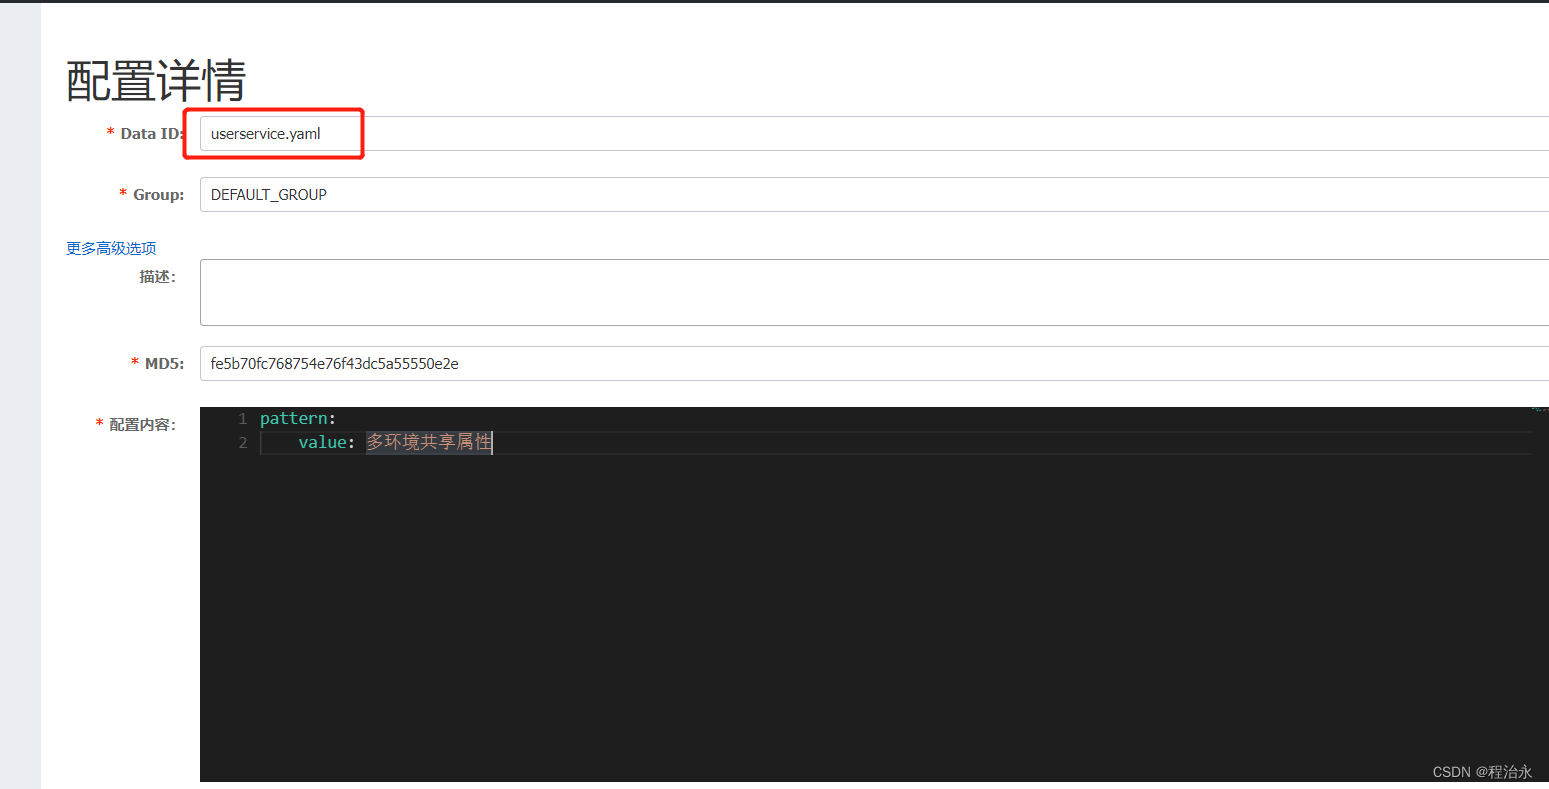
[spring.application.name].yaml,例如:userservice.yaml
而[spring.application.name].yaml不包含环境,因此可以被多个环境共享。
在nacos创建一个没有环境的配置文件:
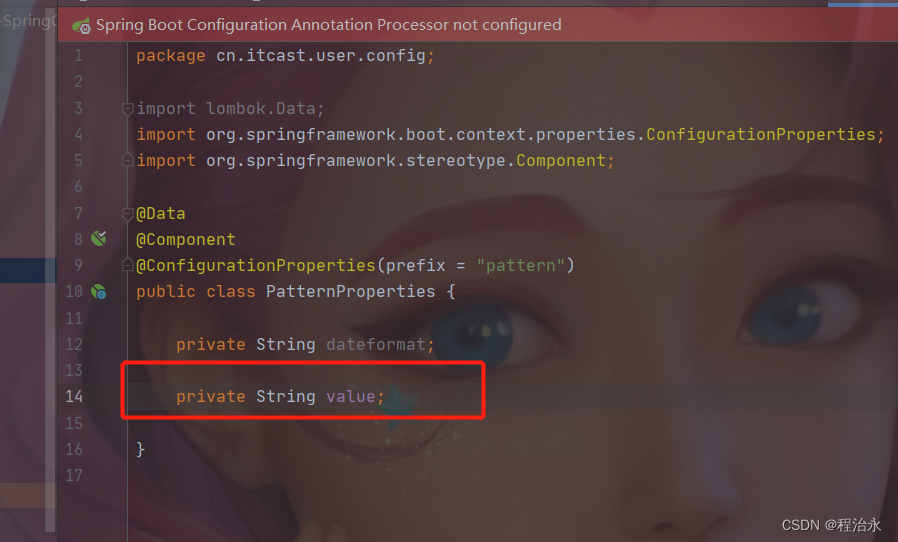
在use-service服务中配置类中添加字段接收:
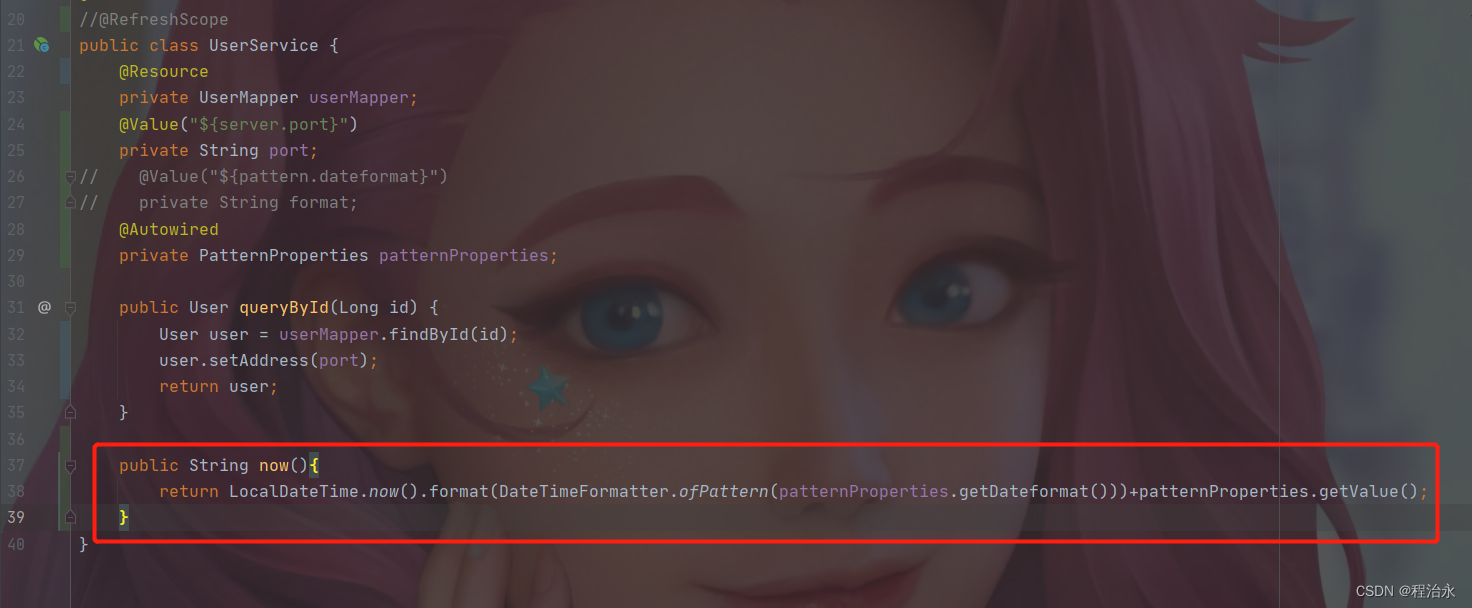
在servcie中获取:
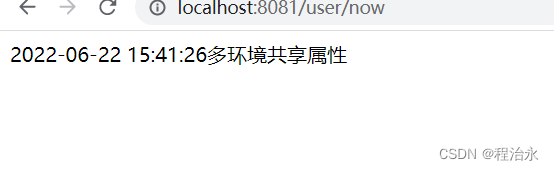
结果:
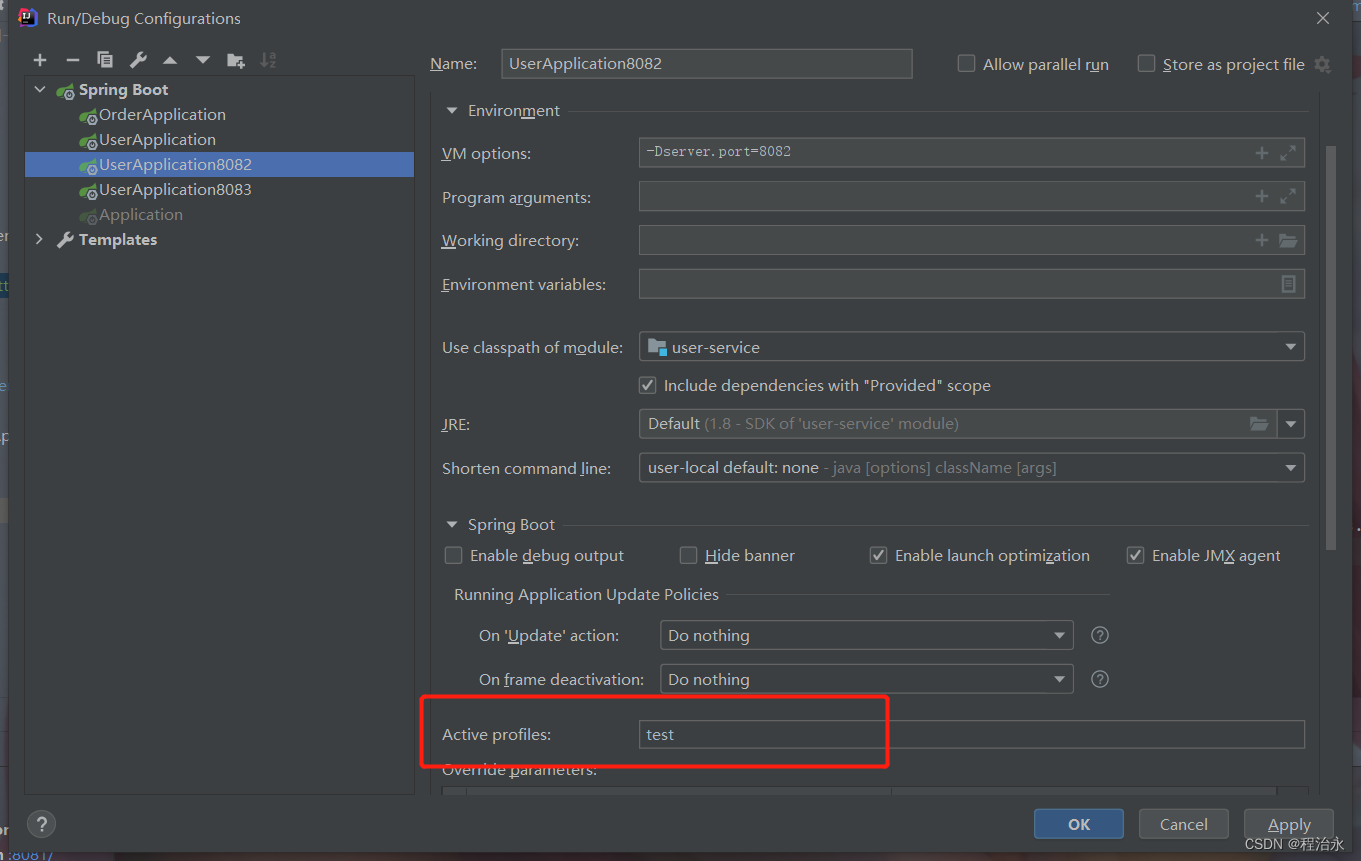
对user-service2修改环境:
重启之后访问:
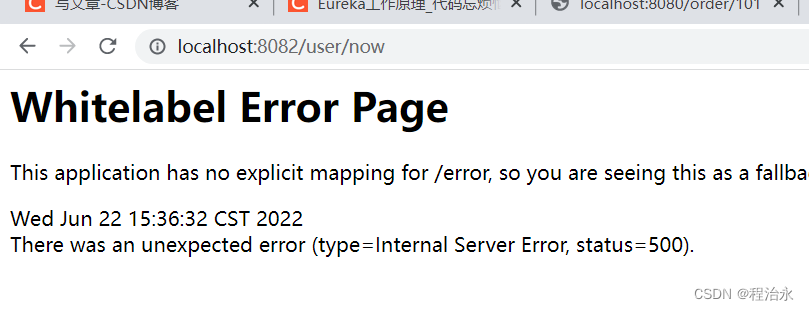
后端错误分析:
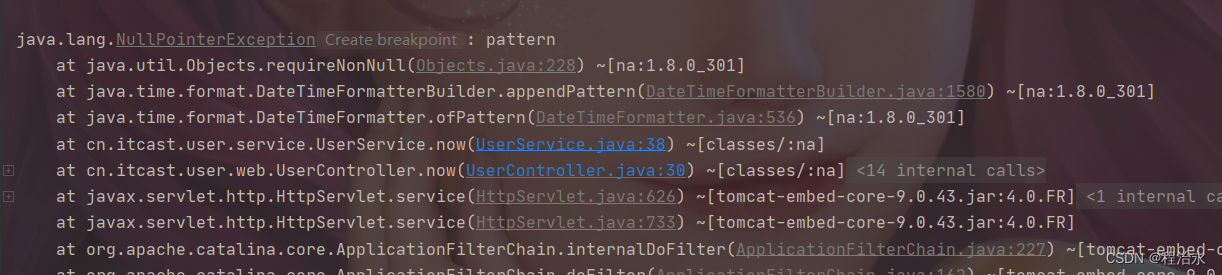
报空指针异常,nacos中管理的配置文件是userservcie-dev.yaml,项目2的环境为test,对应的应该去找userservice-test.yaml配置文件,因为找不到配置文件,所以getDateformat()会报空指针,不妨我们把getDateformat()方法去掉试一下:
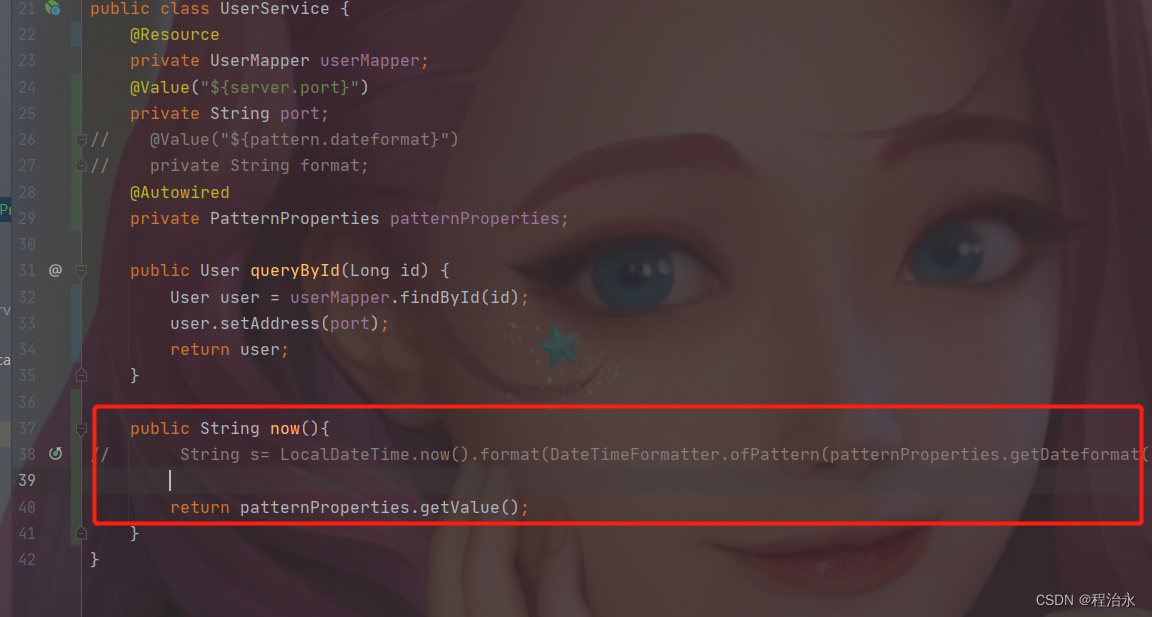
问题解决:
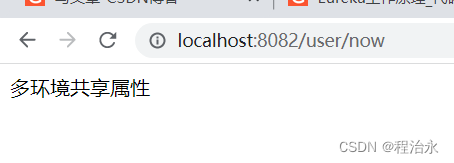
可以看出不加环境,可以为环境共享;各自的环境只能访问各自的以及共享的。
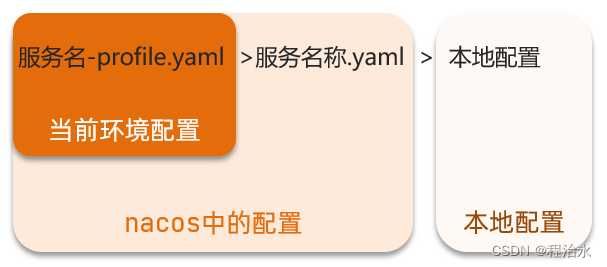
当nacos、服务本地同时出现相同属性时,优先级有高低之分:
6.4 Nacos集群搭建
Nacos生产环境下一定要部署为集群状态.
集群结构图(官网的):
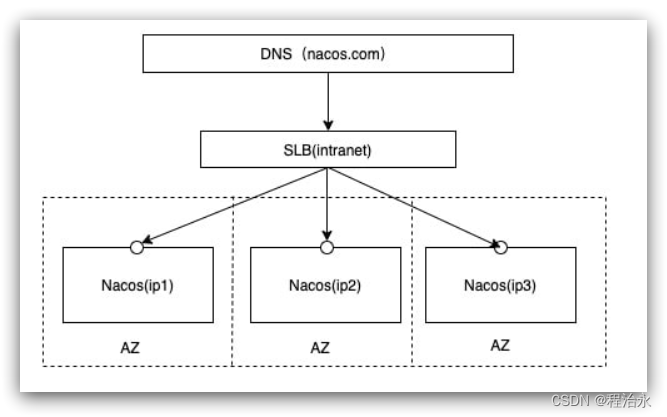
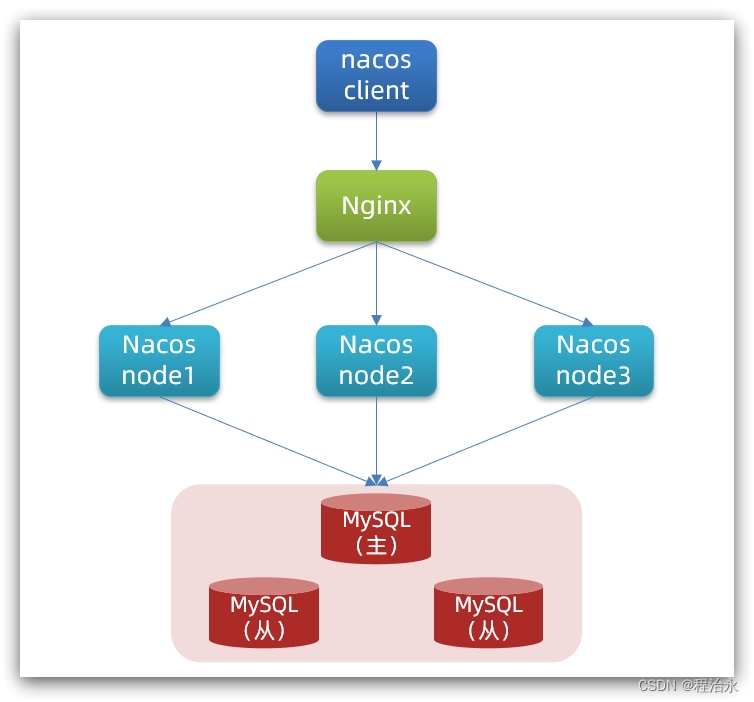
其中包含3个nacos节点,然后一个负载均衡器代理3个Nacos。这里负载均衡器可以使用nginx。
我们计划的集群结构:
6.4.1集群搭建
搭建集群的基本步骤:
- 搭建数据库,初始化数据库表结构
- 下载nacos安装包
- 配置nacos
- 启动nacos集群
- nginx反向代理
6.6.1.1 初始化数据库
Nacos默认数据存储在内嵌数据库Derby中,不属于生产可用的数据库。
官方推荐的最佳实践是使用带有主从的高可用数据库集群,主从模式的高可用数据库可以参考其他资料。
这里我们以单点的数据库为例来讲解。
首先新建一个数据库,命名为nacos,而后导入下面的SQL:
CREATE TABLE `config_info` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id',
  `data_id` varchar(255) NOT NULL COMMENT 'data_id',
  `group_id` varchar(255) DEFAULT NULL,
  `content` longtext NOT NULL COMMENT 'content',
  `md5` varchar(32) DEFAULT NULL COMMENT 'md5',
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间',
  `src_user` text COMMENT 'source user',
  `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip',
  `app_name` varchar(128) DEFAULT NULL,
  `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段',
  `c_desc` varchar(256) DEFAULT NULL,
  `c_use` varchar(64) DEFAULT NULL,
  `effect` varchar(64) DEFAULT NULL,
  `type` varchar(64) DEFAULT NULL,
  `c_schema` text,
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_configinfo_datagrouptenant` (`data_id`,`group_id`,`tenant_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info';

/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = config_info_aggr   */
/******************************************/
CREATE TABLE `config_info_aggr` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id',
  `data_id` varchar(255) NOT NULL COMMENT 'data_id',
  `group_id` varchar(255) NOT NULL COMMENT 'group_id',
  `datum_id` varchar(255) NOT NULL COMMENT 'datum_id',
  `content` longtext NOT NULL COMMENT '内容',
  `gmt_modified` datetime NOT NULL COMMENT '修改时间',
  `app_name` varchar(128) DEFAULT NULL,
  `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_configinfoaggr_datagrouptenantdatum` (`data_id`,`group_id`,`tenant_id`,`datum_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='增加租户字段';


/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = config_info_beta   */
/******************************************/
CREATE TABLE `config_info_beta` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id',
  `data_id` varchar(255) NOT NULL COMMENT 'data_id',
  `group_id` varchar(128) NOT NULL COMMENT 'group_id',
  `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name',
  `content` longtext NOT NULL COMMENT 'content',
  `beta_ips` varchar(1024) DEFAULT NULL COMMENT 'betaIps',
  `md5` varchar(32) DEFAULT NULL COMMENT 'md5',
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间',
  `src_user` text COMMENT 'source user',
  `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip',
  `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_configinfobeta_datagrouptenant` (`data_id`,`group_id`,`tenant_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info_beta';

/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = config_info_tag   */
/******************************************/
CREATE TABLE `config_info_tag` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id',
  `data_id` varchar(255) NOT NULL COMMENT 'data_id',
  `group_id` varchar(128) NOT NULL COMMENT 'group_id',
  `tenant_id` varchar(128) DEFAULT '' COMMENT 'tenant_id',
  `tag_id` varchar(128) NOT NULL COMMENT 'tag_id',
  `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name',
  `content` longtext NOT NULL COMMENT 'content',
  `md5` varchar(32) DEFAULT NULL COMMENT 'md5',
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间',
  `src_user` text COMMENT 'source user',
  `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_configinfotag_datagrouptenanttag` (`data_id`,`group_id`,`tenant_id`,`tag_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info_tag';

/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = config_tags_relation   */
/******************************************/
CREATE TABLE `config_tags_relation` (
  `id` bigint(20) NOT NULL COMMENT 'id',
  `tag_name` varchar(128) NOT NULL COMMENT 'tag_name',
  `tag_type` varchar(64) DEFAULT NULL COMMENT 'tag_type',
  `data_id` varchar(255) NOT NULL COMMENT 'data_id',
  `group_id` varchar(128) NOT NULL COMMENT 'group_id',
  `tenant_id` varchar(128) DEFAULT '' COMMENT 'tenant_id',
  `nid` bigint(20) NOT NULL AUTO_INCREMENT,
  PRIMARY KEY (`nid`),
  UNIQUE KEY `uk_configtagrelation_configidtag` (`id`,`tag_name`,`tag_type`),
  KEY `idx_tenant_id` (`tenant_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_tag_relation';

/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = group_capacity   */
/******************************************/
CREATE TABLE `group_capacity` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID',
  `group_id` varchar(128) NOT NULL DEFAULT '' COMMENT 'Group ID,空字符表示整个集群',
  `quota` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '配额,0表示使用默认值',
  `usage` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '使用量',
  `max_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个配置大小上限,单位为字节,0表示使用默认值',
  `max_aggr_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '聚合子配置最大个数,,0表示使用默认值',
  `max_aggr_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个聚合数据的子配置大小上限,单位为字节,0表示使用默认值',
  `max_history_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '最大变更历史数量',
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_group_id` (`group_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='集群、各Group容量信息表';

/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = his_config_info   */
/******************************************/
CREATE TABLE `his_config_info` (
  `id` bigint(64) unsigned NOT NULL,
  `nid` bigint(20) unsigned NOT NULL AUTO_INCREMENT,
  `data_id` varchar(255) NOT NULL,
  `group_id` varchar(128) NOT NULL,
  `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name',
  `content` longtext NOT NULL,
  `md5` varchar(32) DEFAULT NULL,
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `src_user` text,
  `src_ip` varchar(50) DEFAULT NULL,
  `op_type` char(10) DEFAULT NULL,
  `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段',
  PRIMARY KEY (`nid`),
  KEY `idx_gmt_create` (`gmt_create`),
  KEY `idx_gmt_modified` (`gmt_modified`),
  KEY `idx_did` (`data_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='多租户改造';


/******************************************/
/*   数据库全名 = nacos_config   */
/*   表名称 = tenant_capacity   */
/******************************************/
CREATE TABLE `tenant_capacity` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID',
  `tenant_id` varchar(128) NOT NULL DEFAULT '' COMMENT 'Tenant ID',
  `quota` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '配额,0表示使用默认值',
  `usage` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '使用量',
  `max_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个配置大小上限,单位为字节,0表示使用默认值',
  `max_aggr_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '聚合子配置最大个数',
  `max_aggr_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个聚合数据的子配置大小上限,单位为字节,0表示使用默认值',
  `max_history_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '最大变更历史数量',
  `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_tenant_id` (`tenant_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='租户容量信息表';


CREATE TABLE `tenant_info` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id',
  `kp` varchar(128) NOT NULL COMMENT 'kp',
  `tenant_id` varchar(128) default '' COMMENT 'tenant_id',
  `tenant_name` varchar(128) default '' COMMENT 'tenant_name',
  `tenant_desc` varchar(256) DEFAULT NULL COMMENT 'tenant_desc',
  `create_source` varchar(32) DEFAULT NULL COMMENT 'create_source',
  `gmt_create` bigint(20) NOT NULL COMMENT '创建时间',
  `gmt_modified` bigint(20) NOT NULL COMMENT '修改时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_tenant_info_kptenantid` (`kp`,`tenant_id`),
  KEY `idx_tenant_id` (`tenant_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='tenant_info';

CREATE TABLE `users` (
	`username` varchar(50) NOT NULL PRIMARY KEY,
	`password` varchar(500) NOT NULL,
	`enabled` boolean NOT NULL
);

CREATE TABLE `roles` (
	`username` varchar(50) NOT NULL,
	`role` varchar(50) NOT NULL,
	UNIQUE INDEX `idx_user_role` (`username` ASC, `role` ASC) USING BTREE
);

CREATE TABLE `permissions` (
    `role` varchar(50) NOT NULL,
    `resource` varchar(255) NOT NULL,
    `action` varchar(8) NOT NULL,
    UNIQUE INDEX `uk_role_permission` (`role`,`resource`,`action`) USING BTREE
);

INSERT INTO users (username, password, enabled) VALUES ('nacos', '$2a$10$EuWPZHzz32dJN7jexM34MOeYirDdFAZm2kuWj7VEOJhhZkDrxfvUu', TRUE);

INSERT INTO roles (username, role) VALUES ('nacos', 'ROLE_ADMIN');
6.4.1.2 配置nacos
将nacos解压到任意非中文目录下,如图:
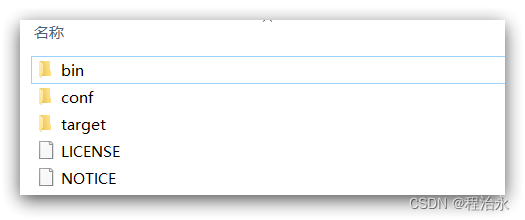
目录说明:
- bin:启动脚本
- conf:配置文件
进入nacos的conf目录,修改配置文件cluster.conf.example,重命名为cluster.conf:
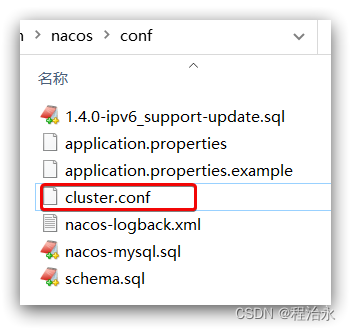
在此文件中添加内容:
127.0.0.1:8845
127.0.0.1:8846
127.0.0.1:8847
然后修改application.properties文件,添加数据库配置
### Specify local server's IP:
nacos.inetutils.ip-address=127.0.0.1
spring.datasource.platform=mysql
db.num=1
db.url.0=jdbc:mysql://127.0.0.1:3306/nacos?characterEncoding=utf8&connectTimeout=1000&socketTimeout=3000&autoReconnect=true&useUnicode=true&useSSL=false&serverTimezone=UTC
db.user.0=root
db.password.0=123
注意:数据库的账号和密码要记得修改成自己的哦~
将nacos文件夹复制三份,分别命名为:nacos1、nacos2、nacos3
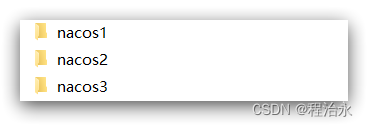
然后分别修改三个文件夹中的application.properties,
nacos1:
server.port=8845
nacos2:
server.port=8846
nacos3:
server.port=8847
然后分别启动三个nacos节点:
startup.cmd
6.6.1.2 nginx反向代理
将nginx安装到非中文目录下;
修改conf/nginx.conf文件,配置如下:
worker_processes  1;
events {
    worker_connections  1024;
}
http {
    include       mime.types;
    default_type  application/octet-stream;
    sendfile        on;
    keepalive_timeout  65;
	upstream nacos-cluster {
		server 127.0.0.1:8845;
		server 127.0.0.1:8846;
		server 127.0.0.1:8847;
	}
	server {
		listen       80;
		server_name  localhost;
		location /nacos {
			proxy_pass http://nacos-cluster;
		}
	}
}
而后在浏览器访问:http://localhost/nacos即可。
代码中application.yml文件配置如下:
spring:
  cloud:
    nacos:
      server-addr: localhost:80 # Nacos地址
访问nacos管理页面:
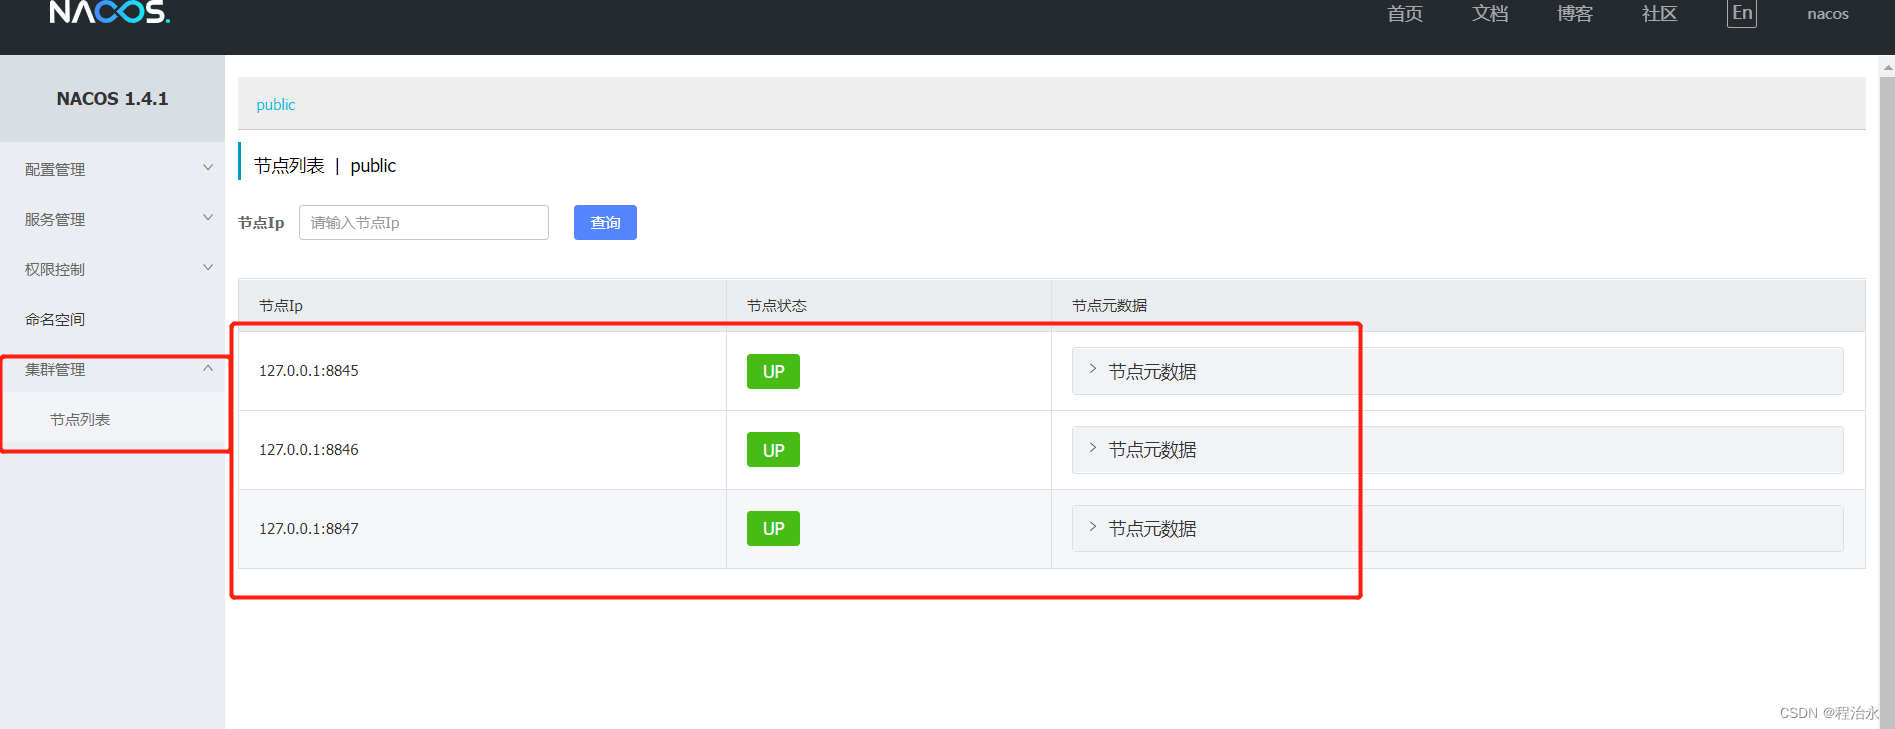
集群就搭建完成了。
7. Feign远程调用
Feign介绍
Feign 的英文表意为“假装,伪装,变形”, 是一个http请求调用的轻量级框架,是以Java接口注解的方式调用Http请求,而不用像Java中通过封装HTTP请求报文的方式直接调用。Feign通过处理注解,将请求模板化,当实际调用的时候,传入参数,根据参数再应用到请求上,进而转化成真正的请求,这种请求相对而言比较直观。
Feign被广泛应用在Spring Cloud 的解决方案中,是学习基于Spring Cloud 微服务架构不可或缺的重要组件。
Spring Cloud 常见的集成方式是使用Feign+Ribbon技术来完成服务间远程调用及负载均衡的,如下图
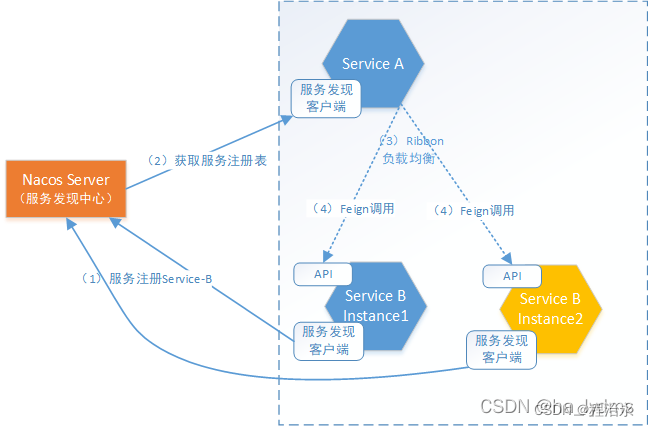
流程:
- 在微服务启动时,会向注册中心注册自身实例信息;
- 微服务会定时向服务发现中心获取服务实例列表,保存到本地;
- 当ServiceA调用ServiceB时,ribbon组件从本地服务实例列表中查找serviceB实例,如获取了多个实例如:Instance1、Instance2。这时ribbon会通过用户所配置的负载均衡策略从中选择一个实例。
- 最终,Feign组件会通过ribbon选取的实例发送http请求。
采用Feign+Ribbon的整合方式,是由Feign完成远程调用的整个流程。而Feign集成了Ribbon,Feign使用Ribbon
7.1 Feign替代RestTemplate
看一下上面用RestTemplate发起的远程调用方式:

存在下面的问题:
•代码可读性差,编程体验不统一
•参数复杂URL难以维护
Feign帮助我们优雅的实现http请求的发送,解决上面提到的问题。
引入依赖:
在order-service服务的pom文件中引入feign的依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
添加注解:
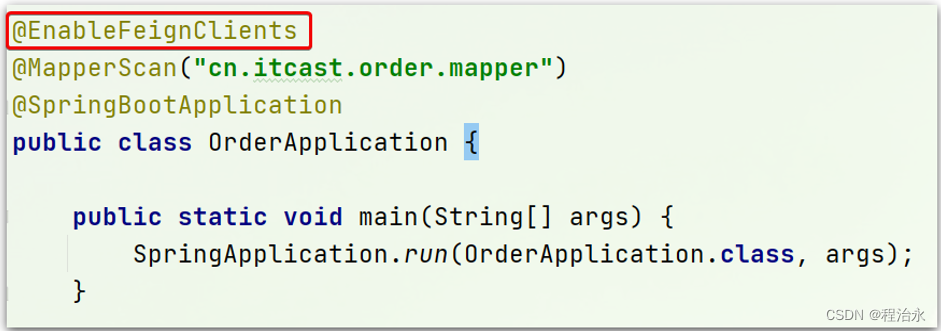
在order-service的启动类添加注解开启Feign的功能:
编写Feign客户端
在order-service中新建一个接口,内容如下:
@FeignClient("userservice")
public interface UserClient {
    @GetMapping("/user/{id}")
    User findById(@PathVariable("id") Long id);
}
这个客户端主要是基于SpringMVC的注解来声明远程调用的信息,比如:
- 服务名称:userservice(被调用的服务名)
- 请求方式:GET
- 请求路径:/user/{id}
- 请求参数:Long id
- 返回值类型:User
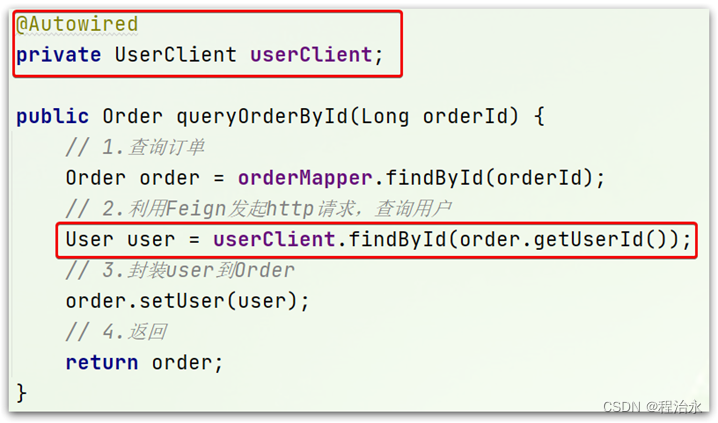
这样,Feign就可以帮助我们发送http请求,无需自己使用RestTemplate来发送了。
测试:
7.2 自定义配置
Feign可以支持很多的自定义配置,如下表所示:
| 类型 | 作用 | 说明 |
|---|---|---|
| feign.Logger.Level | 修改日志级别 | 包含四种不同的级别:NONE、BASIC、HEADERS、FULL |
| feign.codec.Decoder | 响应结果的解析器 | http远程调用的结果做解析,例如解析json字符串为java对象 |
| feign.codec.Encoder | 请求参数编码 | 将请求参数编码,便于通过http请求发送 |
| feign. Contract | 支持的注解格式 | 默认是SpringMVC的注解 |
| feign. Retryer | 失败重试机制 | 请求失败的重试机制,默认是没有,不过会使用Ribbon的重试 |
一般情况下,默认值就能满足我们使用,如果要自定义时,只需要创建自定义的@Bean覆盖默认Bean即可。
下面以日志为例来演示如何自定义配置。
配置文件方式
基于配置文件修改feign的日志级别可以针对单个服务:
feign:
  client:
    config:
      userservice: # 针对某个微服务的配置
        loggerLevel: FULL #  日志级别
也可以针对所有服务:
feign:
  client:
    config:
      default: # 这里用default就是全局配置,如果是写服务名称,则是针对某个微服务的配置
        loggerLevel: FULL #  日志级别
而日志的级别分为四种:
- NONE:不记录任何日志信息,这是默认值。
- BASIC:仅记录请求的方法,URL以及响应状态码和执行时间
- HEADERS:在BASIC的基础上,额外记录了请求和响应的头信息
- FULL:记录所有请求和响应的明细,包括头信息、请求体、元数据。
java代码方式
也可以基于Java代码来修改日志级别,先声明一个类,然后声明一个Logger.Level的对象:
public class DefaultFeignConfiguration  {
    @Bean
    public Logger.Level feignLogLevel(){
        return Logger.Level.BASIC; // 日志级别为BASIC
    }
}
如果要全局生效,将其放到启动类的@EnableFeignClients这个注解中:
@EnableFeignClients(defaultConfiguration = DefaultFeignConfiguration .class)
如果是局部生效,则把它放到对应的@FeignClient这个注解中:
@FeignClient(value = "userservice", configuration = DefaultFeignConfiguration .class)
7.4 Feign使用优化
Feign底层发起http请求,依赖于其它的框架。其底层客户端实现包括:
•URLConnection:默认实现,不支持连接池
•Apache HttpClient :支持连接池
•OKHttp:支持连接池
因此提高Feign的性能主要手段就是使用连接池代替默认的URLConnection。
这里我们用Apache的HttpClient来演示。
在order-service的pom文件中引入Apache的HttpClient依赖:
<!--httpClient的依赖 -->
<dependency>
    <groupId>io.github.openfeign</groupId>
    <artifactId>feign-httpclient</artifactId>
</dependency>
在order-service的application.yml中添加配置:
feign:
  client:
    config:
      default: # default全局的配置
        loggerLevel: BASIC # 日志级别,BASIC就是基本的请求和响应信息
  httpclient:
    enabled: true # 开启feign对HttpClient的支持
    max-connections: 200 # 最大的连接数
    max-connections-per-route: 50 # 每个路径的最大连接数
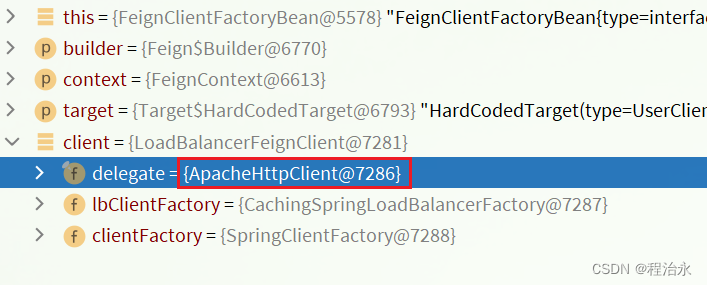
接下来,在FeignClientFactoryBean中的loadBalance方法中打断点:
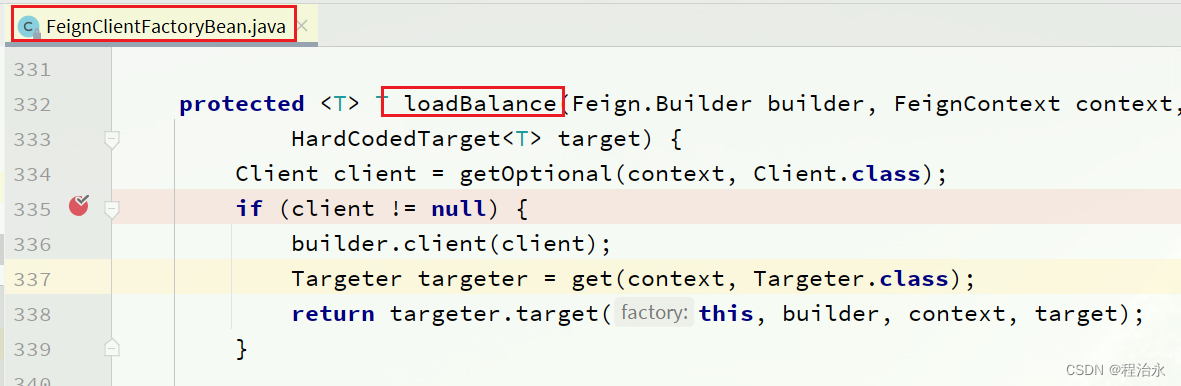
Debug方式启动order-service服务,可以看到这里的client,底层就是Apache HttpClient:
抽取Feign
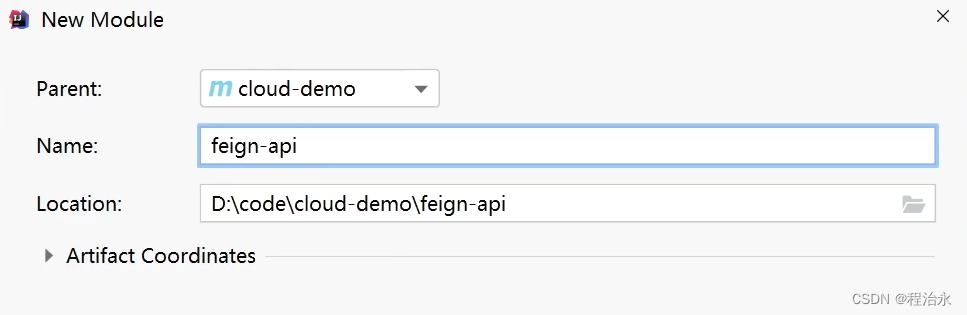
将Feign的Client抽取为独立模块,并且把接口有关的POJO、默认的Feign配置都放到这个模块中,提供给所有消费者使用。
首先创建一个module,命名为feign-api:
在feign-api中然后引入feign的starter依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
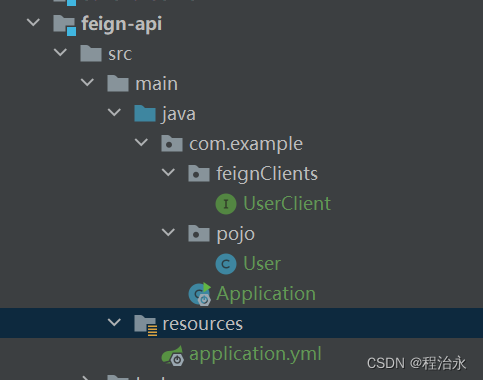
然后把在order-serivce中的UserClient、User搬到feign-api服务中:
在order-service中使用feign-api
首先,删除order-service中的UserClient、User、DefaultFeignConfiguration等类或接口。
在order-service的pom文件中中引入feign-api的依赖:
<dependency>
    <groupId>cn.itcast.demo</groupId>
    <artifactId>feign-api</artifactId>
    <version>1.0</version>
</dependency>
修改order-service中的所有与上述三个组件有关的导包部分,改成导入feign-api中的包
这样还是会有一个错误:
在feign-api中,UserClient是在com.example.feignClients包下,
而order-service的@EnableFeignClients注解是在cn.itcast.order包下,不在同一个包,无法扫描到UserClient。
解决方式:
方式一:
指定feign应该扫描的包:
@EnableFeignClients(basePackages = "cn.itcast.feign.clients")
方式二:
指定需要加载的client接口:
@EnableFeignClients(clients = {UserClient.class})
8. Gateway网关
Spring Cloud Gateway 是 Spring Cloud 的一个全新项目,该项目是基于 Spring 5.0,Spring Boot 2.0 和 Project Reactor 等响应式编程和事件流技术开发的网关,它旨在为微服务架构提供一种简单有效的统一的 API 路由管理方式。
8.1 为什么需要网关
Gateway网关是服务的守护神,所有微服务的统一入口:
网关的核心功能特性:
- 请求路由
- 权限控制
- 限流

权限控制:网关作为微服务入口,需要校验用户是是否有请求资格,如果没有则进行拦截。
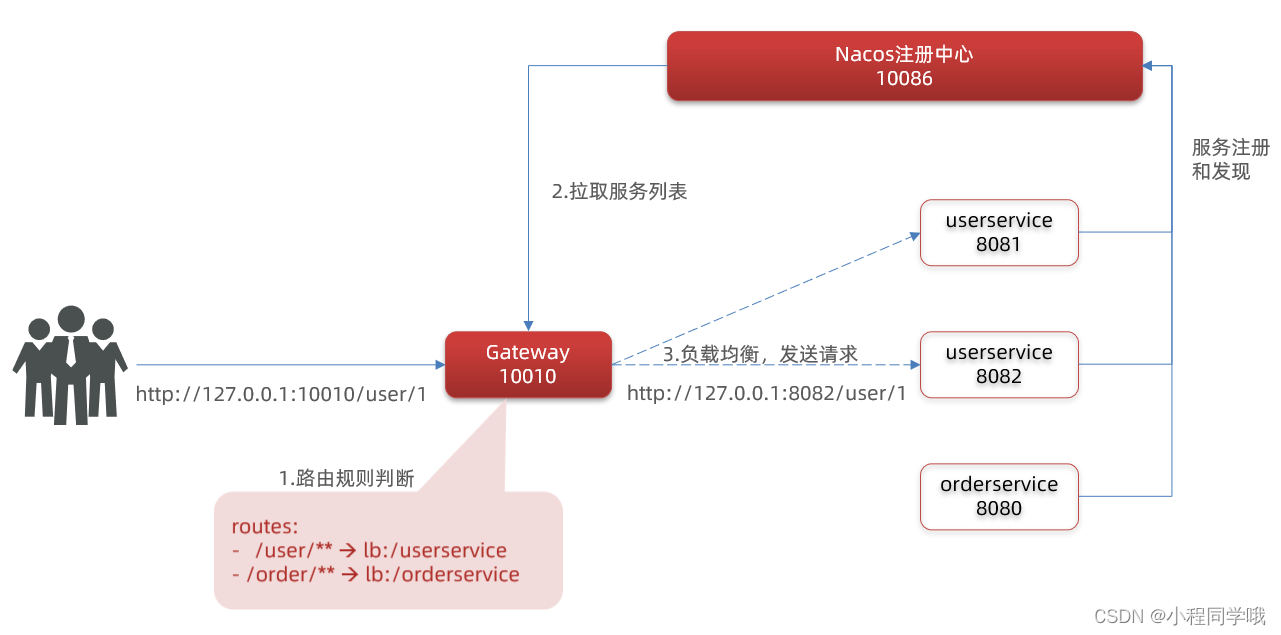
路由和负载均衡:一切请求都必须先经过gateway,但网关不处理业务,而是根据某种规则,把请求转发到某个微服务,这个过程叫做路由。当然路由的目标服务有多个时,还需要做负载均衡。
限流:当请求流量过高时,在网关中按照下流的微服务能够接受的速度来放行请求,避免服务压力过大。
在SpringCloud中网关的实现包括两种:
- gateway
- zuul
Zuul是基于Servlet的实现,属于阻塞式编程。而SpringCloudGateway则是基于Spring5中提供的WebFlux,属于响应式编程的实现,具备更好的性能。
8.2 Gateway的快速入门
基本步骤如下:
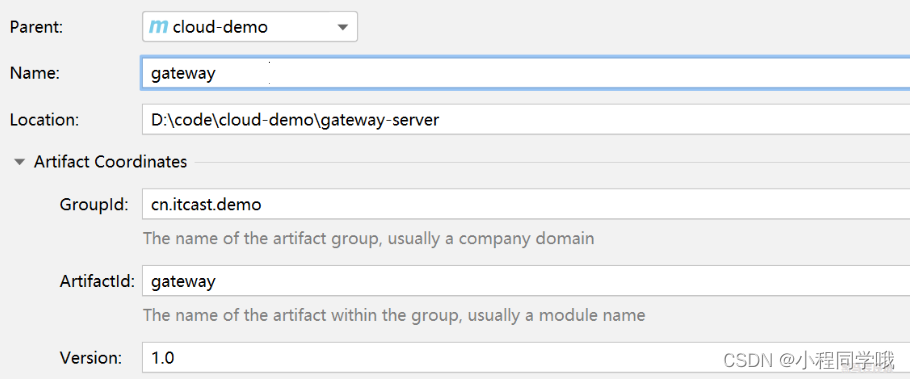
- 创建SpringBoot工程gateway,引入网关依赖
<!--网关-->
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-gateway</artifactId>
</dependency>
<!--nacos服务发现依赖-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
- 编写启动类
@SpringBootApplication
public class GatewayApplication {

	public static void main(String[] args) {
		SpringApplication.run(GatewayApplication.class, args);
	}
}
- 编写基础配置和路由规则
server:
  port: 10010 # 网关端口
spring:
  application:
    name: gateway # 服务名称
  cloud:
    nacos:
      server-addr: localhost:8848 # nacos地址
    gateway:
      routes: # 网关路由配置
        - id: user-service # 路由id,自定义,只要唯一即可
          # uri: http://127.0.0.1:8081 # 路由的目标地址 http就是固定地址
          uri: lb://userservice # 路由的目标地址 lb就是负载均衡,后面跟服务名称
          predicates: # 路由断言,也就是判断请求是否符合路由规则的条件
            - Path=/user/** # 这个是按照路径匹配,只要以/user/开头就符合要求
- 启动网关服务进行测试
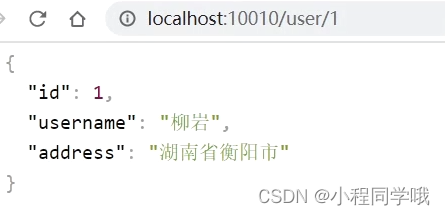
重启网关,访问http://localhost:10010/user/1时,符合/user/**规则,请求转发到uri:http://userservice/user/1,得到了结果:
5.网关路由的流程图
总结:
网关搭建步骤:
-
创建项目,引入nacos服务发现和gateway依赖
-
配置application.yml,包括服务基本信息、nacos地址、路由
路由配置包括:
-
路由id:路由的唯一标示
-
路由目标(uri):路由的目标地址,http代表固定地址,lb代表根据服务名负载均衡
-
路由断言(predicates):判断路由的规则,
-
路由过滤器(filters):对请求或响应做处理
8.3 断言工厂
在配置文件中写的断言规则只是字符串,这些字符串会被Predicate Factory读取并处理,转变为路由判断的条件
例如Path=/user/**是按照路径匹配,这个规则是由org.springframework.cloud.gateway.handler.predicate.PathRoutePredicateFactory类来处理的,像这样的断言工厂在SpringCloudGateway还有十几个:
| 名称 | 说明 | 示例 |
|---|---|---|
| After | 是某个时间点后的请求 | - After=2037-01-20T17:42:47.789-07:00[America/Denver] |
| Before | 是某个时间点之前的请求 | - Before=2031-04-13T15:14:47.433+08:00[Asia/Shanghai] |
| Between | 是某两个时间点之前的请求 | - Between=2037-01-20T17:42:47.789-07:00[America/Denver], 2037-01-21T17:42:47.789-07:00[America/Denver] |
| Cookie | 请求必须包含某些cookie | - Cookie=chocolate, ch.p |
| Header | 请求必须包含某些header | - Header=X-Request-Id, \d+ |
| Host | 请求必须是访问某个host(域名) | - Host=.somehost.org,.anotherhost.org |
| Method | 请求方式必须是指定方式 | - Method=GET,POST |
| Path | 请求路径必须符合指定规则 | - Path=/red/{segment},/blue/** |
| Query | 请求参数必须包含指定参数 | - Query=name, Jack或者- Query=name |
| RemoteAddr | 请求者的ip必须是指定范围 | - RemoteAddr=192.168.1.1/24 |
| Weight | 权重处理 |
一般只会用到path这种路由。
9 过滤工厂
GatewayFilter是网关中提供的一种过滤器,可以对进入网关的请求和微服务返回的响应做处理:
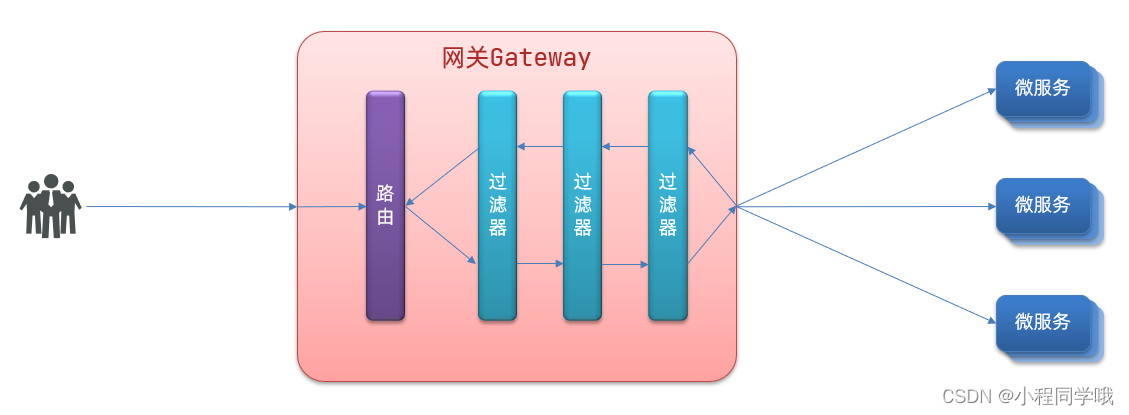
9.1 路由过滤器的种类
Spring提供了31种不同的路由过滤器工厂。例如:
| 名称 | 说明 |
|---|---|
| AddRequestHeader | 给当前请求添加一个请求头 |
| RemoveRequestHeader | 移除请求中的一个请求头 |
| AddResponseHeader | 给响应结果中添加一个响应头 |
| RemoveResponseHeader | 从响应结果中移除有一个响应头 |
| RequestRateLimiter | 限制请求的流量 |
9.2 请求头过滤器
以AddRequestHeader 为例来讲解。
需求:给所有进入userservice的请求添加一个请求头:Truth=itcast is freaking awesome!
只需要在gateway服务的application.yml文件,添加路由过滤器即可:
spring:
  cloud:
    gateway:
      routes:
      - id: user-service
        uri: lb://userservice
        predicates:
        - Path=/user/**
        filters: # 过滤器
        - AddRequestHeader=Truth, Itcast is freaking awesome! # 添加请求头
当前过滤器写在userservice路由下,因此仅仅对访问userservice的请求有效。
可以在userController方法中 注入请求头信息,进行测试
@GetMapping("/{id}")
public User queryById(@PathVariable("id") Long id,
                          @RequestHeader(value = "Truth",required = false) String name) {
        System.out.println("请求头中携带的name = " + name);
        return userService.queryById(id);
}
9.3 默认过滤器
如果要对所有的路由都生效,则可以将过滤器工厂写到default下。格式如下:
spring:
  cloud:
    gateway:
      routes:
      - id: user-service
        uri: lb://userservice
        predicates:
        - Path=/user/**
      default-filters: # 默认过滤项
      - AddRequestHeader=Truth, Itcast is freaking awesome!
9.4 全局过滤器
上面学习的过滤器,网关提供了31种,但每一种过滤器的作用都是固定的。如果我们希望拦截请求,做自己的业务逻辑则没办法实现。
9.4.1 全局过滤器的作用
全局过滤器的作用也是处理一切进入网关的请求和微服务响应,与gatewayFilter作用一样,区别在于gatewayFitle通过配置定义,处理逻辑是固定的;而GlobalFilter的逻辑需要自己写代码实现。
定义方式是实现GlobalFilter接口。
public interface GlobalFilter {
    /**
     *  处理当前请求,有必要的话通过{@link GatewayFilterChain}将请求交给下一个过滤器处理
     *
     * @param exchange 请求上下文,里面可以获取Request、Response等信息
     * @param chain 用来把请求委托给下一个过滤器
     * @return {@code Mono<Void>} 返回标示当前过滤器业务结束
     */
    Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain);
}
在filter中编写自定义逻辑,可以实现下列功能:
- 登录状态判断
- 权限校验
- 请求限流等
9.4.2 自定义全局过滤器
需求:定义全局过滤器,拦截请求,判断请求的参数是否满足下面条件:
-
参数中是否有authorization,
-
authorization参数值是否为admin
如果同时满足则放行,否则拦截
实现:
在gateway中定义一个过滤器:
@Order(-1)
@Component
public class AuthorizeFilter implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        // 1.获取请求参数
        MultiValueMap<String, String> params = exchange.getRequest().getQueryParams();
        // 2.获取authorization参数
        String auth = params.getFirst("authorization");
        // 3.校验
        if ("admin".equals(auth)) {
            // 放行
            return chain.filter(exchange);
        }
        // 4.拦截
        // 4.1.禁止访问,设置状态码
        exchange.getResponse().setStatusCode(HttpStatus.UNAUTHORIZED);
        // 4.2.结束处理
        return exchange.getResponse().setComplete();
    }
}
9.4.3 过滤器的执行顺序
请求进入网关会遇到三种过滤器:当前路由器的过滤器、DefaultFilter、GlobalFilter
请求路由后,会将当前路由过滤器和DefaultFilter、GlobalFilter,合并到一个过滤器链(集合)中,排序后依次执行每个过滤器:
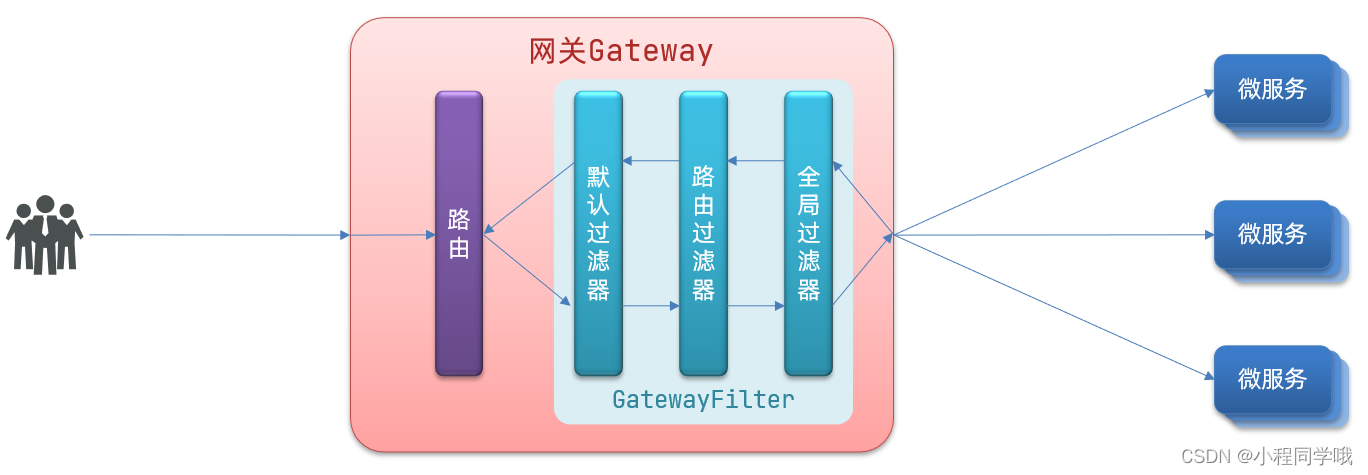
排序的规则是什么呢?
- 每一个过滤器都必须指定一个int类型的order值,order值越小,优先级越高,执行顺序越靠前。
- GlobalFilter通过实现Ordered接口,或者添加@Order注解来指定order值,由我们自己指定
- 路由过滤器和defaultFilter的order由Spring指定,默认是按照声明顺序从1递增。
- 当过滤器的order值一样时,会按照 defaultFilter > 路由过滤器 > GlobalFilter的顺序执行。
@Slf4j
@Configuration
public class FilterConfiguration {

    @Bean
    @Order(-2)
    public GlobalFilter globalFilter1(){
        return ((exchange, chain) -> {
            log.info("过滤器1的pre阶段!");
            return chain.filter(exchange).then(Mono.fromRunnable(() -> {
                log.info("过滤器1的post阶段!");
            }));
        });
    }

    @Bean
    @Order(-1)
    public GlobalFilter globalFilter2(){
        return ((exchange, chain) -> {
            log.info("过滤器2的pre阶段!");
            return chain.filter(exchange).then(Mono.fromRunnable(() -> {
                log.info("过滤器2的post阶段!");
            }));
        });
    }

    @Bean
    @Order(0)
    public GlobalFilter globalFilter3(){
        return ((exchange, chain) -> {
            log.info("过滤器3的pre阶段!");
            return chain.filter(exchange).then(Mono.fromRunnable(() -> {
                log.info("过滤器3的post阶段!");
            }));
        });
    }
}
9.5 跨域问题
9.5.1 什么是跨域问题
跨域:域名不一致就是跨域,主要包括:
-
域名不同: www.taobao.com 和 www.taobao.org 和 www.jd.com 和 miaosha.jd.com
-
域名相同,端口不同:localhost:8080和localhost:8081
跨域问题:浏览器禁止请求的发起者与服务端发生跨域ajax请求,请求被浏览器拦截的问题
9.5.2 解决跨域问题
在gateway服务的application.yml文件中,添加下面的配置:
spring:
  cloud:
    gateway:
      # 。。。
      globalcors: # 全局的跨域处理
        add-to-simple-url-handler-mapping: true # 解决options请求被拦截问题
        corsConfigurations:
          '[/**]':
            allowedOrigins: # 允许哪些网站的跨域请求
              - "http://localhost:8090"
            allowedMethods: # 允许的跨域ajax的请求方式
              - "GET"
              - "POST"
              - "DELETE"
              - "PUT"
              - "OPTIONS"
            allowedHeaders: "*" # 允许在请求中携带的头信息
            allowCredentials: true # 是否允许携带cookie
            maxAge: 360000 # 这次跨域检测的有效期
 1319


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


