


- 💂 个人主页:风间琉璃
- 🤟 版权: 本文由【风间琉璃】原创、在CSDN首发、需要转载请联系博主
- 💬 如果文章对你有帮助、欢迎关注、点赞、收藏(一键三连)和订阅专栏哦
目录
前言
YOLO(You Only Look Once)是一种基于深度神经网络的目标对象识别和定位算法,其特点是运行速度快、实时性高。这里我们将使用Tiny YOLOv2版本的YOLO算法。
YOLO算法创造性地将R-CNN目标检测中的选择候选区和识别候选区对象两个阶段合二为一,这也是YOLO名字的来由(只需看一眼就知道图片的哪些位置有什么对象)。
一、YOLOv2-tiny介绍
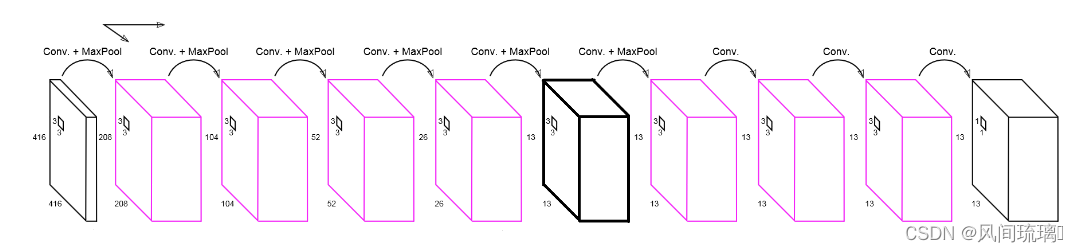
YOLOv2-tiny,轻量版的YOLOv2,即使用Tiny YOLOv2来实现目标检测。Tiny YOLOv2包含9个卷积层和6个最大池化层,如图所示。
Tiny YOLOv2目标检测算法具有预处理、网络推导和后处理三个步骤:
(1)预处理:对输入的任意分辨率的RGB图像,将各通道像素点的像素值归一化到[0, 1]区间,并按原图的长宽比例,将图像的尺寸缩放至416×416(以0.5填充);
(2)网络推导:将归一化后的416×416×3图像输入到Tiny YOLOv2网络进行前向推导,得到
13×13×5×25的输出张量;
(3)后处理:根据输出张量的格式,得到每个边框的中心点坐标以及长和宽,并根据各边框的覆盖度和置信度等信息,对所有13×13×5个边框进行NMS处理,得到最可能包含目标对象的候选框。最后根据1)中的缩放比率,将得到的候选边框放大并在原图中显示,即可得到目标对象的位置和类别信息。
yolov2-tiny网络模型每个Cell需要检测5个BOX,对每个BOX来说,包含如下数据:
4个位置信息x、y、w、h
1个置信分数
基于VOC数据集的20个目标类别
所以对每个BOX来说,每个BOX有5+20=25个参数,5个BOX共有 5x25=125个参数。所以,tiny-YOLO网络模型最后一层卷积层深度是125。
yolov2参考:目标检测之YOLOv1-v3_风间琉璃•的博客-CSDN博客
资源下载:
yolov2-tiny-voc.weights:https://pjreddie.com/media/files/yolov2-tiny-voc.weights
yolov2-tiny-voc.cfg:https://github.com/pjreddie/darknet/blob/master/cfg/yolov2-voc.cfg
voc.names:https://github.com/pjreddie/darknet/blob/master/data/voc.names
更多版本下载:YOLO: Real-Time Object Detection
二、预处理
数据集采用的voc数据集,需要将voc.names包含训练模型的所有类名称加载到内存中。
String classespath = "F:/data/CQU/VS/yolov2-tiny/voc.names";

//得到网络对应的标签
vector<string> getclasses(string classespath)
{
	ifstream ifs(classespath);
	//分类名
	vector<string> classes;
	if (ifs.is_open())
	{
		string line;
		while (getline(ifs, line))
		{
			classes.push_back(line);
		}
	}
	return classes;
}
神经网络的输入图像需要采用称为blob的特定格式。从输入图像或视频流中读取帧后,将通过blobFromImage函数将其转换为神经网络的输入blob。
在此过程中,它使用比例因子1/255将图像像素值缩放到0到1的目标范围。它还将图像的大小调整为给定大小(416,416)而不进行裁剪。
//图像预处理
Mat blob = blobFromImage(frame, 1 / 255.0, Size(416, 416), Scalar(), true, false);
三、模型加载与推理
加载网络直接使用readNetFromDarknet。
String config = "F:/data/CQU/VS/yolov2-tiny/yolov2-tiny-voc.cfg";
String weights = "F:/data/CQU/VS/yolov2-tiny/yolov2-tiny-voc.weights";

	//加载网络模型
	Net net = readNetFromDarknet(config, weights);
	if (net.empty())
	{
		printf("Could not load net...\n");
		return;
	}


#if 1
	//cpu推理
	net.setPreferableBackend(DNN_BACKEND_OPENCV);
	net.setPreferableTarget(DNN_TARGET_CPU);

#elif 0
	//使用cuda加速
	net.setPreferableBackend(cv::dnn::DNN_BACKEND_CUDA);
	net.setPreferableTarget(cv::dnn::DNN_TARGET_CUDA_FP16);

#endif
这里可以根据个人情况是否使用CUDA加速。
预处理和网络模型都加载完成后可以进行图像的预测。
//设置输入
net.setInput(blob,"data");

//推理预测
Mat detectionMat = net.forward("detection_out");
预测的结果保存在detectionMat的Mat类型矩阵中。接下来就需要对这个预测结果进行后处理。
四、解析输出
yolov2的输出包含:4个位置信息x、y、w、h,1个置信分数以及基于VOC数据集的20个目标类别。注意这里的x,y是边框中心的坐标,所以要将目标边框绘制出来,需要根据这个四个参数推算出左顶点的坐标和高,宽。
for (int i = 0; i < detectionMat.rows;i++)
{
	Mat scores = detectionMat.row(i).colRange(5, detectionMat.cols);
	Point classIdPoint;
	double confidence;

	minMaxLoc(scores, 0, &confidence, 0, &classIdPoint);
	int classid = classIdPoint.x;
	if (confidence > 0)
	{
		printf("confide:%.2f\n", confidence);
	}

	if (confidence > confidenceThreshold)
	{
		printf("confide2:%.2f\n", confidence);
	   //x,y,w,h:中心坐标,边框w,h
		float x = detectionMat.at<float>(i, 0) * image.cols;
		float y = detectionMat.at<float>(i, 1) * image.rows;
		float width = detectionMat.at<float>(i, 2) * image.cols;
		float height = detectionMat.at<float>(i, 3) * image.rows;

		//左上角坐标
		int xLeftBottom = static_cast<int>((x - width / 2));
		int yLeftBottom = static_cast<int>((y - height / 2));

		//获取矩形框x,y,w,h
		Rect object(xLeftBottom, yLeftBottom, static_cast<int>(width), static_cast<int>(height));
		//绘制矩形框
		rectangle(image, object, Scalar(0, 255, 0), 2);
		if (classid < classNames.size())
		{
			//获取类别名称及其置信度
			string conf = format("%.2f", confidence);
			String label = String(classNames[classid]) + ": " + conf;
			int baseLine = 0;
			//在图像上添加标签
			Size labelSize = getTextSize(label, FONT_HERSHEY_SIMPLEX, 0.5, 1, &baseLine);
			rectangle(image, Rect(Point(xLeftBottom, yLeftBottom), Size(labelSize.width, labelSize.height + baseLine)), Scalar(255, 255, 255), FILLED);
			putText(image, label, Point(xLeftBottom, yLeftBottom + labelSize.height), FONT_HERSHEY_SIMPLEX, 0.5, Scalar(0, 0, 0));
		}
	}
}
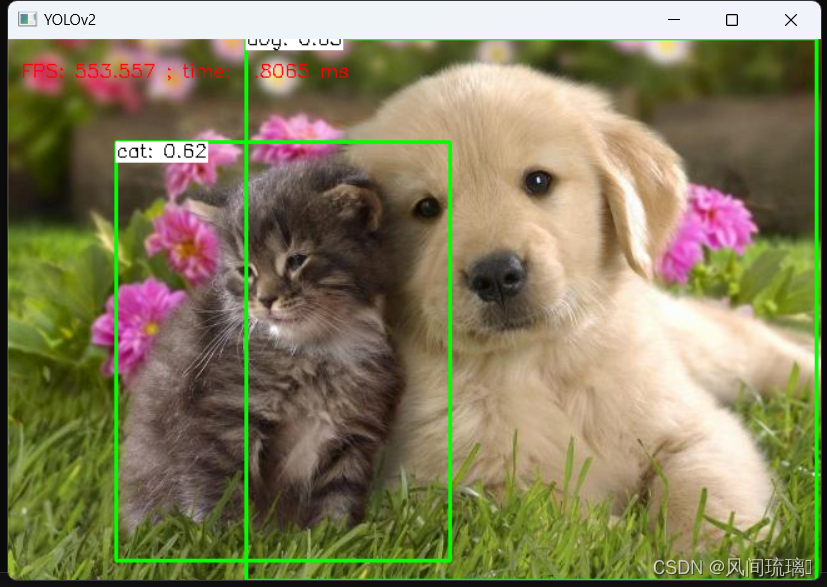
运行结果:
图片:
视频:
OpenCV yolov2-tiny
源码:资源下载:https://download.csdn.net/download/qq_53144843/88354502
// yolov2-tiny.cpp : 此文件包含 "main" 函数。程序执行将在此处开始并结束。
//

#include <iostream>
#include <fstream>
#include <algorithm>
#include <cstdlib>

#include <opencv2/opencv.hpp>
#include <opencv2/dnn.hpp>
#include <opencv2/imgproc.hpp>
#include <opencv2/highgui.hpp>


using namespace std;
using namespace cv;
using namespace cv::dnn;


//置信度阈值
float confidenceThreshold = 0.25;


//得到网络对应的标签
vector<string> getclasses(string classespath)
{
	ifstream ifs(classespath);
	//分类名
	vector<string> classes;
	if (ifs.is_open())
	{
		string line;
		while (getline(ifs, line))
		{
			classes.push_back(line);
		}
	}
	return classes;
}


void detection(string config, string weights, string classespath, string video_path)
{
	//加载网络模型
	Net net = readNetFromDarknet(config, weights);
	if (net.empty())
	{
		printf("Could not load net...\n");
		return;
	}


#if 0
	//cpu推理
	net.setPreferableBackend(DNN_BACKEND_OPENCV);
	net.setPreferableTarget(DNN_TARGET_CPU);

#elif 1
	//使用cuda加速
	net.setPreferableBackend(cv::dnn::DNN_BACKEND_CUDA);
	net.setPreferableTarget(cv::dnn::DNN_TARGET_CUDA_FP16);

#endif


	//获得分类名
	vector<string> classNames = getclasses(classespath);

	//打开视频流
	VideoCapture capture;
	capture.open(video_path); //传入0:读取摄像头
	if (!capture.isOpened())
	{
		printf("could not open the video...\n");
		return;
	}

	//读取视频流
	Mat frame;
	while (capture.read(frame))
	{
		if (frame.channels() == 4)
		{
			cvtColor(frame, frame, COLOR_BGRA2BGR);
		}

		//图像预处理
		Mat blob = blobFromImage(frame, 1 / 255.0, Size(416, 416), Scalar(), true, false);
		//设置输入
		net.setInput(blob,"data");

		//获得当前系统的计时间周期数,求FPS
		double t = (double)getTickCount();

		//推理预测
		Mat detectionMat = net.forward("detection_out");


		for (int i = 0; i < detectionMat.rows; i++)
		{
			//获取每一行从第5列起的分类类别的概率
			const int probability_index = 5;
			//概率的总列数
			const int probability_size = detectionMat.cols - probability_index;
			//用于查找最大概率的类别
			float* prob_array_ptr = &detectionMat.at<float>(i, probability_index);
			//查找概率数组中的最大值,并返回最大值的索引
			size_t objectClass = max_element(prob_array_ptr, prob_array_ptr + probability_size) - prob_array_ptr;
			//获取置信度值
			float confidence = detectionMat.at<float>(i, (int)objectClass + probability_index);

			if (confidence > confidenceThreshold)
			{
				printf("confide:%.2f\n", confidence);
				float x = detectionMat.at<float>(i, 0);
				float y = detectionMat.at<float>(i, 1);
				float width = detectionMat.at<float>(i, 2);
				float height = detectionMat.at<float>(i, 3);
				int xLeftBottom = static_cast<int>((x - width / 2) * frame.cols);
				int yLeftBottom = static_cast<int>((y - height / 2) * frame.rows);
				int xRightTop = static_cast<int>((x + width / 2) * frame.cols);
				int yRightTop = static_cast<int>((y + height / 2) * frame.rows);
				Rect object(xLeftBottom, yLeftBottom,xRightTop - xLeftBottom,yRightTop - yLeftBottom);
				rectangle(frame, object, Scalar(0, 255, 0),2);
				if (objectClass < classNames.size())
				{
					//获取类别名称及其置信度
					string conf = format("%.2f", confidence);
					String label = String(classNames[objectClass]) + ": " + conf;
					int baseLine = 0;
					Size labelSize = getTextSize(label, FONT_HERSHEY_SIMPLEX, 0.5, 1, &baseLine);
					rectangle(frame, Rect(Point(xLeftBottom, yLeftBottom),Size(labelSize.width, labelSize.height + baseLine)),Scalar(255, 255, 255), FILLED);
					putText(frame, label, Point(xLeftBottom, yLeftBottom + labelSize.height), FONT_HERSHEY_SIMPLEX, 0.5, Scalar(0, 0, 0));
				}
			}
		}
		//FPS计算
		t = ((double)getTickCount() - t) / getTickFrequency();//求输入帧后经过的周期数/每秒系统计的周期数=一帧用时多少秒
		double fps = 1.0 / t;//求倒数得到每秒经过多少帧,即帧率
		string text = format("FPS:%.2f", fps);
		cv::putText(frame, text, Point(10, 50), FONT_HERSHEY_SIMPLEX, 1, cv::Scalar(0, 255, 0), 2, 8, 0);//FPS计算

		imshow("YOLOv2", frame);
		int c = cv::waitKey(1);
		if (c == 27)
		{
			break;
		}
	}
}


void image_detection(string config, string weights, string classespath, string image_path)
{
	//读取图片
	Mat image = imread(image_path);
	if (image.channels() == 4)
	{
		cvtColor(image, image, COLOR_BGRA2BGR);
	}
	//预处理
	Mat blob = blobFromImage(image, 1 / 255.0, Size(416, 416), Scalar());
	//加载网络
	Net net = readNetFromDarknet(config, weights);
	if (net.empty())
	{
		printf("Could not load net...\n");
		return;
	}

#if 0
	//cpu推理
	net.setPreferableBackend(DNN_BACKEND_OPENCV);
	net.setPreferableTarget(DNN_TARGET_CPU);

#elif 1
	//使用cuda加速
	net.setPreferableBackend(cv::dnn::DNN_BACKEND_CUDA);
	net.setPreferableTarget(cv::dnn::DNN_TARGET_CUDA_FP16);

#endif

	//获得分类名
	vector<string> classNames = getclasses(classespath);

	net.setInput(blob, "data");
	Mat detectionMat = net.forward("detection_out");

	//推理时间
	vector<double> layersTimings;
	double freq = getTickFrequency() / 1000;
	double time = net.getPerfProfile(layersTimings) / freq;
	ostringstream ss;
	ss << "FPS: " << 1000 / time << " ; time: " << time << " ms";
	putText(image, ss.str(), Point(10, 30), 0, 0.5, Scalar(0, 0, 255));


	for (int i = 0; i < detectionMat.rows;i++)
	{
		Mat scores = detectionMat.row(i).colRange(5, detectionMat.cols);
		Point classIdPoint;
		double confidence;

		minMaxLoc(scores, 0, &confidence, 0, &classIdPoint);
		int classid = classIdPoint.x;
		if (confidence > 0)
		{
			printf("confide:%.2f\n", confidence);
		}

		if (confidence > confidenceThreshold)
		{
			printf("confide2:%.2f\n", confidence);
		   //x,y,w,h:中心坐标,边框w,h
			float x = detectionMat.at<float>(i, 0) * image.cols;
			float y = detectionMat.at<float>(i, 1) * image.rows;
			float width = detectionMat.at<float>(i, 2) * image.cols;
			float height = detectionMat.at<float>(i, 3) * image.rows;

			//左上角坐标
			int xLeftBottom = static_cast<int>((x - width / 2));
			int yLeftBottom = static_cast<int>((y - height / 2));

			//获取矩形框x,y,w,h
			Rect object(xLeftBottom, yLeftBottom, static_cast<int>(width), static_cast<int>(height));
			//绘制矩形框
			rectangle(image, object, Scalar(0, 255, 0), 2);
			if (classid < classNames.size())
			{
				//获取类别名称及其置信度
				string conf = format("%.2f", confidence);
				String label = String(classNames[classid]) + ": " + conf;
				int baseLine = 0;
				//在图像上添加标签
				Size labelSize = getTextSize(label, FONT_HERSHEY_SIMPLEX, 0.5, 1, &baseLine);
				rectangle(image, Rect(Point(xLeftBottom, yLeftBottom), Size(labelSize.width, labelSize.height + baseLine)), Scalar(255, 255, 255), FILLED);
				putText(image, label, Point(xLeftBottom, yLeftBottom + labelSize.height), FONT_HERSHEY_SIMPLEX, 0.5, Scalar(0, 0, 0));
			}
		}
	}

	imshow("YOLOv2", image);
	cv::waitKey(0);
}

int main()
{
	String config = "F:/data/CQU/VS/yolov2-tiny/yolov2-tiny-voc.cfg";
	String weights = "F:/data/CQU/VS/yolov2-tiny/yolov2-tiny-voc.weights";
	String classespath = "F:/data/CQU/VS/yolov2-tiny/voc.names";
	String video_path = "F:/data/CQU/VS/yolov2-tiny/1.mp4";
	String image_path = "F:/data/CQU/VS/yolov2-tiny/dog_cat.jpg";
	//image_detection(config, weights, classespath, image_path);
	detection(config, weights, classespath, video_path);


}
结束语
感谢你观看我的文章呐~本次航班到这里就结束啦 🛬
希望本篇文章有对你带来帮助 🎉,有学习到一点知识~
躲起来的星星🍥也在努力发光,你也要努力加油(让我们一起努力叭)。
最后,博主要一下你们的三连呀(点赞、评论、收藏),不要钱的还是可以搞一搞的嘛~
不知道评论啥的,即使扣个666也是对博主的鼓舞吖 💞 感谢 💐


 5398


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


