


💥💥💞💞欢迎来到本博客❤️❤️💥💥
🏆博主优势:🌞🌞🌞博客内容尽量做到思维缜密,逻辑清晰,为了方便读者。
🎁完整资源、论文复现、期刊合作、论文辅导及科研仿真定制事宜点击:
👉👉👉本文完整资源下载
⛳️座右铭:行百里者,半于九十。
⛳️赠与读者
👨💻做科研,涉及到一个深在的思想系统,需要科研者逻辑缜密,踏实认真,但是不能只是努力,很多时候借力比努力更重要,然后还要有仰望星空的创新点和启发点。建议读者按目录次序逐一浏览,免得骤然跌入幽暗的迷宫找不到来时的路,它不足为你揭示全部问题的答案,但若能解答你胸中升起的一朵朵疑云,也未尝不会酿成晚霞斑斓的别一番景致,万一它给你带来了一场精神世界的苦雨,那就借机洗刷一下原来存放在那儿的“躺平”上的尘埃吧。
或许,雨过云收,神驰的天地更清朗.......🔎🔎🔎
💥第一部分——内容介绍
离散时间非线性系统策略迭代自适应动态规划算法研究
摘要
离散时间非线性系统的最优控制是现代控制理论与工程应用领域的核心难题,传统动态规划方法受限于“维数灾难”与模型精准依赖问题,难以适配复杂非线性、未知扰动下的实时最优控制场景。自适应动态规划(ADP)融合强化学习与自适应控制思想,为非线性系统最优控制提供了无模型、自迭代的求解框架。本文以离散时间非线性系统为研究对象,系统性开展策略迭代自适应动态规划算法研究,梳理策略迭代ADP的核心架构、迭代逻辑与运行机制,对比值迭代ADP的技术差异,剖析算法在非线性系统控制中的适配优势、现存技术瓶颈与优化方向。研究表明,策略迭代ADP通过策略评估与策略改进的双层迭代闭环,可在无需精准系统数学模型的前提下,逐步逼近最优控制策略与性能指标,有效克服传统动态规划的计算缺陷,对非线性离散系统的自适应最优控制工程落地具有重要理论支撑价值。
关键词:离散时间非线性系统;自适应动态规划;策略迭代;最优控制;自学习优化
1 引言
1.1 研究背景与意义
随着工业智能化、装备自动化技术的快速发展,各类工程控制系统呈现出强非线性、时变不确定性、多耦合约束的典型特征,离散时间非线性系统已广泛应用于机器人控制、电力能源调度、智能制造、航空航天等诸多领域。最优控制作为提升系统控制精度、运行稳定性与经济性的核心技术,其核心目标是在有限控制约束下,求解能够最小化系统性能代价的最优控制策略,实现系统动态性能的全局最优。
传统最优控制方法高度依赖系统精准数学模型,且主要依托经典动态规划算法求解最优控制律。但在实际非线性系统中,系统机理复杂、参数摄动、外部扰动频发,难以构建精准的数学模型,同时经典动态规划存在严重的“维数灾难”问题,随着系统状态维度提升,计算量呈指数级增长,无法满足高维非线性离散系统的实时控制需求,极大限制了传统最优控制方法的工程适用性。
自适应动态规划理论的提出,突破了传统动态规划的技术局限,其核心思路是通过迭代学习的方式近似求解哈密顿-雅可比-贝尔曼最优方程,摒弃了对精准系统模型的强依赖,同时通过函数近似结构规避维数灾难问题。在ADP的两大核心迭代机制中,策略迭代相较于值迭代具备收敛速度稳定、策略更新平滑、工程可实现性强的优势,更适配离散时间非线性系统的动态控制场景,能够通过持续的在线迭代学习,自适应修正控制策略,适配系统非线性特性与工况变化,因此开展离散时间非线性系统策略迭代ADP算法研究,对完善非线性系统自适应最优控制理论、推动智能控制技术工程落地具有重要的理论与应用价值。
1.2 国内外研究现状
自适应动态规划由Werbos首次提出,为非线性系统最优控制的近似求解提供了全新框架。后续国外学者围绕ADP迭代机制、架构设计、稳定性分析等开展了大量基础性研究,明确了策略迭代与值迭代两大核心迭代模式的运行逻辑,证明了迭代ADP算法在离散系统最优控制中的收敛性与稳定性,同时构建了基于近似网络的ADP实现架构,解决了最优方程无解析解的求解难题。其中,Lewis团队针对离散时间非线性系统的特性,优化了无初始稳定策略的策略迭代ADP框架,大幅降低了算法的初始条件约束,提升了算法的通用性。
国内研究聚焦于算法优化、场景适配与性能提升,众多学者围绕策略迭代ADP的稳定性证明、收敛速度优化、约束适配、抗扰动能力提升等方向开展研究,逐步解决了传统策略迭代ADP在非线性系统中迭代震荡、局部最优、鲁棒性不足等问题。同时,相关研究逐步将策略迭代ADP算法落地于电力系统能量管理、工业设备自适应控制、智能机器人轨迹跟踪等场景,验证了算法的工程实用性。但现有研究仍存在不足,针对强非线性、不确定扰动的离散系统,策略迭代ADP的自适应学习能力、迭代效率、约束适配性仍有待进一步优化,算法的理论完备性与工程通用性仍需持续完善。
1.3 论文主要研究内容与结构
本文主要围绕离散时间非线性系统,开展策略迭代自适应动态规划算法的系统性研究,核心内容包括:梳理自适应动态规划的核心理论框架,辨析策略迭代与值迭代ADP的核心差异;剖析离散时间非线性系统下策略迭代ADP的迭代机制、运行原理与核心流程;分析算法在非线性系统控制中的适配优势、关键技术难点;总结算法优化方向与未来研究趋势。全文结构安排如下:第二部分阐述ADP基础理论与离散非线性系统控制需求;第三部分详细剖析策略迭代ADP算法的核心架构与迭代逻辑;第四部分对比分析策略迭代与值迭代ADP的性能差异;第五部分总结当前算法的研究难点与优化路径;第六部分对全文进行总结与展望。
2 自适应动态规划基础理论与系统特性分析
2.1 自适应动态规划核心思想
自适应动态规划是一种融合动态规划、强化学习、自适应控制的智能最优控制方法,核心目标是解决复杂非线性系统最优控制的求解难题。其核心思想摒弃了传统动态规划离线全局求解的模式,采用在线迭代学习、近似逼近的方式,逐步拟合系统最优性能指标函数与最优控制策略。ADP无需依赖完整精准的系统机理模型,可通过系统运行的状态与输入输出数据实现自适应学习,具备无模型、自优化、自适应的核心特性,完美适配离散时间非线性系统模型不确定、动态特性复杂的控制场景。
ADP的核心运行逻辑围绕性能指标函数逼近与控制策略迭代更新展开,通过近似拟合结构替代传统的精准方程求解,有效规避维数灾难问题,同时通过持续的迭代闭环,不断优化控制策略,使系统性能逐步收敛至最优状态。根据迭代更新对象的差异,ADP算法主要分为值迭代与策略迭代两类,二者迭代逻辑、收敛特性与工程适配性存在显著差异。
2.2 离散时间非线性系统控制特性与需求
离散时间非线性系统区别于线性系统与连续非线性系统,具备状态离散更新、动态特性非线性、工况时序变化的典型特征,系统状态仅在离散时刻发生跃迁,且状态变化与控制输入之间存在复杂的非线性耦合关系,同时实际运行中普遍存在参数摄动、外部随机扰动、输入输出约束等问题。
针对该类系统的最优控制,传统控制方法难以兼顾动态适应性与最优性,具体表现为:线性最优控制方法无法适配系统非线性特性,控制精度较差;传统动态规划计算复杂度极高,无法实现在线实时控制;模型依赖型最优控制方法难以应对系统参数不确定与扰动问题。因此,离散时间非线性系统的最优控制需要满足无模型依赖、在线自适应迭代、收敛稳定、实时性强的核心需求,而策略迭代ADP算法的迭代架构与学习特性能够精准匹配上述控制需求。
3 离散时间非线性系统策略迭代ADP算法原理与架构
3.1 策略迭代ADP整体架构
针对离散时间非线性系统的策略迭代自适应动态规划算法,整体采用“评估-改进”双层闭环迭代架构,核心包含策略评估与策略改进两个基础模块,通过两个模块的交替迭代,实现控制策略与性能指标的同步优化。整个算法架构无需精准系统模型支撑,依托系统离散时序运行数据完成迭代学习,完全适配离散非线性系统的动态运行特性。
策略迭代ADP的核心运行逻辑为:基于初始可行控制策略,完成当前策略下的系统性能评估,求解对应策略的性能指标;在评估结果的基础上,对控制策略进行优化更新,得到更优的控制策略;循环执行评估与改进流程,直至控制策略与性能指标收敛至最优稳态,最终得到适配离散非线性系统的最优控制策略。相较于单一迭代逻辑的智能算法,策略迭代的双层闭环架构具备迭代逻辑清晰、收敛过程平稳、优化方向性明确的优势。
3.2 策略评估阶段核心机制
策略评估是策略迭代ADP的基础环节,核心作用是量化当前控制策略作用下离散非线性系统的运行性能,精准拟合当前策略对应的性能指标函数。在离散时间系统时序运行逻辑下,该阶段依托系统逐时刻的状态更新、控制输入与运行代价数据,完成对当前固定策略的性能估值。
由于离散非线性系统不存在最优方程的解析解,策略评估阶段通过近似拟合的方式,逼近当前策略的真实性能指标,无需复杂的精准计算。该阶段保持控制策略固定不变,持续采集系统离散时序数据,迭代更新性能指标的近似拟合结果,直至当前策略的性能评估结果趋于稳定,完成单次策略评估流程。策略评估的精准度直接决定后续策略改进的优化效果,是保障算法整体收敛性与控制精度的核心基础。同时,该阶段无需依赖系统非线性机理参数,仅通过运行数据完成评估,具备良好的模型无关性。
3.3 策略改进阶段核心机制
策略改进是实现最优控制的核心迭代环节,核心目标是基于稳定的策略评估结果,对现有控制策略进行全局优化,生成性能更优的更新策略。针对离散时间非线性系统的时序离散特性,策略改进以最小化系统运行代价为优化目标,依托前序阶段拟合的性能指标,完成控制策略的迭代更新。
在非线性特性的适配层面,策略改进环节能够根据系统不同离散时刻的状态特征,自适应调整控制策略,有效适配系统的非线性耦合与时变特性,避免线性控制策略适配非线性系统导致的性能偏差。同时,策略改进遵循贪心优化原则,每一次迭代更新的策略性能均优于上一轮策略,保证了整体迭代过程的单调优化特性,有效规避迭代震荡、性能退化等问题,为算法的稳定收敛提供核心保障。
3.4 整体迭代收敛逻辑
策略迭代ADP算法的迭代收敛是评估与改进交替循环、逐步优化的过程。算法启动后,无需初始最优策略,仅需一组可行的初始控制策略即可启动迭代流程,大幅降低了算法的应用门槛。首轮迭代完成策略评估与策略改进后,生成全新的优化策略,随后以新策略为基础,开启下一轮迭代循环,持续更新性能指标与控制策略。
针对离散时间非线性系统,随着迭代次数增加,控制策略的优化空间持续缩小,系统性能代价逐步收敛至最小值,最终实现策略迭代稳态,此时控制策略即为适配系统的最优控制策略。整个迭代过程具备单调收敛、稳定无震荡的特性,且能够自适应适配系统非线性、参数摄动与小幅外部扰动,契合离散非线性系统的工程控制需求。
4 策略迭代与值迭代ADP算法对比分析
值迭代与策略迭代是自适应动态规划的两大核心迭代范式,二者均可实现离散时间非线性系统的最优控制求解,但迭代逻辑、收敛特性、工程适配性存在显著差异,本文从核心迭代机制、收敛性能、初始条件、工程实用性四个维度开展对比分析。
在迭代机制层面,值迭代ADP直接对最优性能指标进行迭代更新,同步完成指标优化与策略求解,迭代流程相对简洁;而策略迭代ADP采用分层迭代逻辑,先评估固定策略性能,再优化更新策略,迭代分层性更强,优化目标更精准。在收敛性能层面,策略迭代具备单调收敛特性,迭代过程平稳,最终收敛精度更高,适配高精度非线性控制场景;值迭代收敛速度波动较大,易出现局部最优问题,收敛稳定性弱于策略迭代。
在初始条件层面,值迭代对初始参数敏感度较高,初始值设置不当易导致迭代不收敛;策略迭代无需初始稳定最优策略,仅需可行初始策略即可启动迭代,初始约束更低,通用性更强。在工程实用性层面,策略迭代的策略更新平滑、性能稳步提升,不会出现控制量突变问题,契合工业离散系统的稳定运行需求;值迭代单次迭代幅度较大,易导致控制输出震荡,工程落地稳定性较差。综上,针对离散时间非线性系统的最优控制场景,策略迭代ADP具备更显著的综合优势。
5 现存研究难点与优化发展趋势
5.1 现存核心技术难点
尽管策略迭代ADP在离散时间非线性系统控制中具备显著优势,但在复杂工程场景下仍存在诸多技术难点。首先,强非线性与强扰动场景下的自适应学习能力不足,现有策略迭代算法在系统非线性耦合极强、外部扰动随机多变的场景中,迭代收敛速度大幅下降,甚至出现精度退化问题,自适应适配能力有限。其次,迭代实时性与控制精度难以兼顾,高精度性能拟合需要更多迭代步数与数据支撑,导致算法计算耗时增加,难以适配高速动态响应的离散系统控制场景。
同时,约束适配能力不足,实际离散非线性系统普遍存在控制输入约束、状态约束、安全约束等多维度约束条件,传统策略迭代ADP未充分考虑约束边界特性,易出现控制策略超约束、优化不可行的问题。此外,算法鲁棒性有待提升,针对系统参数时变、未建模动态等不确定性因素,迭代学习的抗干扰能力较弱,难以保证复杂工况下的稳定最优控制性能。
5.2 算法优化与研究趋势
针对上述技术难点,当前离散时间非线性系统策略迭代ADP算法的优化研究主要聚焦四大方向。一是融合智能近似结构优化拟合精度,通过优化近似学习网络的架构,提升非线性系统性能指标与控制策略的拟合精准度,同时降低迭代计算量,兼顾控制精度与实时性。二是引入约束优化机制,构建带约束的策略迭代ADP框架,精准适配系统多维度约束条件,解决约束场景下的优化不可行问题,提升算法的工程适配性。
三是抗扰动与鲁棒性优化,结合自适应补偿、扰动观测等技术,优化迭代学习逻辑,提升算法对系统不确定性、外部扰动的抑制能力,保障复杂工况下的迭代收敛稳定性与控制最优性。四是事件触发与迭代机制融合,摒弃固定时序迭代模式,采用事件触发自适应迭代机制,仅在系统状态发生有效变化时启动迭代优化,大幅降低算法计算开销,提升实时控制能力,适配高速、高实时性要求的离散非线性控制系统。
6 结论与展望
本文以离散时间非线性系统为研究对象,系统性开展策略迭代自适应动态规划算法研究,梳理了ADP的核心理论体系,剖析了策略迭代算法的双层迭代架构、策略评估与策略改进的核心运行机制,阐明了算法无模型、自适应、单调收敛的核心优势,精准适配离散时间非线性系统的最优控制需求。通过与值迭代ADP的对比分析,明确了策略迭代算法在收敛稳定性、初始条件兼容性、工程实用性上的显著优势。同时,总结了当前算法在强非线性、多约束、强扰动场景下的技术难点,梳理了算法的优化方向与未来研究趋势。
研究证实,策略迭代自适应动态规划算法能够有效克服传统动态规划的维数灾难与模型依赖问题,通过分层迭代学习实现离散非线性系统的自适应最优控制,是非线性智能控制领域的核心有效方法。未来可围绕约束适配优化、鲁棒性提升、实时性优化、多场景适配等方向深入研究,进一步完善策略迭代ADP的理论体系,推动算法在高端工业控制、智能装备、能源系统等复杂非线性离散控制系统中的规模化工程应用。
📚第二部分——运行结果
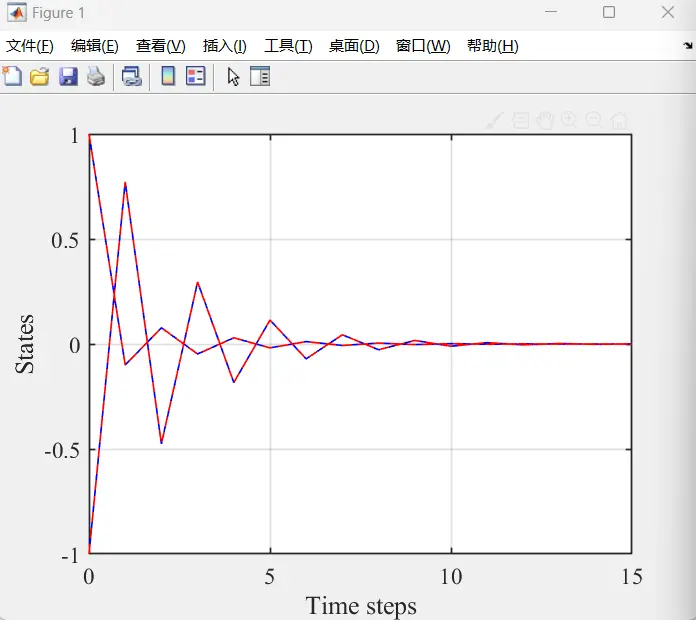

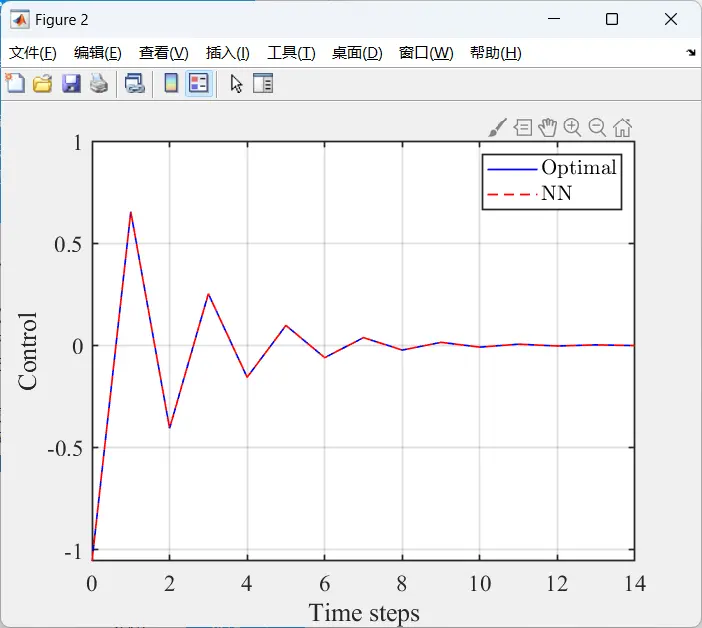
🎉第三部分——参考文献
文章中一些内容引自网络,会注明出处或引用为参考文献,难免有未尽之处,如有不妥,请随时联系删除。(文章内容仅供参考,具体效果以运行结果为准)
🌈第四部分——本文完整资源下载
资料获取,更多粉丝福利,MATLAB|Simulink|Python|数据|文档等完整资源获取


 扫一扫


 438

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


