


TL;DR: 给 Claude Code 一条 15 秒参考视频,让它调用 Hypit 和 MiniMax H3 API,把整条片子改成吉卜力风格。全程三步:确认模型和费用、分析并生成、人工审片。
1. 先分清:换风格还是换素材
先确认你要哪一种。两者流程完全一样,区别只在提示词里写什么目标。
| 换风格 | 换素材 | |
|---|---|---|
| 做法 | 保留原视频的镜头、动作和对话,只替换画面风格 | 只借鉴原视频的镜头结构和节奏,用自己的画面重新制作 |
| 举例 | 真人实拍 → 吉卜力动画风 | 别人的爆款结构 → 你的产品和出镜 |
| 适合场景 | 自己拍的素材做二次创作 | 公开发布、商业用途 |
本文演示换风格,技术要求更高,更能看出 Hypit 的能力边界。后面的步骤对两者都适用。
2. Hypit 是什么
Hypit 是一个让 AI Agent 制作视频的开源项目。分工是这样的:你提要求、确认画面、审片,Agent 调用工具、生成素材、维护工程文件。
配置完成后,Claude Code 能做这些事:
- 拆解参考视频的镜头结构和时长
- 生成或整理图片、视频素材
- 安排镜头顺序和切镜节奏
- 添加字幕和画中画
- 合成并渲染最终视频
- 保存可以继续修改的工程文件
项目地址:https://github.com/hypit-ai/hypit
和「一键成片」工具最大的不同在工程文件:一键成片是一次性的,不满意只能重来;Hypit 留下可编辑的工程,只改有问题的那一个镜头,不用重跑整条视频。
3. 开始前要准备什么
| 要准备的东西 | 要求 | 说明 |
|---|---|---|
| Claude Code | 已能正常使用 | Agent 本体 |
| 一条参考视频 | 10~30 秒,结构清楚 | 挑选标准见第 5 节 |
| 一个视频生成模型 | MiniMax H3 API 或其他 | 本文用 MiniMax H3,费用按量计费 |
| 一个项目目录 | 空目录即可 | 用来放素材、工程文件和成片 |
安装 Skill 和配置视频模型是两件事,分开做。先装 Skill,再单独解决模型和额度——混在一起,出问题难以定位。
4. 安装 Hypit
在终端执行官方安装命令:
npx skills add hypit-ai/hypit -g
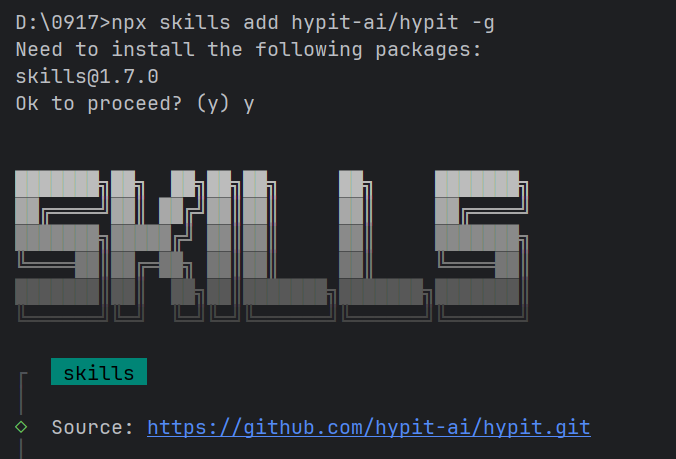
安装细节见 Hypit Quickstart。
装完重新打开 Claude Code,让 Skill 生效。注意这一步只装工具,不提供任何模型额度——视频模型要单独解决,也就是下一步。
5. 挑一条适合改造的参考视频
不要把手上最复杂的视频直接交给 Agent。标准只有一条:内容简单到能用一句话说清楚——一个人讲一个观点、产品前后对比、用一个方法解决一个具体问题,都符合。具体一点:
- 时长 10~30 秒,镜头数不超过 8 个
- 画面主要由人物、产品或简单场景组成,不依赖复杂特效
原片的字幕做得再好,也不会跟着复刻过来。详见第 9 节。
本文用的参考视频
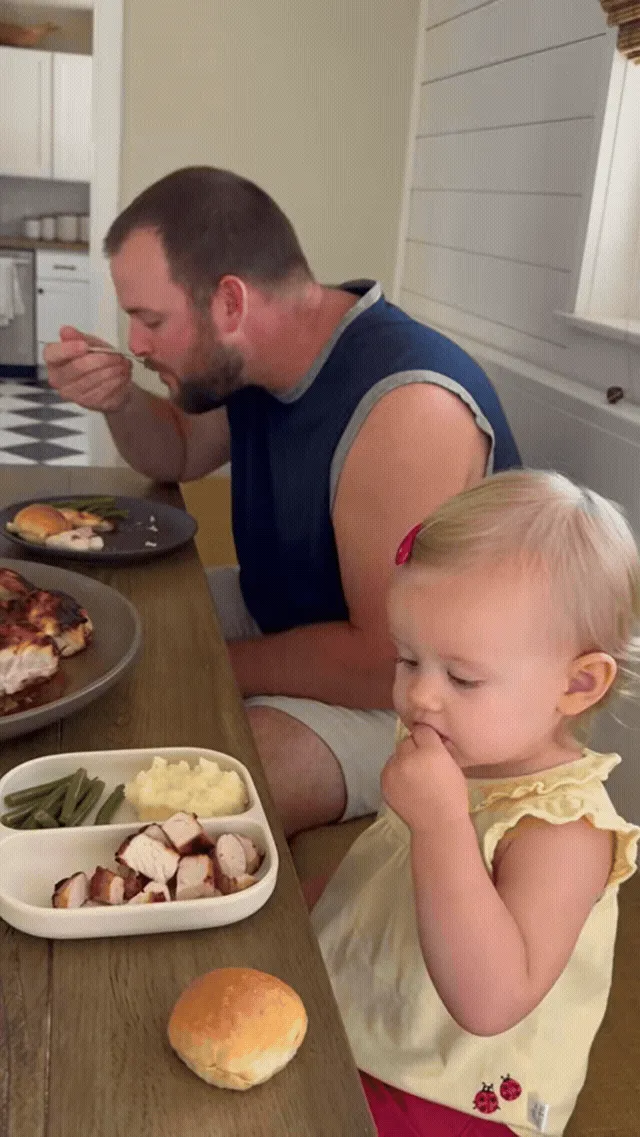
一条 15 秒的家庭用餐视频,固定机位、一个连续镜头:小女孩边吃饭边问画外的妈妈这些食物是不是她做的,最后抬头对着镜头笑。
全片没有切镜,不需要强行拆成多个镜头。这一点直接决定了后面提示词该怎么写。
6. 第一步:确认视频模型和费用
Hypit 可以用自带的视频生成能力,也可以接入其他模型,但不能同时默认使用。先确认这次实际要调用哪一个。
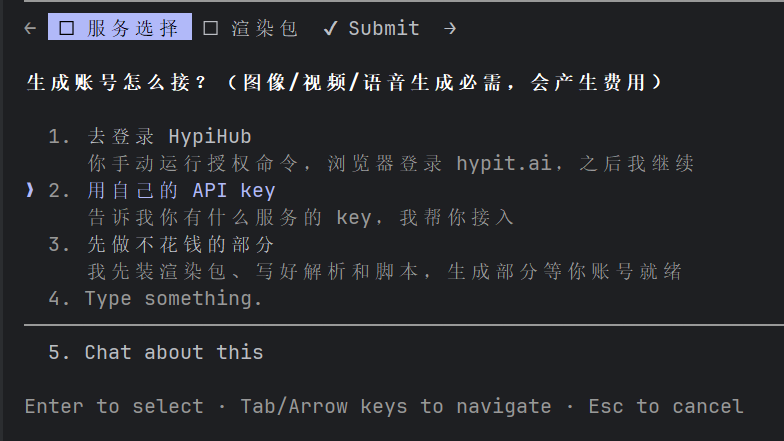
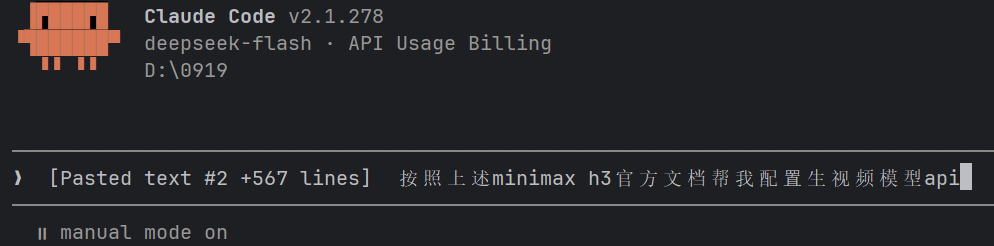
本文用 MiniMax H3 API。可以这样要求 Claude Code:
请检查 MiniMax H3 API 的配置和调用权限,并估算这条 15 秒视频改成吉卜力风格的费用。

先不要生成。如果接口不可用,也先停下来告诉我。
如果改用 Hypit 自带能力,先确认当前账号有没有可用套餐,再进入生成步骤。
验证点:模型可用、费用范围已知,才能往下走。出错就停下来排查配置,不要反复重试——重试也在消耗额度。
7. 第二步:让 Claude Code 分析并生成视频
模型确认可用之后,把 15 秒参考视频放进项目目录,让 Agent 先分析再生成。
请分析当前文件夹下的 MP4 文件,把视频整体改成吉卜力风格。
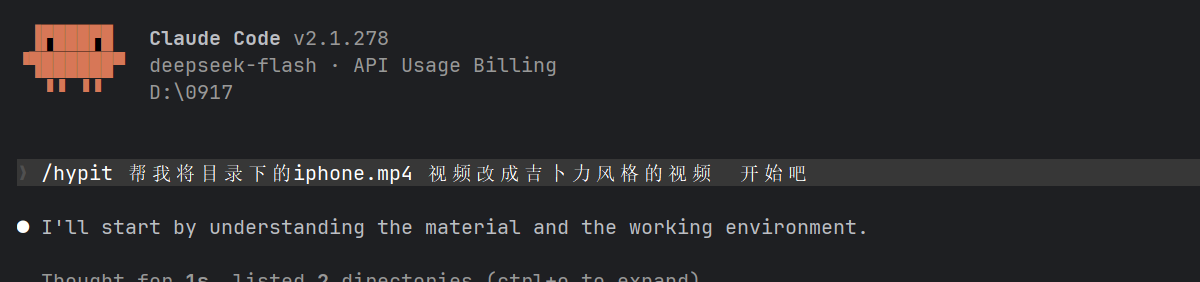
验证点:验收标准不是「已经生成了视频」,而是 Agent 有没有说清这条片子会被怎么处理——哪些内容保留、哪些改造、要不要拆镜、输出文件放在哪。
如果它只丢给你一个文件、什么都没说,先让它补上说明,再打开成片。
生成完成后先看片,再决定是否重做。只有某个画面或片段有问题时,只改那一部分,不要重跑整个项目。
8. 第三步:审片,检查五个维度
Agent 说「已完成」,不等于成片能用。至少从五个维度各过一遍:
| # | 维度 | 检查什么 |
|---|---|---|
| 1 | 内容 | 原视频的对话和故事是否仍然清楚,字幕有没有丢 |
| 2 | 画面 | 风格是否统一,人物和物体有没有明显变形 |
| 3 | 节奏 | 时长、动作和镜头变化是否接近参考视频 |
| 4 | 技术 | 画面是否闪烁、卡顿、缺帧,声音是否正常 |
| 5 | 合规 | 参考素材、人物、音乐和生成内容是否可以公开使用 |
不要只看 Agent 的文字报告,一定要实际打开渲染结果。同时保留原视频、提示词、成片和工程文件,方便对比和回滚。
原视频:
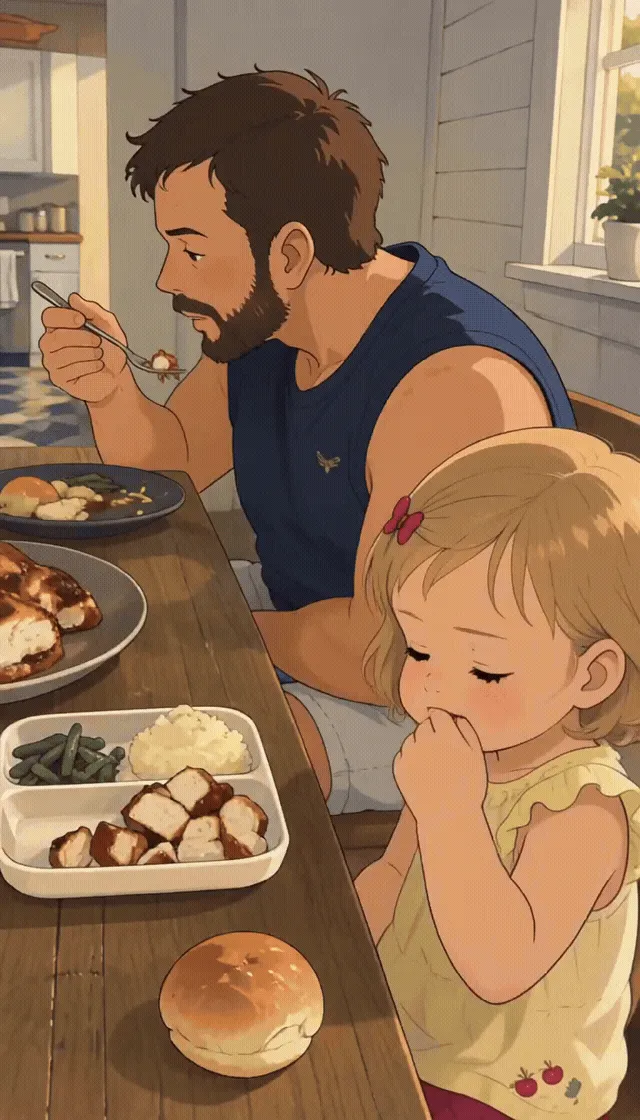
改造后的复刻视频:
9. 实测中发现的三个问题
1. 字幕全部丢失
原片有字幕,成片一条都没有。挑片时字幕还是加分项,所以这一条没有预料到。成片必须有字幕的话,要在提示词里单独提出,审片时也要单独确认。
2. 效果:简单玩玩可以,当作品发还不够
风格确实换过去了,但达不到交付水准。自己看、发给朋友够用;要拿去交付或者投出去,先按第 8 节的五个维度严格过一遍。
3. 批量之前先算单条成本
每生成一条都要消耗一次模型额度,成本随条数线性增长。先完整跑通一条,算出单条成本,再决定总量。
优缺点
Hypit 值得用的地方
- 留工程文件:只改出问题的镜头,不用重跑整条视频
- 流程完整:从分析参考视频到渲染导出,都在同一条链路里
- 开源免费,也能接入第三方 API
需要注意的地方
- 生成要花钱:Skill 免费,但额度得自己准备
- 替代不了审片:成片必须人工过一遍第 8 节的五个维度
- 合规责任在你:工具不会判断你的素材能不能用
适合人群
已经在用 Claude Code 的开发者、手上有参考视频的内容创作者、需要保留工程文件反复迭代的团队,都适合。
不适合谁:只想偶尔生成一条、不打算修改的轻度用户——这类需求用一键成片工具更快。
10. 常见问题(FAQ)
- q: “Hypit 是什么?”
a: “Hypit 是一个让 AI Agent 制作视频的开源项目:你负责提要求、确认画面和审片,Agent 负责调用工具并维护工程文件。” - q: “Hypit 免费吗?”
a: “Hypit Skill 本身免费开源,但它不提供任何模型额度。用它生成视频需要另外接入视频模型——Hypit 自带能力可能需要订阅套餐,接入第三方 API(如 MiniMax H3)则按量计费。” - q: “复刻后的视频为什么没有字幕?”
a: “本次实测中,原片是有字幕的,复刻成片里字幕完全丢失。字幕不会跟着画面一起复刻过来,如果你的成片必须有字幕,要在提示词里单独提出,并在审片时确认。” - q: “用 Hypit 改造别人的视频,会被平台判定为搬运吗?”
a: “取决于你做的是哪一种改造。只借鉴镜头结构和节奏、用自己的画面重新制作,风险较低;保留原视频的画面、人物和对话、只替换风格,风险较高,公开发布前应确认授权并按要求标注 AI 合成内容。”


 扫一扫


 384

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


