K8s的集群调度

kubernetes scheduler 源码解析及自定义资源调度算法实践 kubernetes scheduler 浅析 什么是kubernetes scheduler? 小到运行着几十个工作负载的 kubernetes 集群,大到运行成千上万个工作负载 kubernetes 集群,每个工作负载到底应该在哪里运行,这需要一个聪明的大脑进行指挥,kubernetes scheduler 就是这个聪明的大脑。从结果看,他的工作很简单,只是为 pod.spec.nodeName 填充上一个 node 的名字而已,从过程看,他又是极其复杂的,因为到底要选哪个节点才最合理,答案往往是和 阅读详情

目录

一、k8s的list-watch机制

1、调度约束:

2、根据list-watch机制,pod的创建流程(工作机制)

二、scheduler的调度策略

1、简介

2、scheduler预选策略的算法

3、scheduler的优选策略的算法

三、k8s中的标签管理及nodeSelector和nodeName的调度方式

1、指定调度节点

2、获取标签帮助

3、需要获取node上的Name的名称

4、给对应的node设置标签分别为rmh=a rmh=b

5、查看标签

6、修改成nodeSelector调度方式

7查看详细事件

四、亲和性

1、简介:

2、查看亲和性的种类

3、node的亲和性

3.1node亲和性硬策略的设置测试

3.2键值对运算关系

3.21In:label 的值在某个列表中  pending   3.22NotIn:label 的值不在某个列表中3.23Gt:label 的值大于某个值3.24Lt:label 的值小于某个值3.25Exists:某个 label 存在3.26DoesNotExist:某个 label 不存在

4、进行硬策略设置的实验

实验前先在node01node02添加标签test=a test=b的标签

如果硬策略不满足条件,Pod 状态一直会处于 Pending 状态。

5、进行软策略设置实验

如果把硬策略和软策略合在一起使用,则要先满足硬策略之后才会满足软策略

6、pod亲和性和反亲和性

7、使用pod反亲和性调度

7.1官方示例1

7.2官方示例2


一、k8s的list-watch机制

1、调度约束:

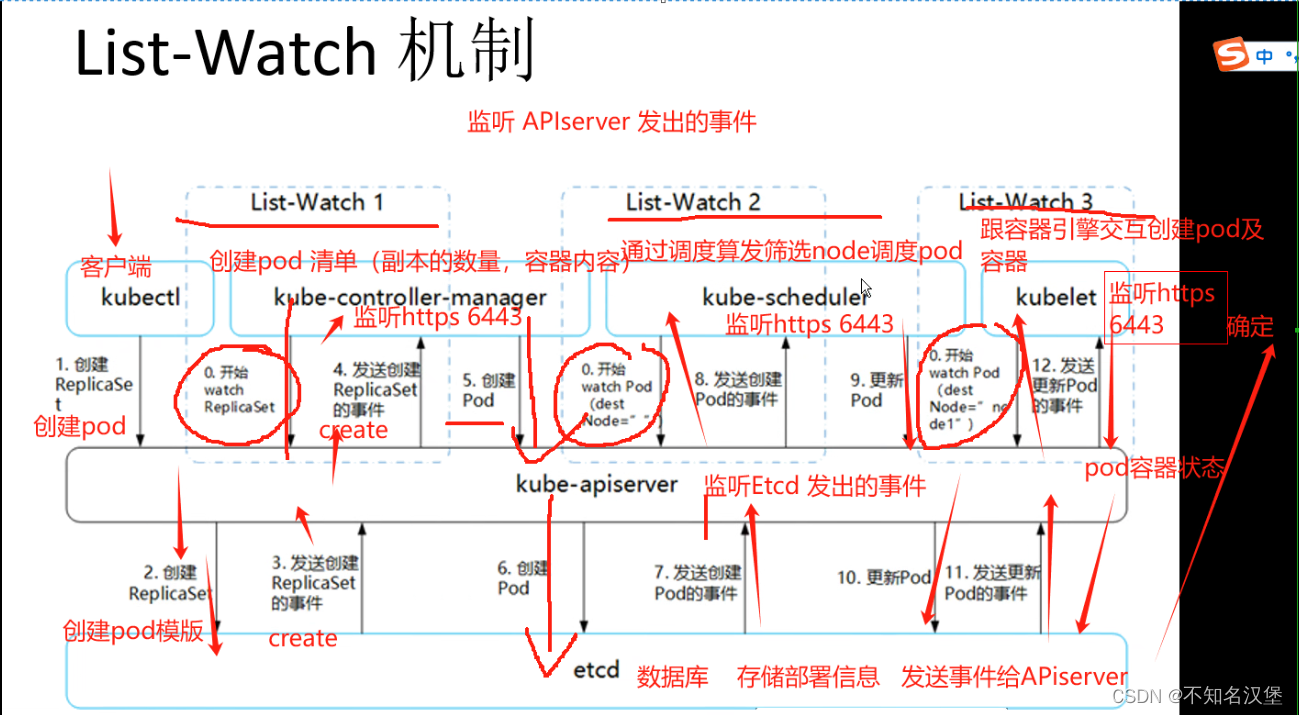
Kubernetes 是通过 List-Watch的机制进行每个组件的协作,保持数据同步的,每个组件之间的设计实现了解耦。

用户是通过 kubectl 根据配置文件,向 APIServer 发送命令,在 Node 节点上面建立 Pod 和 Container。

APIServer 经过 API 调用,权限控制,调用资源和存储资源的过程,实际上还没有真正开始部署应用。这里    需要 Controller Manager、Scheduler 和 kubelet 的协助才能完成整个部署过程。

在 Kubernetes 中,所有部署的信息都会写到 etcd 中保存。实际上 etcd 在存储部署信息的时候,会发送 Create 事件给 APIServer,而 APIServer 会通过监听(Watch)etcd 发过来的事件。其他组件也会监听(Watch)APIServer 发出来的事件。

2、根据list-watch机制,pod的创建流程(工作机制)
注意:在创建pod的工作已经完成之后为什么kubelet还要一直监听呢?

是因为如果此时kubectl发布命令,要扩充pod副本数量,那么上面的流程又会触发一遍,kubelet会根据最新的pod的部署情况调整node的资源,又或者pod副本数量没有发生变化,但是其中的镜像文件升级了,kubelet也会自动获取最新的镜像文件并且加载。

①这里有三个 List-Watch,分别是 Controller Manager(运行在 Master),Scheduler(运行在 Master),kubelet(运行在 Node)。 他们在进程已启动就会监听(Watch)APIServer 发出来的事件。

②用户通过 kubectl 或其他 API 客户端提交请求给 APIServer 来建立一个 Pod 对象副本。

③APIServer 尝试着将 Pod 对象的相关元信息存入 etcd 中,待写入操作执行完成,APIServer 即会返回确认信息至客户端。

④当 etcd 接受创建 Pod 信息以后,会发送一个 Create 事件给 APIServer。

⑤由于 Controller Manager 一直在监听(Watch,通过https的6443端口)APIServer 中的事件。此时 APIServer 接受到了 Create 事件,又会发送给 Controller Manager。

⑥Controller Manager 在接到 Create 事件以后,调用其中的 Replication Controller 来保证 Node 上面需要创建的副本数量。一旦副本数量少于 RC 中定义的数量,RC 会自动创建副本。总之它是保证副本数量的 Controller(PS:扩容缩容的担当)。

⑦在 Controller Manager 创建 Pod 副本以后,APIServer 会在 etcd 中记录这个 Pod 的详细信息。例如 Pod 的副本数,Container 的内容是什么。

⑧同样的 etcd 会将创建 Pod 的信息通过事件发送给 APIServer。

⑨由于 Scheduler 在监听(Watch)APIServer,并且它在系统中起到了“承上启下”的作用,“承上”是指它负责接收创建的 Pod 事件,为其安排 Node;“启下”是指安置工作完成后,Node 上的 kubelet 进程会接管后继工作,负责 Pod 生命周期中的“下半生”。 换句话说,Scheduler 的作用是将待调度的 Pod 按照调度算法和策略绑定到集群中 Node 上。

⑩Scheduler 调度完毕以后会更新 Pod 的信息,此时的信息更加丰富了。除了知道 Pod 的副本数量,副本内容。还知道部署到哪个 Node 上面了。并将上面的 Pod 信息更新至 API Server,由 APIServer 更新至 etcd 中,保存起来。

11.etcd 将更新成功的事件发送给 APIServer,APIServer 也开始反映此 Pod 对象的调度结果。

12.kubelet 是在 Node 上面运行的进程,它也通过 List-Watch 的方式监听(Watch,通过https的6443端口)APIServer 发送的 Pod 更新的事件。kubelet 会尝试在当前节点上调用 Docker 启动容器,并将 Pod 以及容器的结果状态回送至 APIServer。

13.APIServer 将 Pod 状态信息存入 etcd 中。在 etcd 确认写入操作成功完成后,APIServer将确认信息发送至相关的 kubelet,事件将通过它被接受。

二、scheduler的调度策略

1、简介

Scheduler 是 kubernetes 的调度器,主要的任务是把定义的 pod 分配到集群的节点上。其主要考虑的问题如下:

①公平:如何保证每个节点都能被分配资源

②资源高效利用:集群所有资源最大化被使用

③效率:调度的性能要好,能够尽快地对大批量的 pod 完成调度工作

④灵活:允许用户根据自己的需求控制调度的逻辑

Sheduler 是作为单独的程序运行的,启动之后会一直监听 APIServer,获取 spec.nodeName 为空的 pod,对每个 pod 都会创建一个 binding,表明该 pod 应该放到哪个节点上。

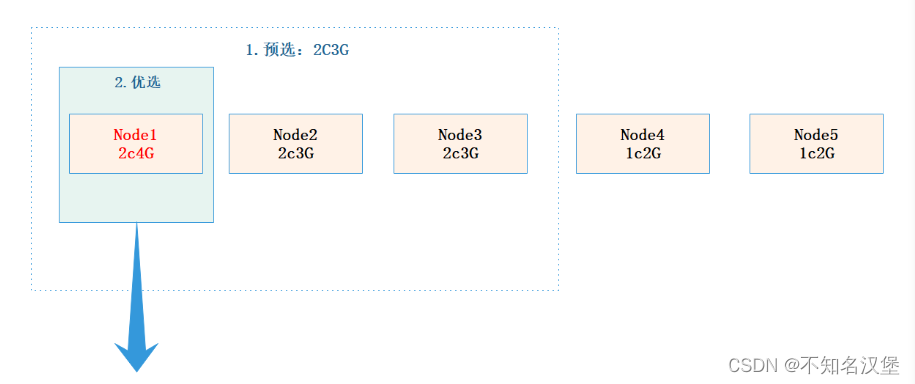
调度分为几个部分:首先是过滤掉不满足条件的节点,这个过程称为预算策略(predicate);然后对通过的节点按照优先级排序,这个是优选策略(priorities);最后从中选择优先级最高的节点。如果中间任何一步骤有错误,就直接返回错误。
2、scheduler预选策略的算法

①PodFitsResources:节点上剩余的资源是否大于 pod 请求的资源nodeName,检查节点名称是否和 NodeName 匹配。

②PodFitsHost:如果 pod 指定了 NodeName,检查节点名称是否和 NodeName 匹配。

③PodFitsHostPorts:节点上已经使用的 port 是否和 pod 申请的 port 冲突。

④PodSelectorMatches:过滤掉和 pod 指定的 label 不匹配的节点。 

⑤NoDiskConflict:已经 mount 的 volume 和 pod 指定的 volume 不冲突,除非它们都是只读。

如果在 predicate 过程中没有合适的节点,pod 会一直在 pending 状态,不断重试调度,直到有节点满足条件。 经过这个步骤,如果有多个节点满足条件,就继续 priorities 过程:按照优先级大小对节点排序。

3、scheduler的优选策略的算法

①LeastRequestedPriority:通过计算CPU和Memory的使用率来决定权重,使用率越低权重越高。也就是说,这个优先级指标倾向于资源使用比例更低的节点。

②BalancedResourceAllocation:节点上 CPU 和 Memory 使用率越接近,权重越高。这个一般和上面的一起使用,不单独使用。比如 node01 的 CPU 和 Memory 使用率 20:60,node02 的 CPU 和 Memory 使用率 50:50,虽然 node01 的总使用率比 node02 低,但 node02 的 CPU 和 Memory 使用率更接近,从而调度时会优选 node02。

③ImageLocalityPriority:倾向于已经有要使用镜像的节点,镜像总大小值越大,权重越高。

三、k8s中的标签管理及nodeSelector和nodeName的调度方式

1、指定调度节点

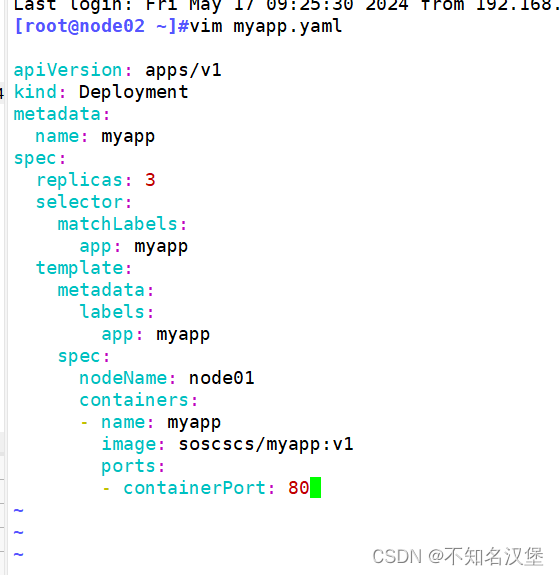
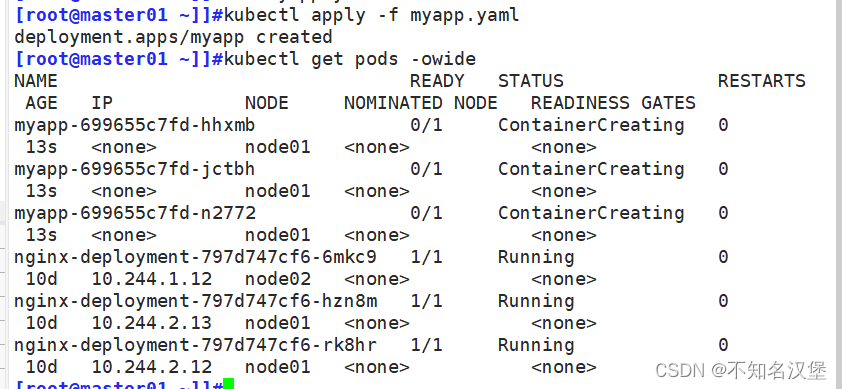
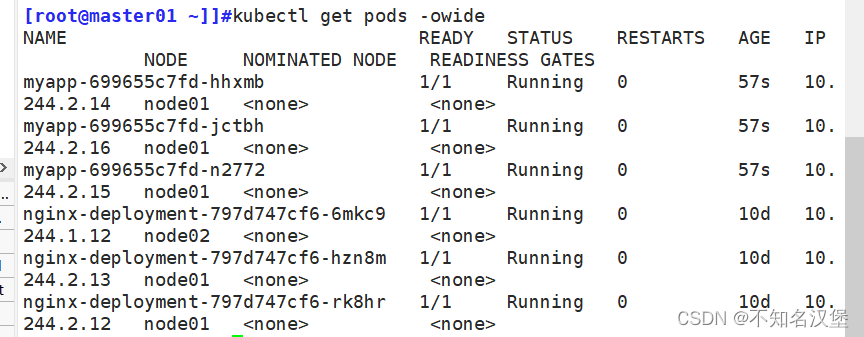
pod.spec.nodeName 将 Pod 直接调度到指定的 Node 节点上,会跳过 Scheduler 的调度策略,该匹配规则是强制匹配

 
vim myapp.yaml
apiVersion: apps/v1  
kind: Deployment  
metadata:
  name: myapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      nodeName: node01
      containers:
      - name: myapp
        image: soscscs/myapp:v1
        ports:
        - containerPort: 80
		
kubectl apply -f myapp.yaml
 
kubectl get pods -o wide
NAME                     READY   STATUS    RESTARTS   AGE   IP            NODE     NOMINATED NODE   READINESS GATES
myapp-6bc58d7775-6wlpp   1/1     Running   0          14s   10.244.1.25   node01   <none>           <none>
myapp-6bc58d7775-szcvp   1/1     Running   0          14s   10.244.1.26   node01   <none>           <none>
myapp-6bc58d7775-vnxlp   1/1     Running   0          14s   10.244.1.24   node01   <none>           <none>
 
//查看详细事件(发现未经过 scheduler 调度分配)
kubectl describe pod myapp-6bc58d7775-6wlpp
......
 Type    Reason   Age   From             Message
  ----    ------   ----  ----             -------
  Normal  Pulled   95s   kubelet, node01  Container image "soscscs/myapp:v1" already present on machine
  Normal  Created  99s   kubelet, node01  Created container nginx
  Normal  Started  99s   kubelet, node01  Started container nginx
pod.spec.nodeSelector:通过 kubernetes 的 label-selector 机制选择节点,由调度器调度策略匹配 label,然后调度 Pod 到目标节点,该匹配规则属于强制约束

2、获取标签帮助

kubectl label --help
Usage

k8s集群调度 1、实现pod的探针:就绪探针 tocScoket2、挂载,容器 /usr/share/nginx/html/ 节点 /opt/html3.node的亲和性 尽量部署在node014、pod的亲和性 ,尽量部署包含有app=nginx的pod且标签名是xy102的节点。5、软策略选择标签名不包含xy102, xy103值小于100。 阅读详情

相关推荐

K8S集群调度

List-watch(监听)---会在每一步把监听的消息(先监听apiserver:6443)----每个组件(controller manager,scheduler,kubelet,etcd)都会监听apiserver:6443端口,都会获取消息。创建pod搭配节点时,由两个策略,先执行预选策略,再执行优选策略,这两步的操作都必须成功,否则立刻返回报错,也就是说,部署的node,必须满足这两个策略。选择pod时,申明了node01,我是硬策略,必须满足硬策略的条件,必须部署在node01,强制性要求。

2301_79410672的博客 1983

k8s 进阶实战笔记 | Scheduler 调度策略总结

Scheduler一直监听着 api-server,如果获取到Pod.Spec.NodeName为空,会对每一个pod创建一个binding,表示放在哪一个节点上运行把 pod 按照预设的调度策略分配到集群的节点上公平资源高效利用效率灵活调度过程预选(predicate过滤步满足条件的节点PodFitsResources :节点上剩余的资源是否大于pod 请求的资源PodFitsHost :如果pod 指定了NodeName,检查节点名称是否和NodeName匹配。

小鲸鱼大梦想 2802

[云原生] k8s集群调度

注意:在创建 Pod 的工作就已经完成了后,为什么 kubelet 还要一直监听呢?原因很简单,假设这个时候 kubectl 发命令,要扩充 Pod 副本数量,那么上面的流程又会触发一遍,kubelet 会根据最新的 Pod 的部署情况调整 Node 的资源。又或者 Pod 副本数量没有发生变化,但是其中的镜像文件升级了,kubelet 也会自动获取最新的镜像文件并且加载。

热心网友 1549

Kubernetes调度算法(Scheduler)

概述 调度SchedulerKubernetes的重要组件之一。其作用是要将待调度的Pod依据某调度策略调度到最适合它运行的节点上运行。这里就涉及到三个对象:待调度的Pod、调度策略、待部署的节点队列。  我们先来看下Scheduler及其相关联组件的框架图。然后再聊下Scheduler调度策略。Scheduler及相关联组件框架图:                          ...

捕影世界 4044

k8s基础(13)之scheduler调度

k8s基础(13)之scheduler调度器 kube-schedulerkubernetes系统的核心组件质疑,主要负责整个集群资源的调度功能,根据特定的调度算法和策略,将Pod调度到最优的一个工作节点上面去,从而更加的合理、更加充分的利用集群的资源。 调度器流程 schedulerKubernetes调度器,它的主要作用就是根据特定的调度算法和调度策略将Pod调度到合适的Node节点上去,是一个独立的二进制程序,当我们通过API 或者kubectl工具发送创建Pod的指令后,apiserver会

qq_23435961的博客 1040

k8s--集群调度(kube-scheduler

以上过程是list-watch会在每一步把监听的消息(APIserver:6443)-------controller manager,scheduler,kubelet,etcd都会监听apiserver:6443。指定节点标签部署pod,是要经过scheduler的算法,如果节点不满足条件,pod会进入penging状态,直到节点条件满足为止。通过预算选择出可以部署的节点,再通过优先选择出来最好的节点,以上都是自带的算法。最低请求优先级,通过算法计算节点上的cpu和内存使用率,确定节点的权重。

qq_51506982的博客 1857

Kubernetesk8s集群资源调度

上天完全是为了坚强我们的意志,才在我们的道路上设下重重的障碍

F12138X的博客 2152

Kubernetesk8s集群调度

Schedulerkubernetes调度器,主要的任务是把定义的 pod 分配到集群的节点上。用一个或多个 taint ,这表示对于那些不能容忍这些 taint 的 Pod,是不会被该节点接受的。在了一种相斥的关系,可以让 Node 拒绝 Pod 的调度执行,甚至将 Node 已经存在的 Pod 驱逐出。忍(Tolerations),意思是设置了容忍的 Pod 将可以容忍污点的存在,可以被调度到存在污点的。节点亲和性,是Pod的一种属性(偏好或硬性要求),它使Pod被吸引到一类特定的节点。

aran2002的博客 1649

K8S集群调度

Kubernetes 中,集群调度(Cluster Scheduling)是指根据资源需求和可用性将工作负载(如 Pod)分配到集群中的节点上的过程。Kubernetes调度器负责执行这一过程,它根据用户定义的要求、节点的资源情况和其他条件来决定将工作负载分配到哪个节点上运行。接收调度请求:当用户提交新的工作负载(如 Pod)时,调度请求将发送给 Kubernetes调度器。选择合适的节点。

m0_65299341的博客 1601

K8S(九)—— Kubernetes 集群调度全面解析

1、list-watch 组件 Controller Manager Scheduler kubelet2、list-watch 工作机制3、亲和性(节点亲和pod亲和)和反亲和性 以及 硬策略和软策略4、污点和容忍5、驱逐一句话总结: “调度是吸引,污点是排斥,亲和性是偏好,容忍是例外。

sk13587280072的博客 1167

Kubernetes 集群调度K8S (五)】

比如 node01 的 CPU 和 Memory 使用率20:60,node02 的 CPU 和 Memory 使用率 50:50,虽然node01 的总使用率比 node02 低,但 node02 的 CPU 和Memory 使用率更接近,从而调度时会优选 node02。使用 kubectl taint 命令可以 给某个 Node 节点设置污点,Node 被设置上污点之后就和 Pod 之间存在了一种相斥的关系,可以让 Node 拒绝 Pod 的调度执行,甚至将 Node 已经存在的 Pod 驱逐出去。

hanyi_qwe的博客 1282

Kubernetes集群调度

注意在创建 Pod 的工作就已经完成了后,为什么 kubelet 还要一直监听呢?原因很简单,假设这个时候 kubectl 发命令,要扩充 Pod 副本数量,那么上面的流程又会触发一遍,kubelet 会根据最新的 Pod 的部署情况调整 Node 的资源。又或者 Pod 副本数量没有发生变化,但是其中的镜像文件升级了,kubelet 也会自动获取最新的镜像文件并且加载。Schedulerkubernetes调度器,主要的任务是把定义的 pod 分配到集群的节点上。

Kiryu7的博客 1600

Kubernetesk8s集群调度

用户是通过 kubectl 根据配置文件,向 APIServer 发送命令,在 Node 节点上面建立 Pod 和 Container。APIServer 经过 API 调用,权限控制,调用资源和存储资源的过程,实际上还没有真正开始部署应用,需要 Controller Manager、Scheduler 和 kubelet 的协助才能完成整个部署过程。在 Kubernetes 中,所有部署的信息都会写到 etcd 中保存。

qq_54188720的博客 1110

使用k8s集群调度GPU

参考链接:https://github.com/NVIDIA/k8s-device-plugin#enabling-gpu-support-in-kubernetes。,我对硬件资源不是很懂,大概看了看官方,简单梳理了一下思路,便开始了踩坑之路(本片文章是无坑文档,请放心使用/参考)对于实验学习而言,在k8s集群中,至少保证1台node节点是有显卡的(本文是。

运维老生常谈 1487

K8S R&D: Kubernetes集群安全、调度、扩展到监控形成完整技术体系

KubernetesK8s)是一个开源容器编排平台,通过自动化部署、扩缩容容器化应用来简化应用管理。其核心安全机制包括:身份认证(X.509证书/ServiceAccount)、RBAC授权、网络隔离(NetworkPolicy)、TLS加密通信、Secret管理敏感数据、命名空间隔离和日志审计。Pod作为最小部署单元,支持单/多容器部署,通过静态Pod管理核心服务,并采用节点亲和性/资源限制等调度策略。删除Pod遵循优雅终止流程,通过labels/selectors实现资源分类管理,namespace实

Wang的专栏 2432

k8s(四)Kubernetes 集群调度

Kubernetes(简称 K8s集群管理中,“调度”是决定 Pod 如何合理分配到节点、保障集群资源高效利用与业务稳定运行的核心机制。无论是小规模测试集群还是大规模生产集群,能否通过调度策略实现“Pod 到节点”的精准匹配,直接影响集群的资源利用率、业务可用性与运维效率。例如,如何让核心业务 Pod 优先调度到性能更强的节点?如何避免不同业务的 Pod 因资源争抢导致故障?如何在节点维护时安全迁移 Pod 而不中断服务?这些问题的答案,都隐藏在 K8s 调度体系的设计逻辑中。

qq_55656748的博客 454
上一篇: Pod进阶——资源限制以及探针检查
下一篇: K8s集群调度续章
不知名汉堡
博客等级 码龄3年 1800粉丝 108原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值