


计算机毕设Springboot基于hadoop平台游戏热度数据分析系统aocru352 (配套有源码 程序 mysql数据库 论文)本套源码可以先看具体功能演示视频领取,文末有联xi 可分享
在当今数字化时代,游戏行业蓬勃发展,玩家数量与日俱增,随之产生的游戏相关数据也呈爆炸式增长。这些数据蕴含着玩家行为、游戏趋势等宝贵信息,对于游戏开发者和市场营销人员来说,具有极高的价值。然而,传统的数据处理方式已难以应对如此海量且复杂的数据。基于此,开发一个高效、可靠的游戏热度数据分析系统显得尤为迫切。
本系统采用Java语言结合SpringBoot框架进行开发,依托Hadoop平台的强大数据处理能力,旨在对海量游戏数据进行高效存储、管理和深度分析。系统集成多种数据源,包括用户活跃度、游戏下载量、在线时长等关键指标,通过数据挖掘和机器学习算法,精准评估不同游戏的受欢迎程度,并以可视化方式呈现分析结果,助力游戏开发者和营销人员做出更明智的决策。
系统的主要功能涵盖以下几个方面:
-
数据采集与整合:通过Scrapy爬虫技术高效收集网络数据,整合多源数据,为分析提供全面基础。
-
用户管理:管理员可对用户信息进行添加、修改、删除等操作,实现用户账号的精细化管理。
-
游戏资源管理:支持对游戏资源的详细信息查询、评论、收藏等功能,方便用户获取和分享游戏资源。
-
游戏资讯管理:用户可在游戏资讯页面进行查询、点赞、收藏等操作,管理员可对资讯分类进行管理。
-
游戏论坛管理:管理员可对游戏论坛帖子进行查询、删除等操作,维护论坛秩序。
-
数据可视化展示:采用Echarts技术,将游戏热度分析结果以直观的图表形式展示在看板大屏上,便于实时监控和分析。
-
系统管理:管理员可对系统进行配置管理,如发布公告、修改系统设置等,保障系统稳定运行。
综上所述,本系统凭借其强大的数据处理与分析能力,以及丰富的功能设计,为游戏行业提供了一种高效、直观的游戏热度分析解决方案,有助于推动游戏行业的精细化运营与发展。
注:以上是纯课题毕业设计介绍,并非实际开发完成,最终开发完成的毕业设计程序以下面的的环境软件、功能图和界面为准。
系统所需要的环境软件:idea、eclipse+mysql5.7、8.0+Navicat+JDK1.8+tomcat7.0
系统用例分析
平台游戏热度数据分析系统综合网络空间开发设计要求。目的是将传统管理方式转换为在网上管理,完成平台游戏热度数据分析的方便快捷、安全性高、交易规范做了保障,目标明确。平台游戏热度数据分析系统可以将功能划分为管理员功能和用户功能。
(1)管理员关键功能包含用户、游戏资源、游戏论坛、系统管理、用户资料等进行管理。管理员用例如下:
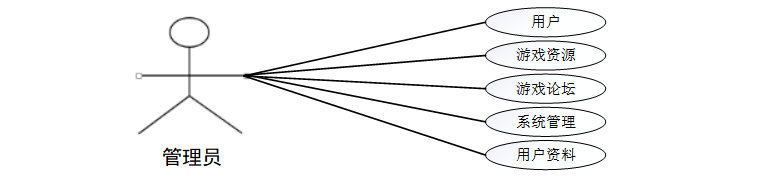
图3-1 管理员用例图
(2)用户关键功能包含个人中心、修改密码、我的发布、我的收藏等进行管理。用户用例如下:
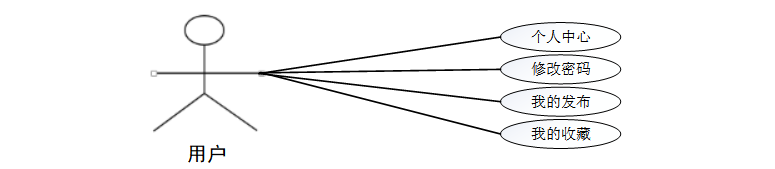
图3-2 用户用例图
3.5 系统流程分析
系统登录流程图如图所示3-3所示。
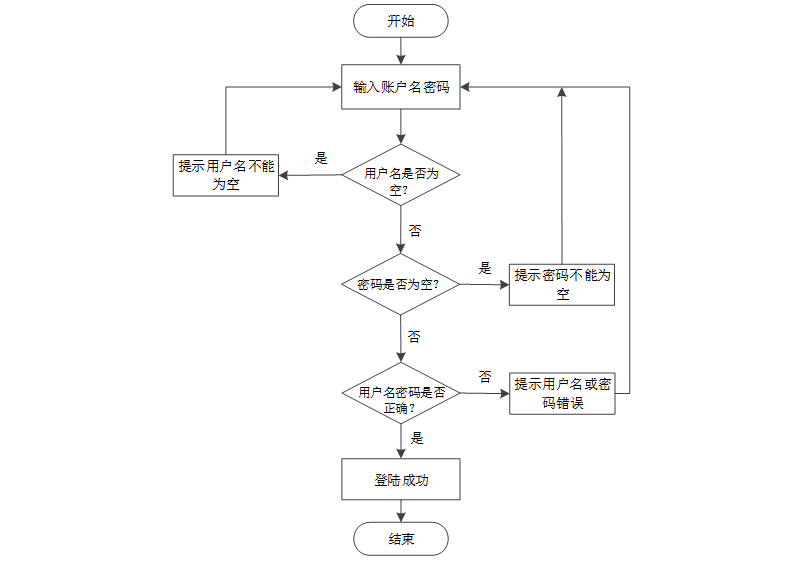
图3-3 系统登录流程图
用户和管理员可以添加信息,内容没有问题之后按下确定键就添加成功了。添加信息流程图如图3-4所示.
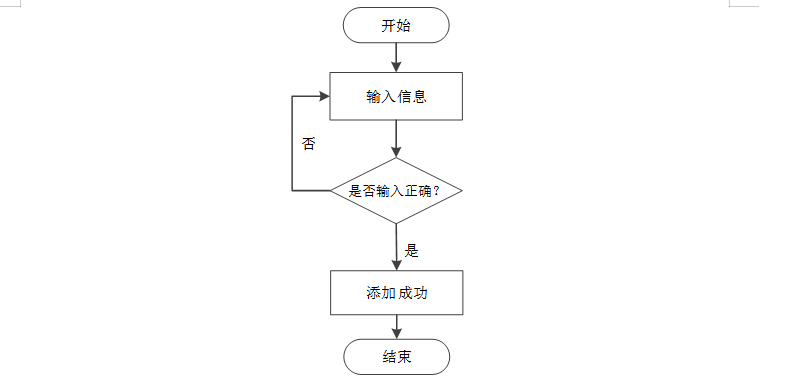
图3-4 添加信息流程图
用户可以选择把自己发布的信息删掉,选择要删除的文章确认之后,删除信息的操作就完成了。删除信息流程图如图3-5所示。
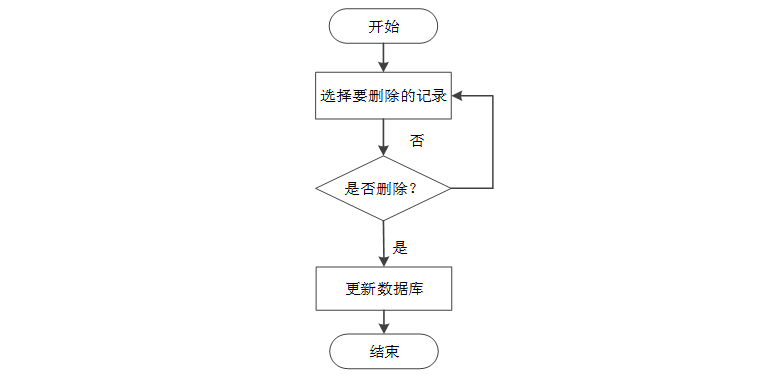
图3-5 删除信息流程图
3.6 本章小结
本章主要是对平台游戏热度数据分析系统的可行性分析和所要实现的功能进行分析,在对一系列的系统可行性分析之后,又详细的讲述了项目的目标与原则,让人们深刻的了解平台游戏热度数据分析系统的设计思想,之后重点对登录模块、添加模块和删除模块的流程进行了详细的图文介绍。
本章主要讲述的是平台游戏热度数据分析系统的设计开发结构,简单介绍了开发流程与数据库设计的原则以及数据表的关系结构图,并且详细的展示了数据表的内部结构信息与属性。
4.1 系统体系结构
管理员模块属于是网站的后台,进入之后有大量的管理员功能,管理员也可以使用其他用户模块的功能,为了维护网站的稳定与页面的布局,将管理员模块的功能详细化后可以使用系统管理对页面进行布局修改,可以发布公告提示用户规范,平台游戏热度数据分析系统总体结构如图4-1所示。

图4-1 系统总体结构图
4.2 数据库设计原则
数据库设计之后,根据数据库关系,可以更加清晰地了解到数据库结构,每一个数据表之间的关系,再创建数据表。快速更改和查询对应的信息,有了数据库就不用在程序和代码中寻找。
分析平台游戏热度数据分析系统的数据结构后,系统局部E-R实体如下图所示。
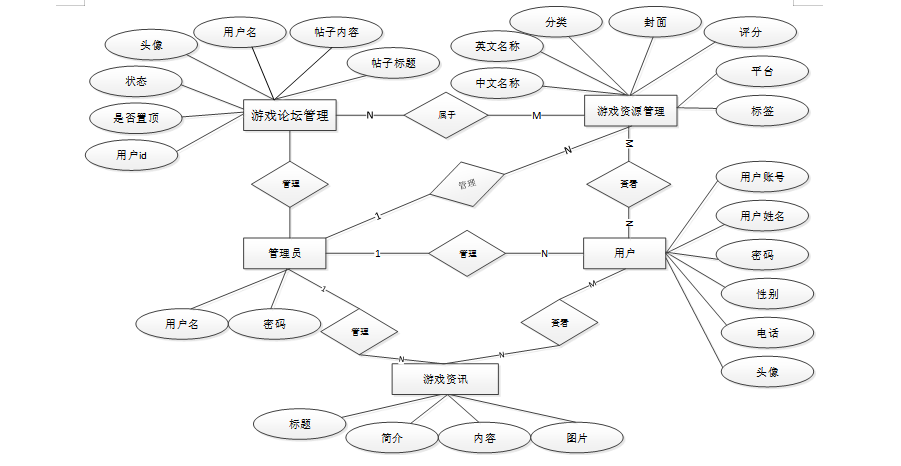
图4-2 局部E-R图
系统实现
本章讲述的是系统对各个模块功能实现的效果图,对首页、管理员功能和用户功能分别进行了展示,页面布局清晰,操作简单快捷,基本实现了对用户和管理员对系统的需求。
5.1 系统功能实现
当人们打开系统的网址后,首先看到的就是首页界面。在这里,人们能够看到系统的导航条,通过导航条导航进入各功能展示页面进行操作。系统首页界面如图5-1所示:
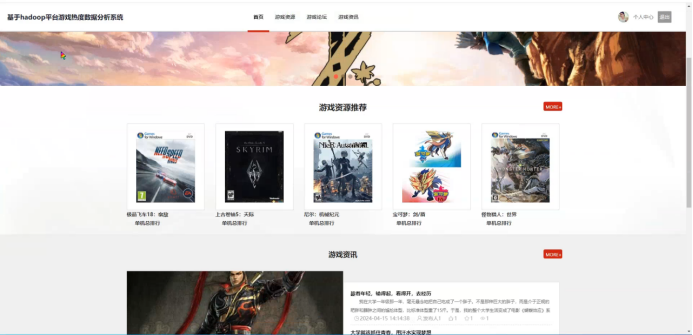
图5-1 系统首页界面
系统注册:在注册流程中,用户在Vue前端填写必要信息(如用户名、密码等)并提交。前端将这些信息通过HTTP请求发送到Java后端。后端处理这些信息,检查用户名是否唯一,并将新用户数据存入MySQL数据库。完成后,后端向前端发送注册成功的确认,前端随后通知用户完成注册。这个过程实现了新用户的数据收集、验证和存储。系统注册页面如图5-2所示:
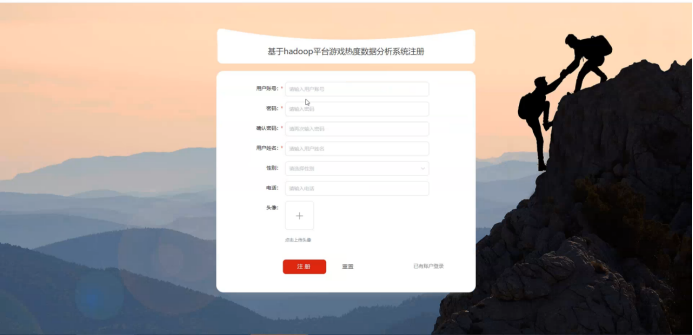
图5-2系统注册页面
游戏资源:在游戏资源页面的输入栏中输入中文名称、分类进行查询,可以查看到游戏资源详细信息,并根据需要进行评论或收藏操作;游戏资源页面如图5-3所示:

图5-3游戏资源详细页面
游戏资讯:在游戏资讯页面的输入栏中输入标题进行查询,可以查看到游戏资讯详细信息,并根据需要进行点赞或收藏操作;游戏资讯页面如图5-4所示:
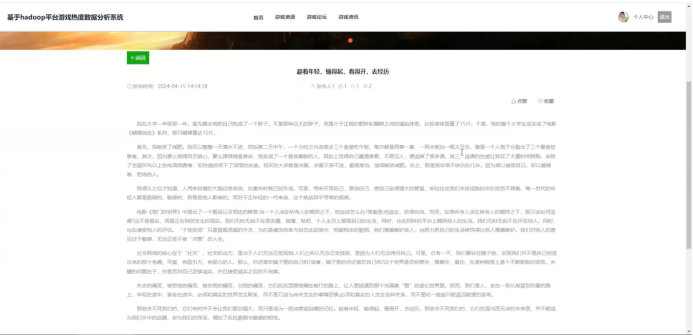
图5-4游戏资讯详细页面
个人中心:在个人中心页面通过填写个人详细信息进行更新操作,还可以对个人中心、修改密码、我的发布、我的收藏进行详细操作;如图5-5所示:
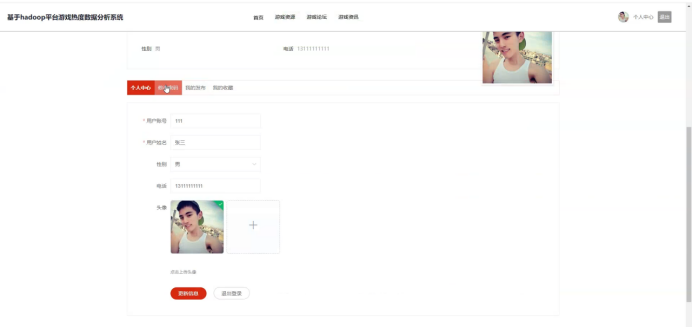
图5-5个人中心界面
5.2 后台模块实现
在登录流程中,用户首先在Vue前端界面输入用户名和密码。这些信息通过HTTP请求发送到Java后端。后端接收请求,通过与MySQL数据库交互验证用户凭证。如果认证成功,后端会返回给前端,允许用户访问系统。这个过程涵盖了从用户输入到系统验证和响应的全过程。如图5-6所示。
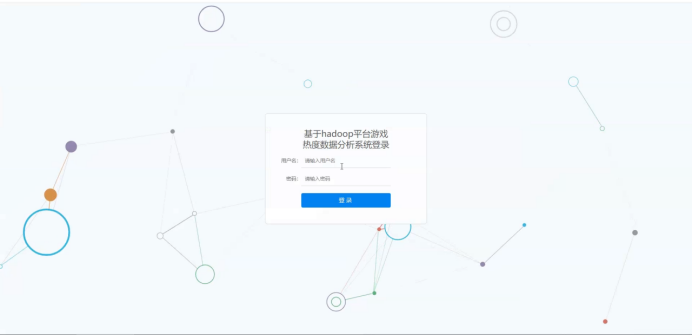
图5-6 后台登录界面
管理员进入主页面,主要功能包括对等进行操作。管理员主页面如图5-7所示:
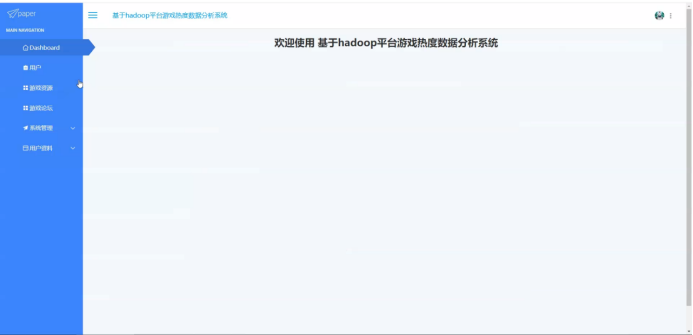
图5-7 管理员主界面
用户功能在视图层(view层)进行交互,比如点击“查询、添加或删除”按钮或填写用户表单。这些用户表单动作被视图层捕获并作为请求发送给相应的控制器层(controller层)。控制器接收到这些请求后,调用服务层(service层)以执行相关的业务逻辑,例如验证输入数据的有效性和与数据库的交互。服务层处理完这些逻辑后,进一步与数据访问对象层(DAO层)交互,后者负责具体的数据操作查看、修改或删除用户信息,并将操作结果返回给控制器。最终,控制器根据这些结果更新视图层,以便用户功能可以看到最新的信息或相应的操作反馈。如图5-8所示:
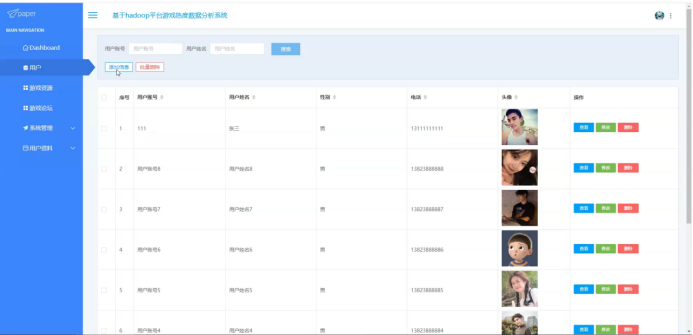
图5-8用户界面
游戏资源功能在视图层(view层)进行交互,比如点击“搜索、添加信息、批量删除、爬取数据”按钮或填写游戏资源表单。这些游戏资源表单动作被视图层捕获并作为请求发送给相应的控制器层(controller层)。控制器接收到这些请求后,调用服务层(service层)以执行相关的业务逻辑,例如验证输入数据的有效性和与数据库的交互。服务层处理完这些逻辑后,进一步与数据访问对象层(DAO层)交互,后者负责具体的数据操作查看、修改、查看评论或删除游戏资源信息,并将操作结果返回给控制器。最终,控制器根据这些结果更新视图层,以便游戏资源功能可以看到最新的信息或相应的操作反馈。如图5-9所示:
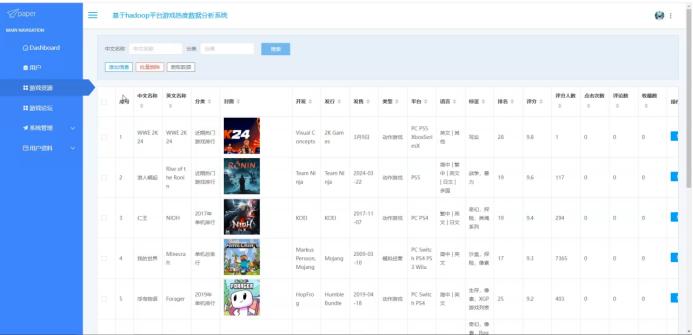
图5-9游戏资源界面
管理员点击游戏论坛。进入游戏论坛页面输入帖子标题可以搜索或批量删除游戏论坛信息,并进行查看、查看评论或删除等操作。如图5-10所示:
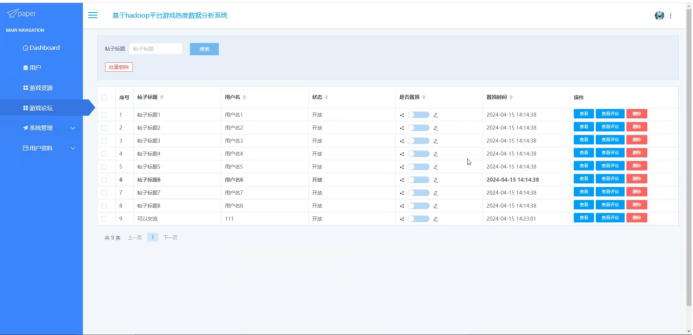
图5-10游戏论坛界面
管理员点击系统管理。进入系统管理的游戏资讯分类页面输入分类名称可以查询、添加或删除分类信息,并进行查看、修改或删除等操作。如图5-11所示:
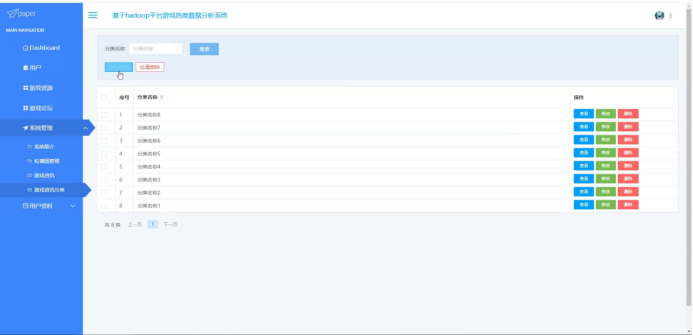
图5-11系统管理界面
管理员进行爬取数据后可以在看板页面查看到系统简介、游戏资源总数、中文名称、平台、发行、类型、评分人数等实时的分析图进行可视化管理;看板大屏选择了Echart作为数据可视化工具,它是一个使用JavaScript实现的开源可视化库,能够无缝集成到Java Web应用中。Echart的强大之处在于其丰富的图表类型和高度的定制化能力,使得管理人员可以通过直观的图表清晰地把握游戏的各项运营数据。
为了实现对游戏信息的自动化收集和更新,我们采用了Apache Spark作为爬虫技术的基础。Spark的分布式计算能力使得系统能够高效地处理大规模数据,无论是从互联网上抓取最新的游戏信息,还是对内部数据进行ETL(提取、转换、加载)操作,都能够保证数据的实时性和准确性。
在大数据分析方面,系统采用了Hadoop框架。Hadoop是一个能够处理大数据集的分布式存储和计算平台,它的核心是HDFS(Hadoop Distributed File System)和MapReduce计算模型。通过Hadoop,我们可以对收集到的大量数据进行存储和分析。如图5-12所示:
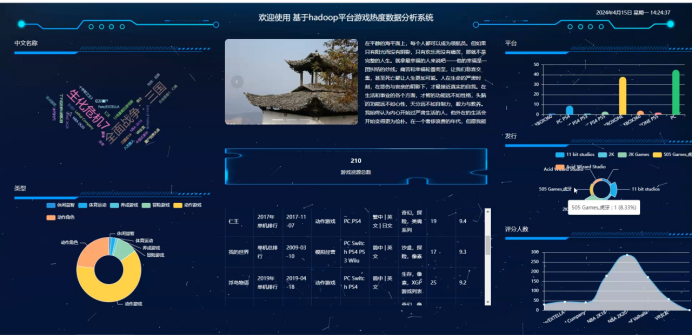
图5-12看板界面
源码无偿分享,文未领取


 扫一扫


 3176

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


