目前针对大模型进行量化的方法概览

一步一步理解大模型:模型量化技术1-简介 简单的说,激活的意思就是如果这个靠近的某个落脚点,就把它算成某个落脚点的值. 在训练模型的时候,机器会调整这些权重,这些权重会用某个落脚点的值来表示。总的来看,模型量化的精度损失取决于多种因素,包括所使用的量化策略、模型的特性,以及实际应用中的需求等。现在,我们把这个0到1之间的范围称为一个权重,看成一片连续的水面,上面表中的值看成一个一个的“落脚点”。依此类推,你有2的n次方种方法来表示这个范围,这里的n就是比特的位数。就是说,你仅用少量的精度损失的代价节省了大量的存储空间,是非常划算的。 阅读详情

转载自知乎:吃果冻不吐果冻皮

近年来,随着Transformer、MOE架构的提出,使得深度学习模型轻松突破上万亿规模参数,从而导致模型变得越来越大,因此,我们需要一些大模型压缩技术来降低模型部署的成本,并提升模型的推理性能。 模型压缩主要分为如下几类:

  • 剪枝(Pruning)
  • 知识蒸馏(Knowledge Distillation)
  • 量化Quantization)

本系列将针对一些常见大模型量化方案(GPTQ、LLM.int8()、SmoothQuant、AWQ等)进行讲述。

本文将讲述大模型压缩部署最重要的技术模型量化的基本概念以及当前大模型量化相关的一些工作。

文章较长,建议先点赞收藏,后续再慢慢观看。另外,我撰写的大模型相关的博客及配套代码均整理放置在Github:llm-action,有需要的朋友自取。

简介

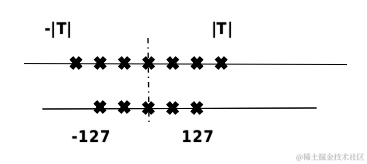
模型量化是指以较低的推理精度损失将连续取值(通常为float32或者大量可能的离散值)的浮点型权重近似为有限多个离散值(通常为int8)的过程。通过以更少的位数表示浮点数据,模型量化可以减少模型尺寸,进而减少在推理时的内存消耗,并且在一些低精度运算较快的处理器上可以增加推理速度。具体如下图所示,[-T, T]是量化前的数据范围,[-127, 127]是量化后的数据范围。
量化比特

计算机中不同数据类型的占用比特数及其表示的数据范围各不相同。可以根据实际业务需求将原模型量化成不同比特数的模型,一般深度神经网络的模型用单精度浮点数表示,如果能用有符号整数来近似原模型的参数,那么被量化的权重参数存储大小就可以降到原先的四分之一,用来量化的比特数越少,量化后的模型压缩率越高。

工业界目前最常用的量化位数是8比特,低于8比特的量化被称为低比特量化。1比特是模型压缩的极限,可以将模型压缩为1/32,在推理时也可以使用高效的XNOR和BitCount位运算来提升推理速度。

量化对象

模型量化的对象主要包括以下几个方面:

  • 权重(weight):weight的量化是最常规也是最常见的。量化weight可达到减少模型大小内存和占用空间。
  • 激活(activation):实际中activation往往是占内存使用的大头,因此量化activation不仅可以大大减少内存占用。更重要的是,结合weight的量化可以充分利用整数计算获得性能提升。
  • KV cache:量化 KV 缓存对于提高长序列生成的吞吐量至关重要。
  • 梯度(Gradients):相对上面两者略微小众一些,因为主要用于训练。在训练深度学习模型时,梯度通常是浮点数,它主要作用是在分布式计算中减少通信开销,同时,也可以减少backward时的开销。

量化形式

另外,根据量化数据表示的原始数据范围是否均匀,还可以将量化方法分为线性量化和非线性量化。实际的深度神经网络的权重和激活值通常是不均匀的,因此理论上使用非线性量化导致的精度损失更小,但在实际推理中非线性量化的计算复杂度较高,通常使用线性量化。

下面着重介绍线性量化的原理。假设r表示量化前的浮点数,量化后的整数q可以表示为:

q = c l i p ( r o u n d ( r s + z ) , q m i n , q m a x ) q=clip(round(\frac{r}{s}+z),q_{min},q_{max}) \\ q=clip(round(sr​+z),qmin​,qmax​)

r o u n d ( ⋅ ) round(\cdot) round(⋅)和 c l i p ( ⋅ ) clip(\cdot) clip(⋅)分别表示取整和截断操作, q m i n q_{min} qmin​和 q m a x q_{max} qmax​是量化后的最小值和最大值。 s s s是数据量化的间隔, z z z是表示数据偏移的偏置, z z z为0的量化被称为对称(Symmetric)量化,不为0的量化称为非对称(Asymmetric)量化。


模型量化论文阅读#1----综述:A Survey of Quantization Methods for Efficient Neural Network Inference 1. 量化的基本概念 A. 问题设置和符号表示 假设网络有L层,其每层的参数表示为:{W1,W2,…,WL}\left\{W_{1}, W_{2}, \ldots, W_{L}\right\}{W1​,W2​,…,WL​},用θ\thetaθ表示所有参数的集合,以监督学习问题为例,其目标函数为: L(θ)=1N∑i=1Nl(xi,yi;θ)(1) \mathcal{L}(\theta)=\frac{1}{N} \sum_{i=1}^{N} l\left(x_{i}, y_{i} ; \theta\right 阅读详情

相关推荐

量化方法怎么选?如何评估量化后的大模型LLM?

本文都是针对PTQ如何选择和应用量化技术的建议:评估量化对各种NLP任务的影响评估量化对不同LLMs的影响不同的Tensor类型对量化的影响不同的量化方法对模型的影响根据实验结果的几个关键见解如下:模型越大,对仅权重和KV缓存量化的容忍度越高,而对激活量化的容忍度较低。利用专家混合(MoE)技术增加模型大小并不一定增强模型对量化的容忍度。对于大多数NLP任务,将大多数LLM家族量化为W4、W4A8、KV4和W8KV4,性能损失可以忽略不计(

lhx17673139267的博客 1499

大模型量化笔记

大模型量化是通过降低模型参数的数值精度(如32位浮点转8位整数)来压缩模型规模、提升推理效率的核心技术。

Gu_erye的博客 1579

大模型的量化和显存计算

Quantization (量化技术)在机器学习和深度学习领域是一种用于降低计算复杂度、减少内存占用、加速推理的优化方法。特别是目前模型越来越大的情况下,如deepseek的671模型,GTP5中预计到1T的模型。量化的核心目标是将模型中的浮点数权重和激活值转换为低精度数值表示,同时保持模型的准确性和性能尽可能不受影响。更具体一点来说,量化通过使用更小的数据类型(如 INT8、FP16 等)表示模型中的权重和激活值,而不是标准的 32 位浮点数。浮点数用于表示小数或非常大的数字。

风暴之灵得博客 1321

大模型量化--PrefixQuant

本文作者来自香港大学、上海AI Lab、同济大学。模型量化(Quantization),可以降低模型显存占用,提升推理速度,是大模型部署的关键技术。现有的量化方案,大多采用per token的动态量化范式,这样可以忽略激活值的token-wise outliers,而重点处理权重的channel-wise outliers。动态量化和静态量化- 动态量化和静态量化,是针对模型激活值(activation) 量化的两种范式。

a647777的博客 1469

[算法前沿]--046-大模型量化的基本原理

模型量化即以较低的推理精度损失将连续取值的浮点型模型权重进行裁剪和取舍,它是以更少位数的数据类型用于近似表示32位有限范围浮点型数据的过程,而模型的输入输出依然是浮点型,从而达到减少模型尺寸大小、减少模型内存消耗及加快模型推理速度等目标。比如int8量化,就是让原来32bit存储的数字映射到8bit存储。int8范围是[-128,127], uint8范围是[0,255]。

全网120W+关注AI拉呱,专注人工智能以及科技前沿! 1186

ChatGPT等大模型的模型量化:平滑量化法

十亿级的模型、百亿级的模型、千亿级的模型量化难度完全不一样,而像chatgpt为代表的大模型,模型参数已经超过千亿。大模型往往同时是计算密集型+访存密集型的,如果想要做模型压缩,非常困难!这篇博客给大家介绍一下为什么大模型量化困难?大模型压缩过程中会遇到哪些挑战?以及如果解决这些困难?SmoothQuant,这是一种train-free、保持精度、通用的训练后量化(PTQ)解决方案,用于实现LLM的8位加权、8位激活(W8A8)量化。

沉迷单车的追风少年 5576

智能体在车联网中的应用:一份详尽到每日的100天学习路线图

这100天的旅程,是一次对毅力、学习方法和工程实践能力的综合考验。它不仅关乎掌握一系列技术点,更关乎培养解决复杂系统性问题的思维模式——将宏观的交通需求分解为微观的智能体决策,再通过多智能体协同涌现出宏观的智能行为。当你完成这份大纲时,你将拥有的不仅是一个项目作品集,更是一套应对“智能体+车联网”乃至更广泛AI+垂直领域挑战的方法论。未来已来,期待你成为构建智能交通新生态的关键贡献者。

IT深耕十余载,大道之简 1323

使用vcpkg快速安装opencascade并自动配置部署开发环境

广泛的开源库:vcpkg 提供了上千个流行的 C++ 开源库,用户可以通过简单的命令安装和集成这些库,包括 Boost、OpenCV、SQLite、fmt 等。确保包版本一致性:通过 vcpkg.json 文件,开发者可以指定依赖的库版本,确保项目在不同环境下的构建结果一致,避免由于依赖库版本不一致而导致的构建问题。强大的社区支持:Vcpkg 是开源项目,拥有活跃的社区和微软团队的支持,提供了稳定的更新和问题修复。快速更新:Vcpkg 社区活跃,库的更新速度较快,开发者可以迅速获得库的最新版本。

loujiand的博客 2289

FPGA学习之路—应用程序—原码二位乘法器及Verilog代码分析

FPGA学习之路——原码二位乘法器及Verilog代码分析 原理 原码乘法可以分为原码一位乘和原码二位乘,两者在实现规则上大同小异。原码一位乘每次判断乘数的最低位,对被乘数和部分积进行相应操作。而原码二位乘则是对乘数的低二位进行判断,并执行相关操作。 两位乘数的取值可以有四种可能组合,每种组合对应于以下操作: 00相当于0x,部分积Dresult右移2位,不进行其他运算; 01相当于1x,部分积D...

谦豫 3712

WordPress搭建“外贸独立站”完整操作教程

  以往的文章,我们介绍了很多种搭建独立站的方式,有最省事的Shopify 、最专业的Magento以及最省钱的Wordpress Woocommerce。其中,通过主机托管的方式又分了免费的谷歌云vps主机、1美元Godaddy主机以及SiteGround共享主机三种。建站方法方式实在太多了,有免费的,有廉价的,有商业版的,有共享主机、有云主机主机以及各种各样的vps服务器,选择哪种方式,哪款主机,也只有真正试了才直到。   没错,上述的这些方法方式,无一例外,我都亲身折腾过。从个人实际需求和建站方式来

www25qi的博客 8070

手撕Lua字节码:从黑盒到透明

lua 字节码 怎么‘手撕’一个 chunk 看看里面啥样?我手里有一个.luac或出来的二进制字节码,想知道里面到底是什么结构、哪些字段、有哪些指令,怎么一步一步“拆箱”,从一个黑盒变成有迹可循的东西?也就是:不满足于只会loadpcall而是想亲眼看看一个 chunk 内部长啥样,甚至写点工具把它解析出来。这篇就用带你从“拿到一坨.luac不搞高深玄学,尽量让你看完就能自己动手。注:以 Lua 5.3/5.4 为主,细节各版本略有不同,但大体套路是一致的。

本博客聚焦游戏开发技巧、创业实战心得及大学热门课程干货。这里既有技术深度,也有思维广度,无论你是开发者、创业者还是高校学子,都能在这里找到适合自己的成长之路! 91

如何修改网页中的文本内容改成自己希望的数值?

本篇文章主要讲解,通过浏览器命令和浏览器自带的F12开发者工具,进行修改网页内容的方法教程 日期:2021年12月5日 作者:任聪聪 一、通过F12开发者工具进行修改 进入方式汇总: 1.右击鼠标,显示菜单找到审查 2.通过快捷键F12进入,笔记本需要先关闭fnlk功能键。 开发者工具介绍 说明: 1.表示选择元素,点击后可以选择文本的元素所在地 2.表示显示方式,手机还是电脑 3.表示div元素,点击后可以展开,对div内的html和文本进行编辑。 双击文本,即可进行修改成自己想要的,但是刷新后.

任聪聪的博客 2万+

DCM07-诊断服务EcuReset ($11 )的配置和实现

文章目录1 诊断服务EcuReset ($11 )1.1 概述1.2 诊断模式声明组1.3 代码实现1.4 配置参数 传送门 ==>> AutoSAR实战系列300讲「糖果Autosar」总目录 1 诊断服务EcuReset ($11 ) 1.1 概述 该服务实现了 ECU 内的复位功能,协议的具体理论讲解请参考「FlashBootloader03【电控单元复位服务($11)】」。在接收到UDS 服务 0x11 的请求时,DCM 模块应触发 ModeDeclarationGroupPrototy

2056

18、公开可用的PPG数据库介绍

本文介绍了多个公开可用的PPG(光电容积描记)数据库,包括PPG-BP数据库、MIMIC II波形数据库、运动期间手腕PPG数据库以及指尖PPG与呼吸数据库等。这些数据库提供了丰富的生理信号数据,适用于动脉血压检测、呼吸频率估计、运动干扰去除以及基于PPG的生物特征识别等研究。每个数据库的数据来源、受试者信息、信号特点和下载方式均有详细介绍,并展示了如何利用这些数据库进行信号分析和算法评估。

salt的博客 381

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

上一篇: triton inference server入门1
下一篇: 大模型来自面试的体会和分享 2024版
seetimee
博客等级 码龄7年 952粉丝 80原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值