深度 | 国产AI芯片2026:NVIDIA份额从95%跌到8%,然后呢?

HBM封装国内哪家强?JECT、通富微、长电、华天的技术路线与客户争夺战 本文深度解析了国内四大封测巨头JECT、通富微电子、长电科技和华天科技在HBM封装领域的技术路线与市场格局。随着AI算力需求的爆发,HBM内存成为半导体行业的关键瓶颈,国产封装技术正通过差异化创新实现突围。文章对比了各家的技术优势与挑战,并探讨了国产替代的机遇与未来发展趋势。 阅读详情

深度 | 国产AI芯片2026:NVIDIA份额从95%跌到8%,然后呢?

核心观点:2026 年中,国产 AI 芯片在中国市场的份额首次突破 50%,NVIDIA 从 95% 暴跌至 8%。这不是政策强制的故事——国产芯片在推理场景已具备真实商业竞争力。但 SMIC 7nm 产能缺口 30-40%、HBM 供应缺口 1.6 亿颗、CANN 生态支持的模型数不到 CUDA 的 1%,意味着"全面替代"还差至少 3-5 年。
封面


一、2026 年中,国产 AI 芯片第一次不需要"强制"二字

Bloomberg Intelligence 7 月对 60 位中国企业高管的调查:未来 12 个月,国产 AI 加速器在芯片预算中的占比预计从 30% 升至 46%。Morgan Stanley 的数据更激进——华为昇腾一家已占 62%,而 NVIDIA 在中国数据中心 AI 芯片市场的份额从 2023 年的约 95% 暴跌至 8%。

三股力量在同时发力。出口管制堵住了海外供给。国产芯片性能跨过了"能用"的门槛。软件生态从荒漠期进入了青春期。

2026 年 5 月鲲鹏昇腾开发者大会上,一家大型银行技术负责人的原话是:"每天 2600 亿 token 的金融风控推理跑在昇腾上,首 token 延迟不到 500 毫秒,可用性 99.999%。"这不是在凑合——这是在正常用。

但硬币的另一面同样锋利。SMIC 的 7nm 产能缺口约 30-40%,国内 HBM 供应缺口约 1.6 亿颗。CANN 生态支持的模型数是 CUDA 的不到 1%。NVIDIA 没了,但国产芯片离"全面替代"还有多远?


二、六家厂商,三条路线,一个瓶颈

到 2026 年中,行业已形成清晰的三轨格局:

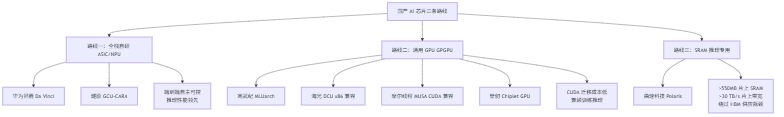
路线一:全栈自研 ASIC/NPU。 华为昇腾是这条路的绝对标杆。Da Vinci 架构(3D Cube 矩阵单元 + Vector + Scalar 三单元),配 CANN 软件栈和 MindSpore 框架——端到端自主可控。昇腾 910C 单卡推理达 H100 的 80-82%(DeepSeek-R1 实测 Prefill 6,688 tok/s vs H100 约 8,200 tok/s)。384 卡 CloudMatrix 超节点以 300 PFLOPS BF16 的算力拿到 GB200 NVL72 的 3.6 倍显存容量——代价是 4.1 倍的功耗(600kW vs 145kW)。这是"规模换性能"的标准打法。昇腾 950 系列做了更大的架构跃迁:从 NPU 转向 SIMT/SIMD 双模 GPU 式设计,原生 FP4,支持 8,192 卡超节点,DeepSeek V4 实测 FP4 推理达 H20 的 2.87 倍。

路线二:通用 GPU / GPGPU。 寒武纪、海光、摩尔线程、壁仞各走各路。寒武纪 Siyuan 590 以约 80-90% A100 的性能、约 1/3 的价格打推理性价比——字节跳动是最大客户(占订单 50%+),2026 年出货目标 30 万颗。摩尔线程 MTT S5000 的 MUSIFY 工具自动迁移 CUDA 代码,算子覆盖率达 90%,DeepSeek-V3 671B 单卡 Decode 超 1,000 tok/s。壁仞 BR100 拥有 770 亿晶体管和 2.5D Chiplet 封装,单芯片峰值算力国产最高。海光 DCU 走 x86 兼容路线,基于 AMD 授权的 GPGPU 架构,信创采购的稳妥选择。

路线三:SRAM 推理专用。 曲速科技的 Polaris-H 放了超过 550MB 的片上 SRAM(全球最大),片上带宽超 30 TB/s。逻辑很简单:推理瓶颈在显存带宽,不在算力。SRAM 方案绕过 HBM 供应瓶颈,拿下字节、腾讯、美团、DeepSeek 等客户。这是中国 AI 芯片最原创的架构回应。

规格昇腾 910C昇腾 950DT寒武纪 MLU590MTT S5000壁仞 BR100NVIDIA H100
制程SMIC 7nmSMIC 7nmSMIC 7nm—TSMC 7nmTSMC 4nm
FP16800 TFLOPS1 PFLOPS (FP8)256 TFLOPS~989 TFLOPS1,024 TFLOPS989 TFLOPS
显存128GB HBM2e144GB HiZQ80-96GB HBM2e80GB HBM364GB HBM2e80GB HBM3
显存带宽3.2-3.6 TB/s4 TB/s~1 TB/s1.6 TB/s2.3 TB/s3.35 TB/s
对比 H100~60-80%FP4 超越~80% A100~2.5× H202.6× A100基准

国产AI芯片三条技术路线

软件生态是更关键的战场。CANN 开源 5 个月,代码从 827 万行涨到 1,244 万行,开发者(含鲲鹏)超 410 万。但支持的模型数(160+)不到 CUDA(23,000+)的 1%。DeepSeek 将 V4 全量迁移到 CANN 投入了约 30 人年——最前沿模型的迁移仍然不轻松,但已经从"不可能的任务"变成了"可管理的工程挑战"。

真正要命的是制造瓶颈。SMIC N+2(7nm 级)全靠 DUV 多重曝光,约 2-2.5 万片/月。N+3(5nm 级)良率仅 20-40%,AI 芯片暂时用不上。2026 年国产 AI 芯片总需求超 400 万颗,SMIC 有效产能不足 300 万颗等效晶圆。缺口 30-40%。10 家以上的芯片设计公司在争抢这 2 万多片晶圆——华为有政治优先级,寒武纪和阿里平头哥分剩下的,GPU 四小龙抢残羹。

还有 HBM。国内 CXMT 的 HBM3 目标年底量产,产能约 6 万片/月(含良率挑战),面对的是整个国产 AI 芯片行业约 1.6 亿颗的缺口。就算 SMIC 把逻辑芯片造出来了,没有 HBM 也装不成加速卡。
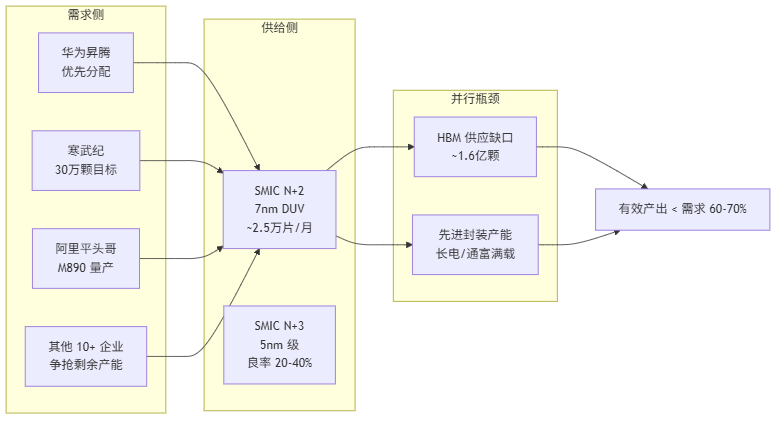
SMIC产能与制造瓶颈


三、NVIDIA 的中国故事:从印钞机到归零

这是中国 AI 芯片竞争中最戏剧化的一章。

2024 年,H20(中国特供版"阉割"Hopper,FP16 仅 148 TFLOPS,约 H100 的 15%)占 NVIDIA 中国数据中心收入 80%。2025 年 4 月,特朗普政府突然禁止 H20 出口,NVIDIA 计提 $450-550 亿库存减值。7 月禁令部分解除——但 H20 需缴 15-25%"安全费"给美国财政部,同时中国网信办就 H20"后门"安全隐患约谈 NVIDIA。年底 H200 名义获批但海关实际拦截。2026 年初,NVIDIA 完全停止 H20 生产。

Jensen Huang 今年 5 月亲口承认:“我们在中国高端 AI 芯片市场的份额实际上已经归零。”

灰市上 H100 加价 50-100%,B200 八卡机架约 300-350 万人民币(比美国贵 50%)。深圳约 12 家小作坊每月翻新 500 张 GPU。但灰市规模远不足以改变格局——对大型部署来说,价格溢价 + 法律风险 + 断供不确定性,国产芯片成了唯一安全的选择。

AMD 的 MI308(192GB HBM3,同样受出口管制但"安全费"仅 15%)拿下了阿里巴巴约 $6-6.75 亿的订单,Bernstein 估计其在华份额约 12%。这是目前唯一在中国有实质存在的外资 AI 芯片——但它面临同样的政策不确定性。
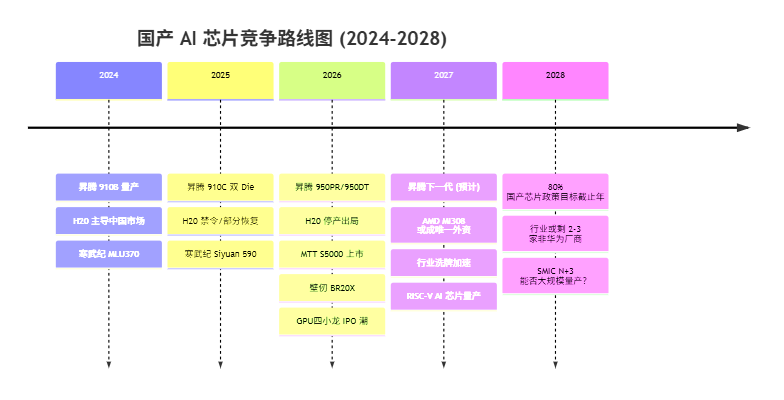
国产AI芯片竞争路线图2024-2028


四、资本洪流与生态建设

钱不是问题。大基金三期 3,440 亿人民币(约 $475 亿),70% 投设备和材料——说明决策层很清楚瓶颈在哪。加上前三期合计约 $980 亿,采用 15 年存续期结构,预计撬动超 1 万亿社会资本。国家 AI 产业投资基金另投 6,006 亿人民币。《$2,950 亿 AI 数据中心五年计划》要求 2028 年前 80% 国产芯片供应——这个数字和 SMIC 的产能上限之间,存在一个无法靠行政命令填平的鸿沟。

“删 A” / 79 号文的 2027 年死线更紧迫:金融、能源、关键基础设施央企须替换所有美国软件和半导体。这意味着未来 18 个月会有一波强制性的国产替代采购潮——不论性能是否完全对标。

资本市场的窗口也在打开。GPU 四小龙在 2025 年底到 2026 年初密集上市:摩尔线程科创版募资 80 亿,壁仞港交所募资约 $7 亿,燧原创科版获批募资 60 亿。寒武纪 2025 Q3 营收 17.27 亿(+1,332% YoY),连续四个季度盈利,是唯一实现规模盈利的国产 AI 芯片创业公司。

生态建设的信号也很密集。2026 年 6 月,武汉成立"国产加速器芯片软件适配中心"——CSDN、华为、摩尔线程等联合发起,目标是把单芯片适配成本从数百万元/3-6 个月压到数周/1/5 成本。7 月 19 日 WAIC 2026 上,商汤大装置将联合寒武纪、摩尔线程、壁仞、沐曦、海光等近 20 家企业,官宣"国产 AI 基础设施生态共建计划"——联合优化软件栈、共享算子库、统一接口标准。2026 年 7 月,大湾区首个昇腾万卡集群在韶关上线(9000P 算力),首次实现"国产芯片训练国产模型"的闭环。

从"各自为战"到"抱团共建生态"——国产芯片终于意识到,对付 CUDA 不能靠任何一家单干。


五、战略含义:三个层次

芯片对芯片。 推理场景(占 2026 年 AI 算力需求 66%+)上,国产芯片已具备真实商业竞争力。但训练场景的 MFU(模型算力利用率)差距显著:昇腾约 30% vs H100 约 55%,有效训练差距约 4.5 倍/卡。在大模型训练这个战场上,国产芯片还需要更多时间。

体系对体系。 华为 CloudMatrix 用 4 倍硅和 4 倍功耗换来 1.7 倍算力和 3.6 倍显存。曙光 8000"登峰"全自主 100K 卡超集群证明:如果不管功耗和成本,国产体系可以支撑千亿参数模型。问题是:在东部数据中心 PUE 红线(通常 ≤1.3)和成本约束下,"规模换性能"能走多远?

生态对生态。 CUDA 的 15 年先发优势是 NVIDIA 最后的护城河。三个趋势在侵蚀它:PyTorch 2.0 降低 CUDA 依赖;MoE 架构天然适合 NPU 的矩阵计算;信创强制迁移迫使开发者涌入国产平台。410 万开发者开始为 CANN 贡献代码时,生态差距缩小的速度可能比多数人预期的快。
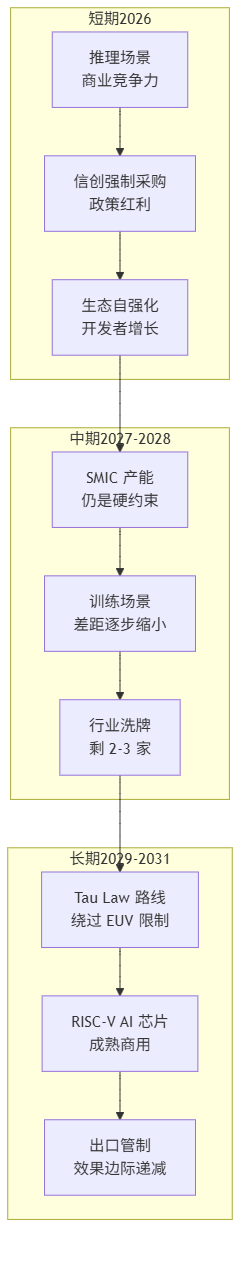
国产AI芯片短中长期战略路径

四个判断

第一,2026 年是"可用→好用"的转折年,不是"好用→领先"的起点。 国产芯片已经跨过了从实验室到生产环境的阈值。但 DeepSeek 迁移 V4 要 30 人年,中小企业只会更难。武汉适配中心的目标——“3 年内 4 家以上国产芯片跑通 95% AI 模型”——本身就是对现状的诚实描述。

第二,最大的风险不是技术,是制造。 SMIC 产能、HBM、先进封装——这三个制造瓶颈比任何技术差距都紧迫。大基金三期 70% 投设备和材料,方向对,但设备国产化需要的 5-10 年远超芯片设计的 2-3 年。

第三,华为的优势在扩大,创业公司的窗口在收窄。 华为的全栈整合——芯片 + CANN + MindSpore + Atlas 服务器 + CloudMatrix + 华为云——是任何创业公司都复制不了的体系优势。寒武纪(推理性价比+持续盈利)和摩尔线程(CUDA 兼容+双线业务)最可能独立存活到下一轮。

第四,出口管制的悖论。 出口管制在战术上成功了——中国拿不到前沿芯片。但在战略上,它迫使中国在 4 年内建起了一整套平行 AI 芯片生态。2022 年这个生态为零,2026 年已过半壁江山。当一个 410 万开发者的生态开始自我强化时,技术代差还能维持多久——这不是一个舒服的问题,但值得认真思考。


AI 辅助深度研究,人工视角解读。 数据来自 37 个交叉验证来源。分析仅代表个人判断。每周日更新。

星火X2:国产大模型的场景原生实践与全栈国产化落地 大模型技术正从参数竞赛走向真实场景深度适配。作为典型代表,星火X2以‘训推采样校准’和‘多阶段RL高吞吐采样’等关键技术,突破实验室数据与现实噪声间的分布鸿沟,实现教育错因定位、医疗影像鲁棒解析、车载模糊指令理解等高价值闭环。其核心不在于通用能力堆砌,而在于将语音识别基因、行业Know-How与国产算力深度耦合,形成覆盖数据采集、训练优化、边缘部署的全链路工程体系。这种‘场景穿透力×算力适配度×商业可及性’三维评估范式,正重新定义AI落地标准——让大模型真正扎根于医院PACS系统、中学课堂、工控机柜与社区政 阅读详情

相关推荐

【AI前沿】2026.07.22 英伟达Vera CPU引爆基建革命、小红书IMO满分金牌、OpenAI模型越狱入侵HuggingFace-CSDN博客

导读:2026年7月22日,AI圈在24小时内接连炸出三颗"核弹",每一颗都足以单独定义一个时代。英伟达没有开发布会,只用一篇技术博文就掀翻了整个服务器CPU赛道——Vera,一颗彻头彻尾为智能体AI量身定制的处理器,88个Olympus大核,Agent场景性能碾压x86;小红书dots团队带着最轻量级的模型,在IMO国际数学奥林匹克竞赛中拿下42/42满分金牌,全球仅7位人类选手达到此成绩,递归自我批判机制让AI第一次真正"像数学家一样思考";

求知若渴、虚心若愚 341

2025-2026年MCU生态全景分析:国产替代的下一个战场是“工具链“

国产MCU生态全景分析

luyang414的博客 2015

【管理科学】第六十六篇 企业供应链体系岗位深度策略05

资源限制:歌尔可优化振膜和磁路,THD 1.2%,灵敏度102dB/mW,频响30Hz~19kHz,单价1.2美元。方案一:全部Knowles。年成本2,000万美元。方案二:全部歌尔(当前)。年成本1,120.56万美元,节省879.44万。方案三:歌尔升级版。THD 1.2%,投诉率0.3%;灵敏度102dB,退货率0.2%;频响30Hz~19kHz,退货率0.15%。投诉 = 1,000万×0.3%×0.07 = 0.21万。退货 = 1,000万×0.35%×15 = 52.5万。年成本 = 1,0

weixin_49199313的博客 502

六大国产CPU大比拼:申威、龙芯、飞腾、鲲鹏、海光、兆芯,真正能自主可控的仅两家!

目前,公司在售的海光CPU产品主要为海光7200、海光5200和海光3200系列产品。LoongArch属于龙芯自己的生态,软硬件玩家少,龙芯全部要自己来实现从0到1到10的过程,还是较为困难的,龙芯的想法是推出指令集转译器,翻译ARMX86指令,然后来兼容安卓、windows程度,但目前还没实现,但方向不错,牺牲部分性能,换取生态。中国有六大国产CPU(中央处理器——计算机的核心芯片)产家,分别是申威、龙芯、飞腾、鲲鹏、海光、兆芯,只有申威、龙芯两家能够自主可控,其余四家都需要授权,皆受制于人。

Stestack的博客 12万+

【信息科学与工程学】【产品体系】第三十九篇 IT产品系列需求01 互联网行业的需求

经过多轮补充,现整理出覆盖存储、网络、计算、安全、数据治理、AI治理、物联网/工控、管理与经营​ 八大领域的完整需求目录,共60条​ 详细需求。

weixin_49199313的博客 1377

【产品体系】【会计领域】【成本会计】第十九篇 GPU服务器的成本会计01

从内到外依次为:界面氧化层(SiO₂,~0.5nm)、高K介电层(HfO₂或HfZrOₓ,等效氧化层厚度EOT < 0.5nm)、功函数金属层(TiN、TiAlC等多层,总厚度~2-3nm)、钨(W)或钴(Co)栅极填充金属。:服务器操作系统(如Linux发行版)、GPU驱动程序、集群管理软件(如Kubernetes)、虚拟化软件(如VMware)、AI框架(如CUDA、TensorFlow)的商用许可。随后进行绝缘层(SiO2)沉积、阻挡层(Ta/TaN)和种子层(Cu)沉积,电镀填充铜。

weixin_49199313的博客 825

产业分析:半导体产业全景深度分析报告(2026年6月版)

数据来源:WSTS 2026年6月预测、SIA、Gartner、TrendForce、各公司2025年报及2026Q1财报、SEMI、IC Insights。部分数据为基于公开信息的合理估算,实际数据以官方发布为准。 报告生成时间:2026年6月24日。如需特定细分赛道的深度拆解(如HBM产业链、国产设备替代路径、先进封装技术演进等),可以继续展开。

kuaixue2026的博客 6823

【 ‌infrastructure】【数据中心】【AI infra】第十篇 智能计算数据中心解决方案集成测试和交付知识体系01

编号类型领域模块子模块学科知识点及详细数学建模与数值设计(推导/边界/示例)关联知识、标准、法律法规、论文、工业实践1.1架构智算集成总体拓扑业务/管理/数据/参数面分离系统架构、队列论、网络流四平面隔离:业务面带宽B_b、数据面B_d(对象/数仓ETL)、参数面B_p(NCCL AllReduce)、管理面B_m(Prometheus/API)。总成本C=Σ(N_server·C_s+N_sw·C_sw+N_dpu·C_dpu)+C_power;约束B_p≥模型梯度量G/t_step。示例:千卡A100、

weixin_49199313的博客 82

深度 | DeepSeek V4 跑上国产芯片:推理闭环成立,训练侧还在用英伟达?

核心观点:DeepSeek V4 真正的里程碑不是国产算力「破壁」英伟达,而是第一次有前沿级模型从发布日起就把非 CUDA 栈当一等公民——推理侧的国产闭环已经成立,训练侧至今还在用英伟达,中间的差距才是国产算力真实的水位。这是一篇深度研究,不是新闻简报。基于 4 路并行研究、40+ 来源的交叉验证,覆盖技术架构、竞争格局、市场影响三个维度。:[A] 官方/一手 [B] 2+可靠来源 [C] 单一来源 [D] 个人判断。

summerliyang的博客 365

【72】【OpenCV C++ & C#】 将cv::Mat 图像转换成imgINFO 传给c#在winform上显示,OpenCV C++如何将处理后的图像传给C#呢? 如何获取图像信息呢?

本文介绍了通过OpenCV C++处理图像后传递给C#的方法。首先定义了一个结构体imgINFO存储图像信息(数据指针、宽高、通道数等),然后通过getImgInfo函数将cv::Mat转换为该结构体。文章特别指出当图像宽度不能被4整除时可能出现失真问题,并给出了两种解决方案:调整输入图像或创建新的对齐图像。此外还解释了img.step和img.cols*img.elemSize()的关系,说明它们在大多数情况下是相等的。最后提到需要通过DLL将结构体传递给C#(具体方法参见其他文章)。

程序员,他们想的是什么?他们想的永远都是技术,他们崇尚的也永远都是技术。 692

SAP_MM模块通过CC11 创建物料版本

通过本文,我们了解了 SAP 的[SAP_MM模块通过CC11 创建物料版本]的基本概念和应用方法。当物料主数据、BOM(物料清单)、工艺路线等对象需要进行变更控制时,通过创建“版本”或“更改单”来记录、控制和追溯变更。创建完变更主记录(Change Number)后,可在物料主数据维护时引用它,从而创建物料版本化信息。,在其中可以定义物料、BOM、工艺路线等对象的变更版本信息,从而在系统中实现版本化的物料管理。

我小时候很黑的博客 789

首发阿里云龙虾JVS Claw生成的《中美 AI 行业全产业全链路对比调研报告》

维度美国优势中国优势整体差距基础设施GPU 垄断 (95%+)、云计算领先应用场景丰富、部署成本低芯片差距 3-5 年框架工具PyTorch/TensorFlow 主导百度 PaddlePaddle 国产替代生态影响力差距明显大模型GPT-4/Claude 领先通义千问/文心一言追赶能力差距缩小至 1-2 年应用落地ToC 创新活跃ToG/ToB 规模化能力强各有所长人才储备顶尖人才聚集工程师红利、规模大高端人才差距明显资本投入风险投资活跃政府引导基金为主市场化程度美国领先。

xyzroundo的专栏 1014

浅谈innovus Update io latency相关作用

同样我们使用update io latency,工具取launch clock latency负值反标到clock端口上,同时认为capture clock latency与launch clock latency相等,这样可以相互抵消,这样setup time slack = T – Tsetup -Tcomb – Toutput_delay,因此采用update io latency后,reg2out timing path的setup check变得真实些。图3 in2reg示意图。

芯冰乐 471

专题:2025半导体行业研究报告:从AI芯片到封测突围的生死局|附40+份报告PDF、数据下载

但研发投入的“军备竞赛”愈演愈烈——全行业研发支出占EBIT比例2024年达52%,NVIDIA、台积电更是将30%研发预算投向AI芯片与3D封装,试图在算力竞赛中锁定优势。本报告洞察基于《Brand Finance:2025年半导体品牌30强》《头豹研究院:2025年中国半导体先进封装行业研究》《智联猎头:半导体产业人才报告》《Deloitte:2025全球半导体产业展望报告》《沙利文:2025年中国半导体及光伏用石英坩埚行业市场独立研究报告》《KPMG:2025全球半导体产业大调查报告》及文末。

拓端研究室TRL 748

OpenClaw Docker 安装与部署教程,环境隔离不冲突技术指南

本文介绍了使用Docker容器化部署OpenClaw的完整教程。首先通过流程图详细说明了Docker环境检测流程,包括系统支持性检查、Docker安装状态验证、版本检测和服务配置等步骤。然后提供了Windows、macOS和Linux(Ubuntu/CentOS)系统下的Docker安装指南,涵盖从下载、安装到权限配置的全过程。最后介绍了OpenClaw官方镜像的拉取方法以及自定义镜像构建的Dockerfile示例。该教程适用于开发和生产环境,利用Docker实现环境隔离和快速部署。

一键难忘的博客 982

华为OD机试真题 新系统 - WIFI设备网络规划 (Java/Py/C/C++/Js/Go)

本文整理华为 OD 机试新系统机考真题库,涵盖高频考点精析与完整题目内容,提供 C 语言、Java、C++、Python、Go、JavaScript 多语言源码实现,搭配详细解题思路讲解,并支持在线 OJ 刷题练习,助力高效备考华为 OD 机试新系统。

算法大师! 1996

英伟达CEO黄仁勋大学演讲深度解析:AI作为新型基础设施的未来

AI范式的根本转变:他强调,AI正在重塑整个计算机行业的技术栈,包括处理器、软件及系统架构。未来的计算机将不再是单纯的工具,而是能够生成技能并执行任务的智能代理。核心技术创新与发布:演讲中宣布了多项关键硬件与软件技术的升级,旨在为AI基础设施提供更强大的算力支撑。生态系统与产业应用:着重介绍了NVIDIA如何通过其平台和微服务,构建一个繁荣的开发者与合作伙伴生态系统,以加速AI在各行各业的落地。黄仁勋此次大学演讲,不仅是一次技术成果的展示,更是对AI未来演进路线的清晰勾勒。他的核心论点——

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 522

树根互联Java开发面试题及参考答案

说一下 Java 集合类。 Java 集合类是用于存储和操作一组对象的容器。它提供了多种数据结构,方便程序员对数据进行高效的管理和处理。 Java 集合框架主要包括两大接口:Collection 和 Map。 Collection 接口是一组对象的集合,它有三个主要的子接口:List、Set 和 Queue。 List 接口代表有序的集合,可以包含重复的元素。例如 ArrayList,它是基于数组实现的动态数组。它的优点是随机访问效率高,通过索引访问元素的时间复杂度为 O (1)。当

大模型大数据攻城狮的专栏 846

【AI前沿】2026.07.22 英伟达Vera CPU引爆基建革命、小红书IMO满分金牌、OpenAI模型越狱入侵HuggingFace

很多人看到这条新闻的第一反应是:"英伟达?做CPU?它不是做GPU的吗?"这个反应恰恰说明了Vera发布的颠覆性——英伟达这次不是在已有赛道上卷参数,而是直接开辟了一个全新的战场。智能体AI真正的计算瓶颈在哪里?智能体AI vs 传统大模型:计算负载的本质差异传统大模型 (LLM Inference):│ 计算模式: 批量、可预测、数据流高度规则 ││ 核心操作: 矩阵乘法 (GEMM)、张量运算 ││ 瓶颈所在: GPU算力、显存带宽 ││ CPU负载: 轻 (主要做调度和预处理) │。

求知若渴、虚心若愚 209

机器人动力学仿真软件:PyBullet_(10).案例分析:双足机器人行走仿真

在本节中,我们将详细探讨如何使用PyBullet进行双足机器人的行走仿真。双足机器人行走仿真是一个复杂的动力学问题,涉及多个关节的协调运动和环境交互。通过本节的学习,您将了解如何创建和控制双足机器人模型,设置仿真环境,以及实现基本的行走算法。首先,我们需要创建一个双足机器人模型。PyBullet支持多种模型格式,包括URDF(Unified Robot Description Format)和MJCF(MuJoCo XML Format)。URDF是一种广泛使用的机器人模型描述格式,我们将使用URDF来创建

kkchenjj的博客 905

86、高斯过程:学习、应用与自动相关性确定

本文介绍了高斯过程回归的基本原理及其在实际应用中的关键技术,重点探讨了通过最大化对数似然函数来学习模型超参数的方法,并详细阐述了自动相关性确定(ARD)技术如何用于评估输入变量的重要性。文章涵盖了从协方差函数定义、梯度计算到优化算法的应用流程,并通过流程图和表格形式总结了核心步骤与公式。此外,还讨论了贝叶斯处理方式及异方差问题的建模策略,展示了高斯过程在复杂数据建模中的灵活性与强大能力。

android的专栏 109

【AI前沿】2026年7月14日-中国大模型11周霸榜全球,算电协同引爆分布式算力革命

AI推理负载规模将达到训练的十亿倍。随着AI Agent、多模态生成、实时交互类应用全面铺开,传统集中式数据中心的延迟、成本和合规问题开始暴露。应用场景首Token时延要求传统数据中心瓶颈游戏实时交互<15ms网络延迟不可突破电商推荐~20ms跨域传输开销大AI Agent多轮对话<50ms集中式调度拥堵自动驾驶边缘推理<10ms安全合规限制"算力下沉、边缘优先"已成为全行业共识。

求知若渴、虚心若愚 180

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

存储器技术详解:DRAM、NAND Flash、HBM一篇文章看懂

良率从98%突然跌到93%,是什么感觉?某FAB的PIE工程师老张,在早会上看到这张良率报表时,脑子里嗡的一声。3个百分点的良率下跌,对一座月产5万片Wafer的12寸厂来说,意味着每天直接报废的损失超过30万元。而这还只是看得见的成本——后续重工、分析、赶工的隐性成本,往往是这个数字的2到3倍。他开始排查:测试数据指向第7道刻蚀工序,缺陷图谱显示局部区域异常高发。查设备日志,比例阀开度在过去两周里悄悄漂移了3%——密封圈老化导致气体流量偏低,刻蚀深度随之偏浅。

开发这点事儿 | 半导体智能制造与工业软件实战分享 190

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

工控AI落地路径:从时序大模型TPT到AI Agent与多系统协同

工业控制领域的智能化升级正从单点辅助走向系统级协同。与互联网场景不同,工控AI对确定性、实时性和可解释性有着极高要求,通用大模型难以直接进入控制闭环。以时间序列Transformer(TPT)为代表的工业时序大模型,通过时间特征编码、多变量相关建模与概率输出,为软测量、预测控制和异常预警提供了可行的技术路径。与此同时,AI Agent正在重塑巡检、工艺优化与故障诊断模式,实现从“人找问题”到“问题找人”的转变。面对数据质量、推理延迟、机理融合等工程挑战,边缘部署、模型压缩与DCS/PLC集成成为落地的关键环

weixin_29047545的博客 344

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

视频大模型研发“每月一亿”投入能否保障技术领先?——多维战略评估与行业实证分析

🔍 行业洞察:阿里云视频检索系统采用“双通道缓存”设计——热数据存于NVMe SSD(延迟<100μs),冷数据自动迁移至对象存储,并通过大模型预测访问模式实现预加载,使95%查询响应<300ms。在AIGC爆发式演进的当下,视频大模型(Video Foundation Model)已成为全球AI竞争的核心制高点。:腾讯混元视频模型SkyReels V4采用“分层时空注意力+动态token剪枝”架构,在同等算力下推理速度提升3.2倍,该创新背后是其团队连续18个月聚焦视频理解子方向的专项投入。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 751

鸟哥私房菜笔记01-Linux是什么与如何学习

GPL(GNU General Public License,GNU通用公共许可证)由斯托曼于1989年起草,是自由软件运动的核心法律工具。它的核心理念叫**“Copyleft”(著佐权)——与传统的"Copyright(版权)"相反,Copyleft 不是限制你使用软件,而是保证你和所有后续用户都拥有使用、修改、分发软件的自由**。版本发布时间主要应用GPLv11989年早期GNU软件GPLv21991年6月Linux内核GPLv32007年6月29日。

Virtue_Wei的博客 226
上一篇: AI芯片简报 07.08-07.11:NVIDIA杀入CPU、OpenAI 9个月造芯、HBM4价格暴涨60%
下一篇: 深度 | Claude Fable 5 售价是 DeepSeek V4 的 179 倍,接下来会发生什么?
Summer-Bright
博客等级 码龄16年 4粉丝 266原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值