


看了几天的小甲鱼视频学python基础,居然说要用scrapy才能做成目前想爬的...
换了个详细的scrapy视频教程看点击打开链接
1、爬取网页url数据返回301、302报错
class ModianSpider(scrapy.Spider):
    name = 'modian'
    allowed_domains = ['modian.com']
    start_urls = ['https://zhongchou.modian.com/search?key=%E9%BB%84%E5%A9%B7%E5%A9%B7']

    def parse(self, response):
        hrefs = response.xpath('//div[@class="myproject clearfix"]/ul/li/a/@href').extract()
        for href in hrefs:
            yield scrapy.Request(href, meta={'href': href}, callback=self.parse_pro_page)

    def parse_pro_page(self, response):
        item = ModianItem()

        item['id'] = response.xpath('//div/@data-pro_id').extract()
        item['title'] = response.xpath('//h3[@class="title"]/span/text()').extract()
        item['href'] = response.meta['href']
测试打印url,301/302报错部分提示get地址由https://zhongchou.modian.com/item/12355.html变成 https://m.modian.com/item/12355.html;
排查发现,settings中写的USER_AGENT_LIST(用于随机User-Agent)中加入了手机代理,导致抓取出的url形式变化。修改之后测试打印url和title均正常无报错。
2、爬取js动态数据
部分数据在浏览器“审查元素”中可以找到,“查看源代码”中无法获取,查询后了解这是动态数据。
查看动态数据方法:打开浏览器右键“审查元素”,切换到Network,选中HXR。刷新页面后,HXR中获取新链接。最终在某个链接的Preview/Response里找到目标数据——摩点某项目的集资金额。
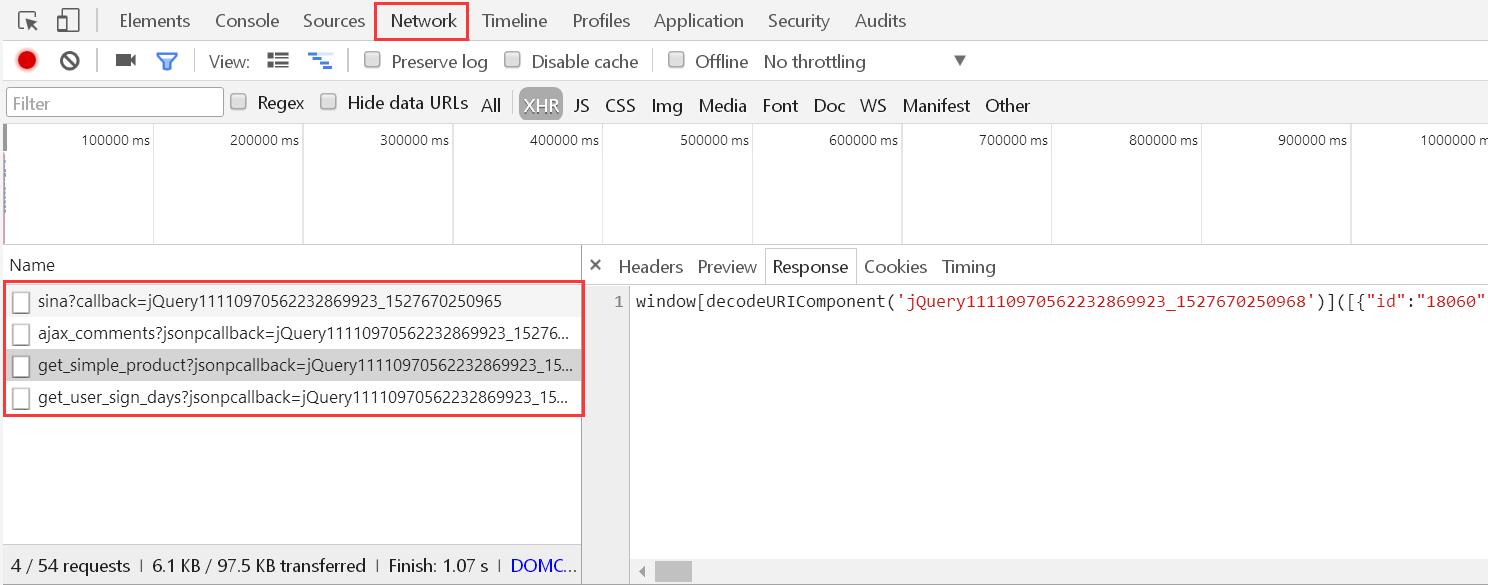
找到目标数据后开始想办法抓取。
网上说用selenium模拟操作,会占用cpu之类的不推荐。那就直接用新的链接抓,链接地址通过Headers里查看:
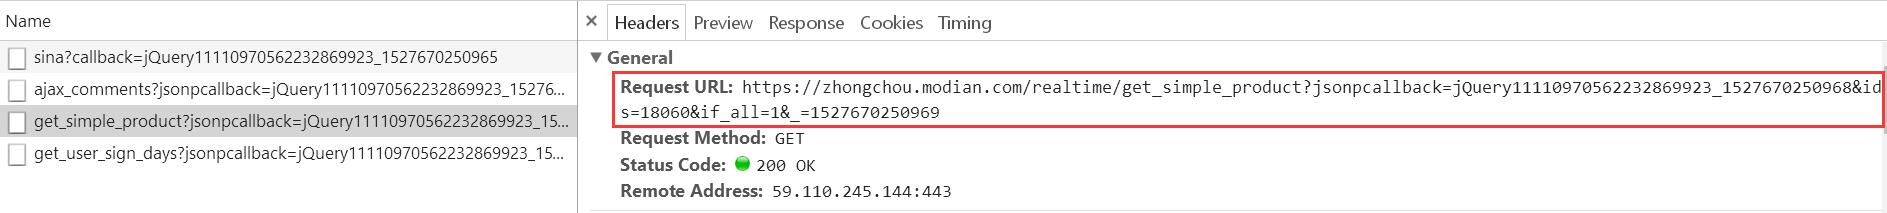
多开几个项目比对一下,观察url样式大致是:
https://zhongchou.modian.com/realtime/get_simple_product?jsonpcallback=jQuery数字_数字&ids=数字&if_all=1&_=数字
其中,ids=数字,这里的数字值正好是之前抓到的项目id。尝试使用正则表达式抓取这个url。这里网上有说应该用python发送GET还是POST请求,没看懂,看到Request Method是GET,就用了requests.get
        get_data = {
            'jsonpcallback': 'jQuery\d+_\d+',
            'ids': item['id'],
            'if_all': '1',
            '_': '\d+'
        }
        return_data = requests.get("https://zhongchou.modian.com/realtime/get_simple_product", params=get_data)

        print(return_data.text)
打印结果确实把Response内的所有内容(包含目标数据)爬取到了,接下来要从中继续提取目标数据了。
 9743


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


