


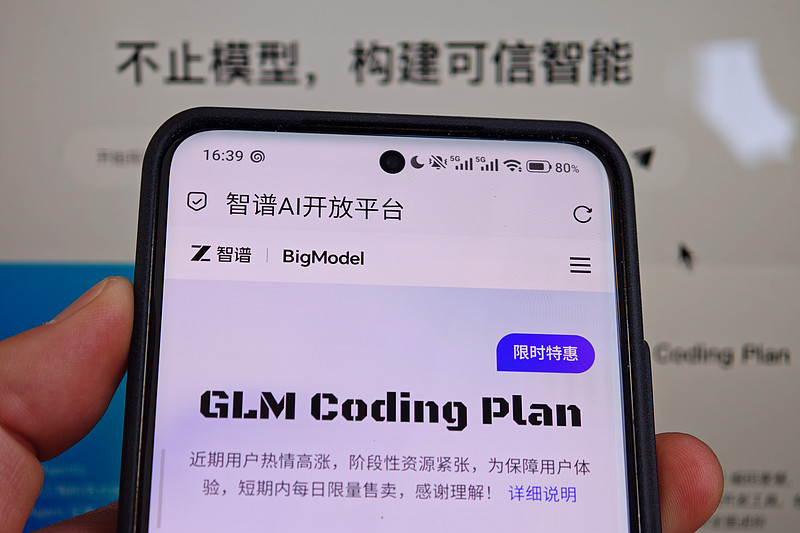
智谱GLM - 5.2初体验
说实话,起初你跟我说国产模型能与Claude、GPT比肩,我是拒绝的。不过,在世超蹲守三天,我终于抢到了智谱的Coding Plan套餐。高强度使用两轮token后,我发现这事似乎真有门道。
智谱应对与算力适配
前几天Anthropic搞出新花样,禁用上线才几天的最强模型Fable 5。就在大家怨声载道之际,智谱出手了。早上Claude发布禁令,下午智谱就以发布新模型作为回应。到今天更是更进一步,直接开放权重,且支持最宽松的MIT协议,意味着大家不仅能直接使用,还能在此基础上修改并商用。同时,智谱还与华为昇腾、平头哥、摩尔线程、寒武纪、昆仑芯、沐曦、海光、壁仞等国产算力平台完成了推理适配。
GLM - 5.1的问题与GLM - 5.2的改进
平时不太关注大模型的朋友,可能对低调的智谱不太了解。上一代GLM - 5.1虽获大家好评,但也存在问题。一是太难抢,比演唱会门票还难搞,每天早上十点准时刷新,全凭手速;二是上下文长度仅支持到256k,处理稍复杂任务时,上下文一满,模型能力就会下降。而GLM - 5.2的更新很大程度上弥补了这些问题,直接提升到百万上下文。从核心长程任务跑分来看,GLM - 5.2综合硬实力介于Claude Opus 4.7和4.8之间。
跑分与实战测试
虽说大家对AI榜单有些麻木,但GLM - 5.2这次跑分惊人。在Code Arena上,GLM 5.2在可用模型中拿下全球第一,分数仅低于前几天被禁用的Claude Fable 5;在Artificial Analysis中,智谱表现仅次于Claude和OpenAI。为检验实际能力,世超进行了测试。先让它做旋转小球游戏,解题思路和Fable相似,不像GPT添加华丽动效,还限制了屏幕“当前小球”最大数量,且在无提示下使用中文UI。最近正值世界杯,让它做点球模拟器,它一次性做出3D游戏,但进球判定较宽松,而Claude Opus 4.8做的程序有bug。至少在编程项目逻辑上,使用GLM - 5.2与4.8体验相差不大。
复杂项目迁移表现
世超在Github上看到AI自动小说续写项目,想移植到手机上。起初用CodeX迁移,CodeX直接拒绝并提建议。世超将同样问题抛给GLM,GLM简单梳理上下文后,启动三个Agent深入代码库探究方案,很快找到解决办法。世超把解决方案发给CodeX后,CodeX道歉反思。经过开发和迁移,GLM - 5.2将应用移植到IOS手机上。
多模态能力与UI问题
由于GLM 5.2是编程偏科模型,无图像识别等多模态能力,遇到前端UI问题时,智谱工程师将图片外包给专门识图模型,提取关键信息后反馈给GLM - 5.2,弥补了部分不足。但与原生多模态模型相比,GLM - 5.2做出的软件UI稍逊一筹,如小说自动续写项目移植到IOS后,UI显得拥挤,可能需开发者与AI进一步配合。
运行速度与算力问题
体验中能明显感觉到,或许因国产大模型厂商缺显卡,GLM - 5.2运行速度不快。世超用Claude或GPT做旋转六边形Demo只需三分钟,而GLM - 5.2用了十三分钟,后续测试Demo也常耗时三四十分钟。可见,国产大模型厂商仍缺算力,这可能也是智谱Coding Plan难抢的原因。
综合评价与展望
世超对GLM - 5.2的感受很复杂。买了订阅后,一天就用掉周额度的50%。整体来看,说它全面超越Claude、GPT有些夸张,目前GLM - 5.2在纯编码方面能与世界顶级闭源模型平分秋色。但要完美完成项目,仅靠编码能力不够。很多问题并非智谱一家的问题,国产模型补齐多模态生态和底层算力短板还需时间。前几天智谱宣布发布GLM - 5.2的文章开头提到:前沿智能不应只属于少数人,也不应被少数规则随时收回,它应该开放、可用、可构建,并服务于每一位开发者。世超认为说得很对,而且智谱也做到了。
 4961


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


