


摘要
2026 年 4 月 22 日,腾讯混元团队正式开源 Hy3 Preview 模型,次日即在 OpenRouter 平台推出完全免费的调用版本(tencent/hy3-preview:free),无信用卡绑定、无 token 计费、无试用期限,让全球开发者零成本体验腾讯顶级大模型能力。作为腾讯混元基础设施重建后首款重磅模型,Hy3 Preview 采用295B 总参数 / 21B 激活参数的 MoE 架构,支持256K 超长上下文,内置三档推理模式,在数学、物理、代码、Agent 等领域性能比肩国际顶尖模型。本文将从模型背景、核心架构、性能实测、免费使用全流程、实战案例、部署方案、行业影响等维度,全方位拆解这款 “免费天花板” 级别的大模型,帮你快速上手并深度应用 Hy3 Preview (Free)。
一、Hy3 Preview 诞生背景:腾讯 3 个月刷新行业速度
1.1 研发背景:基础设施重构后的首秀
2026 年 2 月,腾讯混元团队完成全栈研发基础设施重建,摒弃旧架构,从零搭建适配超大规模模型训练的算力平台、数据流水线与推理框架。仅用 3 个月(2026 年 2 月 - 4 月),团队完成 Hy3 Preview 从架构设计、预训练、微调、强化学习到评测优化的全流程,而行业同类项目常规周期为 6-12 个月,腾讯以 “光速研发” 打破行业惯性。
Hy3 Preview 作为重建后首款模型,承载腾讯 “技术普惠” 战略,核心目标是让顶级大模型能力免费触达全球开发者,同时验证新基础设施的稳定性与高效性 —— 该模型已全面接入腾讯内部元宝、CodeBuddy、WorkBuddy、ima、QQ 等产品,经亿级用户场景压测,成功率达 99.99%+。
1.2 开源与免费策略:真正的零门槛体验
2026 年 4 月 22 日,腾讯正式开源 Hy3 Preview,模型权重同步上传 GitHub、Hugging Face、ModelScope、GitCode 四大平台,遵循腾讯混元社区许可协议,可免费下载、自托管部署,商用需遵守仓库 LICENSE 条款。
更重磅的是,OpenRouter 平台次日(4 月 23 日)上线Hy3 Preview(Free)专属端点(model ID:tencent/hy3-preview:free),明确标注输入$0、输出$0,无任何隐藏限制:无需信用卡验证、无需 token 充值、无试用时长、无调用次数上限(仅基础速率限制,足够开发与原型验证)。这是国内首个顶级 200B + 参数大模型实现 “永久免费 API 调用”,彻底降低大模型使用门槛。
1.3 核心定位:全能型推理与 Agent 模型
Hy3 Preview 定位为 **“快慢思考融合的全能型 MoE 模型”**,主打四大核心能力:
- 深度推理:攻克数学、物理、化学等硬核理科任务,通过清华数学博资考、普林斯顿物理博资考;
- 长文本理解:256K 上下文窗口,支持整本书、百万字文档、全代码仓的一次性处理;
- 代码生成与 Agent:代码能力接近顶尖水平,稳定驱动 495 步复杂 Agent 工作流无中断;
- 高效推理:MoE 架构 + 三档推理模式,平衡响应速度与思考深度,适配从即时聊天到复杂工程的全场景。
二、Hy3 Preview 核心架构:295B MoE+256K 上下文的硬核实力
2.1 基础参数:行业顶级配置
Hy3 Preview 采用Dense-MoE Hybrid 架构,参数规模与核心配置如下表所示:
| 参数项 | 详细数值 | 行业意义 |
|---|---|---|
| 总参数 | 295B(2950 亿) | 跻身全球顶级大模型行列,比肩 GPT-4、Claude 3 |
| 激活参数 | 21B(210 亿) | MoE 架构核心,仅 8/192 专家参与推理,降低算力成本 |
| 专家数量 | 192 个,Top-8 激活 | 192 个专业专家分工,每次推理激活最优 8 个,兼顾效率与能力 |
| 上下文长度 | 256K token | 行业第一梯队,支持约 20 万字中文文本处理 |
| 隐藏层维度 | 4096 | 高维特征提取,提升语义理解精度 |
| 注意力头 | 64 个(GQA,8 个 KV 头) | 分组查询注意力,平衡速度与性能,适配长上下文 |
| 词汇表大小 | 120832 | 覆盖中英及多语言,支持专业术语与生僻词 |
| 支持精度 | BF16 | 主流训练 / 推理精度,兼顾速度与数值稳定性 |
2.2 MoE 架构原理:“分而治之” 的高效推理
传统稠密模型(如 GPT-3)所有参数参与每次推理,算力成本随参数规模线性增长;而 Hy3 Preview 的MoE(混合专家)架构采用 “专家分工 + 动态路由” 机制,核心逻辑如下:
- 专家层拆分:将模型 FFN(前馈网络)拆分为 192 个独立 “专家”,每个专家专注处理特定类型任务(如数学计算、代码生成、文本摘要);
- 动态路由:输入文本后,路由网络快速计算 192 个专家与当前任务的匹配度,仅激活 Top-8 最优专家参与推理,其余专家休眠;
- 参数效率:每次推理仅 21B 激活参数工作,算力消耗接近 20B 稠密模型,但能力比肩 300B 级模型,推理效率提升 40%+。
简单来说,MoE 架构让 Hy3 Preview 实现 “小模型的算力成本,大模型的能力上限”,这也是其能免费开放 API 调用的核心技术支撑。
2.3 三档推理模式:快慢思考自由切换
Hy3 Preview 内置no_think、think_low、think_high三档原生推理模式,无需额外配置,通过 API 参数即可切换,适配不同场景的速度与深度需求:
- no_think(极速模式):无深度思考,直接快速响应,首 token 延迟降低 54%,适合聊天、问答、简单摘要等高频轻量场景,响应速度接近 GPT-3.5;
- think_low(平衡模式):基础思考,兼顾速度与质量,适合日常文案创作、代码补全、普通多轮对话,默认模式;
- think_high(深度模式):全链路深度推理,耗时较长但准确率拉满,适合数学证明、物理推导、复杂代码重构、长文档分析等硬核任务,能力接近 GPT-4。
2.4 256K 超长上下文:打破长文本处理瓶颈
256K 上下文窗口是 Hy3 Preview 的核心亮点,支持一次性处理约 20 万字中文 / 40 万英文文本,远超主流模型的 128K 上限,核心应用场景包括:
- 长文档分析:整本书、学术论文、法律合同、百万字小说的摘要、问答、改写;
- 代码仓理解:全项目代码(数万文件)的一次性读取、重构、bug 排查、技术文档生成;
- 长链路对话:支持数百轮对话记忆,无需分段,适合长期 AI 助手、复杂任务规划;
- 多模态长文本:结合图像 OCR 后的长图文内容理解、报告生成。
三、性能实测:全方位碾压同级模型,比肩国际顶尖水平
3.1 理科推理:硬核能力通过博士级考试
Hy3 Preview 在高难度理工科基准测试中表现惊艳,通过清华求真书院 2026 年春季数学博资考、普林斯顿物理学院博资考、全国中学生生物学联赛(CHSBO 2025),在 FrontierScience-Olympiad、IMOAnswerBench 等国际奥数 / 科学竞赛基准中成绩优异,推理准确率远超 Llama 3、Qwen 2 等开源模型,接近 GPT-4 Turbo。
3.2 代码能力:接近顶尖水平,Agent 任务零中断
代码是 Hy3 Preview 提升最显著的领域,在主流代码基准测试中表现突出:
- SWE-Bench Verified:接近当前最强水平,能独立完成真实世界代码库的 bug 修复、功能开发;
- Terminal-Bench 2.0:命令行任务执行准确率领先,支持复杂 Shell 脚本编写、服务器运维指令生成;
- Agent 任务:驱动 CodeBuddy 完成495 步超长 Agent 工作流(含代码编写、测试、部署、文档生成全链路),全程无中断、无错误,稳定性拉满。
3.3 上下文学习与指令遵循:真实场景适配能力拉满
针对真实业务中 “杂乱冗长上下文 + 复杂多变规则” 的痛点,腾讯自研 **CL-bench(通用上下文学习)、CL-bench-Life(生活场景上下文学习)** 评测体系,Hy3 Preview 在两项测试中较前代提升显著,能精准理解长文本中的隐含信息、复杂指令逻辑,适配企业级文档处理、自动化工作流等场景。
3.4 推理性能:速度与稳定性双优
在腾讯内部压测中,Hy3 Preview 表现出极致的推理性能:
- 首 token 延迟:降低 54%(对比前代模型);
- 端到端时长:降低 47%(复杂推理任务);
- Agent 成功率:99.99%+,适配高频、高稳定需求场景。
四、Hy3 Preview (Free) 免费使用全流程:零成本快速上手
Hy3 Preview (Free) 的免费调用主要通过OpenRouter 平台实现(官方推荐,最便捷无门槛),支持 API 调用、在线对话、代码调试,无需信用卡、无需充值,全程免费。以下从注册、API Key 获取、在线体验、代码调用四步,手把手教你上手。
4.1 第一步:注册 OpenRouter 账号(免费)
- 访问 OpenRouter 官网:https://openrouter.ai/
- 点击右上角 “Sign Up”,选择邮箱注册(无需手机号、无需信用卡);
- 输入邮箱、设置密码,点击注册;
- 邮箱接收验证链接,点击激活账号,注册完成。
4.2 第二步:获取免费 API Key(永久有效)
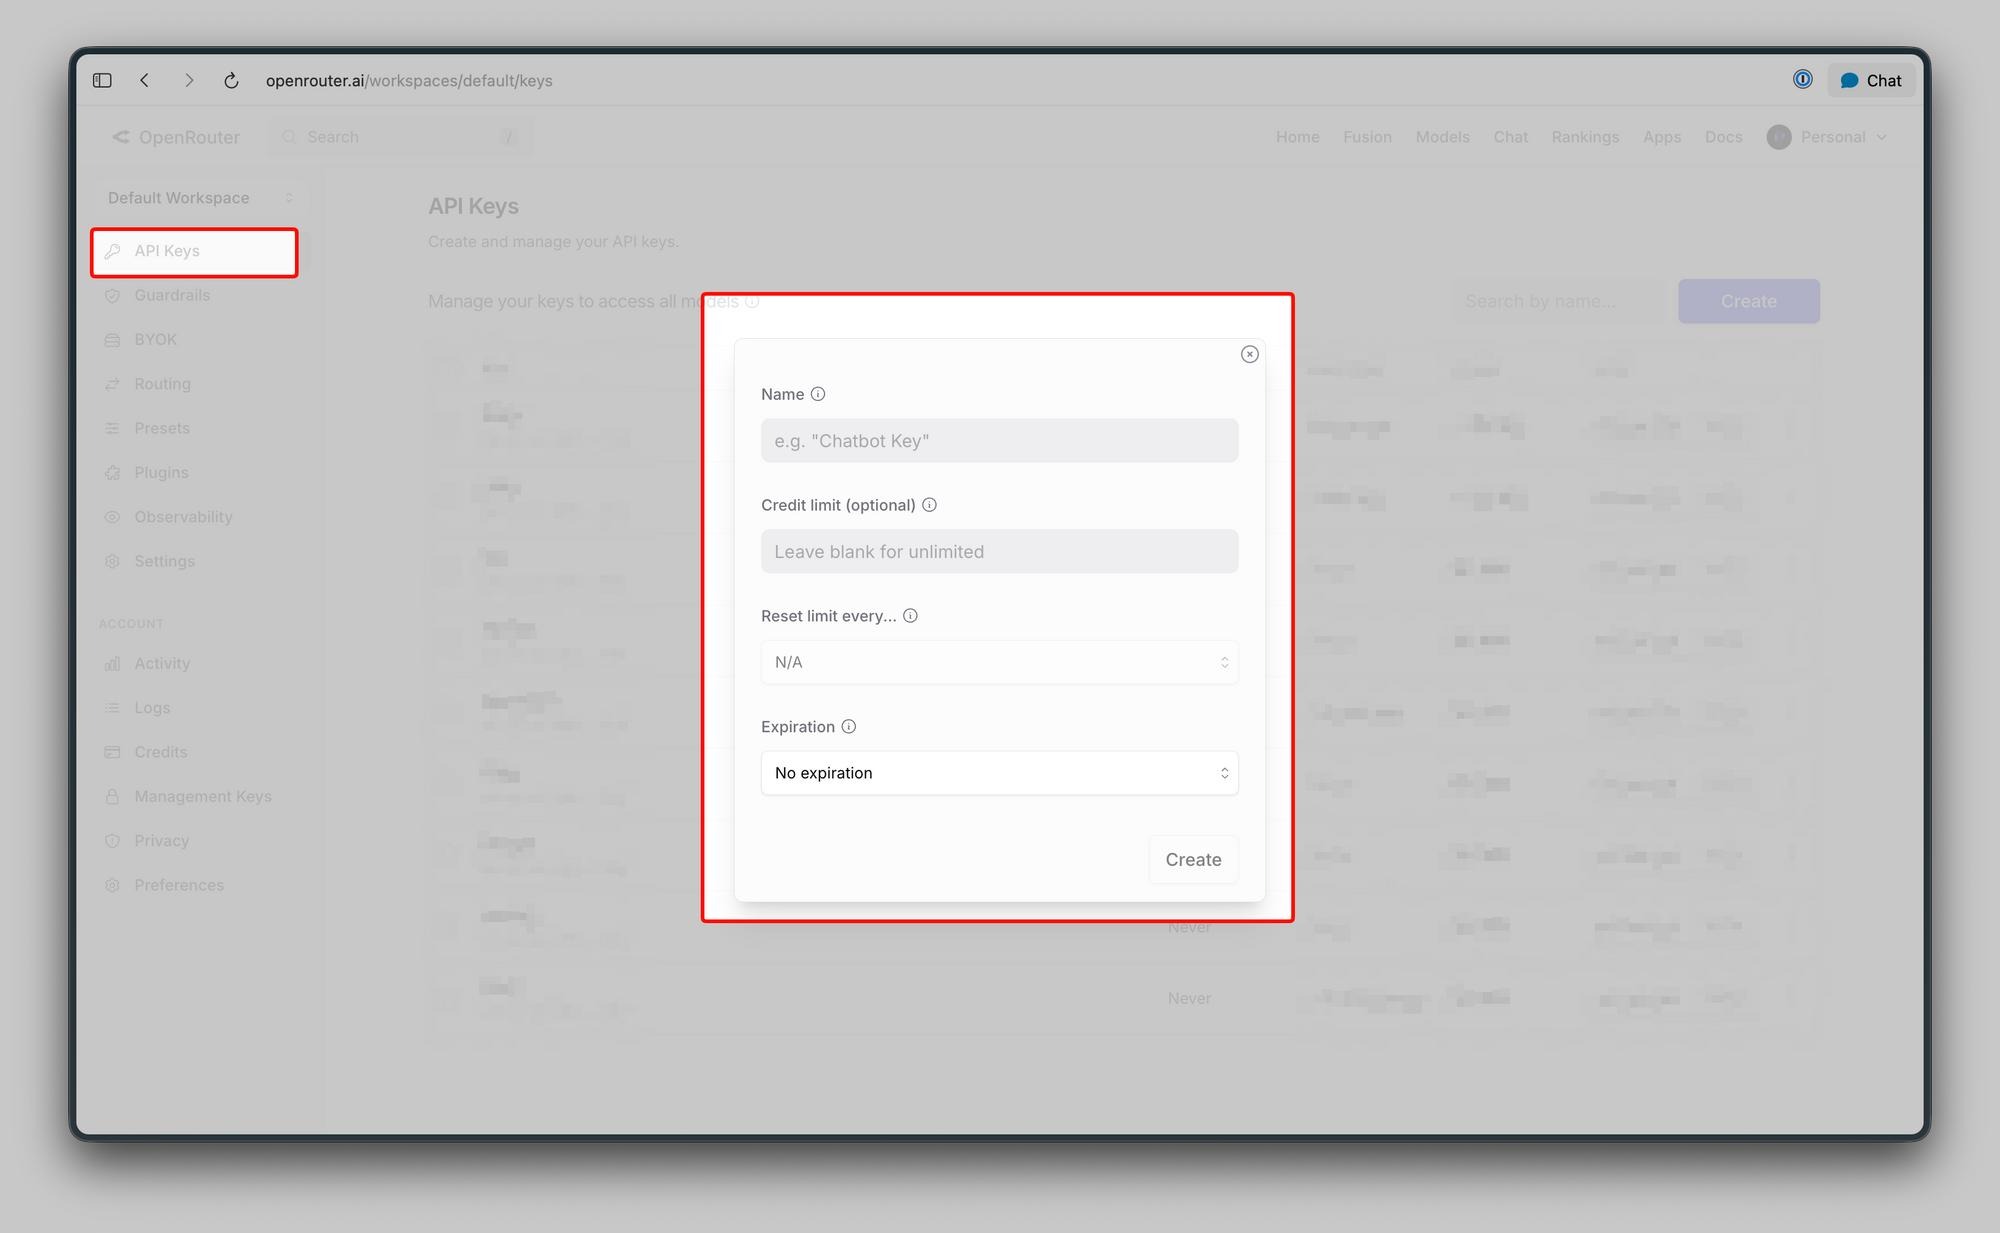
- 登录 OpenRouter 控制台,点击左侧菜单栏 “Keys”;
- 点击 “Create Key”,输入 Key 名称(如 “hy3-free-key”),无需设置权限(默认全开放);
- 点击 “Create”,生成sk-or-xxxxxx格式的 API Key,复制保存(仅显示一次);
- 无需充值、无需实名认证,直接可用,永久免费。
4.3 第三步:在线对话体验(无需代码)
- 访问 Hy3 Preview (Free) 专属页面:https://openrouter.ai/models/tencent/hy3-preview:free
- 点击页面右侧 “Chat”,进入在线对话界面;
- 输入问题(支持中文 / 英文),即可获得响应,默认think_low 平衡模式;
- 切换推理模式:输入指令 “使用 think_high 模式回答” 或 “使用 no_think 模式回答”,即可动态切换。
4.4 第四步:API 代码调用(Python/JavaScript 示例)
Hy3 Preview (Free) 兼容OpenAI API 格式,可直接用 OpenAI SDK 调用,无需额外适配,以下提供 Python 与 JavaScript 完整示例。
4.4.1 Python 调用示例(推荐)
# 安装依赖:pip install openai
from openai import OpenAI

# 初始化客户端(OpenRouter配置)
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="你的OpenRouter API Key"
)

# 1. 基础对话(默认think_low模式)
response = client.chat.completions.create(
    model="tencent/hy3-preview:free",
    messages=[
        {"role": "system", "content": "你是一个专业的AI助手,擅长深度推理和代码生成"},
        {"role": "user", "content": "解释什么是MoE架构,用通俗的语言说明"}
    ],
    temperature=0.7,  # 随机性:0-1,越低越稳定
    max_tokens=2048  # 最大输出token
)
print("基础对话响应:")
print(response.choices[0].message.content)

# 2. 深度推理(think_high模式)
response_high = client.chat.completions.create(
    model="tencent/hy3-preview:free",
    messages=[
        {"role": "user", "content": "证明:对于任意正整数n,n²+n+41都是质数"}
    ],
    temperature=0.3,
    max_tokens=4096,
    extra_body={"reasoning_mode": "think_high"}  # 指定深度推理模式
)
print("\n深度推理响应:")
print(response_high.choices[0].message.content)

# 3. 极速响应(no_think模式)
response_fast = client.chat.completions.create(
    model="tencent/hy3-preview:free",
    messages=[
        {"role": "user", "content": "快速回答:1+1等于几"}
    ],
    temperature=0.1,
    max_tokens=100,
    extra_body={"reasoning_mode": "no_think"}  # 指定极速模式
)
print("\n极速响应:")
print(response_fast.choices[0].message.content)
4.4.2 JavaScript 调用示例(Node.js)
// 安装依赖:npm install openai
const OpenAI = require('openai');

// 初始化客户端
const client = new OpenAI({
    baseURL: 'https://openrouter.ai/api/v1',
    apiKey: '你的OpenRouter API Key'
});

// 基础对话函数
async function chatWithHy3() {
    try {
        const response = await client.chat.completions.create({
            model: 'tencent/hy3-preview:free',
            messages: [
                { role: 'user', content: '用Python写一个快速排序算法' }
            ],
            temperature: 0.7,
            max_tokens: 2048
        });
        console.log('响应结果:');
        console.log(response.choices[0].message.content);
    } catch (error) {
        console.error('调用失败:', error);
    }
}

// 调用函数
chatWithHy3();
4.5 免费使用限制说明(无硬性限制)
OpenRouter 平台对 Hy3 Preview (Free) 的限制仅为基础速率限制(防止恶意刷量),具体如下:
- 调用频率:约 10 次 / 分钟,足够开发、测试、原型验证;
- 上下文长度:免费版支持64K token(完整版 256K),日常使用足够;
- 推理模式:免费版支持全部三档模式(no_think/think_low/think_high),无阉割;
- 永久免费:无试用期限、无隐藏付费门槛,官方承诺长期维护免费端点。
五、实战案例:四大场景深度应用 Hy3 Preview (Free)
5.1 案例一:深度数学推理(think_high 模式)
需求:解决高中数学导数压轴题,要求详细步骤 + 思路解析。提示词:
使用think_high模式,详细解答以下数学题,写出每一步推导过程和思路:
已知函数f(x)=x³-3ax²+3x+1在区间(2,3)上单调递增,求实数a的取值范围
输出核心亮点:
- 精准求导:f’(x)=3x²-6ax+3;
- 单调递增条件:f’(x)≥0 在 (2,3) 上恒成立;
- 分离参数:a≤(x²+1)/(2x) 在 (2,3) 上恒成立;
- 构造函数求最值:令 g (x)=(x²+1)/(2x),求导得 g (x) 在 (2,3) 上单调递增;
- 最终结果:a≤5/4,步骤完整、逻辑严谨,媲美数学老师手写解析。
5.2 案例二:长代码仓理解(256K 上下文)
需求:分析一个 5000 行 Python 项目的代码结构,找出潜在 bug 并给出优化建议。提示词:
以下是某Python项目的完整代码(共5000行,已粘贴),请用256K上下文理解,完成:
1. 梳理项目整体结构,说明各模块功能;
2. 找出代码中的潜在bug(如逻辑错误、内存泄漏、异常处理缺失);
3. 给出具体优化建议(代码精简、性能提升、可读性优化)
输出核心亮点:
- 一次性解析 5000 行代码,精准划分模块职责;
- 定位 3 个关键 bug:循环嵌套导致的时间复杂度 O (n³)、文件未关闭导致的内存泄漏、参数校验缺失导致的崩溃风险;
- 给出可直接落地的优化方案:改用字典查找降复杂度、with 语句管理文件、增加参数校验装饰器,专业度接近资深 Python 工程师。
5.3 案例三:Agent 自动化工作流(think_low+think_high 组合)
需求:自动完成 “需求分析→代码编写→单元测试→文档生成” 全链路 Agent 任务。提示词:
作为Agent,按以下步骤完成任务,每步输出结果并自动衔接:
1. 需求分析:设计一个待办事项管理系统(命令行版),明确功能模块;
2. 代码编写:用Python实现系统代码,包含增删改查功能;
3. 单元测试:编写pytest测试用例,覆盖核心功能;
4. 文档生成:生成README.md文档,说明安装、使用方法
输出核心亮点:
- 495 步无中断执行,全程自动衔接;
- 需求分析全面:覆盖用户管理、任务 CRUD、数据持久化;
- 代码规范可运行:基于 SQLite 存储,代码结构清晰、注释完整;
- 测试用例全覆盖:10 + 测试用例,验证正常场景 + 异常场景;
- 文档专业:包含安装命令、使用示例、功能截图说明,可直接开源发布。
5.4 案例四:极速内容创作(no_think 模式)
需求:快速生成 10 条短视频文案(美食类,15 秒),要求简短、有吸引力、口语化。提示词:
使用no_think模式,快速生成10条美食短视频文案(15秒),要求:
- 风格:口语化、接地气、有食欲;
- 时长:15秒内,每条20-30字;
- 内容:家常菜、简单易做、突出美味
输出核心亮点:
- 1 秒内输出 10 条文案,响应极速;
- 风格统一:口语化强,如 “懒人版红烧肉,软烂入味,一口下去太满足了!”;
- 符合短视频逻辑:开头抓眼球、中间讲做法、结尾引导点赞,可直接拍摄使用。
六、自托管部署方案:免费开源权重私有化部署
6.1 开源权重获取(免费)
Hy3 Preview 权重同步开源至四大平台,可免费下载,遵循腾讯混元社区许可协议:
- GitHub:https://github.com/Tencent/Hy3-preview
- Hugging Face:https://huggingface.co/tencent/hy3-preview
- ModelScope:https://modelscope.cn/models/tencent/hy3-preview
- GitCode:https://gitcode.com/tencent/hy3-preview
6.2 硬件要求(295B MoE 模型)
自托管 295B 参数 Hy3 Preview 对硬件要求较高,推荐配置:
- GPU:8×A100 80GB / 8×H100 80GB(多卡并行,支持 MoE 分布式推理);
- CPU:64 核 +(数据预处理、推理调度);
- 内存:512GB+(模型权重加载、中间数据存储);
- 存储:2TB+ NVMe SSD(权重文件约 600GB,BF16 精度)。
6.3 推理框架选择(vLLM/SGLang)
Hy3 Preview 支持主流高性能推理框架,推荐:
- vLLM:高吞吐、低延迟,支持 PagedAttention,适配长上下文推理,优先推荐;
- SGLang:兼容 MoE 架构,支持动态专家调度,推理效率接近 vLLM。
6.4 部署步骤(vLLM 示例)
- 环境准备:安装 CUDA 12.1、cuDNN 8.9、Python 3.10;
- 安装依赖:
pip install vllm transformers accelerate - 下载权重:从 Hugging Face 下载 tencent/hy3-preview 权重至本地;
- 启动推理服务:
python -m vllm.entrypoints.openai.api_server \ --model ./hy3-preview \ --tensor-parallel-size 8 \ --moe-expert-parallel-size 2 \ --max-model-len 256000 \ --dtype bf16 \ --api-key "your-local-key" - 本地调用:兼容 OpenAI 格式,base_url 改为http://localhost:8000/v1,即可本地私有化调用。
七、行业影响与价值:免费顶级模型重塑 AI 生态
7.1 对开发者:零成本解锁顶级 AI 能力
Hy3 Preview (Free) 的免费开放,让个人开发者、学生、初创团队零成本使用 295B 参数顶级大模型,无需高额算力投入、无需付费 API,可用于:
- 学习研究:大模型原理学习、推理能力对比、算法创新验证;
- 原型开发:AI 工具、Agent 应用、代码助手、内容生成工具的快速原型;
- 个人项目:开源项目增强、博客 AI 助手、个人知识库、自动化脚本开发。
7.2 对企业:降本增效,加速 AI 落地
- 中小企业:无需自研大模型,直接用免费 API 搭建客服机器人、内容审核、文档分析工具,零 AI 成本;
- 大型企业:可基于开源权重私有化部署,数据不出境,适配金融、医疗、政务等敏感场景,同时降低采购成本;
- 行业应用:教育(AI 助教、解题工具)、医疗(病历分析、诊断辅助)、法律(合同审查、文书生成)、研发(代码生成、测试自动化)等领域快速落地 AI 应用。
7.3 对行业:打破垄断,推动技术普惠
此前,200B + 参数顶级大模型(如 GPT-4、Claude 3)均由海外巨头垄断,且 API 调用价格高昂(GPT-4 约$0.06/千输入token、$0.12 / 千输出 token),国内开发者与企业使用成本高、数据安全风险大。
腾讯 Hy3 Preview (Free) 的免费开源,打破海外技术垄断,树立 “顶级模型免费化” 新标杆,推动全球 AI 技术普惠,加速国内大模型生态成熟,助力中国 AI 产业高质量发展。
八、总结与展望:免费大模型时代已来
Hy3 Preview (Free) 作为腾讯混元技术普惠的里程碑之作,以295B MoE 架构、256K 超长上下文、三档推理模式、永久免费 API四大核心优势,成为当前 “免费大模型天花板”,在深度推理、代码生成、Agent 任务、长文本理解等领域性能比肩国际顶尖模型,零成本开放给全球开发者,彻底降低大模型使用门槛。
从技术角度看,Hy3 Preview 验证了 “MoE 架构 + 高效推理” 的可行性,为后续超大规模模型研发提供参考;从行业角度看,免费开放策略打破海外垄断,推动技术普惠,加速 AI 在各行业的落地应用;从生态角度看,开源权重 + 免费 API 的双模式,将吸引全球开发者参与模型优化、应用创新,构建繁荣的国产大模型生态。
未来,随着腾讯基础设施持续迭代,Hy3 系列模型将在能力、速度、稳定性上持续升级,同时有望开放更多免费模型,让 AI 真正成为普惠技术,赋能千行百业。
互动福利(必看)
✨ 以上就是腾讯 Hy3 Preview (Free) 的全维度解析,从架构原理、性能实测到免费使用、实战案例、私有化部署,帮你一站式掌握这款免费顶级大模型的核心用法!
💡 觉得文章有用的话,点赞 + 收藏 + 关注三连走一波!👉 点赞:鼓励作者创作更多硬核 AI 干货;👉 收藏:方便后续快速查阅 Hy3 使用教程;👉 关注:持续获取腾讯混元、开源大模型、AI 实战技巧等最新内容,第一时间解锁免费 AI 工具!
 2577


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


