


我们的要求是要在一堆给定的文本文件中统计输出每一个单词出现的总数。
首先我使用的是IntelliJ IDEA Community软件进行文件的写入。具体的文件我放在百度网盘中了。
链接:https://pan.baidu.com/s/1M1sHjHcb2M1ClmgzzkVHiQ
提取码:cqjy
然后按照接下来的步骤进行安装就可以啦:
首先解压到当前文件夹,如图:
然后选择>>IntelliJ IDEA Community Edition 2021.2.3 >>bin >>idea43.exe,双击文件打开就可以了。

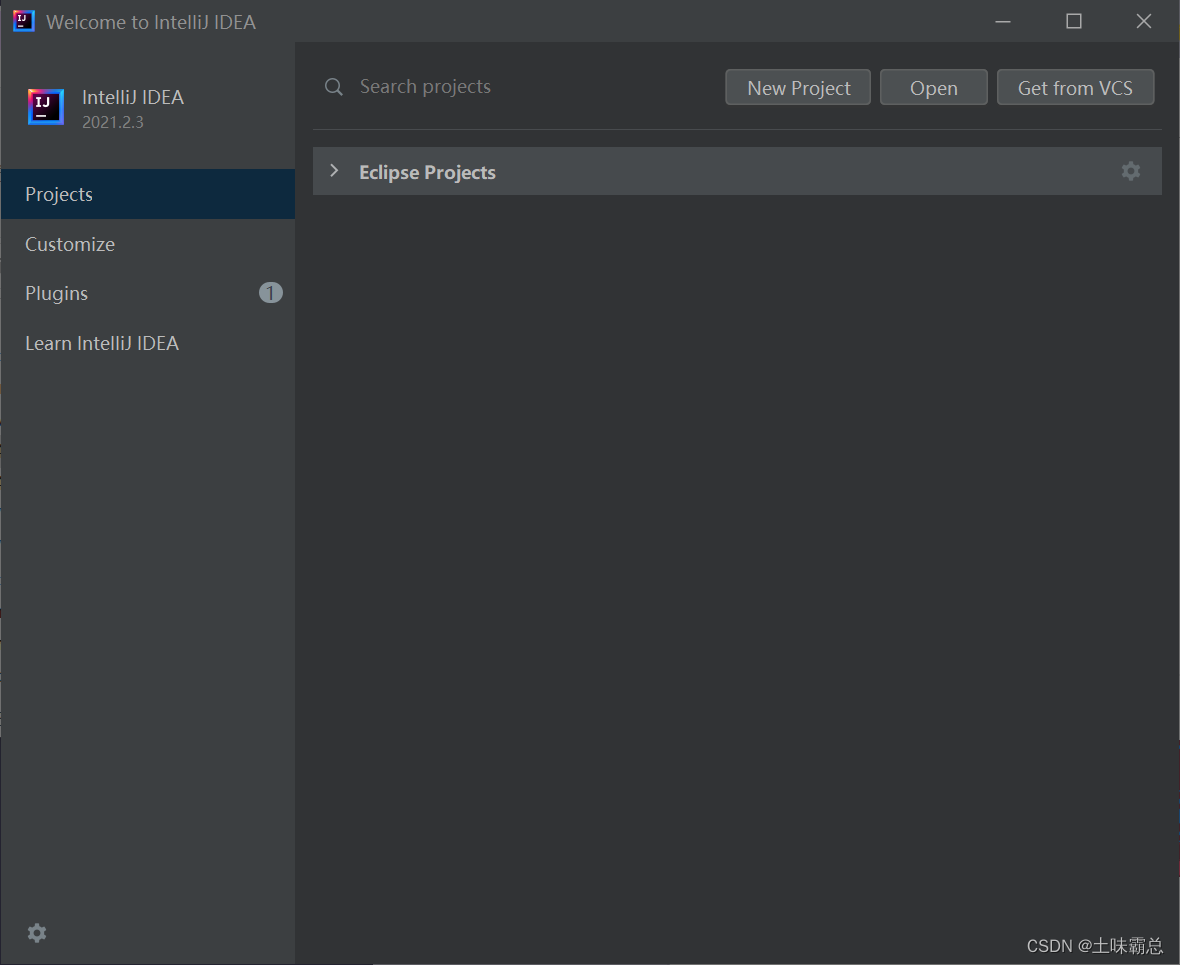
不用安装即可运行,就是下面的页面:

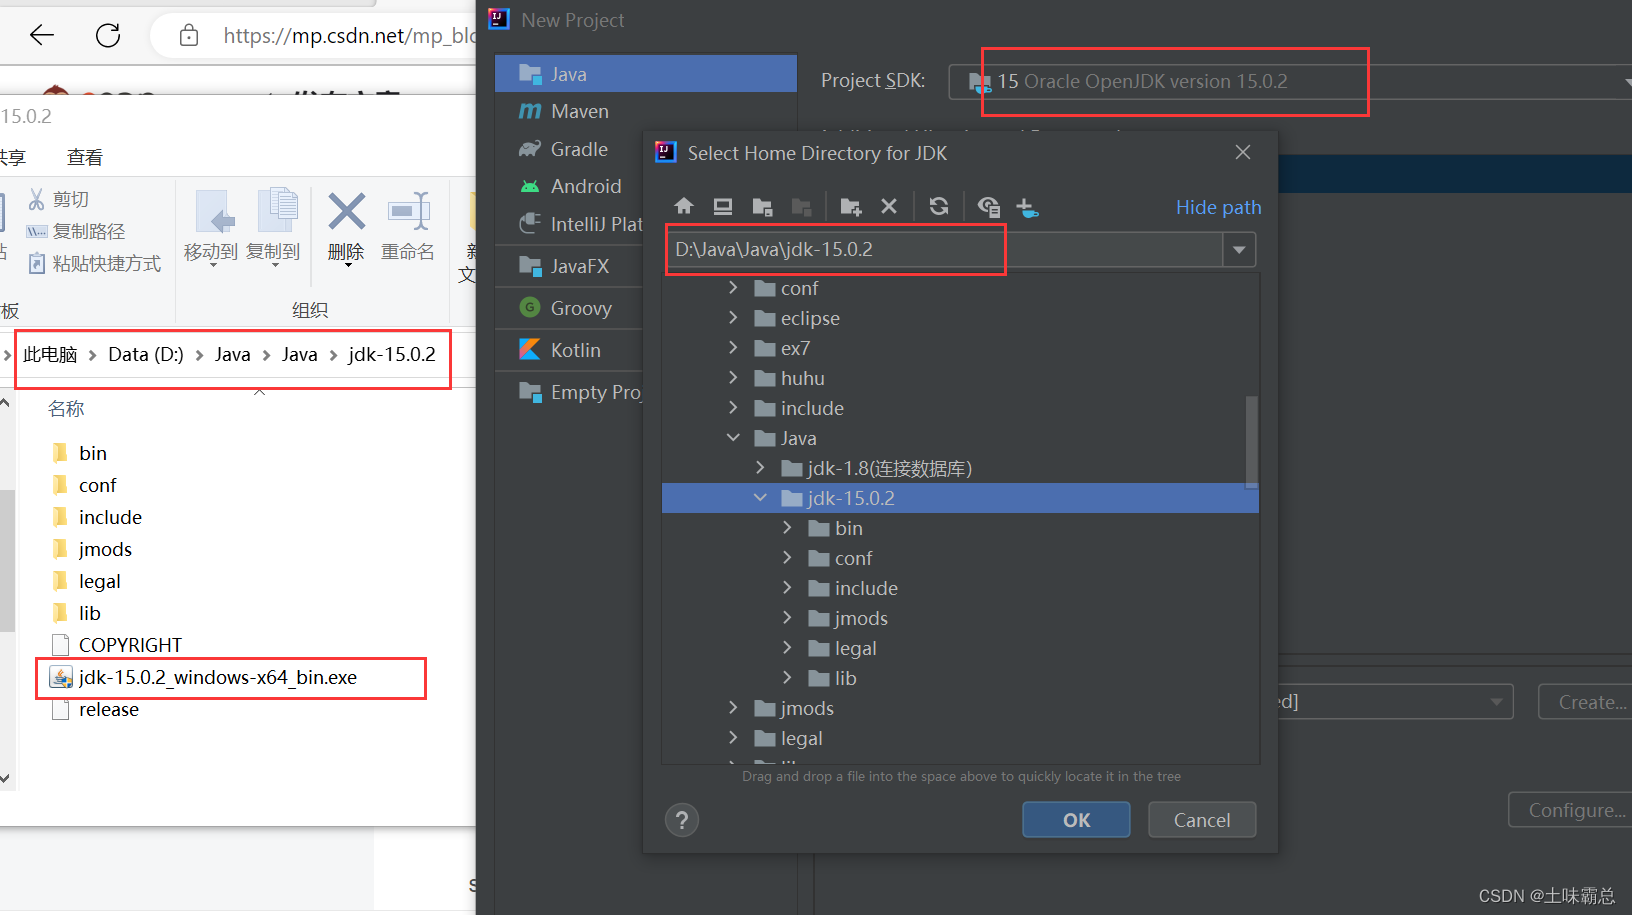
在新建项目时要选择jdk,我用的是我之前的软件eclipse所使用的jdk-15.0.2:
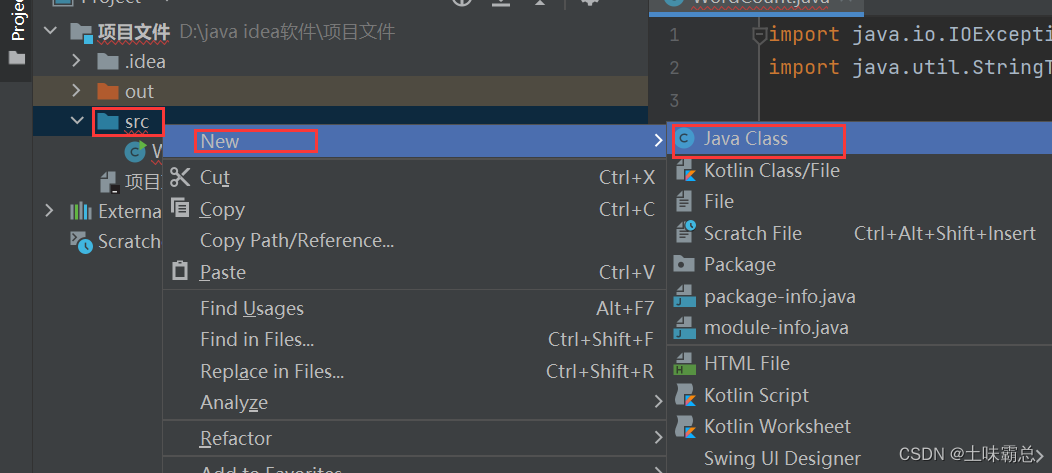
然后直接在src下面新建class文件,不需要先建立包:
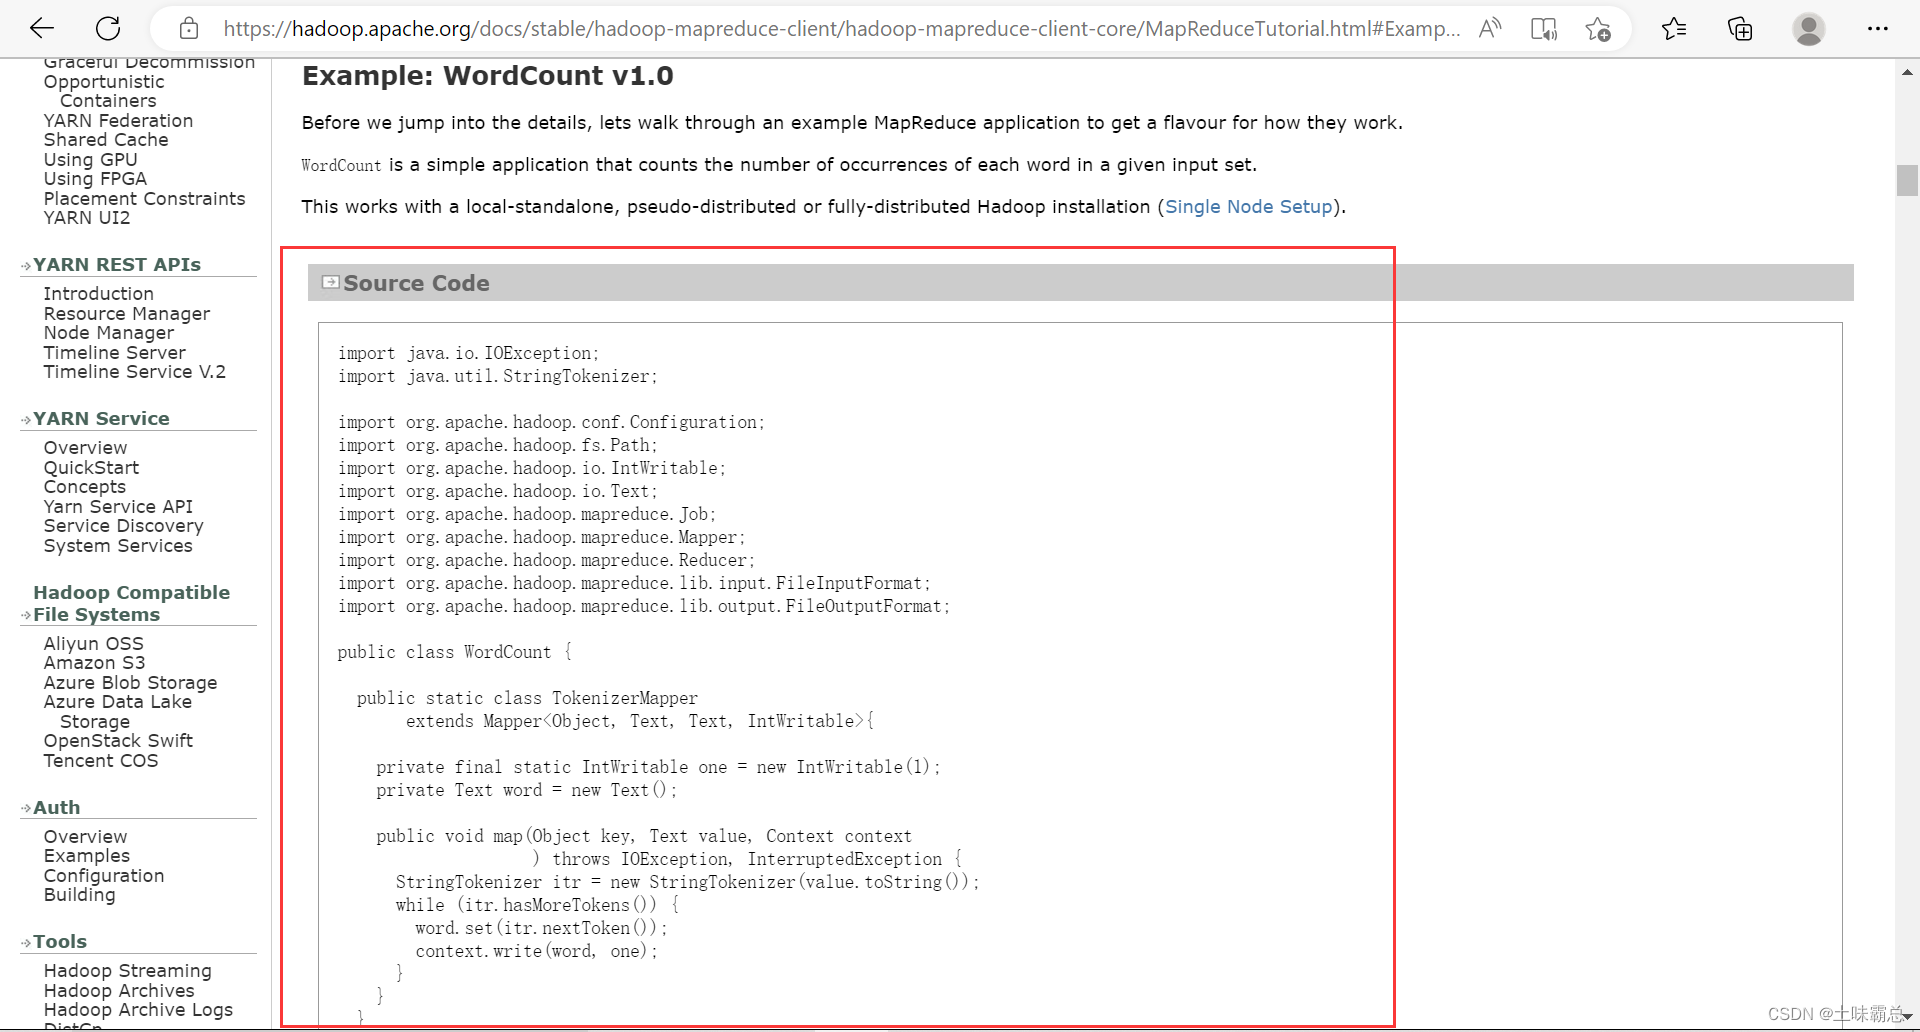
我的文件名叫做WordCount,然后他的代码是我从官网复制过来的,直接粘贴进文件里面就好:
import java.io.IOException;
import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCount {

  public static class TokenizerMapper
       extends Mapper<Object, Text, Text, IntWritable>{

    private final static IntWritable one = new IntWritable(1);
    private Text word = new Text();

    public void map(Object key, Text value, Context context
                    ) throws IOException, InterruptedException {
      StringTokenizer itr = new StringTokenizer(value.toString());
      while (itr.hasMoreTokens()) {
        word.set(itr.nextToken());
        context.write(word, one);
      }
    }
  }

  public static class IntSumReducer
       extends Reducer<Text,IntWritable,Text,IntWritable> {
    private IntWritable result = new IntWritable();

    public void reduce(Text key, Iterable<IntWritable> values,
                       Context context
                       ) throws IOException, InterruptedException {
      int sum = 0;
      for (IntWritable val : values) {
        sum += val.get();
      }
      result.set(sum);
      context.write(key, result);
    }
  }

  public static void main(String[] args) throws Exception {
    Configuration conf = new Configuration();
    Job job = Job.getInstance(conf, "word count");
    job.setJarByClass(WordCount.class);
    job.setMapperClass(TokenizerMapper.class);
    job.setCombinerClass(IntSumReducer.class);
    job.setReducerClass(IntSumReducer.class);
    job.setOutputKeyClass(Text.class);
    job.setOutputValueClass(IntWritable.class);
    FileInputFormat.addInputPath(job, new Path(args[0]));
    FileOutputFormat.setOutputPath(job, new Path(args[1]));
    System.exit(job.waitForCompletion(true) ? 0 : 1);
  }
}
我们发现他要报错,这是正常情况,因为在windows系统里没有Hadoop,这里报错不用管: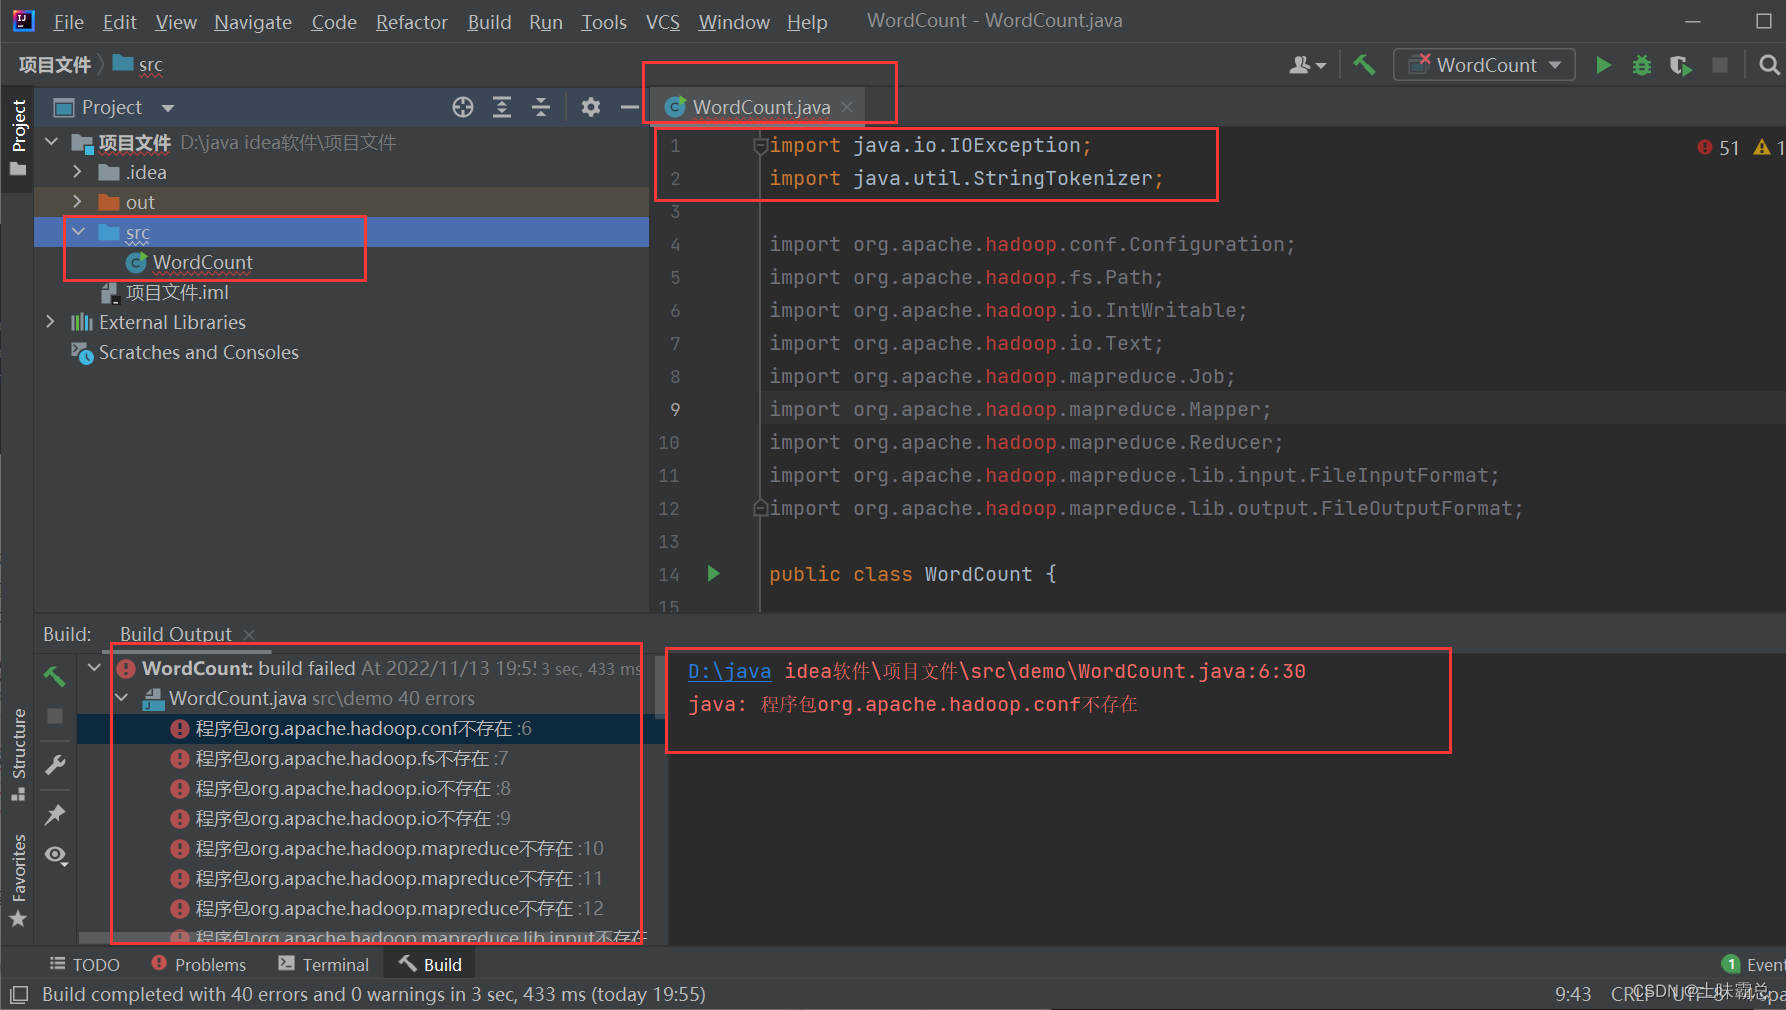
这是官网的地址,大家也可以选择自己自行复制:
Apache Hadoop 3.3.4 – MapReduce Tutorial
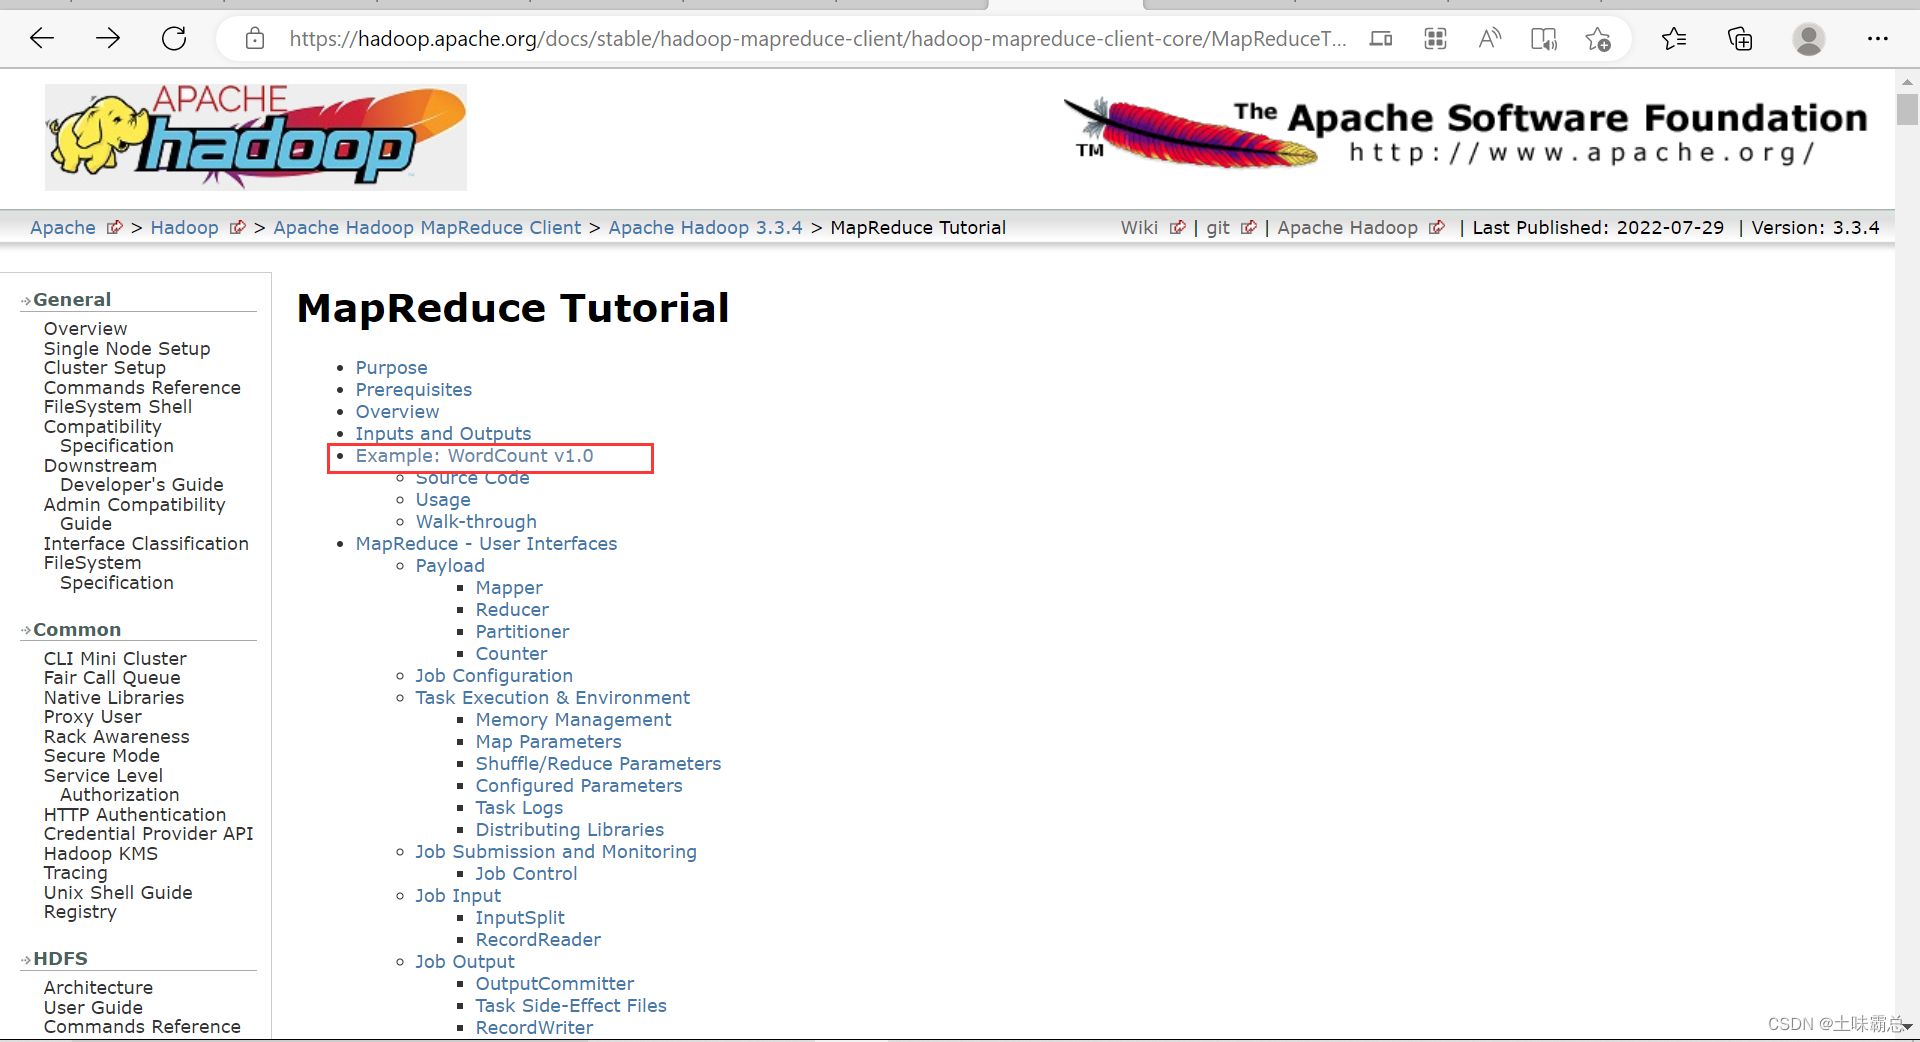
然后我们就可以发现在对应的目录下面就可以看见该文件了,使用xftp把他传到虚拟机master中,不同的电脑java文件的图标不同,我的图标就是记事本的图标,有些人的文件图标是IJ软件的图标,关系不大的:

接下来就开始步入正题,进行单词的数量统计。
在进行下面的操作之前要使用命令打开hadoop集群,不然执行相关命令会报错。
cd /opt/hadoop-3.1.4/sbin
./start-dfs.sh
./start-yarn.sh
./mr-jobhistory-daemon.sh start historyserver
jps 然后记得使用cd命令进入主目录,不然会报错:

使用xftp上传这个文件到虚拟机的master主节点里面,用命令ls查看是否上传成功。
 然后在根目录创建一个wc00的文件夹,再将刚才上传的文件移动到文件夹wc00中:

接下来进行环境变量的配置,将Hadoop的classpath信息添加到CLASSPATH变量中。
先使用vi命令进入profile文件中,然后在文件的最下面添加如下命令:
vi /etc/profileexport CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath):$CLASSPAH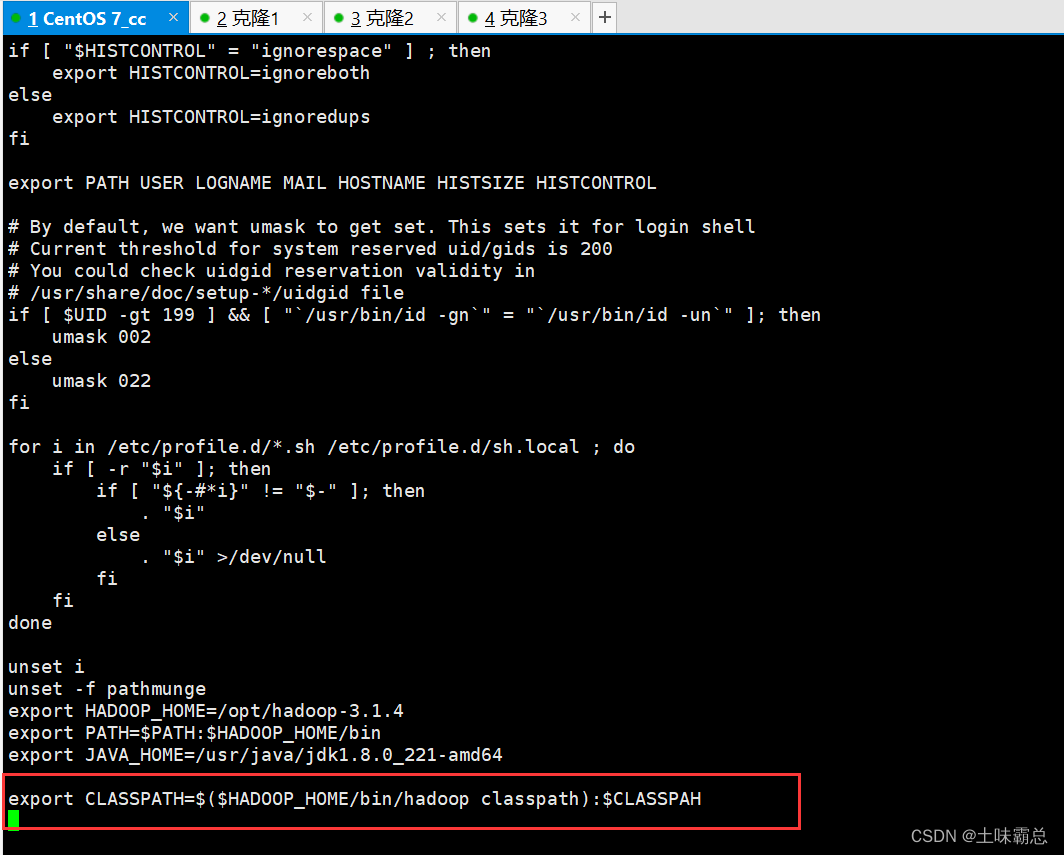 然后保存退出即可。
在修改配置了该文件之后,一定要使用source命令对文件进行更新操作:
source /etc/profile然后用javac对源代码进行编译,生成他的字节码文件 :
javac WordCount.java然后使用命令ls查看生成的字节码文件:

然后使用命令对文件进行打包,并使用命令ls查看生成的jar包:
jar -cvf WordCount.jar ./WordCount*.class
然后使用touch创建一个对WordCount进行处理的文件,并用vi向文件中写入一些文字:
touch file001.txt
vi file001.txt
下面的内容就是我向文件file001中写入的内容,内容是可以自定义的。

然后配置classpath的操作就是这样了:

使用命令hadoop classpath查看配置的环境变量信息:

下一步将进行yarn-site.xml的配置:
使用命令进入要陪是的文件及文件目录:
vi /opt/hadoop-3.1.4/etc/hadoop/yarn-site.xml向里面最后的位置添加如下文字:
<property>

    <name>yarn.application.classpath</name>

    <value>

/opt/hadoop-3.1.4/etc/hadoop:/opt/hadoop-3.1.4/share/hadoop/common/lib/*:/opt/hadoop-3.1.4/share/hadoop/common/*:/opt/hadoop-3.1.4/share/hadoop/hdfs:/opt/hadoop-3.1.4/share/hadoop/hdfs/lib/*:/opt/hadoop-3.1.4/share/hadoop/hdfs/*:/opt/hadoop-3.1.4/share/hadoop/mapreduce/lib/*:/opt/hadoop-3.1.4/share/hadoop/mapreduce/*:/opt/hadoop-3.1.4/share/hadoop/yarn:/opt/hadoop-3.1.4/share/hadoop/yarn/lib/*:/opt/hadoop-3.1.4/share/hadoop/yarn/*

     </value>

</property>
配置成功之后启动集群,上传文件到集群,使用如下命令:
cd /opt/hadoop-3.1.4/sbin
./start-dfs.sh
./start-yarn.sh
./mr-jobhistory-daemon.sh start historyserver
hdfs dfs -mkdir /output2
cd ~/wc00
ls
hdfs dfs -put file001.txt /output2
上传文件成功之后运行jar包:
hadoop jar WordCount.jar WordCount /output2 /results 最后,可以在网页中看到我们运行的结果:


按照顺序依次点击就发现以及统计了每个单词出现的次数:






 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


