


位置编码和RoPE旋转位置编码,torch.nn.functional.embedding
文章目录
2. 位置编码和RoPE旋转位置编码
2.1 绝对位置编码
https://blog.csdn.net/v_JULY_v/article/details/134085503
位置编码:
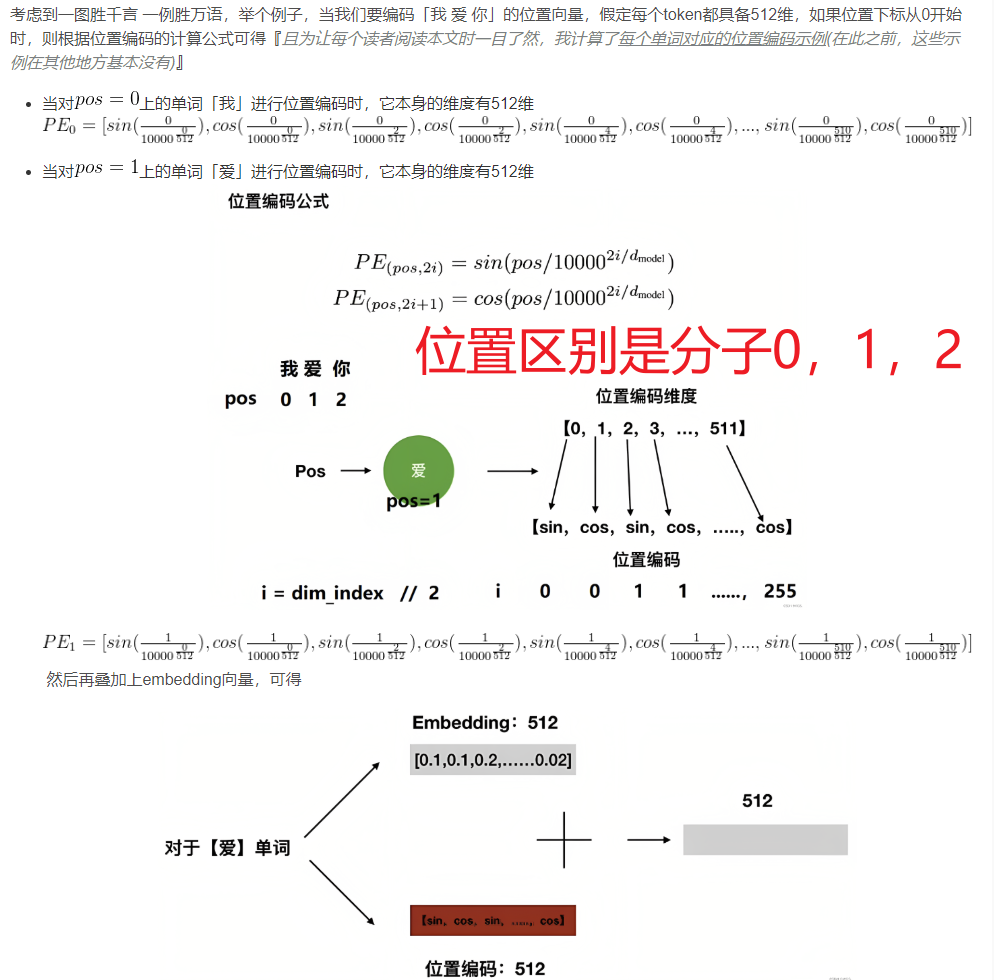
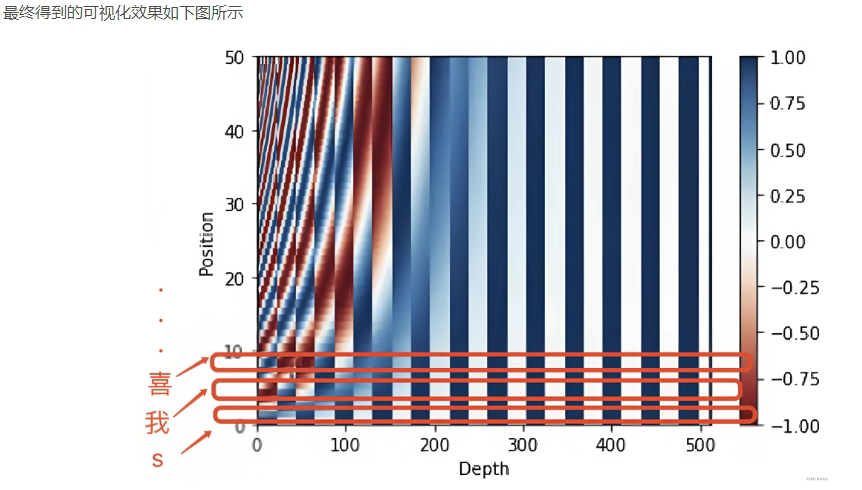
图中每一行是一个位置的编码,编码的长度等于特征的长度512
位置编码代码:就是每个位置得到一个向量,直接加在特征上。
为什么要这么编码呢?
下面代码输入输出shape都是: batch, seq_len, dim
"""位置编码的实现,调用父类nn.Module的构造函数"""
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, dropout, max_len=5000):
        super(PositionalEncoding, self).__init__()
        self.dropout = nn.Dropout(p=dropout)  # 初始化dropout层

        # 计算位置编码并将其存储在pe张量中
        pe = torch.zeros(max_len, d_model)                # 创建一个max_len x d_model的全零张量
        position = torch.arange(0, max_len).unsqueeze(1)  # 生成0到max_len-1的整数序列,并添加一个维度
        # 计算div_term,用于缩放不同位置的正弦和余弦函数
        div_term = torch.exp(torch.arange(0, d_model, 2) *
                             -(math.log(10000.0) / d_model))

        # 使用正弦和余弦函数生成位置编码,对于d_model的偶数索引,使用正弦函数;对于奇数索引,使用余弦函数。
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        pe = pe.unsqueeze(0)                  # 在第一个维度添加一个维度,以便进行批处理
        self.register_buffer('pe', pe)        # 将位置编码张量注册为缓冲区,以便在不同设备之间传输模型时保持其状态

    # 定义前向传播函数
    def forward(self, x):
        # 将输入x与对应的位置编码相加
        x = x + Variable(self.pe[:, :x.size(1)],
                         requires_grad=False)
        # 应用dropout层并返回结果
        return self.dropout(x)
优势: 实现简单,可预先计算好,不用参与训练,速度快。
劣势: 没有外推性,即如果预训练最大长度为512的话,那么最多就只能处理长度为512的句子,再长就处理不了了。当然,也可以将超过512的位置向量随机初始化,然后继续微调。
2.2 RoPE
RoPE通过绝对位置编码的方式实现相对位置编码,综合了绝对位置编码和相对位置编码的优点。RoPE 代表了一种编码位置信息的新方法。传统方法中无论是绝对方法还是相对方法,都有其局限性。绝对位置编码为每个位置分配一个唯一的向量,虽然简单但不能很好地扩展并且无法有效捕获相对位置;相对位置编码关注标记之间的距离,增强模型对标记关系的理解,但使模型架构复杂化。
RoPE巧妙地结合了两者的优点。允许模型理解标记的绝对位置及其相对距离的方式对位置信息进行编码。这是通过旋转机制实现的,其中序列中的每个位置都由嵌入空间中的旋转表示。RoPE 的优雅之处在于其简单性和高效性,这使得模型能够更好地掌握语言语法和语义的细微差别。
主要就是对attention中的q, k向量注入了绝对位置信息,然后用更新的q,k向量做attention中的内积就会引入相对位置信息了。
https://blog.csdn.net/weixin_43646592/article/details/130924280 这篇博客里面的代码写的比较清晰
1)第m个位置的q,第n个位置的k经过某个变换f之后,两者相乘得到的attention包含相对位置信息
如公式2,得到的attention(g)可以分解出m-n
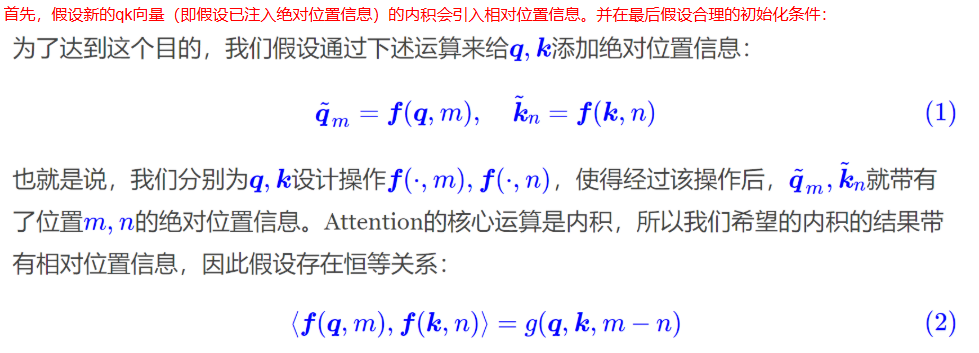
2)其实利用旋转是可以达到公式2的要求的。
因此:如下图,Rm是第m位置的编码矩阵
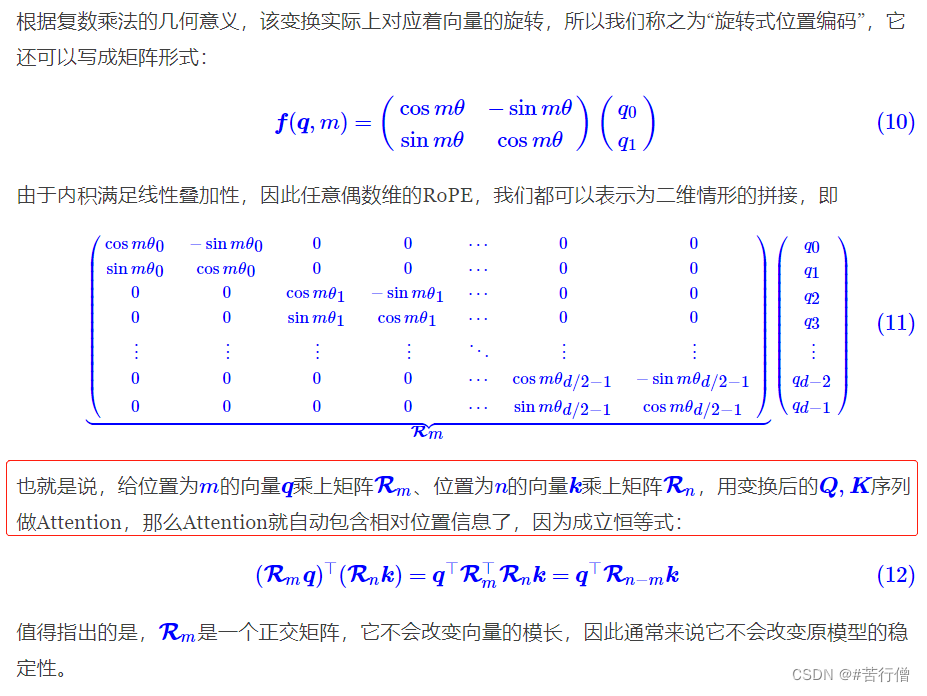
3)再度简化后:得到公式13
还记得 绝对位置的编码是什么吗?绝对位置编码就是对每个位置编码一个位置相关的向量 ,然后加到原来的特征上。也就是直接相加
这里变成了下图:相乘后相加
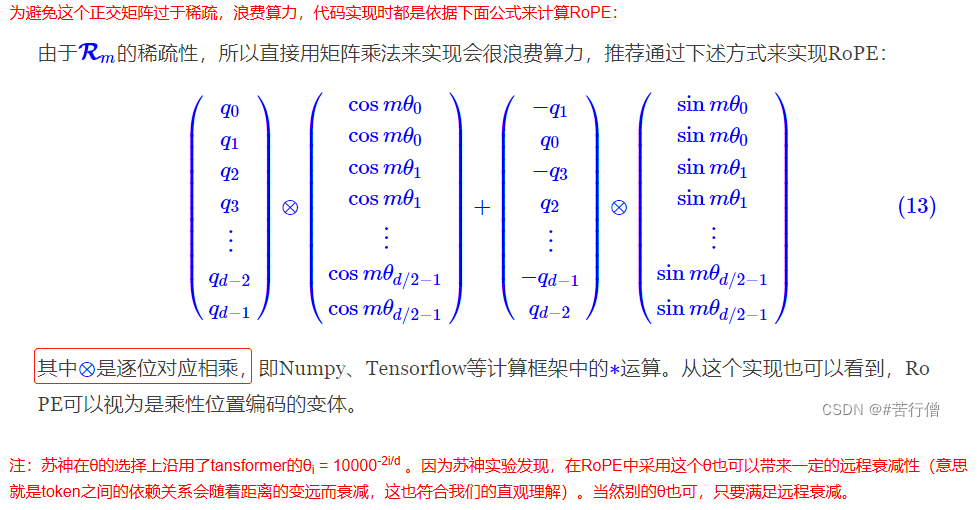
4)具体代码如下
RoPE中首先是绝对位置编码,然后对q,k进行编码
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

# %%

def sinusoidal_position_embedding(batch_size, nums_head, max_len, output_dim, device):
    # (max_len, 1)
    position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(-1)
    # (output_dim//2)
    ids = torch.arange(0, output_dim // 2, dtype=torch.float)  # 即公式里的i, i的范围是 [0,d/2]
    theta = torch.pow(10000, -2 * ids / output_dim)

    # (max_len, output_dim//2)
    embeddings = position * theta  # 即公式里的:pos / (10000^(2i/d))

    # (max_len, output_dim//2, 2)
    embeddings = torch.stack([torch.sin(embeddings), torch.cos(embeddings)], dim=-1)

    # (bs, head, max_len, output_dim//2, 2)
    embeddings = embeddings.repeat((batch_size, nums_head, *([1] * len(embeddings.shape))))  # 在bs维度重复,其他维度都是1不重复

    # (bs, head, max_len, output_dim)
    # reshape后就是:偶数sin, 奇数cos了
    embeddings = torch.reshape(embeddings, (batch_size, nums_head, max_len, output_dim))
    embeddings = embeddings.to(device)
    return embeddings


# %%

def RoPE(q, k):
    # q,k: (bs, head, max_len, output_dim)
    batch_size = q.shape[0]
    nums_head = q.shape[1]
    max_len = q.shape[2]
    output_dim = q.shape[-1]

    # (bs, head, max_len, output_dim)
    pos_emb = sinusoidal_position_embedding(batch_size, nums_head, max_len, output_dim, q.device)


    # cos_pos,sin_pos: (bs, head, max_len, output_dim)
    # 看rope公式可知,相邻cos,sin之间是相同的,所以复制一遍。如(1,2,3)变成(1,1,2,2,3,3)
    cos_pos = pos_emb[...,  1::2].repeat_interleave(2, dim=-1)  # 将奇数列信息抽取出来也就是cos 拿出来并复制
    sin_pos = pos_emb[..., ::2].repeat_interleave(2, dim=-1)  # 将偶数列信息抽取出来也就是sin 拿出来并复制

    # q,k: (bs, head, max_len, output_dim)
    q2 = torch.stack([-q[..., 1::2], q[..., ::2]], dim=-1)
    q2 = q2.reshape(q.shape)  # reshape后就是正负交替了


    # 更新qw, *对应位置相乘
    q = q * cos_pos + q2 * sin_pos

    k2 = torch.stack([-k[..., 1::2], k[..., ::2]], dim=-1)
    k2 = k2.reshape(k.shape)
    # 更新kw, *对应位置相乘
    k = k * cos_pos + k2 * sin_pos

    return q, k
https://cloud.tencent.com/developer/article/2403895 这篇博客中的RoPE给了另一个角度
2.3 图像视觉领域的绝对位置编码
2.1小节是 batch, seqlen, dim 用于自然语言处理
对于图像视觉领域对图像划分了patch,编码每个patch的位置
input:bchw
output:b2hw
来源:https://github.com/MCG-NJU/SGM-VFI/blob/main/model/position.py
import torch
import torch.nn as nn
import math


class PositionEmbeddingSine(nn.Module):
    """
    This is a more standard version of the position embedding, very similar to the one
    used by the Attention is all you need paper, generalized to wo

 667


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


