


Linux krpobe调试技术是内核开发者专门为了编译跟踪内核函数执行状态所涉及的一种轻量级内核调试技术,利用kprobe技术,内核开发人员可以在内核的绝大多数指定函数中动态插入探测点来收集所需的调试状态信息而基本不影响内核原有的执行流程。本章的是基于5.15内核来学习kprobe的相关内容,主要包括以下内容
- kprobe技术产生的背景
- 主要针对ARM64 kpobes的技术实现原理,实现方式
- 对于ftrace中的kprobe是如何实现的
- kpobe可以做什么,可以解决哪些问题
1 kprobe技术背景
对于开发者,我们在内核或者模块的调试过程中,往往需要知道一些函数的执行流程,何时被调用,执行过程中的入参和返回值是什么等等,比较简单的做法就是在内核代码对应的位置添加日志信息,但是这种方式往往需要重新编译内核或者模块,烧写或者替换模块,操作较为复杂甚至可能会破坏原有的代码执行过程。
所以针对这种情况,内核提供了一种调试机制kprobe,提供了一种方法,能够在不修改现有代码的基础上,灵活的跟踪内核函数的执行。
它的基本工作原理是:用户指定一个探测点,并把一个用户定义的处理函数关联到该探测点,当内核执行到该探测点时,相应的关联函数被执行,然后继续执行正常的代码路径。
kprobe 是一种动态调试机制,用于debugging,动态跟踪,性能分析,动态修改内核行为等,2004年由IBM发布,是名为Dprobes工具集的底层实现机制[1][2],2005年合入Linux kernel。probe的含义是像一个探针,可以不修改分析对象源码的情况下,获取Kernel的运行时信息。kprobe一直在X86系统上使用,ARM64的平台支持在2015年合入kernel [8],kprobe提供了三种形式的探测点,
- 一种最基本的kprobe:能够在指定代码执行前,执行后进行探测,但此时不能访问被探测函数内的相关变量信息,内核代码的任何指令处
- 一种是jprobe:用于探测某一个函数的入口,并且能够访问对应的函数参数,这个目前已经不再使用
- 一种是kretprobe:用于完成指定函数返回值的探测功能,内核函数的退出点
其中最基本的就是kprobe机制,jprobe以及kretprobe的实现都依赖于kprobe,kprobe是linux内核的一个重要的特性,是其他内核调试工具(perf,systemtap)的基础设施,同时内核BPF也是依赖于kprobe,它是利用指令插桩原理,截获指令流,并在指令执行前后插入hook函数,其如下:
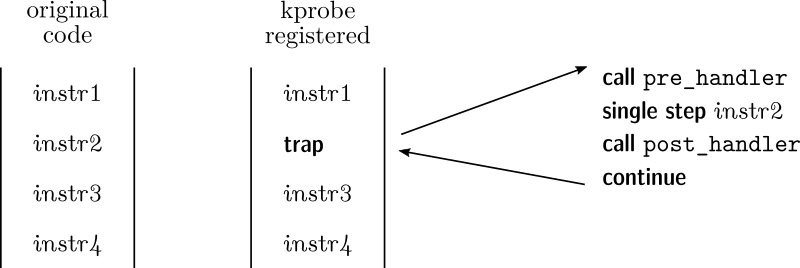
所以kprobe的实现原理是把制定地址(探测点)的指令替换成一个可以让cpu进入debug模式的指令,使执行路径暂停,跳转到probe处理函数后收集,修改信息,然后再跳转回来继续执行的过程。
如果需要知道内核函数是否被调用、被调用上下文、入参以及返回值,比较简单的方式是加printk,但是效率低,利用kprobe技术,用户可以自定义自己的回调函数,可以再几乎所有的函数中动态插入探测点。
首先kprobe是最基本的探测方式,是实现后两种的基础,它可以再任意的位置放置探测点(就连函数内部的某条指令处也可以),提供了探测点的调用前,调用后和内存访问出错3种回调方式,分别是- -
- per_handler:将在被探测指令执行前回调
- post_handler:将在被探测指令执行完毕后回调(注意不是被探测函数)
对于kretprobe从名字就可以看出,它同样是基于kprobe实现,用于获取被探测函数的返回值
2 ARM64 kprobe的工作原理
实现kprobes 接口的数据结构和函数已在文件<include/linux/kprobes.h>中定义。下面的数据结构描述了一个 kprobe
struct kprobe {
	struct hlist_node hlist;  /* 所有注册的kprobe都会添加到kprobe_table哈希表中,hlist成员用来链接到某个槽位中 */

	/* list of kprobes for multi-handler support */
	struct list_head list;     /* 链接一个地址上注册的多个kprobe */

	/*count the number of times this probe was temporarily disarmed */
	unsigned long nmissed;    /* 记录当前的probe没有被处理的次数 */
  /* 一个是用户在注册前指定探测点的基地址(加上偏移得到真实的地址),
   * 另一个是在注册后保存探测点的实际地址, 如果没有指定,必须指定探测的位置的符号信息 */
	/* location of the probe point */
	kprobe_opcode_t *addr;    /* 探测点地址 */
  /* 名称和地址不能同时指定,否则注册时会返回EINVAL错误 */
	/* Allow user to indicate symbol name of the probe point */
	const char *symbol_name;  /* 探测点函数名 */

	/* Offset into the symbol */
	unsigned int offset;      /* 探测点在函数内的偏移 */
  /* 断点异常触发之后,开始单步执行原始的指令之前被调用 */
	/* Called before addr is executed. */
	kprobe_pre_handler_t pre_handler;
  /* 在单步执行原始的指令后会被调用 */
	/* Called after addr is executed, unless... */
	kprobe_post_handler_t post_handler;  /* 后处理函数 */
  /* 原始指令,在被替换为断点指令(X86下是int 3指令)前保存。 */
	/* Saved opcode (which has been replaced with breakpoint) */
	kprobe_opcode_t opcode;

	/* copy of the original instruction */
	struct arch_specific_insn ainsn;   /* 保存平台相关的被探测指令和下一条指令 */

	/*
	 * Indicates various status flags.
	 * Protected by kprobe_mutex after this kprobe is registered.
	 */
	u32 flags;                        /* 状态标记 */
};
所以对于kprobe的使用比较简单,只需要指定探测点地址,或者使用符号名+偏移的方式,定义xxx_handler,注册即可,注册后,探测指令被替换,可以使用kprobe_enable/disable函数动态开关
2.1 kprobe初始化
下面我们来看看 kprobe 的初始化过程,kprobe 的初始化由 init_kprobes() 函数kernel/kprobes.c实现:
static int __init init_kprobes(void)
{
	int i, err = 0;
  /* 初始化用于存储 kprobe 模块的哈希表 */
	/* FIXME allocate the probe table, currently defined statically */
	/* initialize all list heads */
	for (i = 0; i < KPROBE_TABLE_SIZE; i++)
		INIT_HLIST_HEAD(&kprobe_table[i]);
  /* 初始化 kprobe 的黑名单函数列表(不能被 kprobe 跟踪的函数列表) */
	err = populate_kprobe_blacklist(__start_kprobe_blacklist,
					__stop_kprobe_blacklist);
	if (err) {
		pr_err("kprobes: failed to populate blacklist: %d\n", err);
		pr_err("Please take care of using kprobes.\n");
	}

	if (kretprobe_blacklist_size) {
		/* lookup the function address from its name */
		for (i = 0; kretprobe_blacklist[i].name != NULL; i++) {
			kretprobe_blacklist[i].addr =
				kprobe_lookup_name(kretprobe_blacklist[i].name, 0);
			if (!kretprobe_blacklist[i].addr)
				printk("kretprobe: lookup failed: %s\n",
				       kretprobe_blacklist[i].name);
		}
	}

	/* By default, kprobes are armed */
	kprobes_all_disarmed = false;

#if defined(CONFIG_OPTPROBES) && defined(__ARCH_WANT_KPROBES_INSN_SLOT)
	/* Init kprobe_optinsn_slots for allocation */
	kprobe_optinsn_slots.insn_size = MAX_OPTINSN_SIZE;
#endif
  /* 初始化CPU架构相关的环境(x86架构的实现为空) */
	err = arch_init_kprobes();
	if (!err)
		err = register_die_notifier(&kprobe_exceptions_nb); /* 注册die通知链*/
	if (!err)
		err = register_module_notifier(&kprobe_module_nb);  /* 注册模块通知链 */

	kprobes_initialized = (err == 0);

	if (!err)
		init_test_probes();
	return err;
}
early_initcall(init_kprobes);
2.2 注册一个kprobe实例
内核是通过register_kprobe完成一个kprobe实例的注册,其详细实现过程在kernel/kprobes.c,如下所示
/* struct kprobe结构体,里面包含指令地址或者函数名地址和函数内偏移 */
int register_kprobe(struct kprobe *p)
{
	int ret;
	struct kprobe *old_p;
	struct module *probed_mod;
	kprobe_opcode_t *addr;
  /* 获取被探测点的地址,指定了sysmbol name,则kprobe_lookup_name从kallsyms中获取;
   * 指定了offsete + address,则返回address + offset */
	/* Adjust probe address from symbol */
	addr = kprobe_addr(p);
	if (IS_ERR(addr))
		return PTR_ERR(addr);
	p->addr = addr;
  /* 判断同一个kprobe是否被重复注册 */
	ret = warn_kprobe_rereg(p);
	if (ret)
		return ret;

	/* User can pass only KPROBE_FLAG_DISABLED to register_kprobe */
	p->flags &= KPROBE_FLAG_DISABLED;
	p->nmissed = 0;
	INIT_LIST_HEAD(&p->list);
  /* 1. 判断被注册的函数是否位于内核的代码段内,或位于不能探测的kprobe实现路径中
   * 2. 判断被探测的地址是否属于某一个模块,并且位于模块的text section内
   * 3. 如果被探测的地址位于模块的init地址段内,但该段代码区间已被释放,则直接退出 */
	ret = check_kprobe_address_safe(p, &probed_mod);
	if (ret)
		return ret;

	mutex_lock(&kprobe_mutex);
  /* 判断在同一个探测点是否已经注册了其他的探测函数 */
	old_p = get_kprobe(p->addr);
	if (old_p) {
		/* Since this may unoptimize old_p, locking text_mutex. */
    /* 如果已经存在注册过的kprobe,则将探测点的函数修改为aggr_pre_handler
     * 将所有的handler挂载到其链表上,由其负责所有handler函数的执行 */
		ret = register_aggr_kprobe(old_p, p);
		goto out;
	}

	cpus_read_lock();
	/* Prevent text modification */
	mutex_lock(&text_mutex);
  /* 分配特定的内存地址用于保存原有的指令 */
	ret = prepare_kprobe(p);
	mutex_unlock(&text_mutex);
	cpus_read_unlock();
	if (ret)
		goto out;
  /* 将kprobe加入到相应的hash表内 */
	INIT_HLIST_NODE(&p->hlist);
	hlist_add_head_rcu(&p->hlist,
		       &kprobe_table[hash_ptr(p->addr, KPROBE_HASH_BITS)]);
  /* 将探测点的指令码修改为arm_kprobe */
	if (!kprobes_all_disarmed && !kprobe_disabled(p)) {
		ret = arm_kprobe(p);
		if (ret) {
			hlist_del_rcu(&p->hlist);
			synchronize_rcu();
			goto out;
		}
	}

	/* Try to optimize kprobe */
	try_to_optimize_kprobe(p);
out:
	mutex_unlock(&kprobe_mutex);

	if (probed_mod)
		module_put(probed_mod);

	return ret;
}
其主要包括以下几个步骤:
- 探测点地址的计算: 该函数主要用来指定位置注册探测点,首先使用kprobe_addr计算需要插入探测点的地址,这个会设置到kprobe的addr成员,注册后通过这个成员和offset就可以拿到探测位置的地址。利用这个特性,你可以通过kprobe来获取内核中某一个函数的运行时地址
- 如果没有指定探测地址,而是指定了符号信息,则调用kprobe_lookup_name在内核符号表中查找符号对应的地址,在找到对应的符号地址后,加上偏移就得到探测点的实际位置
- 如果只是指定了探测点的地址,则会将这个地址直接加上偏移返回
- 检测探测点地址: 计算探测点的地址后,接下来就需要检查这个地址是否可以被探测
- 跟踪点是否已经被 ftrace 跟踪,如果是就返回错误(kprobe 与 ftrace 不能同时跟踪同一个地址)
- kprobe只能用作内核函数的探测,所以在注册前必须检查探测点的地址是否是在内核地址空间中,探测点的地址要么在内核影响中(_stext 和 etext之间,如果是在相同启动阶段(sinittext 和_einittext之间),具体实现在kernel_text_address代码中
- 跟踪点是否在 kprobe 的黑名单中,如果是就返回错误
- 如果探测点的地址在一个内核模块中,需要增加对该模板的引用,以防止模块提前卸载,如果模块已经开始卸载,此时也是不能注册探测点
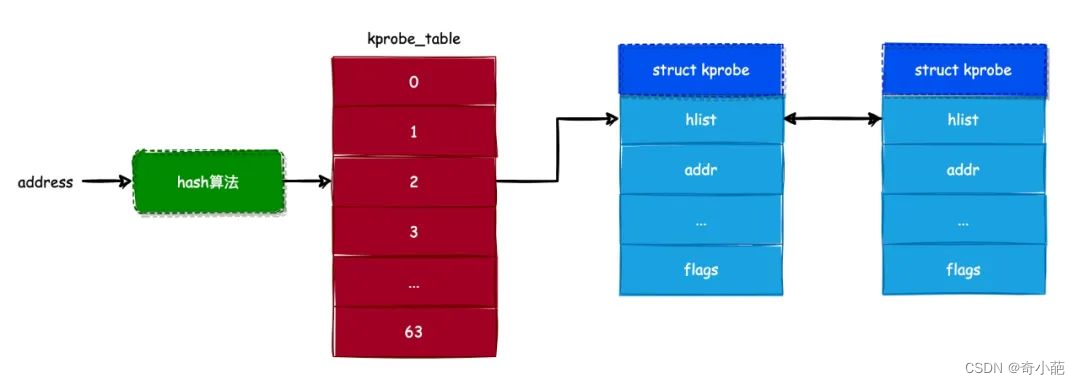
- 保存被跟踪指令的值: 内核通过调用prepare_kprobe函数来保持被跟踪的指令,而
prepare_kprobe()最终会调用 CPU 架构相关的arch_prepare_kprobe()函数来完成任务 - 注册kprobe: 系统中所有的kprobe实例都保存在kprobe_table这个哈希表中,
- 如果调用get_kprobe()能找到一个kprobe实例,说明已经在当前的探测点注册了一个kprobe,这种情况下会调用register_aggr_kprobe()来处理。
- 如果当前的探测点没有注册过kprobe,则调用arm_kprobe将被探测位置的指令保持到kprobe的ainsn成员中,并且被探测位置的第一条指令保存到opcode成员中
对于arch_prepare_kprobe,看指令是否是一些分支等特殊指令,需要特别处理。如果是正常可以probe的指令,调用arch_prepare_ss_slot把探测点的指令备份到slot page里,把下一条指令存入struct arch_probe_insn结构的restore成员里,在post_handler之后恢复执行。
arch_prepare_krpobe无误后把kprobe加入kprobe_table哈希链表。
然后调用arch_arm_kprobe替换探测点指令为BRK64_OPCODE_KPROBES指令。
int __kprobes arch_prepare_kprobe(struct kprobe *p)
{
	unsigned long probe_addr = (unsigned long)p->addr;
  /* 地址应该为4的整数倍 */
	if (probe_addr & 0x3)
		return -EINVAL;

	/* copy instruction */
	p->opcode = le32_to_cpu(*p->addr);  /* 大端小端转换,将地址进行转换成PC能识别的地址 */
  /* 检测地址是否在异常代码段中 */
	if (search_exception_tables(probe_addr))
		return -EINVAL;
  /* 取出探测点的汇编指令 */
	/* decode instruction */
	switch (arm_kprobe_decode_insn(p->addr, &p->ainsn)) {
	case INSN_REJECTED:	/* insn not supported */
		return -EINVAL;
  /* 异常处理 */
	case INSN_GOOD_NO_SLOT:	/* insn need simulation */
		p->ainsn.api.insn = NULL;
		break;

	case INSN_GOOD:	/* instruction uses slot */
		p->ainsn.api.insn = get_insn_slot();
		if (!p->ainsn.api.insn)
			return -ENOMEM;
		break;
	}

	/* prepare the instruction */
	if (p->ainsn.api.insn)
		arch_prepare_ss_slot(p);   /* 将指令存放到slot中,记录吓一条指令到p->ainsn.api.insn */
	else
		arch_prepare_simulate(p);  /* 异常处理,如分支指令特殊处理 */

	return 0;
}
整个过程如下图所示:
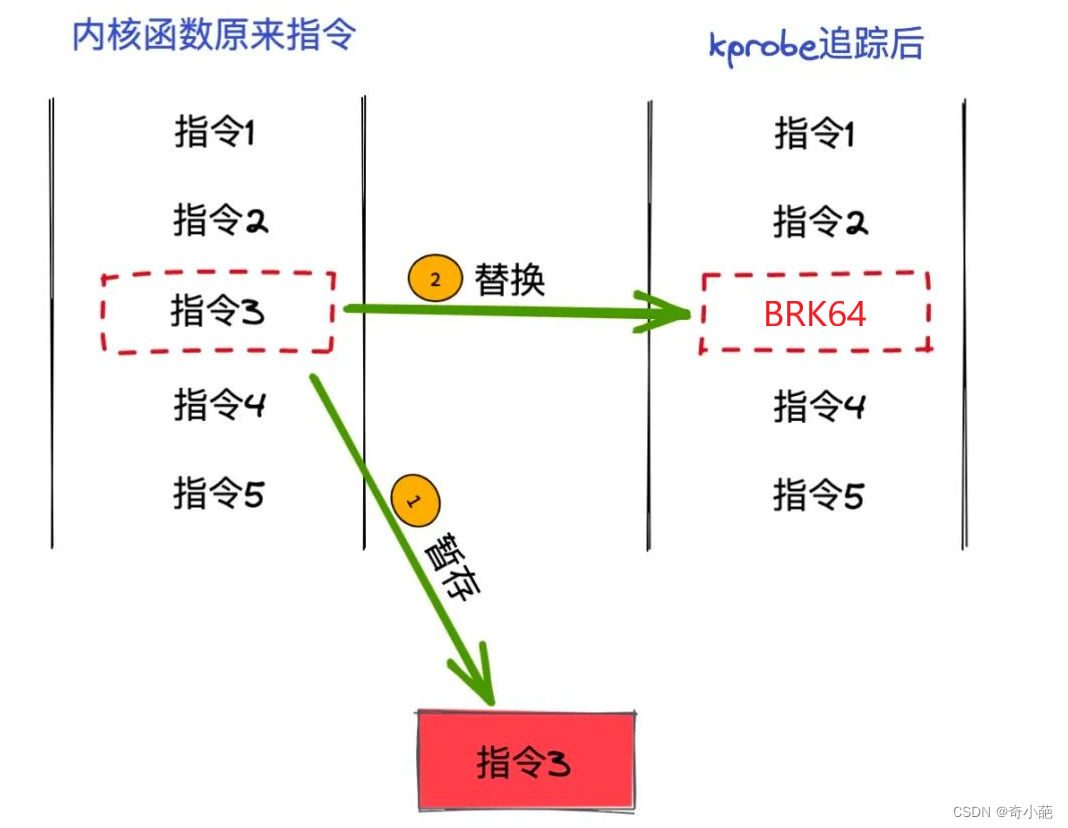
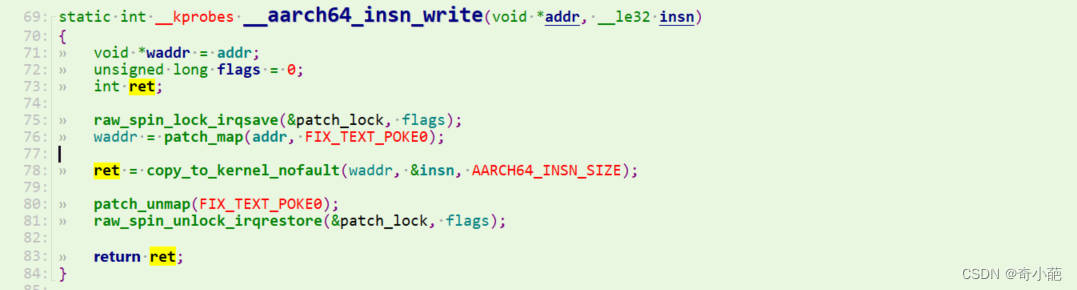
最终会调用arm_kprobe,将指令3替换成一条BRK64异常处理指令,当CPU执行到这个跟踪点的时候,将会触发断点中断,这时候就会走到异常处理函数中,对于x86,这个是一条int 3指令,我们来看看针对ARM64,是如何处理的,其最终会调到arch_arm_kprobe,最终会替换成BRK64_OPCODE_KPROBES指令。
/* arm kprobe: install breakpoint in text */
void __kprobes arch_arm_kprobe(struct kprobe *p)
{
	void *addr = p->addr;               /* 原地址 */
	u32 insn = BRK64_OPCODE_KPROBES;    /* 替换后的指令 */

	aarch64_insn_patch_text(&addr, &insn, 1);
}
2.3 触发kprobe探测和回调
kprobe的触发和处理是通过brk exception和single step单步exception执行的,每次的处理函数中会修改被异常中断的上下文(struct pt_regs)的指令寄存器,实现执行流的跳转。ARM64对于异常处理的注册在arch/arm64/kernel/debug-monitors.c, 是arm64的通用debug模块,kgdb也基于这个模块。请参考Query: ARM64: Behavior of el1_dbg exception while executing el0_dbg
void __init debug_traps_init(void)
{
	/* 单步异常处理 */
	hook_debug_fault_code(DBG_ESR_EVT_HWSS, single_step_handler, SIGTRAP,
			      TRAP_TRACE, "single-step handler");
  /* 断点异常处理 */
	hook_debug_fault_code(DBG_ESR_EVT_BRK, brk_handler, SIGTRAP,
			      TRAP_BRKPT, "BRK handler");
}
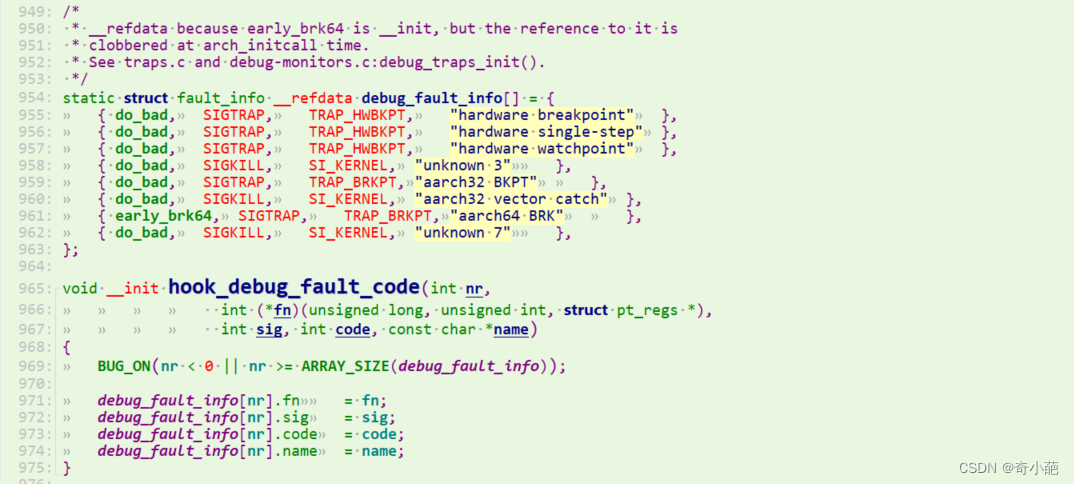
通过hook_debug_fault_code动态定义了异常处理的钩子函数brk_handler,它将在断点异常处理函数中被调用
hook_debug_fault_code是替换arch/arm64/mm/fault.c 中的debug_fault_info异常表项:
对于ARM64的异常处理,当brk断点异常触发后悔执行不同的回调处理,进入异常会跳转到arch/arm64/kernel/entry.S的sync异常处理,此处会跳转到el1_sync
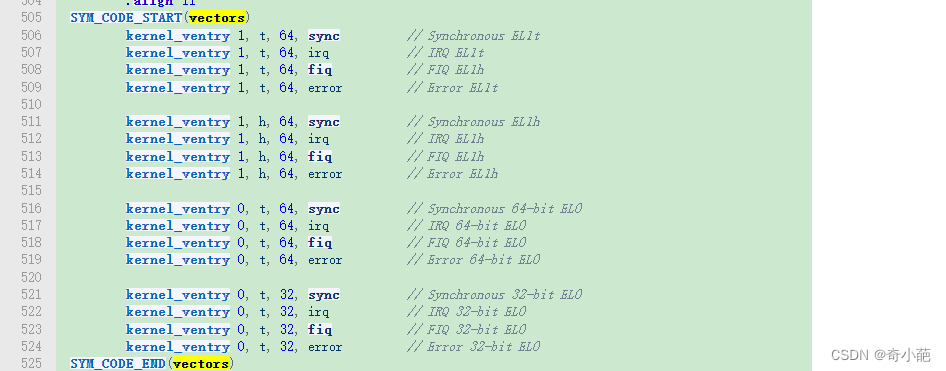
将 entry_handler 1, t, 64, sync宏展开得到调用el1t_64_sync_handler的处理函数,在arch/arm64/kernel/entry-common.c中处理,是通过read_sysreg(esr_el1)来处理对应的异常
最终会调用do_debug_exception处理debug异常
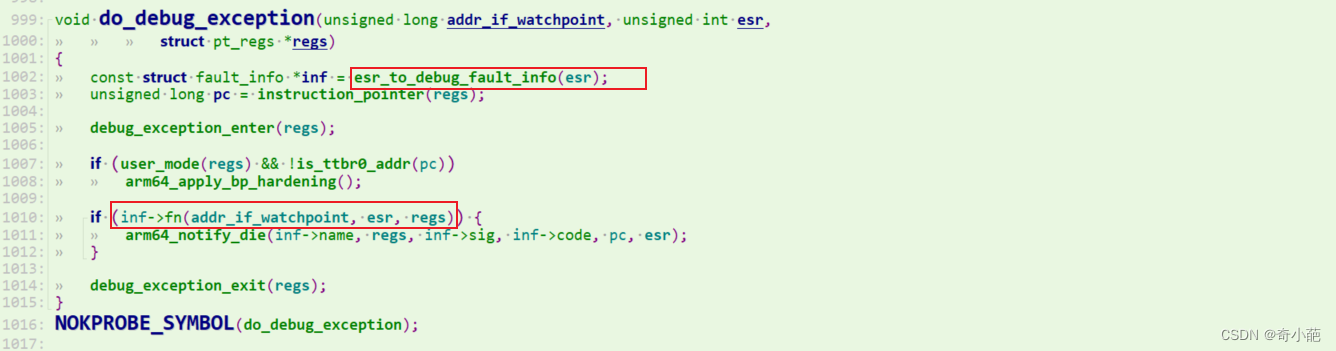
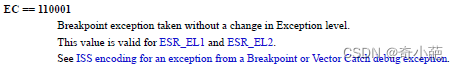
sr_el1的bit27~bit29指示了debug异常类型,对应debug_fault_info数组的索引,此处可知debug异常类型为0x6,对应DBG_ESR_EVT_BRK,由初始化函数debug_traps_init可知inf->fn为brk_handler
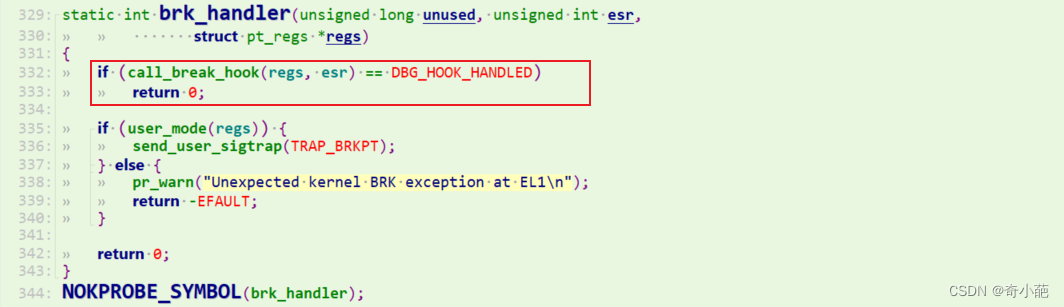
brk_handler会调用call_break_hook,它实际是根据具体的某种断点异常类型来回调不同的hook,主要是根据ESR_EL1.ISS.Comment进行区分,也就是不同的ESR_EL1.ISS.Comment对应不同的hook。
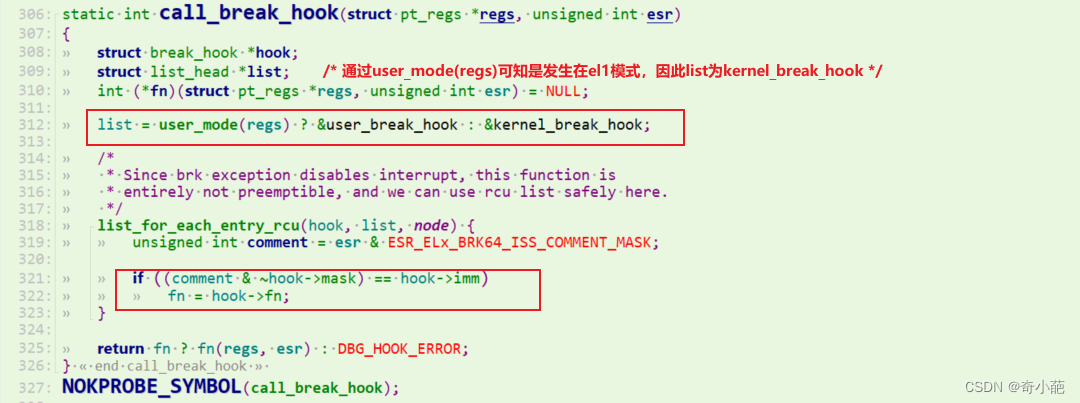
在初始化时register_kernel_break_hook会向kernel_break_hook链表注册不同的hook,这包括kprobes_break_hook和kprobes_break_ss_hook。list_for_each_entry_rcu(hook, list, node)主要通过遍历kernel_break_hook链表,根据debug断点异常类型找到匹配的hook。
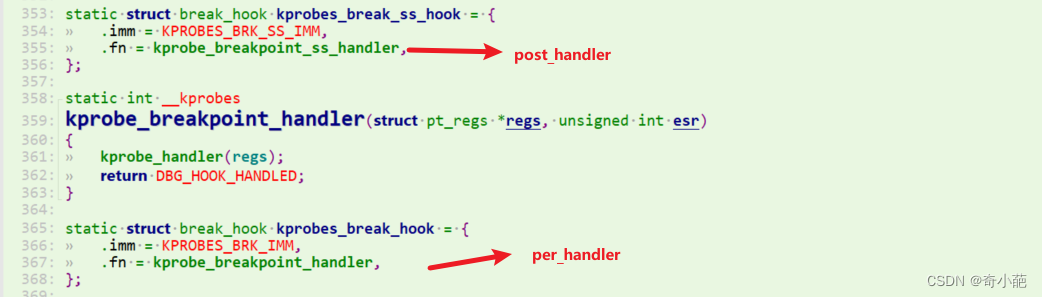
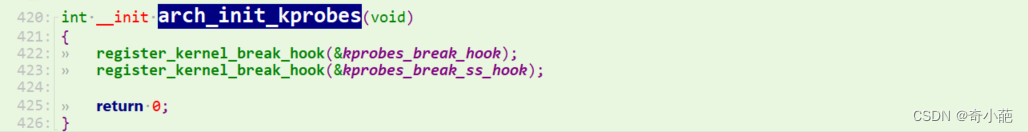
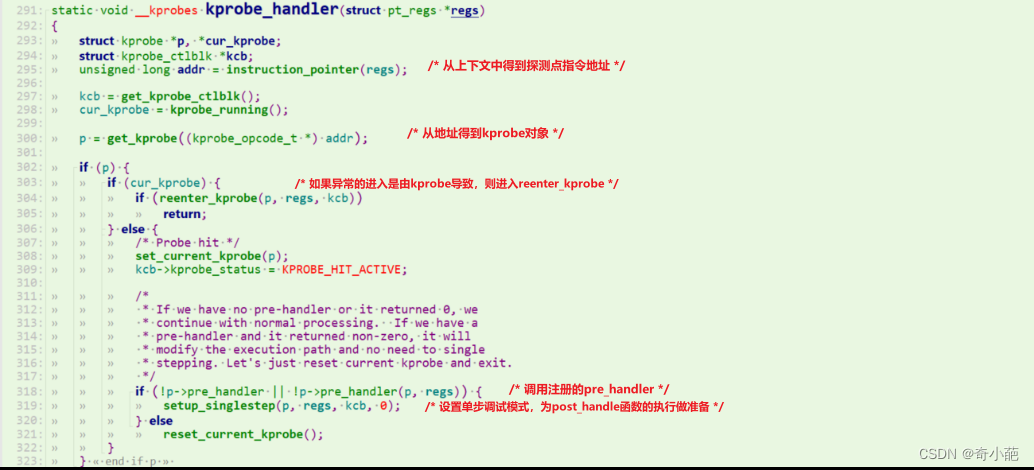
可以看出kprobe_handler里先是进入pre_handler,然后通过setup_singlestep设置single-step相关寄存器,为下一步执行原指令时发生single-step异常做准备
2.4 单步执行
进入异常态后,首先执行pre_handler,然后利用CPU提供的单步调试(single-step)功能,设置好相应的寄存器,将下一条指令设置为插入点处本来的指令,从异常态返回
这个里面使用reenter检查机制,对于SMP,中断等可能有kprobe的重入,允许kpobe发生嵌套
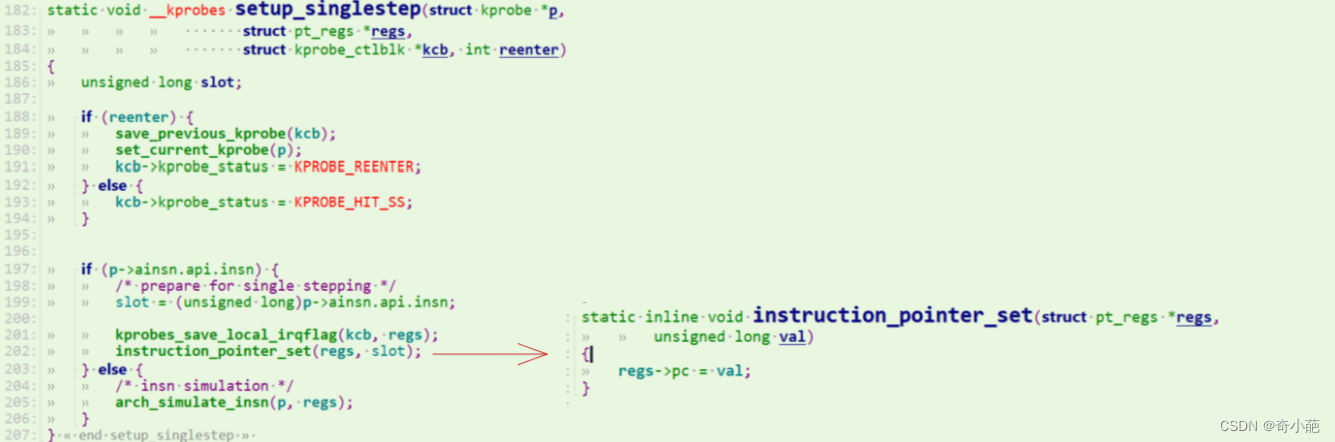
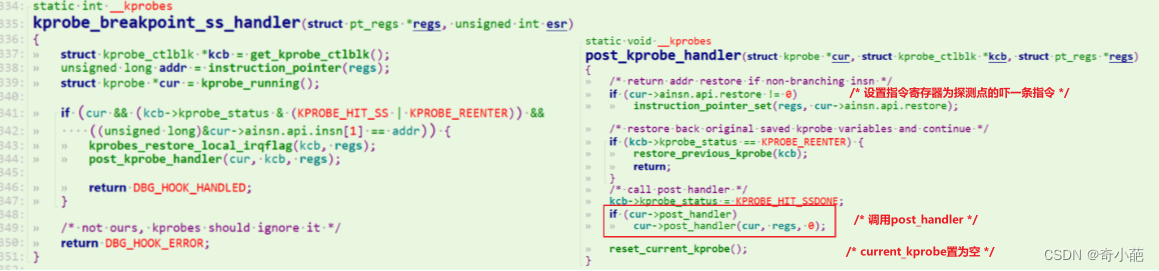
setup_singlestep() 执行完毕后,程序继续执行保存的被探测点的指令,由于开启了单步调试模式,执行完指令后会继续触发异常,单步执行探测点的指令后,会触发单步异常,进入single_step_handler,调用kprobe_breakpoint_ss_handler,主要任务是恢复执行路径,调用用户注册的post_handler
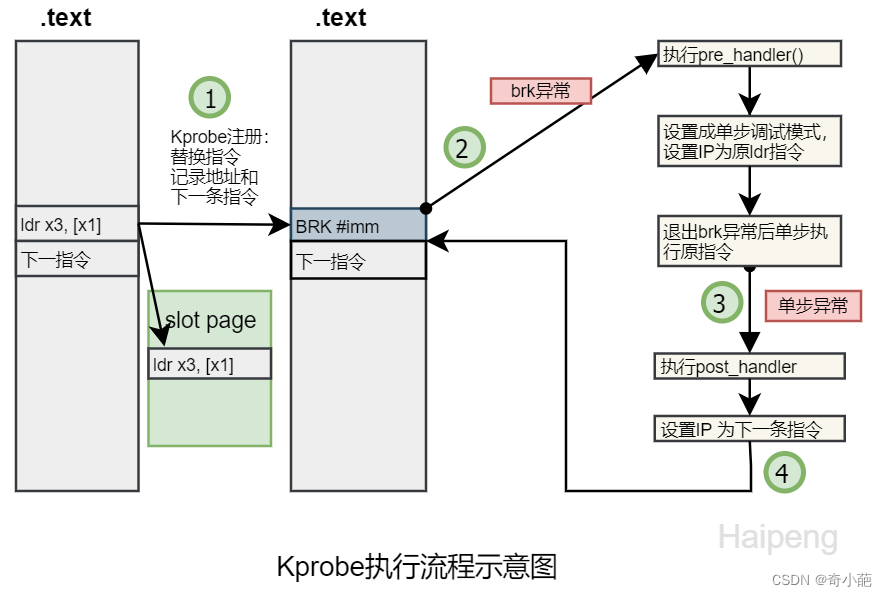
kprobe的实现原理是把指定地址(探测点)的指令替换成一个可以让cpu进入debug模式的指令,使执行路径暂停,跳转到probe 处理函数后收集、修改信息,再跳转回来继续执行。
X86中使用的是int3指令,ARM64中使用的是BRK指令进入debug monitor模式。
3 kprobe event实现原理
首先我们跟function一样,从我们的配置开始,krpobe event和功能一样,那么大部分的实现是一样的,最关键的不同就是怎么使用新的插桩方法来创建event。使用向“/sys/kernel/debug/tracing/kprobe_events”文件中echo命令的形式来创建krpobe event。来查看具体的代码实现:
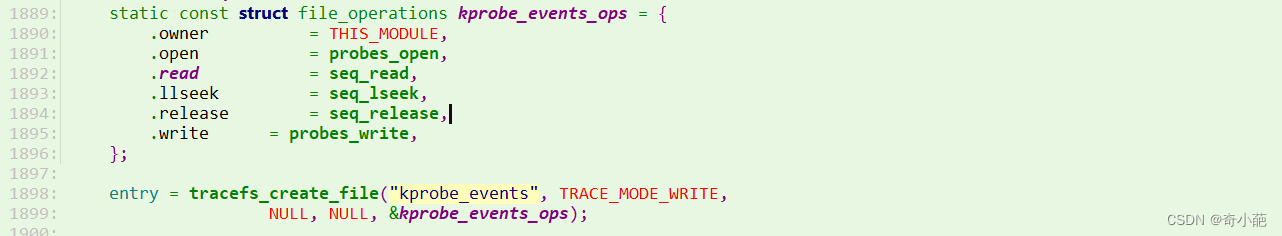
经过层层调用,最终到__trace_kprobe_create函数,其主要的实现如下:
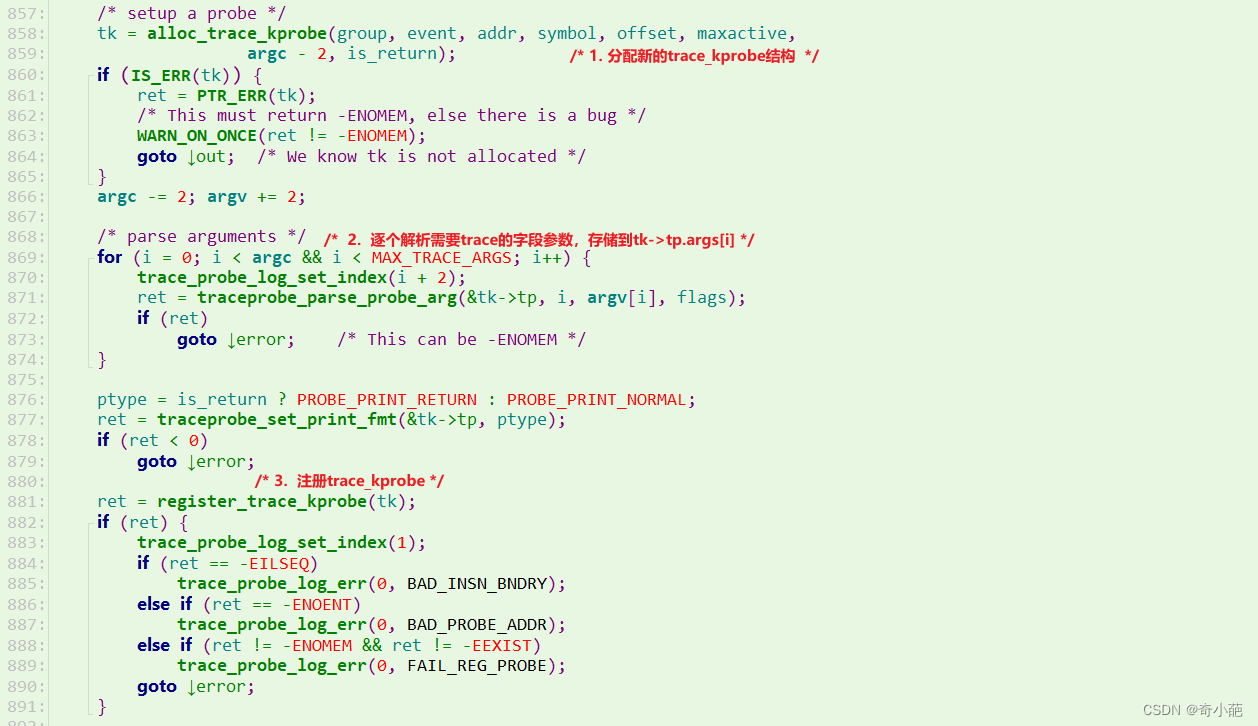
对于alloc_trace_kproe,可以看到kretprobe模式下的桩函数:kretprobe_dispatcher(),而kprobe模式下的插桩函数为kprobe_dispatcher
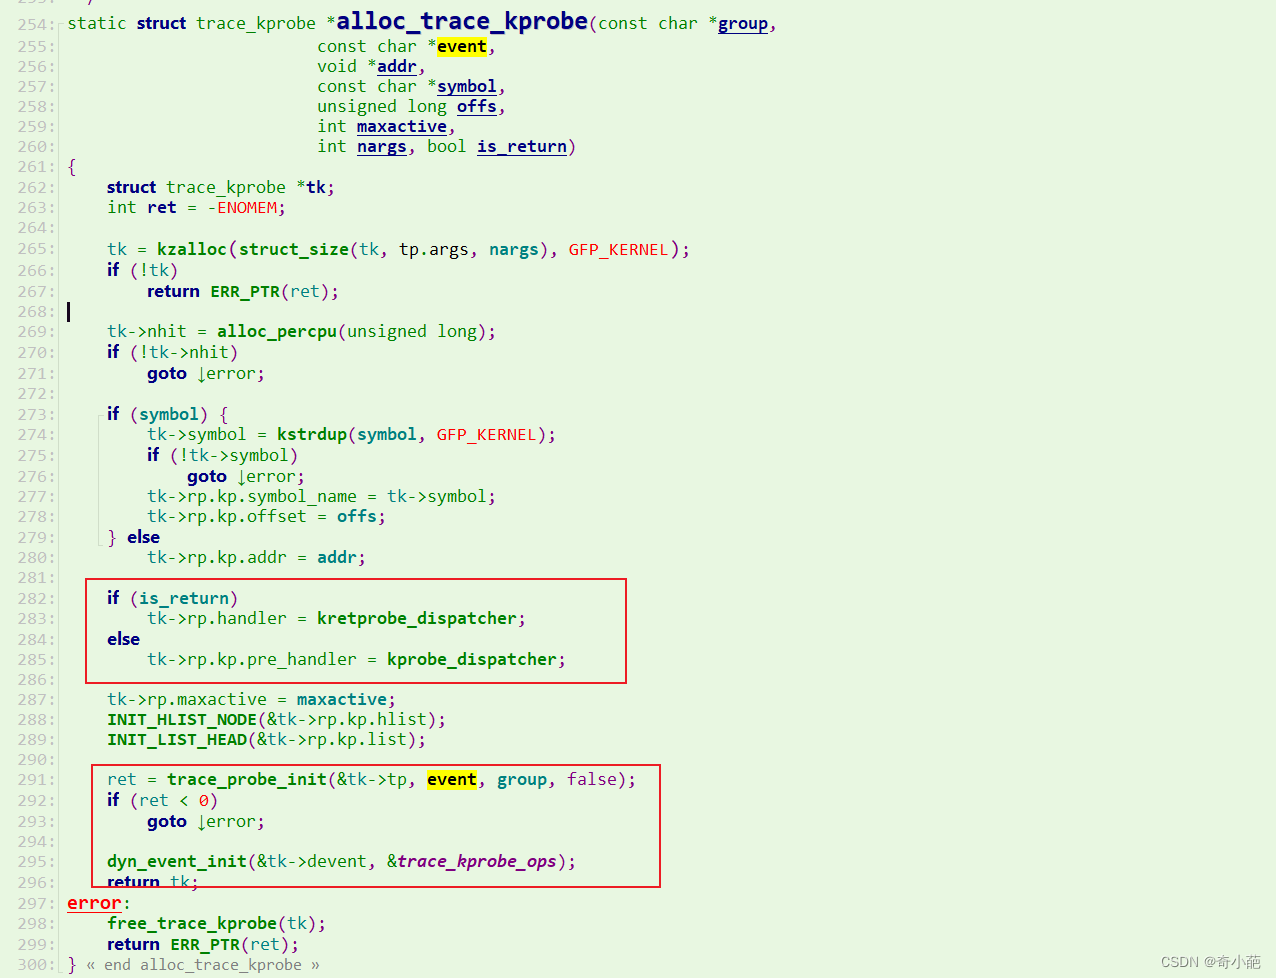
其最终也会通过__register_trace_kprobe注册kprobe和kpretprobe,其最终的原理也是基本类似
4 kprobe的使用方法
最早的时候,使用kprobe一般都是编写内核驱动,在模块中定义pre-handler和post-handler函数,然后调用kprobe的API(register_kprobe)来进行注册kprobe。加载模块后,pre-handler和post-handler中的printk就会打印定制的信息到系统日志中,目前有三种使用kporbe的接口
- kprobe API:使用register_kprobe
- 基于Ftrace的/sys/kernel/debug/tracing/kprobe_events接口,通过写特定的配置文件
- perf_event_open:通过perf工具,perf 的probe命令提供了添加动态探测点的功能, 参看 kernel/tools/perf/Documentation/perf-probe.txt,
- 在最新的内核上,BPF tracing也是通过这种方式,后面再学习这种方法
kprobes的最大使用者都是一些tracer的前端工具,比如perf、systemtap、BPF 跟踪(BCC和bpftrace)
由于第一种方式灵活而且功能更为强大,对于方法一,大家请参考示例
- kprobe:请参考samples/kprobes/kprobe_example.c
- kretprobe:请参考sample/kprobe/kretprobe_example.c
要编写一个 kprobe 内核模块,可以按照以下步骤完成:
- 第一步:根据需要来编写探测函数,如
pre_handler和post_handler回调函数。 - 第二步:定义
struct kprobe结构并且填充其各个字段,如要探测的内核函数名和各个探测回调函数。 - 第三步:通过调用
register_kprobe函数注册一个探测点。 - 第四步:编写 Makefile 文件。
- 第五步:编译并安装内核模块。
对于方式二,用户通过/sys/kernel/debug/tracing/目录下的trace等属性文件来探测用户指定的函数,用户可添加kprobe支持的任意函数并设置探测格式与过滤条件,无需再编写内核模块,使用更为简便,但需要内核的debugfs和ftrace功能的支持,详细的请参考内核文档kprobetrace
使用前确定内核CONFIG打开:CONFIG_KPROBE_EVENT=y
- /sys/kernel/tracing/kprobe_events:添加断点接口
- /sys/kernel/tracing/events/kprobes/enabled:断点使能开关
- /sys/kernel/tracing/trace:查看trace日志接口
4.1 查看"vfs_open"当前打开文件名
如果你使用了“‘p:’ or ‘r:’+event name” > kprobe_events命令,新的kprobe event将会被添加,可以看到新events对应的文件夹tracing/events/kprobes/,包含‘id’, ‘enabled’, ‘format’ and ‘filter’文件。
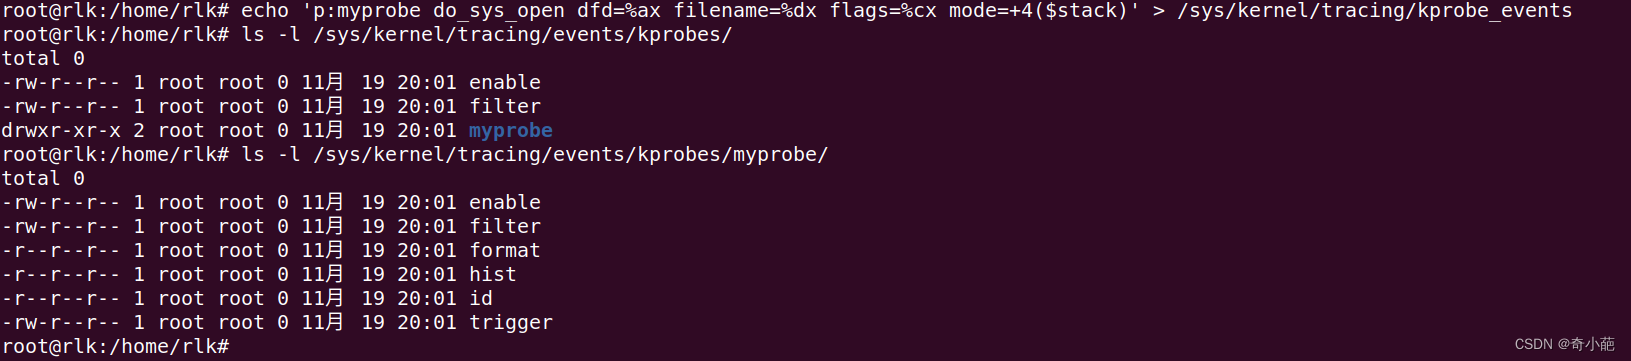
- enable:使能
- filter:过滤想要的信息
- trigger:事件发生时触发其他功能,例如function功能
- format:环形队列缓冲区的格式
- id: event对应的id
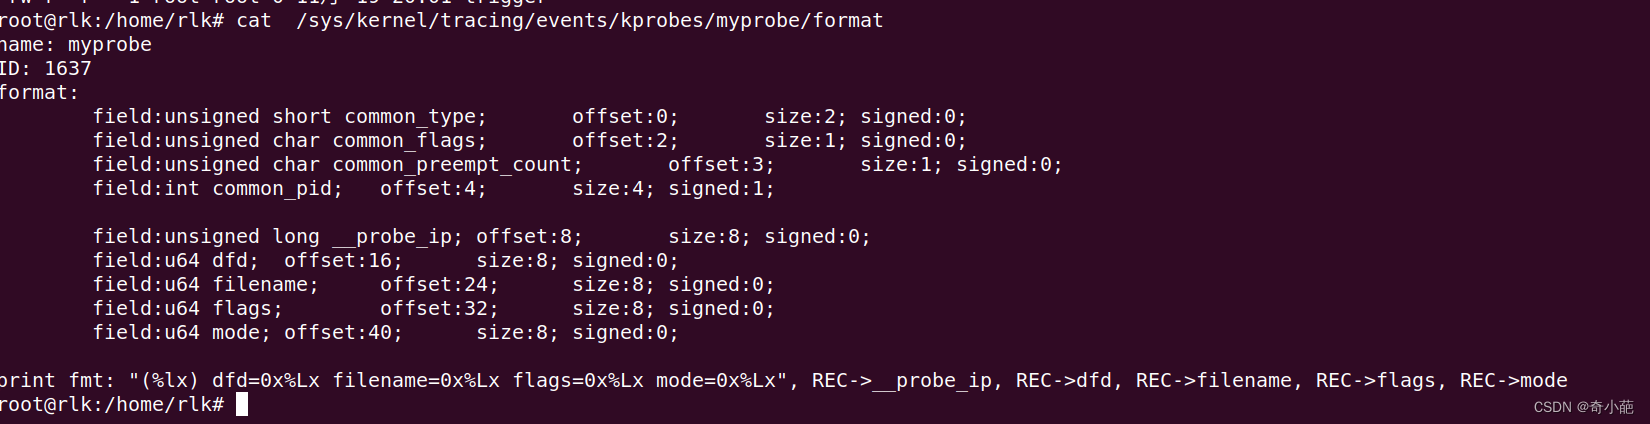
echo 1 > /sys/kernel/tracing/events/kprobes/myprobe/enable
echo 1 > /sys/kernel/tracing/tracing_on
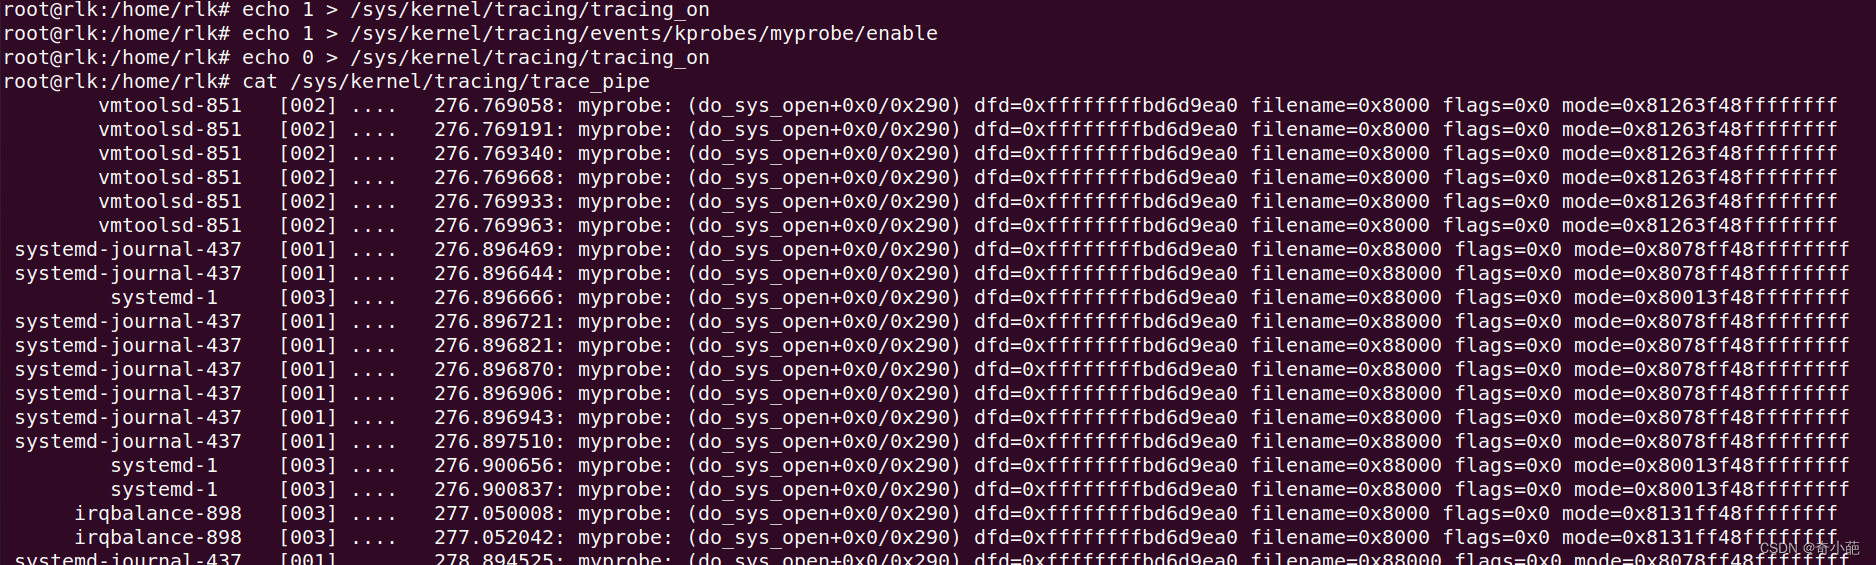
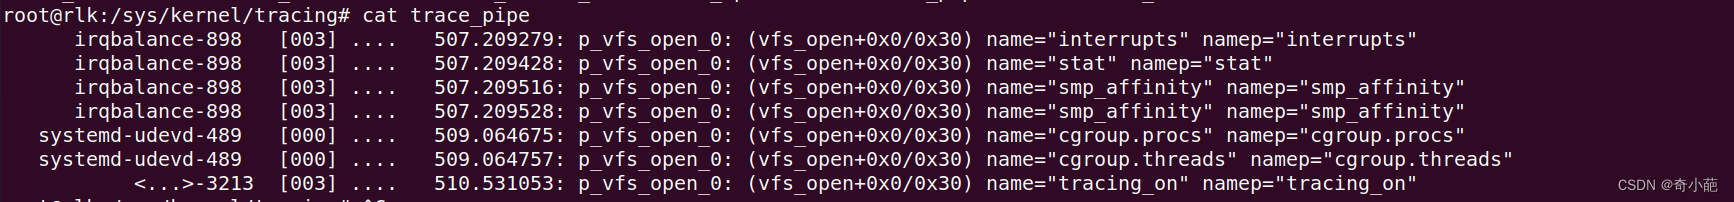
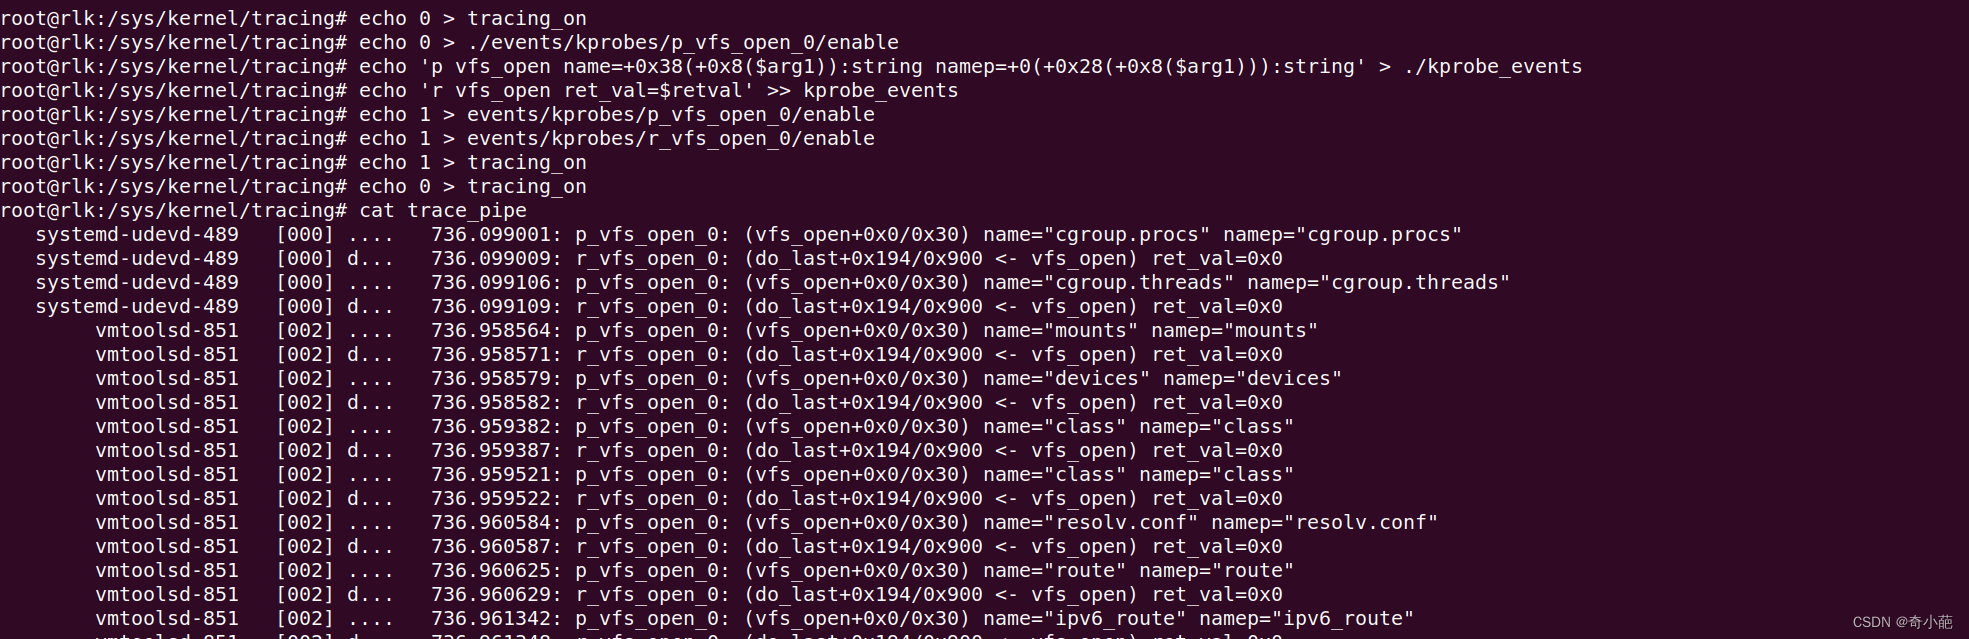
要查看哪些进程触发了这些kprobe,可以通过trace、trace_pipe接口查看,输出格式如下,最左边是进程名,如果是<…>,可能是因为cat的时候,那个进程号对应的进程已经不存在了,第二个是进程PID,触发kprobe的时候记录的。FUNCTION就是触发的那个kprobe的名字,后面括号里是触发的时候代码位置,如果是“r”类型的kprobe,会显示返回到了什么代码位置。代码位置中的行号是反汇编对应的行号。
# 设置kprobe规则,获取vfs_open函数第一个参数path中的文件name
cd /sys/kernel/tracing
echo 'p vfs_open name=+0x38(+0x8($arg1)):string namep=+0(+0x28(+0x8($arg1))):string' > ./kprobe_events
# 使能上述的kprobe
echo 1 > ./events/kprobes/p_vfs_open_0/enable
# 使能数据写入到 Ring 缓冲区
echo 1 > tracing_on
通过offset和类型打印,实现结构体内部成员的打印,但是需要知道寄存器和参数的对应关系和结构体成员的偏移。[13]提到了新的function_event机制,可以直接传递参数名。例如我们想获取net_device的stats信息,获取数据结构偏移的例子:打印ip_rcv的网络设备名和收发包数
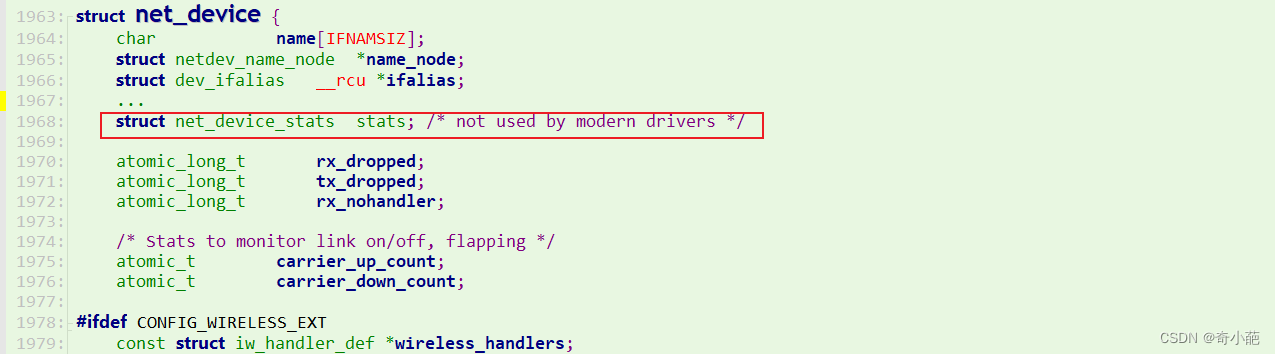
$ aarch64-linux-gnu-gdb vmlinux
(gdb) ptype/o struct net_device
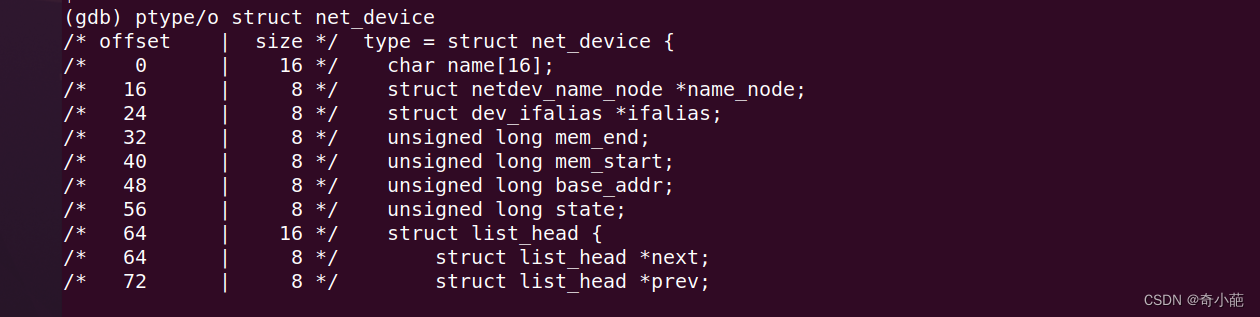
gdb) print (int)&((struct net_device *)0)->stats
$7 = 296

cd /sys/kernel/debug/tracing/
echo 'p:net ip_rcv name=+0(%x1):string rx_pkts=+296(%x1):u64 tx_pkts=+280(%x1):u64 ' > kprobe_events
echo 1 > events/kprobes/enable
4.2 设置了一个kretprobe,用来记录返回值
root@rlk:/sys/kernel/tracing# echo 0 > tracing_on
root@rlk:/sys/kernel/tracing# echo 0 > ./events/kprobes/p_vfs_open_0/enable
root@rlk:/sys/kernel/tracing# echo 'p vfs_open name=+0x38(+0x8($arg1)):string namep=+0(+0x28(+0x8($arg1))):string' > ./kprobe_events
root@rlk:/sys/kernel/tracing# echo 'r vfs_open ret_val=$retval' >> kprobe_events
root@rlk:/sys/kernel/tracing# echo 1 > events/kprobes/p_vfs_open_0/enable
root@rlk:/sys/kernel/tracing# echo 1 > events/kprobes/r_vfs_open_0/enable
root@rlk:/sys/kernel/tracing# echo 1 > tracing_on
root@rlk:/sys/kernel/tracing# echo 0 > tracing_on
root@rlk:/sys/kernel/tracing# cat trace_pipe
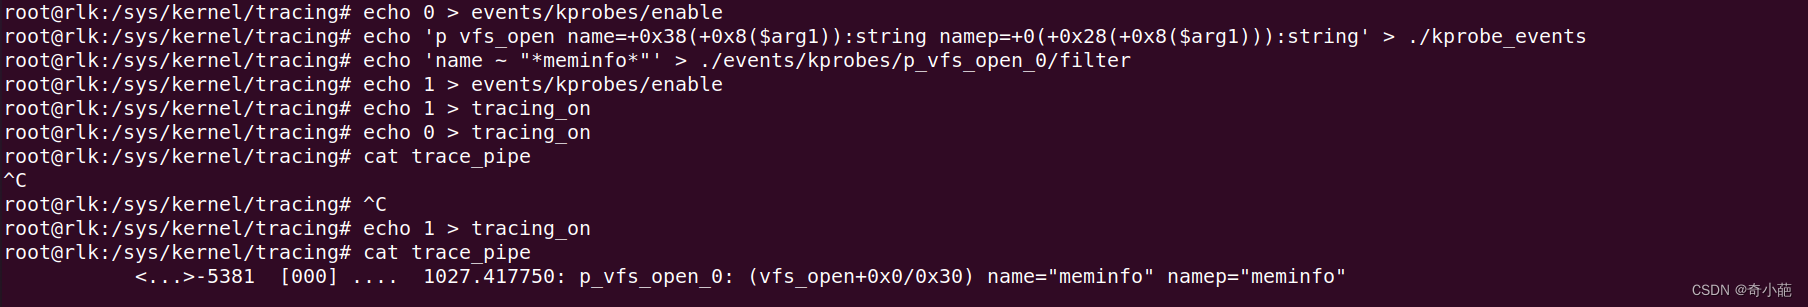
4.3 filter:捕获"vfs_open"查看指定文件的信息的事件
# 设置过滤条件,name中包含test字段
echo 'name ~ "*test*"' > ./events/kprobes/p_vfs_open_0/filter
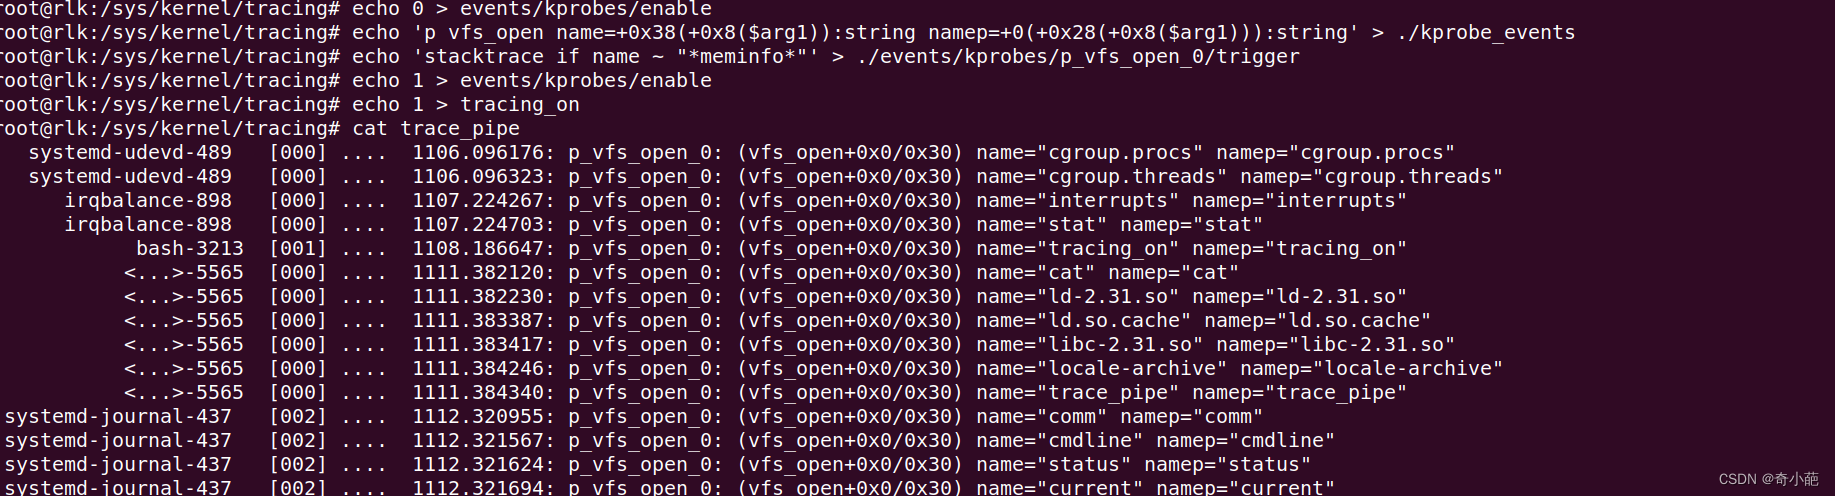
4.4 trigger:包含"test"字段的文件的事件会触发"stacktrace"堆栈打印
# 包含"test"字段的文件的事件会触发"stacktrace"堆栈打印
echo 'stacktrace if name ~ "*test*"' > ./events/kprobes/p_vfs_open_0/trigger
5 总结
至此,我们知道Kprobe实现的本质是breakpoint和single-step的结合,这一点和大多数调试工具一样,比如kgdb/gdb。实现动态内核的注入,其主要流程如下:
- 当 kprobe 被注册后,内核会将对应地址的指令进行拷贝并替换为断点指令(比如 X86 中的
int 3) - 随后当内核执行到对应地址时,中断会被触发从而执行流程会被重定向到我们注册的
pre_handler函数 - 当对应地址的原始指令执行完后,内核会再次执行
post_handler从而实现指令级别的内核动态监控。也就是说,kprobe 不仅可以跟踪任意带有符号的内核函数,也可以跟踪函数中间的任意指令。
6 参考文档
【原创】Kernel调试追踪技术之 Kprobe on ARM64

 990


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


