


前言:
最近负责rag检索模块的开发中引入了es进行rag检索,现在就来更深入一点的了解一下es,本文将从底层数据结构出发,逐步深入到代码层面的查询构建,起完整的 ES 知识体系。内容基于真实项目实践,涵盖倒排索引、中文分词、向量检索、KNN 与 BM25 混合排序,以及文档级权限控制。
ES 是什么?
ES 是文档型数据库
ES 属于文档型数据库,数据以 JSON 文档形式存储。我比较熟悉mysql所以我进行对比和 MySQL 对应关系如下:
| MySQL | ES |
|---|---|
| 数据库 | 集群(Cluster) |
| 表(Table) | 索引(Index) |
| 行(Row) | 文档(Document) |
| 列(Column) | 字段(Field) |
| 主键 |
ES 的字段类型一旦确定就很难修改。比如 textContent 定义成 text 就不能改成 keyword;向量维度定义成 2048 就不能改成 1024。所以创建索引前,必须通过 mapping 文件把结构定义清楚。
之前我对es索引其实有误解,其实es索引有两层概念对于上层来说,es索引可以类比于数据库表,索引其实就是一张表。对于底层来说倒排索引,HNSW索引才是用来加快检索。
Mapping 相当于 MySQL 的建表语句
索引(Index):是 ES 里实际存储数据的容器,里面装着很多 JSON 文档。相当于 MySQL 的一张表。
Mapping:是描述这个索引里有哪些字段、每个字段是什么类型、要不要分词、要不要建索引的“设计图”。相当于 MySQL 的
CREATE TABLE语句。
在项目中我把mapping放在了resource下,把 mapping 放 resources 下,是因为它是程序启动时要读取的配置文件,不是业务逻辑代码。这样可读、可版本管理、可自动初始化,也方便多环境保持一致。
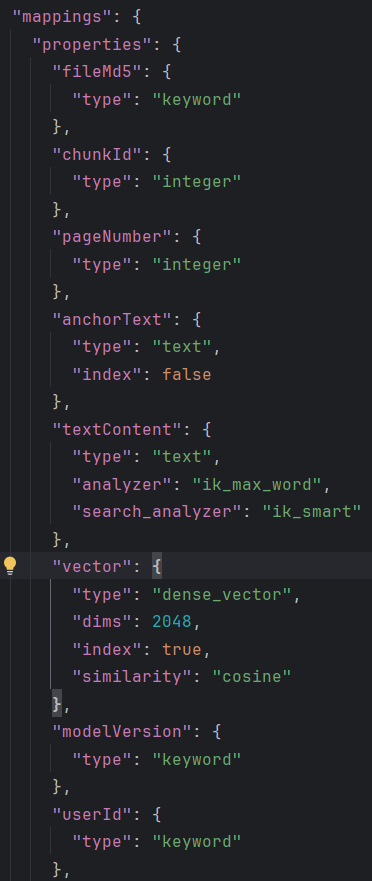
| 属性 | 用在哪 | 作用 |
|---|---|---|
type | 所有字段 | 字段类型,决定怎么存、怎么查 |
index | anchorText 设 false,vector 设 true | 是否建索引。text/keyword 默认 true;dense_vector 默认 false,必须手动开 |
analyzer | textContent 用 ik_max_word | 写入时的分词器,切得细,索引更全 |
search_analyzer | textContent 用 ik_smart | 查询时的分词器,切得粗,减少无关召回 |
dims | vector 设 2048 | 向量维度,必须和 Embedding 模型输出一致 |
similarity | vector 设 cosine | 向量相似度算法,用余弦相似度计算距离 |
type 定类型,index 管要不要建索引,analyzer/search_analyzer 管分词,dims 和 similarity 管向量。
ES 为什么能检索得又快又准?
ES 实现毫秒级全文搜索的核心是 倒排索引,它建立“词 → 文档”的映射,避免全表扫描。
文档1:公司财务报销制度
文档2:财务报表分析
用中文分词器切分后,建立倒排索引:
"公司" → [文档1]
"财务" → [文档1, 文档2]
"报销" → [文档1]
"制度" → [文档1]
"报表" → [文档2]
"分析" → [文档2]
中文分词:IK 分词器的两种模式
中文没有空格,ES 默认分词器会把整句当成一个词,导致全文检索失效。IK 分词器解决此问题,包含两种模式:
| 模式 | 用途 | 切分粒度 | 示例(“中华人民共和国人民大会堂”) |
|---|---|---|---|
ik_max_word | 写入时用 | 最细粒度 | 中华人民共和国,中华人民,中华,华人,人民共和国,人民大会堂,人民大会,大会堂 |
ik_smart | 查询时用 | 最粗粒度 | 中华人民共和国,人民大会堂 |
写入用 ik_max_word:索引尽可能多的词,保证搜什么都能命中,提高召回率。
查询用 ik_smart:避免切太碎导致召回大量无关文档,提高精确率。
向量检索:语义相似度计算
ES 支持 dense_vector 类型字段,用于 KNN 相似度检索。
写入时:文档切片通过 Embedding 模型转成向量(如 2048 维),存入
dense_vector字段,建立 HNSW 向量索引。查询时:用户问题也必须通过同一个 Embedding 模型转成向量,然后用
knn查询计算余弦相似度。
KNN 与 BM25 简介
在混合检索中,有两个核心算法:
KNN(K 近邻)
基于向量的语义检索。文档和问题都转成向量,计算相似度(如余弦相似度),返回最相似的 K 个。ES 底层用 HNSW 图索引加速,把复杂度从 O(N) 降到接近 O(log N)。KNN 管“意思像不像”,理解语义,同义词也能召回,但可能召回关键词不精确的文档。
BM25(Best Matching 25)
ES 默认的关键词相关性打分算法。根据词频(TF)、逆文档频率(IDF)和文档长度归一化计算得分。BM25 管“词对不对得上”,精确匹配关键词、计算快,但不理解语义,同义词搜不到。
为什么两者结合?
只用 KNN 可能召回语义相近但关键词不精确的文档;只用 BM25 则同义词搜不到。混合检索的思路:第一阶段用 KNN 扩大召回窗口,保证语义相关的文档都进候选集;第二阶段用 BM25 重新打分,让关键词精确匹配的文档排在前面。既保证召回率,又保证精确率。
构建混合检索查询
下面是一个完整的混合检索查询示例,包含 KNN 召回、关键词匹配、权限过滤和 BM25 重打分:
SearchResponse<EsDocument> response = esClient.search(s -> {
    s.index("knowledge_base");

    // ===== 1. KNN 向量召回 =====
    int recallK = topK * 30; // 扩大召回窗口
    s.knn(kn -> kn
        .field("vector")
        .queryVector(queryVector)
        .k(recallK)
        .numCandidates(recallK)
    );

    // ===== 2. 关键词匹配 + 权限过滤 =====
    s.query(q -> q.bool(b -> b
        .must(m -> m.match(ma -> ma
            .field("textContent").query(query)))
        .filter(f -> f.bool(bf -> bf
            .should(s1 -> s1.term(t -> t.field("isPublic").value(true)))
            .should(s2 -> s2.term(t -> t.field("userId").value(userDbId)))
            .should(s3 -> s3.terms(t -> t.field("allowedRoles").terms(tv -> tv.value(userRoles))))
            .should(s4 -> s4.terms(t -> t.field("allowedDepts").terms(tv -> tv.value(userDepts))))
            .should(s5 -> s5.terms(t -> t.field("allowedPositions").terms(tv -> tv.value(userPositions))))
            .minimumShouldMatch("1")
        ))
    ));

    // ===== 3. BM25 重打分 =====
    s.rescore(r -> r
        .windowSize(recallK)
        .query(rq -> rq
            .queryWeight(0.2d)          // 保留 20% KNN 分数
            .rescoreQueryWeight(1.0d)   // BM25 主导排序
            .query(rqq -> rqq.match(m -> m
                .field("textContent").query(query).operator(Operator.And)))
        )
    );

    s.size(topK);
    return s;
}, EsDocument.class);
总结
| 检索方式 | 写入时 | 查询时 | 底层索引 |
|---|---|---|---|
| 关键词检索 | ik_max_word 细粒度分词 | ik_smart 粗粒度分词 | 倒排索引 |
| 向量检索 | Embedding 模型转向量 | 同一模型转向量 | HNSW 向量索引 |
ES 的混合检索能力让它成为 RAG 系统中不可替代的检索组件。理解倒排索引、分词器、向量索引、KNN 与 BM25 的底层原理,才能在遇到检索效果问题时有的放矢地优化。


 扫一扫


 8459

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


