


VADv2: 基于概率规划的端到端矢量化自动驾驶
从大规模驾驶演示中学习类似人类的驾驶策略是很有前途的,但规划的不确定性和非确定性本质使得这一任务充满挑战。在这项工作中,为了应对不确定性问题,作者提出了VADv2,一个基于概率规划的端到端驾驶模型。VADv2以流方式输入多视角图像序列,将传感器数据转换为环境token嵌入,输出动作的概率分布,并从中采样一个动作来控制车辆。仅使用摄像头传感器,VADv2在CARLA Town05基准测试中实现了最先进的闭环性能,显著优于所有现有方法。它能够在完全端到端的方式下稳定运行,甚至不需要基于规则的封装。
论文链接:https://arxiv.org/pdf/2402.13243
代码链接:https://hgao-cv.github.io/VADv2
一、VADv2简介
从大规模人类驾驶演示中学习类人驾驶策略是有希望的。但是,规划的不确定性使得从驾驶演示中提取驾驶知识是有挑战性的。从统计学习的角度来看,动作(包括实际和速度)是高度随机的,受许多无法建模的潜在因素影响。
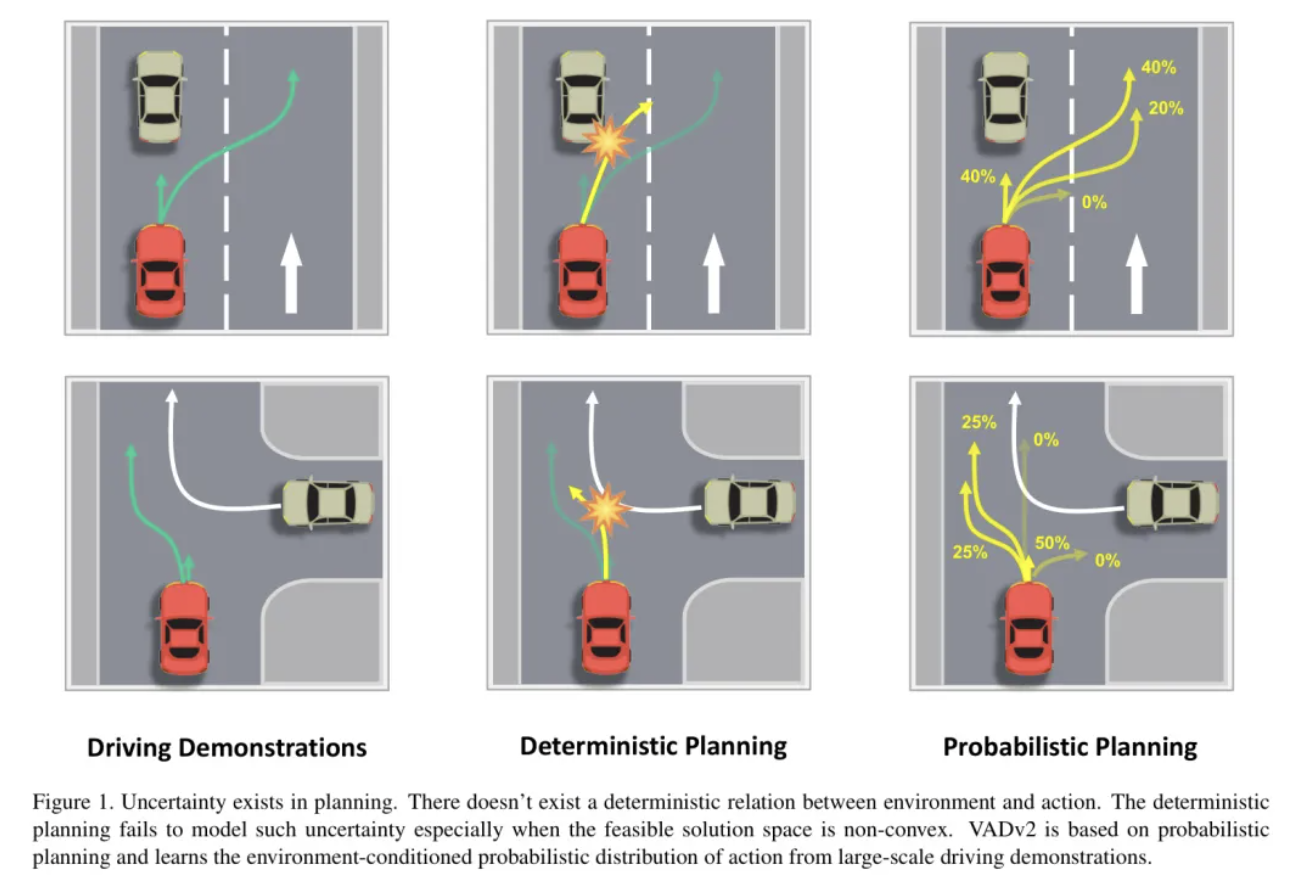
1.1、不确定性场景展示与规则现状
为了展示这种不确定性,图中提出了两种情境:
跟随另一辆车。人类驾驶员有各种合理的驾驶操作,包括保持跟随或变道超车;
与迎面来车的交互。人类驾驶员有两种可能的驾驶操作,即让行或超车。从统计学的角度来看,行动(包括时机和速度)具有高度随机性,受到许多无法建模的潜在因素的影响。
现有的基于学习的方法遵循确定性范式直接回归动作。回归目标 a ^ \hat{a} a^未来轨迹或控制信号(加速度和转向)。这种范式假设环境和动作之间存在确定性的关系,但这并非实际情况。但人类驾驶的差异会导致回归目标的模糊性(尤其对于非凸解空间而言,两个解之间的值可能不是解),且这类方法倾向于输出数据集中出现最多的轨迹(直行或停止),从而导致不高的性能。
1.2、本文对不确定性场景改进
在这项工作中,作者提出了概率性规划以应对规划的不确定性,提出VADv2,第一个在连续的规划解空间上使用概率建模的方法。规划策略被建模为以环境为条件的非静止随机过程 p ( a ∣ o ) p(a∣o) p(a∣o),其中 o o o为历史和当前对驾驶环境的观测, a a a为候选规划行为。与确定性建模相比,概率建模能更有效地捕捉规划中的不确定性,从而实现更准确且安全的规划性能。
规划动作空间是一个高维的连续时空空间。作者求助于概率场函数来建模从动作空间到概率分布的映射。由于直接拟合连续的规划动作空间是不可行的,作者将规划动作空间离散化为一个大的规划词汇表,并使用大量驾驶演示来基于规划词汇表学习规划动作的概率分布。对于离散化,作者收集了所有驾驶演示中的轨迹,并采用最远轨迹采样方法选择N个代表性轨迹,这些轨迹作为规划词汇。该概率建模的方法灵感来自于大型语言模型对文本不确定性的处理。即使用以上下文为条件的、下一单词在大型语料库中的概率分布,并从该分布中采样一个单词作为预测的下一单词。
概率性规划有两个其他优点。(1)可建模行为和环境的关系,可为所有驾驶词汇而非仅正样本提供监督,有更丰富的监督信息;(2)在推断阶段更加灵活,因其输出多模态规划轨迹,容易与基于规则的或基于优化的方法结合,且可灵活添加规划词汇并评估。
1.3、作者贡献
基于概率性规划,作者提出了VADv2,一个端到端的驾驶模型,它以流式方式接收环视图像序列作为输入,将传感器数据转换成标记嵌入,输出动作的概率分布,并采样一个动作来控制车辆。仅使用摄像头传感器,VADv2在CARLA Town05基准测试中实现了最先进的闭环性能,显著优于所有现有方法。丰富的闭环演示可以在https://hgao-cv.github.io/VADv2上找到。VADv2在完全端到端的方式下稳定运行,即使没有基于规则的封装也可以。
1、作者提出概率性规划以应对规划中的不确定性。作者设计了一个概率场,将动作空间映射到概率分布,并从大规模驾驶演示中学习动作的分布。
2、基于概率性规划,作者提出了VADv2,一个端到端的驾驶模型,它将传感器数据转换为环境token嵌入,输出动作的概率分布,并从中采样一个动作来控制车辆。
3、在CARLA模拟器中,VADv2在Town05基准测试上实现了最先进的闭环性能。闭环演示表明,它能够以端到端的方式稳定运行。
二、前期相关工作
2.1、感知工作
感知是实现自动驾驶的第一步,对驾驶场景的统一表征有利于其轻松整合到下游任务中。鸟瞰图(BEV)表示近年来已成为一种常见策略,它有效支持场景特征编码和多模态数据融合。LSS 是一项开创性工作,通过显式预测图像像素的深度来实现透视视图到BEV的转换。
另一方面,BEVFormer 通过设计空间和时序注意力机制,避免了显式的深度预测,并取得了令人印象深刻的检测性能。后续工作通过优化时序建模和BEV转换策略,持续提高了在下游任务中的性能。在矢量化映射方面,HDMapNet 通过后处理将车道线分割转换为矢量地图。VectorMapNet 以自回归方式预测矢量地图元素。MapTR 引入了排列等价和分层匹配策略,显著提升了映射性能。LaneGAP 引入了针对车道图的路径建模。
2.2、运动预测
运动预测旨在预测驾驶场景中其他交通参与者的未来轨迹,辅助自车做出明智的规划决策。传统的运动预测任务利用历史轨迹和高清地图等输入来预测未来轨迹。然而,近年来端到端的运动预测方法将感知和运动预测结合起来。在场景表示方面,一些研究采用栅格化的图像表示并使用卷积神经网络进行预测。
其他方法则采用向量化表示,并使用图神经网络或Transformer模型进行特征提取和运动预测。一些研究将未来的运动视为密集占用和流,而不是个体 Level 的未来航点。一些运动预测方法采用高斯混合模型(GMM)来回归多模态轨迹。这可以应用于规划中来建模不确定性。但模式的数量是有限的。
2.3、规划工作
基于学习的规划由于其数据驱动性质以及随着数据量的增加而带来的令人印象深刻的性能,近年来已显示出巨大的潜力。早期尝试采用了完全的黑箱精神,其中传感器数据直接用于预测控制信号。然而,这种策略缺乏可解释性,且难以优化。此外,还有许多研究结合了强化学习和规划。通过在闭环仿真环境中自主探索驾驶行为,这些方法实现了甚至超越人类水平的驾驶性能。
然而,在模拟与现实之间的架桥,以及处理安全问题,将强化学习策略应用于真实驾驶场景提出了挑战。模仿学习是另一个研究方向,模型通过学习专家驾驶行为以获得良好的规划性能,并发展出接近人类的驾驶风格。近年来,端到端自动驾驶技术已经出现,将感知、运动预测和规划整合到单一模型中,形成了一种完全数据驱动的方法,展示了有前景的性能。UniAD巧妙地整合了多个感知和预测任务以增强规划性能。VAD探索了向量化场景表征用于规划的潜力,并摆脱了密集地图的束缚。
2.4、自动驾驶领域的大型语言模型
大型语言模型(LLM)展示的可解释性和逻辑推理能力可以在自动驾驶领域提供极大的帮助。近期的研究探讨了LLM与自动驾驶的结合。一方面,有用LLM通过问答(QA)任务来进行驾驶场景理解和评估的工作。
另一方面,还有研究更进一步,在基于LLM的场景理解之上加入了规划。例如,DriveGPT4接受历史视频和文本(包括问题及额外的信息,如历史控制信号)作为输入。编码后,这些输入被送入LLM,预测问题的答案和控制信号。而LanguageMPC则接收历史 GT 感知结果和以语言描述形式的高清地图。它采用一种思维链分析的方法来理解场景,最终LLM从预定义的集合中预测规划动作。每个动作对应一个具体的执行控制信号。VADv2从GPT中获得灵感,以解决不确定性问题。不确定性同样存在于语言建模中。
在特定语境下,下一个词是非确定性的和概率性的。LLM从大规模语料库中学习下一个词的条件概率分布,并从这个分布中抽样一个词。受到LLM的启发,VADv2将规划策略建模为一种环境条件下的非定常随机过程。VADv2离散化动作空间以生成规划词汇表,根据大规模驾驶演示近似概率分布,并在每个时间步从分布中抽样一个动作来控制车辆。
三、VADv2方法论
VADv2的总体框架如图所示。

VADv2以流方式接收多视角图像序列作为输入,将传感器数据转换为环境tokens嵌入,输出动作的概率分布,并采样一个动作来控制车辆。使用大规模驾驶演示和场景约束来监督预测的分布。
3.1、场景编码器(Scene Encoder)
图像中的信息是稀疏和低级的。作者使用编码器将传感器数据转换为实例级tokens嵌入 E e n v E_{env} Eenv,直接提取高层级的信息。 E e n v E_{env} Eenv包括四种标记:地图标记tokens、代理标记tokens、交通元素标记tokens和图像标记tokens。
1、VADv2使用一组地图Map Tokens来预测地图的向量表示(包括车道中心线、车道分隔线、道路边界和行人横道)。
2、此外,VADv2还使用一组代理Agent Tokens来预测其他交通参与者的运动信息(包括位置、方向、大小、速度和多模态未来轨迹)。交通元素在规划中也起着至关重要的作用。
3、VADv2将传感器数据转换为交通元素标记 Traffic Element Tokens,以预测交通元素的状态。
4、将Image Tokens 作为规划用的场景表示,包含丰富的信息,可以作为上述实例级的 tokens 的补充。
在CARLA中,作者考虑两种类型的交通信号:交通灯信号和停车标志。通过对应的监督信号来监督 Map Tokens, Agent Tokens 和 Traffic Element Tokens,确保它们显式地编码了对应的高层级信息。此外,用一个 MLP 将导航信息Navigation Info和自车状态Ego State编码为嵌入 { E n a v i , E s t a t e } \lbrace E_{navi}, E_{state} \rbrace {
Enavi,Estate} 。
3.2 概率规划(Probabilistic Planning)
作者提出概率性规划以应对规划过程中的不确定性。作者将规划策略建模为一个条件于环境的非定常随机过程,表述为 p ( a ∣ o ) p(a∣o) p(a∣o)。作者基于大规模驾驶演示近似地估计规划动作空间为一个概率分布,并在每个时间步从该分布中采样一个动作来控制车辆。
规划动作空间是一个高维连续时空空间 A ∈ { a ∣ a ∈ R 2 T } \mathbb{A} \in \lbrace a|a \in \mathbb{R}^{2T} \rbrace A∈{
a∣a∈R2T}。由于直接拟合连续的规划动作空间是不现实的,作者将规划动作空间离散化为一个大的规划词汇表 V ∈ { a i } N \mathbb{V} \in \lbrace a^i \rbrace^N V∈{
ai}N 。具体来说,作者收集了驾驶示例中的所有规划动作,并采用最远轨迹采样方法选择N


 3364


 扫一扫















 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


