HEAR:面向智能体大模型服务的编排器‑推理引擎双向通信协议

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

HEAR:面向智能体大模型服务的编排器‑推理引擎双向通信协议

原文网页:https://arxiv.org/html/2610.06597v1
PDF链接:https://arxiv.org/pdf/2610.06597v1
arXiv编号:arXiv:2610.06597v1 [cs.AI],提交日期:2026‑10‑05

摘要
大模型智能体执行复杂工作流,涉及多轮推理、工具调用、多智能体协同,端到端高效服务需要横跨两层系统做联合决策:智能体编排器(Harness)掌握工作流依赖关系、上下文生命周期、执行目标;推理引擎观测请求队列、KV‑Cache状态、资源压力、执行能力。现有接口无法系统化打通两层视图,难以实现感知工作流的调度执行。
本文提出
HEAR
,一套编排器‑引擎双向配对通信协议(Harness‑Engine pAiRing Protocol),标准化编排器向引擎传递工作流意图与执行约束,同时引擎回传运行时状态、硬件能力与执行结果。协议将语义定义与优化策略解耦,在不改动工作流与模型语义的前提下,支持多种多样协同策略。
本文基于HEAR实现两类协同策略:感知缓存的运行时协同、面向智能体角色的负载感知执行模式选择。在4套对话与研究型智能体基准、内存受限并发服务场景下开展实验:SCBench基准实现1.61倍批处理加速,首token中位生成时间降低2.23倍;Mooncake基准证明,工作流意图与引擎实时状态在不同负载下可以形成互补增益;在BrowseComp‑Plus、DeepResearchBench基准上,面向负载的角色专属配置分别取得1.23倍、2.45倍端到端加速,且任务质量没有发生退化。实验证明HEAR可作为可复用协同底层,实现高效智能体大模型服务。

关键词
大模型智能体;推理服务;KV缓存;双向协议;编排器;调度优化;多智能体;服务系统

目录

  1. 引言
  2. 相关工作
  3. HEAR协议设计
  4. 实验
  5. 结论
  6. 参考文献
  7. 附录简要说明

1 引言

大模型智能体依靠多轮规划、工具调用、多智能体协作完成复杂任务。智能体编排器负责工作流编排、上下文维护、工具交互;vLLM、SGLang等推理引擎负责模型执行、请求批处理、KV缓存管理。端到端效率不只取决于单次模型调用加速,更需要跨工作流对请求与可复用KV状态做协同调度。

协同优化存在根本障碍:决策所需信息分散在两个系统层。

  • 编排器:掌握请求依赖、上下文生命周期、应用目标;看不到引擎侧缓存驻留、请求队列、资源压力。
  • 推理引擎:观测缓存、队列、硬件负载;不理解上层智能体工作流依赖、未来上下文复用意图。

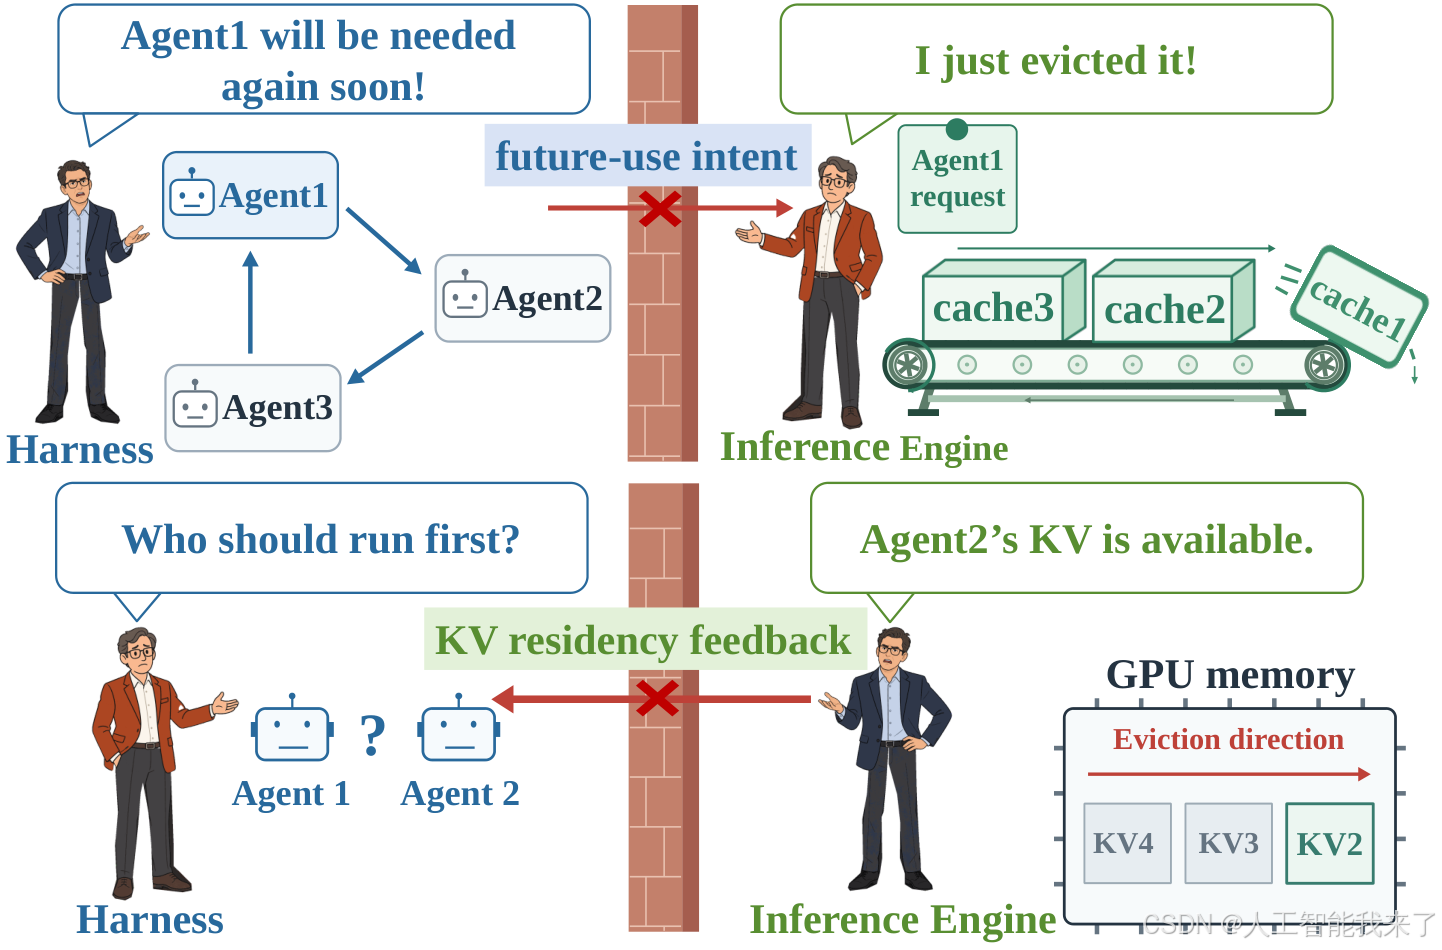
信息割裂会造成典型问题:引擎在KV缓存即将被再次使用时将其驱逐,触发代价高昂的重新预填充;编排器不知道哪些上下文已经驻留在缓存,可能优先调度冷请求,而缓存就绪的请求反而延后执行。执行模式选择同样存在矛盾:需要结合编排器看到的负载特征,以及引擎侧的效率‑质量权衡。因此需要一套双向接口,实现两层信息交换、联合决策。

现有相关工作已经验证工作流信息、运行时反馈对智能体服务的价值,但缺少通用的控制平面抽象。各类优化方案各自定义跨层信号、控制语义、生命周期,策略与特定编排器、推理引擎强耦合,可移植性差,难以组合复用。

本文提出HEAR双向协议:

  1. 将每条交互消息关联到对应请求、上下文版本、服务实例;消息划分为四大语义类别。编排器输出:执行描述与意图、执行约束与控制;引擎回传:状态与能力、执行结果。
  2. 定义消息作用力与操作生命周期,区分描述与指令、偏好与硬性要求、观测与保证、接收确认与执行完成。协议只定义交互语义,不绑定具体优化策略;策略决定交换什么信息、采取什么动作,协议定义消息如何被解析处理。HEAR协调现有工作流的请求调度,不修改任务选择逻辑,不改动模型本身语义。

本文实现两套不同时间尺度下的协同策略:

  1. 感知缓存的运行时协同:编排器传递等待约束、未来复用意图;引擎回传KV驻留状态与队列信息,联合调度请求优先级、控制缓存保留策略。
  2. 角色专属推理配置:粗粒度策略,把智能体角色、输入输出、并发特征映射到引擎支持的推理模式。

本文主要贡献

  1. 提出HEAR编排器‑引擎双向协议,将跨层交互绑定请求与上下文,划分四大语义类别,定义消息作用力与操作生命周期。
  2. 实例化两套执行协同策略:在线缓存感知运行协同、角色感知推理模式配置;同一套交互契约同时支持运行时调度、缓存决策与粗粒度执行模式选择。
  3. 在SCBench、Mooncake、BrowseComp‑Plus、DeepResearchBench开展受控评测;融合编排器意图与引擎状态,对话服务效率提升;研究型智能体工作流取得1.23‑2.45倍端到端加速,任务质量无退化。
    在这里插入图片描述

2 相关工作

2.1 智能体编排框架

AutoGen、AgentScope、LangGraph、Deep Agents等智能体Harness,支持多智能体通信、状态流控制、模型调用、上下文管理与工具调用。这类框架决定智能体执行逻辑、请求就绪时机,但无法直接访问推理引擎内部运行状态:请求队列、批处理、KV缓存驻留、GPU资源压力。HEAR打通边界,把工作流意图传递给引擎,并将引擎状态回传给编排器。

2.2 LLM推理系统

vLLM的PagedAttention、SGLang的RadixAttention、LMCache多级预取、H₂O / SnapKV / OmniKV / KIVI各类KV缓存压缩、选择性保留方案。这些都属于引擎内部机


存储&AI行业每日要闻(2026-10-25 影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题; 阅读详情

相关推荐

第33章 YOLO+OpenCV:视频流网络传输

本案例演示用视觉处理库连接网络视频流并逐帧显示画面。程序先打开流地址,再循环取帧、显示、等待按键退出,并用重试计数应对连接失败与读取中断。验证时关注窗口能否稳定出画、是否长时间卡顿黑屏、退出后终端有无报错。🌈

小哥谈 478

Windows 10错误代码解析与系统故障排除指南

操作系统错误代码是系统运行状态的直接反馈,Windows系统通过特定编码机制将故障信息转化为可识别的错误代码。从技术原理看,这些代码通常对应特定的异常处理流程,包括内存管理、驱动兼容性、文件系统等核心模块。理解错误代码对于系统维护具有重要价值,能快速定位问题根源,提高故障排除效率。在实际应用场景中,蓝屏错误(如0x0000007B)、系统升级失败(如0x80070002)和启动故障是最常见的三类问题。通过分析dump文件、使用WinDbg工具和系统内置诊断功能,可以有效解决大部分系统异常。特别是对于蓝屏错误

weixin_30516429的博客 284

STM32F4的sct文件理解

原文地址http://blog.sina.com.cn/s/blog_898f36590100ya2l.html ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~...

weixin_34008805的博客 988

java结合Ai

Spring AI 是 AI 工程的应用框架。其目标是将Spring生态系统的设计原则(如可移植性和模块化设计)应用于AI领域,并促进使用POJO作为应用程序的构建块到AI领域。特征跨 AI 提供商的可移植 API 支持,适用于聊天、文本到图像和嵌入模型。支持同步 API 和流 API 选项。还支持下拉以访问特定于模型的功能。聊天模型亚马逊基岩人类学Cohere的命令AI21 Labs的侏罗纪-2Meta 的 LLama亚马逊的泰坦人类学克劳德Azure 开放式 AI。

qq_67832732的博客 2843

python爬虫案例——腾讯网新闻标题(异步加载网站数据抓取,post请求)(6)

本篇案例主要讲解异步加载网站如何分析网页接口,以及如何观察post请求URL的参数,网站数据并不难抓取,主要是将要抓取的数据接口分析清楚,才能根据需求编写想要的代码。

@CSDN盲敲代码的阿豪的博客 940

微服务架构下服务注册与发现与治理机制

服务注册中心:注册中心核心功能+实现策略,讲解注册中心核心功能和注册中心实现策略+服务发布与注册+服务发现与调用+服务监控

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 169万+

搭建自己的MQTT服务器,实现设备上云(Ubuntu+EMQX)

这篇文章教大家在ECS云服务器上部署EMQX,搭建自己私有的MQTT服务器,配置EMQX实现设备上云,设备数据转发,存储;服务器我采用的华为云的ECS服务器,系统选择Ubuntu系统。

2万+

AD(十四)调用已有的PCB元件封装库

软件:Altium Designer 16 需要资料:已有的PCB原理图文件(.PCBDOC)或者PCB库文件(.PCBLIB)(来源文中细说) 调用已有的PCB元件封装库(一)从已有的PCB原理图文件(*.PCBDOC)中调用1、PCB原理图文件来源2、打开已有的PCB原理图文件(*.PCBDOC)3、生成PCB封装库4、复制封装到工程文件下的PCB库文件(*.PCBLIB)5、重名问题(二)从已有的PCB库文件(*.PCBLIB)中调用1、PCB库文件(*.PCBLIB)的来源2、打开已有的PCB库 (

Curnane0_0的博客 5074

Python与.NET革命性互操作:PythonNet实现零门槛双向调用——深度解析与实战案例

跨语言调用实战指南:Python与.NET深度集成 摘要:本文详解Python与.NET双向互调技术,通过PythonNet和Python.Runtime实现高效跨语言协作。核心优势包括:无缝集成Python机器学习模块(如PaddleOCR)与.NET UI框架,内存直传提升90%数据效率,减少80%重复代码。内容涵盖:1)Python调用.NET类库的完整流程;2)C#动态加载Python脚本及环境配置要点;3)反射机制实现私有方法调用与泛型处理;4)性能优化技巧(类型缓存、NumPy数组转换);5)异

墨夶的博客 604

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

上一篇: BTTF:面向芯片设计验证智能体系统的EDA基础设施重构方案
下一篇: HERA:面向智能体主动拒止能力的执行框架‑环境协同演化框架
人工智能我来了
博客等级 码龄8年 6365粉丝 1625原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值