Python爬取拼多多商品数据保姆级教程(附源码及效果图)

VIPPython爬取拼多多商品数据保姆级教程(附源码及效果图)
本文介绍了使用Python爬取拼多多商品数据的完整教程。通过DrissionPage库模拟浏览器操作,利用正则表达式提取嵌入在HTML中的商品数据(关键步骤是从window.rawData变量获取),解析后转换为结构化数据并导出Excel。教程包含八大步骤:环境配置、浏览器初始化、网络监听、搜索模拟、数据提取(核心是正则匹配JSON)、数据验证、字段解析和Excel导出,最后提供了封装好的函数可直接调用。该方法特别适合课程作业或毕业设计获取电商数据,能爬取商品名称、价格、销量等关键信息,处理了价格单位转换等
开通可读全文 ·2k 人阅读
最低0.47元/天 解锁文章

前言

考虑到大家期末课程作业或毕业设计等需要数据作为支撑,或者需要提交代码编程作业。本系列分别用三篇文章:京东、淘宝、拼多多数据爬取来讲述数据爬取过程,即便是python入门级小白也能掌握。本篇文章为拼多多爬取教程。(ps:拼多多爬取的坑在于拼多多把数据藏在html文件里面,得用正则匹配和处理数据)

一、安装&导入依赖库

(1)安装库

%pip install DrissionPage pandas openpyxl

(2)导入依赖

# 爬虫库,使用谷歌模拟器
from DrissionPage import ChromiumPage
import re  # 正则表达式库
import json  # JSON解析库
import pandas as pd  # 办公操作库
from datetime import datetime  # 时间库

说明:

  • DrissionPage:用于浏览器自动化操作
  • re:用于正则表达式匹配,提取嵌入在页面中的数据
  • json:用于解析JSON格式的数据
  • pandas:用于数据处理和导出Excel
  • datetime:用于生成带时间戳的文件名

二、初始化浏览器并访问拼多多

创建浏览器实例并访问拼多多搜索页

driver = ChromiumPage()
driver.get('https://mobile.pinduoduo.com/relative_goods.html?__rp_name=search_view&source=index&options=3&shade_words=%E7%BA%B8%E5%B7%BE%E6%8A%BD%E7%BA%B8&ssr_histories=%5B%22%E9%AB%98%E6%A1%A3%E6%AD%A3%E5%93%81%E8%BD%BB%E8%96%84%E7%BE%BD%E7%BB%92%E6%9C%8D%22%5D&refer_page_name=index&refer_page_id=10002_1761990623118_tf6j8y73ut&refer_page_sn=10002')

关键点:

  1. 实例化浏览器对象:创建 ChromiumPage 对象
  2. 直接访问拼多多移动版搜索页:拼多多的移动版页面结构更简单,数据更容易获取

为什么访问移动版?

  • 移动版页面结构更清晰
  • 数据加载方式更直接
  • 反爬机制相对较弱

三、启动网络请求监听

启动监听器

# 启动监听
driver.listen.start('search_result.html')

监听原理:

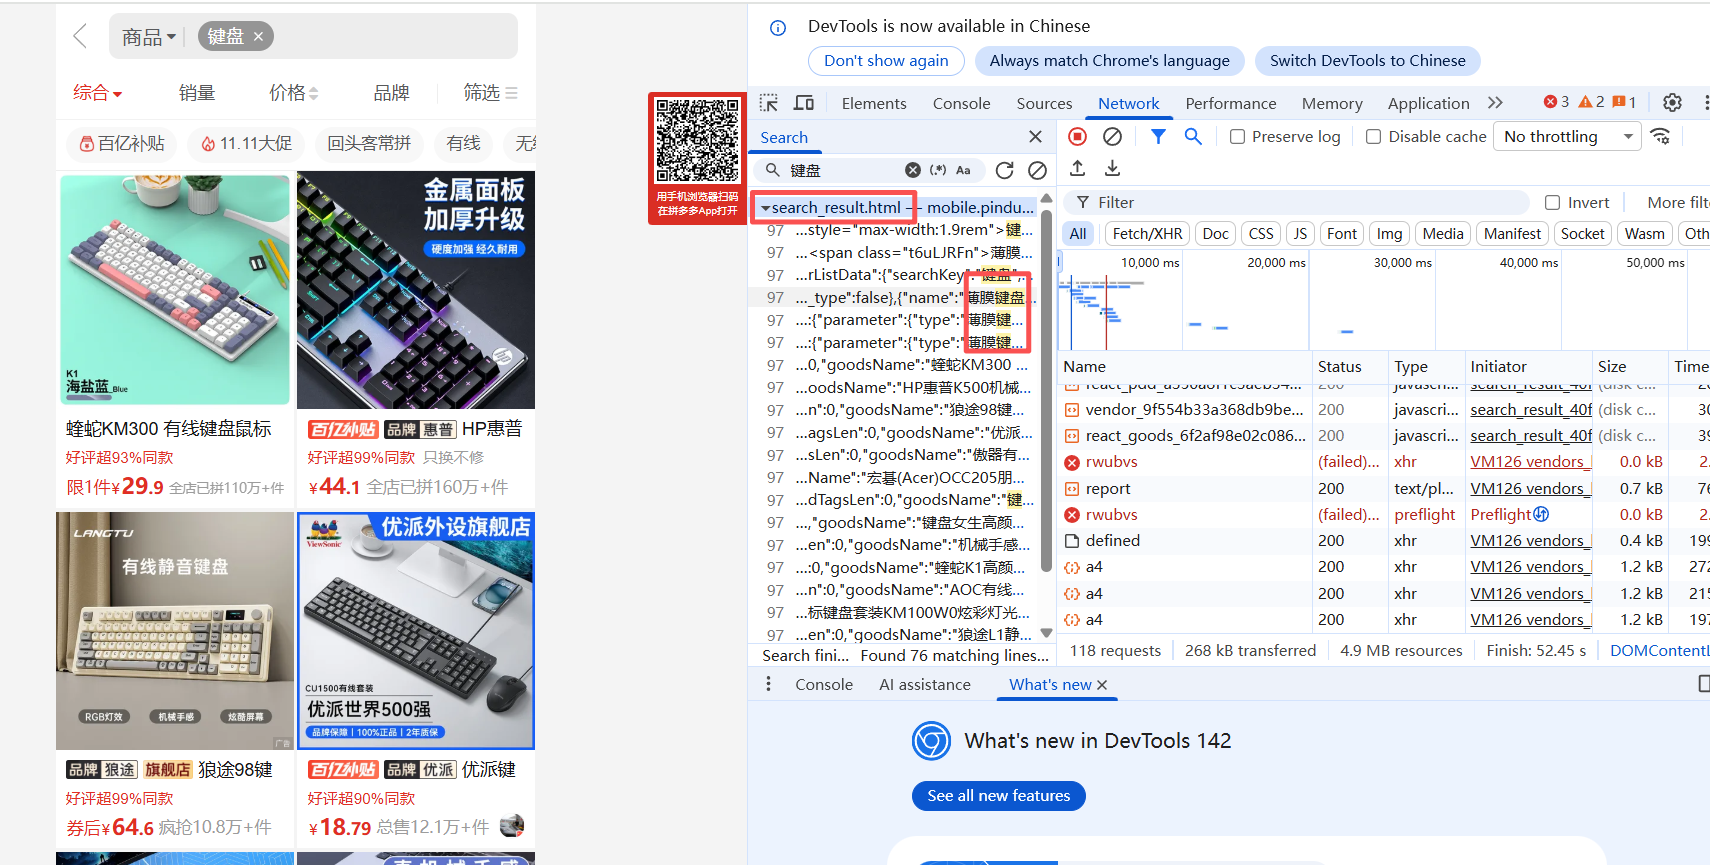
  • 拼多多在搜索时会请求 search_result.html 页面
  • 这个页面包含完整的商品数据
  • 通过监听这个请求,我们可以获取原始HTML内容

与淘宝监听的区别:

  • 淘宝:监听JSON接口(mtop.relationrecommend)
  • 拼多多:监听HTML页面(search_result.html),但数据嵌入在页面的JavaScript变量中

四、模拟用户搜索操作

4.1 输入搜索关键词

driver.ele('css:form input[type="search"]').input('键盘')
  • 使用CSS选择器定位搜索框:form input[type="search"]
  • 输入搜索关键词"键盘"
  • 可以替换成任何你想搜索的商品

4.2 点击搜索按钮

driver.ele('css:.RuSDrtii').click()
  • 使用CSS选择器定位搜索按钮(class名为 RuSDrtii)
  • 点击按钮触发搜索

4.3 等待页面加载

driver.wait(3)

等待3秒,确保搜索结果页面完全加载。


五、提取页面中的数据(核心技术)

5.1 初始化数据存储变量


VIP 爬虫剑谱第十页(关于拼多多商品信息的爬取<修改版>) 关于此前发布了一篇关于爬取拼多多商品信息的博客:爬虫剑谱第七页(输入关键词爬取拼多多商品信息并进行保存)_独一无二的李狗蛋儿的博客-CSDN博客出现了问题,运行结束后无法返回数据,up主在这里重新进行了修正,但让然无法进入商品详情页,只能爬取首页的商品图片等信息,如果有解决方法的朋友可以私信或进行评论。 修正后代码: 需要用到selenium库 from selenium import webdriver from lxml import etree import time #实例化一个浏览器对象( 开通可读全文·2.5k 阅读·0 点赞·7 收藏 阅读全文

相关推荐

Python 爬虫实战之爬拼多多商品做数据分析

通过使用 Python 爬虫技术爬取拼多多商品数据,并进行数据分析,可以为电商企业提供有价值的市场信息和决策支持。在实施过程中,需要掌握 Python 基础知识和爬虫相关库的使用方法,遵循合法性和频率限制原则,确保数据的准确性和可靠性。同时,可以结合数据可视化技术,将分析结果以直观的图表形式展示出来,使结果更加易于理解和应用。通过爬取拼多多商品数据并进行分析,可以了解市场趋势、消费者需求以及竞争对手情况,为企业决策和产品优化提供有力支持。Python 基础知识。发送 HTTP 请求。

2403_87487018的博客 3773

Python爬取京东商品数据保姆级教程(附源码及效果图)

本文介绍了一个基于Python的京东商品数据爬取教程,适合入门级开发者使用。文章详细讲解了从安装依赖库(DrissionPage、pandas等)到完成数据爬取的全过程,包括:1. 模拟用户搜索操作;2. 解析商品标题、价格、销量等关键信息;3. 处理复杂数据格式(如转换万级销量);4. 数据存储与Excel导出。教程提供了完整的封装函数,支持自定义搜索关键词和爬取数量,并包含错误处理和多种元素定位方式。最终数据会按时间戳命名导出为Excel文件,方便用于课程作业或毕业设计。

weixin_46449236的博客 1868

Python爬取淘宝商品数据保姆级教程(附源码及效果图)

本文介绍了一个基于DrissionPage库的淘宝商品数据爬取方法,适用于课程作业或毕业设计。核心步骤包括:1)安装依赖库并初始化浏览器;2)通过监听网络请求获取商品JSON数据(淘宝会伪造两个请求,需获取第二个);3)解析商品标题、价格、销量等关键字段;4)将数据保存为带时间戳的Excel文件。文章提供了完整封装函数,支持自定义搜索关键词和商品数量,即使Python新手也能快速上手。相比直接解析HTML,该方法通过监听接口获取数据更稳定可靠,并能绕过淘宝的部分反爬机制。

weixin_46449236的博客 2050

Python爬虫实战:采集淘宝商品信息并导入EXCEL表格!

文章目录 前言 一、解析淘宝URL组成 二、查看网页源码并用re库提取信息 1.查看源码2.re库提取信息 三:函数填写 四:主函数填写 五:完整代码 前言 本文简单使用python的requests库及re正则表达式对淘宝的商品信息(商品名称,商品价格,生产地区,以及销售额)进行了爬取,并最后用xlsxwriter库将信息放入Excel表格。最后的效果图如下: 提示:以下是本篇文章正文内容 一、解析淘宝URL组成 1.我们的第一个需求就是要输入商品名字返回对应的信息 所以我们这

pythonlaodi的博客 1863

Python爬虫实战:采集淘宝商品信息并导入EXCEL表格

文章目录 前言 一、解析淘宝URL组成 二、查看网页源码并用re库提取信息 1.查看源码2.re库提取信息 三:函数填写 四:主函数填写 五:完整代码 很多人学习python,不知道从何学起。 很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手。 很多已经做案例的人,却不知道如何去学习更加高深的知识。 那么针对这三类人,我给大家提供一个好的学习平台,免费领取视频教程,电子书籍,以及课程的源代码!??¤ QQ群:7

Python_kele的博客 1792

Python 通用爬虫:3 行代码爬取电商公开数据(附源码)

本文分享一个Python 爬虫入门演示脚本,基于 requests 库实现电商公开数据的极简爬取逻辑。脚本以 3 行核心代码为例,拆解了爬虫的基础框架与请求头配置思路,仅用于教学演示。文章附带完整源码,适合 Python 新手理解数据采集原理,严禁用于商业爬取或违规操作。

PyFree_ST的博客 591

Agent + 监控平台:自动诊断告警根因

根因分析、智能监控、AI Agent、告警风暴、异常检测、可观测性、故障诊断在现代分布式系统中,快速定位和解决问题是维持系统稳定性的关键。传统的监控系统虽然能够生成大量告警,但往往缺乏对告警根因的自动诊断能力,导致运维团队在告警风暴中难以快速定位问题。本文深入探讨了将AI Agent技术与监控平台结合,实现告警根因自动诊断的技术架构、理论基础和实现方法。我们将从第一性原理出发,分析根因诊断问题的本质,介绍基于Agent的智能监控系统设计,并通过实际案例展示其应用价值。文章同时涵盖了从理论到实践的全链路,包括

AIGC应用创新大全的博客 299

AI市场风起云涌,ai浏览器是最佳的落地项目,现在ai市场的ai浏览器竞争加剧,得ai浏览器者得天下!

从场景覆盖度来看,AI 浏览器已突破 “网页浏览” 的传统边界,成为连接个人生活、工作、消费的 “超级入口”,这是其他 AI 应用难以比拟的落地优势。在个人生活场景,AI 浏览器可基于用户行为数据主动提供服务 —— 当用户浏览马拉松赛事信息时,浏览器能自动生成 “训练计划 + 装备推荐 + 能量补给方案”,并关联预订链接;在工作场景,Opera Neon 浏览器已实现 “网页内容提取 - 代码生成 - 报告撰写” 的全流程辅助,开发者可直接在浏览器内完成网站开发初稿;

zhang9880000的博客 1083

大白映射 宝马Esys编程设码映射、USB设备映射

大白映射,宝马Esys设码编程、USB设备映射

denson0394的博客 4787

单细胞转录组数据分析全流程:从原始数据到细胞注释

本文详细介绍了单细胞转录组数据分析的全流程,从原始数据读取、环境搭建、数据质控与标准化,到降维聚类、细胞类型注释,以及高级质控与多样本整合。重点阐述了如何利用Seurat等工具进行数据处理,并通过标志基因比对与自动注释方法完成细胞身份鉴定,为研究者提供了一套清晰、可操作的分析指南。

coffee的博客 541

NAO V6 开发环境的配置(附所有文件)

NAO V6开发环境配置前言环境Robot SettingsChoregraphe 2.8.5.10python2.7+naoqi2.8+opencv4.1.0putty与FileZilla 前言 学校的机器人摸索了一段时间,之前摸爬滚打探索环境,之前没接触这类机器人可能会非常艰辛,希望能给需要的人一些帮助。Nao与pepper通用 环境 win10(x64)+naoqi2.8 1、Robot S...

wbhhello的博客 3212

【STM32 CubeMX】I2C中断方式与DMA方式

在STM32 CubeMX环境中,I2C(Inter-Integrated Circuit)通信协议的实现可以采用中断方式或DMA(Direct Memory Access)方式。中断方式通过触发中断来处理数据传输,而DMA方式则利用直接内存访问技术来实现数据传输,减轻了CPU的负担。在选择I2C通信方式时,开发者需要根据具体的应用需求和性能要求来选择合适的方式。STM32 CubeMX提供了图形化配置工具,使得配置I2C通信方式变得更加便捷。

m0_62599305的博客 7736

YOLOv8实战教程:从模型训练到改进的全流程指南

回顾这段YOLOv8的实战历程,从最初的模型训练到后来的各种改进尝试,我深刻体会到目标检测技术的魅力与挑战。YOLOv8作为一款优秀的框架,不仅易用性强,而且具备很强的可扩展性,让我能在其基础上不断创新。未来,我计划在以下几个方向继续探索:一是将YOLOv8与多模态技术结合,尝试实现图像与文本的联合目标检测;二是深入研究自监督学习在YOLOv8中的应用,减少对标注数据的依赖;三是探索YOLOv8在更广泛场景的部署,如机器人、自动驾驶等。

LXY_LOVE36的博客 274

RepHead一种重参数化检测头用于提升YOLOv8在困难样本上的检测性能

在目标检测任务中,困难样本通常是指那些由于特殊背景、遮挡、低分辨率或极度小物体等因素,导致模型难以识别的样本。这类样本对传统YOLO系列模型的影响较大,常常造成漏检或误检。重参数化(Reparameterization)是一种深度学习中常用的技术,旨在通过对网络参数的变换,使得模型在训练过程中能够更加灵活地适应不同的数据特征。通过对原始网络结构的参数进行重新表达,能够引导模型在训练过程中学习到更加有效的特征。本文详细介绍了YOLOv8的改进——RepHead检测头,并深入分析了它在解决困难样本检测中的应用。

博客 1199

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

上一篇: Python爬取淘宝商品数据保姆级教程(附源码及效果图)
下一篇: Chrome插件 - DIY Theme

双11狂欢大促

盲盒赢 定制羽绒服

开启惊喜盲盒,抽取你的专属好礼

— 惊喜奖品抢先看 —
土拨鼠爱coding
博客等级 码龄7年 84粉丝 28原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值