Python:爬取数据出现response.status_code为403解决方法

前言

出现403的返回结果
主要是有些服务器为了防止访问量过大,承受服务器的压力,或者是拒绝你的访问。服务器接收到这个信息,理应返回了这个403的信息

在前一块的代码中解决了
Python:爬取数据出现response.status_code为418解决方法

如果还出现了403的访问错误
可以通过如下解决

1. 原理

服务器拒绝访问,可以通过给服务器登录,获取当前的cookie来得到网址的信任。得以爬取该网址的信息

在head头中加入cookie的信息
具体怎么查找该cookie的信息,可以通过登录你要搜寻的网址,点击F12进行查看cookie信息即可
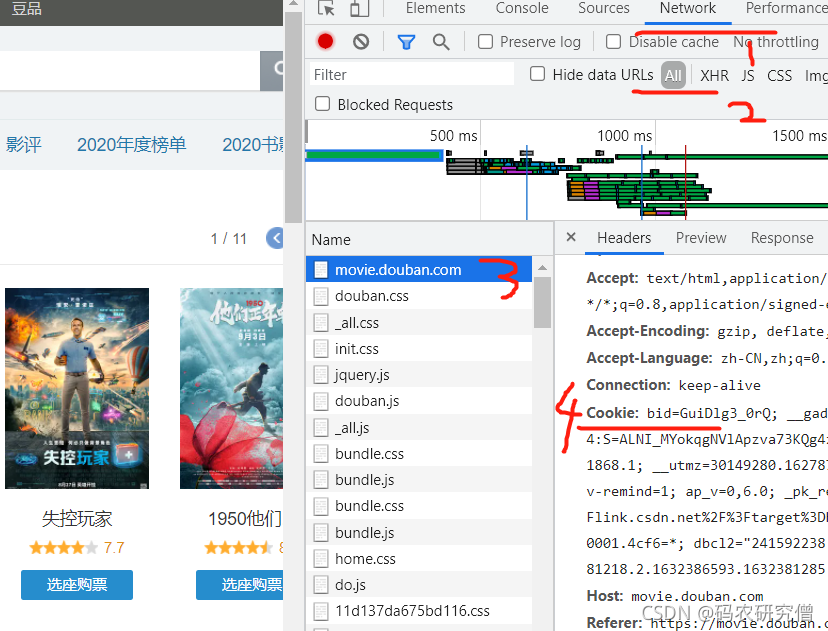
在这里插入图片描述

2. 代码

具体代码设置

head = {
   
   
Python网页表格爬取:三步定位数据源的实战方法 网页表格爬取本质是结构化二维数据(tabular data)的采集任务,其核心难点不在于解析技术本身,而在于准确识别数据真实来源——是静态HTML、AJAX接口还是客户端渲染。理解这一原理,才能避免盲目使用BeautifulSoup或pandas.read_html导致的空列表、结构错乱等问题。通过浏览器Network面板诊断数据流、区分XHR/JSON与HTML响应、结合requests与Playwright分层处理,可显著提升采集稳定性与执行效率。该方法特别适用于竞品价格监控、政府公开数据获取及电商库存 阅读详情

相关推荐

Python requests库raise_for_status方法:从能用变好用的HTTP错误处理实战

HTTP状态码是客户端与服务器通信结果的核心标识,理解其原理是构建稳定网络应用的基础。4xx代表客户端错误,如404资源未找到或429请求过多;5xx代表服务器端错误,如500内部服务故障。主动检查状态码能及时将协议层错误转化为明确的程序异常,避免业务逻辑在错误数据上继续运行,这是提升代码健壮性的关键技术价值。在调用RESTful API、进行数据爬取或集成OpenAI等第三方服务时,这一实践尤为重要。本文以Python requests库为例,深入探讨如何利用.raise_for_status()方法构建

weixin_34088583的博客 331

Python网页文档爬取实战:从Requests到DrissionPage的完整解决方案

网络爬虫是自动化获取互联网公开数据的关键技术,其核心原理是模拟浏览器行为,通过HTTP协议与服务器交互并解析返回的HTML文档。这项技术的价值在于能够将海量、分散的网络信息高效转化为结构化数据,为数据分析、市场研究和知识库构建提供原料。在工程实践中,爬虫广泛应用于批量采集行业报告、学术论文、产品手册等文档资源。针对静态页面,Requests库以其轻量高效成为首选;而当遇到由JavaScript动态渲染的内容时,则需要借助DrissionPage或Selenium等工具来执行脚本并获取完整DOM。本文聚焦于网

weixin_34050005的博客 308

Python Requests + XPath 爬取六只脚轨迹数据:30页/870条实战与反爬策略

本文详细介绍了使用Python Requests和XPath技术高效爬取六只脚平台户外轨迹数据的实战方法,包括自动登录、多页数据爬取、反爬策略应对及数据存储处理。通过30页/870条数据的实战案例,展示了如何构建健壮的爬虫系统,并提供了反爬机制应对方案和数据可视化示例,助力研究人员和数据分析师获取有价值的时空信息。

weixin_30628801的博客 374

抖音博主数据爬取实战:抓包分析与Python自动化实现

网络爬虫是数据采集领域的一项基础技术,其核心原理是通过模拟客户端请求与服务器进行通信,从而获取并解析目标数据。这项技术对于数据分析、市场研究等场景具有重要价值。在社交媒体分析、竞品监测等应用场景中,获取公开的博主主页数据是常见需求。然而,面对抖音这类采用严格反爬机制的大型平台,传统的网页爬虫方法往往失效。本文聚焦于通过抓包分析App真实接口这一关键技术路径,详细讲解了如何使用Fiddler等工具进行协议逆向,并利用Python的requests库模拟复杂请求,最终构建一个稳定、可自动化的数据采集方案,有效应

weixin_34239592的博客 399

抖音博主数据爬取实战:从抓包分析到Python自动化实现

网络爬虫是数据采集领域的核心技术,其核心原理是通过模拟客户端请求,从目标服务器获取结构化数据。在数据驱动决策的背景下,高效、稳定的数据采集技术具有重要价值,广泛应用于市场分析、舆情监控和学术研究等场景。面对抖音这类采用动态渲染和复杂反爬机制的单页面应用,传统的静态页面解析方法往往失效。本文聚焦于通过抓包工具定位核心API接口,并深入解析请求参数与签名机制,特别是针对X-Bogus等关键加密参数的处理。基于Python的Requests库,文章详细演示了如何构建一个完整的自动化爬虫框架,涵盖会话管理、参数模拟

weixin_34245749的博客 418

python爬虫返回403错误?加了请求头+代理也解决不了 >>看这

【疑惑】:使用python的requests库发起get或post请求返回403代码错误,使用postman发起请求发现状态码竟然成功了。首先排除ip问题,ip有问题的话postman也访问不了。难道是headers出现了问题吗,通过对比发现也不是headers的问题。【解疑】:其实遇到这种情况大概率是遇到了“原生模拟浏览器 TLS/JA3 指纹的验证”,浏览器和postman都有自带指纹验证,而唯独requests库没有。这就让反爬有了区分人为和爬虫的突破口。2、使用 pyhttpx 库。

云霄IT的博客 1万+

关于抓包返回数据正常,浏览器请求报403错误的解决方法

不知道大家遇到过没有,我们使用诸如Fiddler、Charles进行抓包的时候是正常的,但是当我们将请求的Url链接拷贝到浏览器中进行请求的时候,就会403错误。403错误是我们网络请求中常见的【禁止访问】错误。如下所示,我们在Charles中是正常的,但是在浏览器中或者使用Postman进行访问时就会出现403错误。 对于这种403禁止访问的错误,我们一般只需要加上对应的header参数即可。具体需要哪些参数,可以将完整的请求拷贝过来,然后进行头信息分析。通常需要的参数如下: req.add_head

xiangzhihong8的专栏 4519

Go语言AI智能体开发实战:基于LangGraphGo构建下一代工作流引擎

在AI应用开发领域,工作流编排是构建复杂智能系统的核心技术。其核心原理是将任务执行过程建模为状态图,通过节点和边的组合定义数据流转路径,实现多步骤推理与工具调用的自动化。这种基于状态图的编程模型,为智能体提供了清晰的“思考-行动-观察”循环抽象,显著提升了复杂业务逻辑的可维护性和可观测性。从技术价值看,它解决了传统代码中状态分散、流程僵化的问题,支持条件分支、并行执行等高级模式,是实现生产级AI应用的关键基础设施。在应用场景上,该技术广泛适用于客服机器人、自动化审批、数据ETL等需要多步骤协调的领域。本文以

weixin_30457551的博客 354

保姆级教程:用dnSpy调试Unity游戏,从找DLL到打断点全流程(附调试版mono.dll下载)

本文详细介绍了使用dnSpy调试Unity游戏的全流程,包括环境准备、关键程序集定位、mono.dll版本匹配与替换、调试环境配置及实战技巧。通过本教程,开发者可以高效进行Unity游戏逆向分析,适用于学习设计模式或安全审计等场景。

weixin_30236595的博客 574

OctoMag: An Electromagnetic System for 5-DOF Wireless Micromanipulation

电磁线圈组驱动经典系统,可以作为参考。 OctoMag: 用于5自由度无线微操作的一个电磁铁系统 OctoMag: An Electromagnetic System for 5-DOF Wireless Micromanipulation [1] Paper Link Authors: J. J. Abbott, etc. 2010, TRO IEEE Transactions on Robot...

XU Yangxin的博客 1661

总结个人关于雷达样式的见解(脉内脉间调制)

概述 雷达有各种各样的脉内脉间调制样式,对于雷达的设计者来说,不外乎三个目的: 1、增加雷达性能,如提高测距精度,增大侦察距离等; 2、雷达的工作机制决定雷达必须采用此种样式的调制,如有些SAR雷达为保证径向测距精度,需要使用脉内宽带调制信号; 3、降低雷达被电子战装备截获的概率,也就是LPI设计。 对于雷达对抗方,则只会观察到信号存在脉内及脉间的调制。对于一般的雷达信号,通常只采用脉内调制,脉间频率调制,脉间PRI调制。 脉间调制类型 1、PD雷达的脉间特征 雷达进行脉间调制的主要是PRI..

年糕的博客 3万+

【人工智能】Spring AI项目在定义 `response_format` 的 Invalid schema for response_format ‘custom_schema‘

确保。

奶爸的编程之路,也就一周冷个三天 553

Python爬虫实战:绕过Cloudflare反爬的最新技术与完整代码详解

在互联网数据采集领域,越来越多的网站开始部署CDN和安全防护服务,其中 Cloudflare 是最为广泛使用的防护方案之一。它不仅为网站提供DDoS防护,还能通过JS挑战、验证码和行为分析来识别并拦截爬虫。这给爬虫工程师带来了极大挑战——如何在不违反网站服务条款的情况下,实现有效的数据采集?本文将分享Python领域绕过Cloudflare反爬的最新技术方法,结合最新流行库与自动化浏览器,帮助你攻克这一难题。绕过Cloudflare反爬不是一蹴而就,需结合多技术、多策略,持续迭代。

2201_76125261的博客 2622

java技术专家【面试】Java程序员英语面试整个流程

java技术专家【面试】Java程序员英语面试整个流程

大壮 747

[自动化工具] 解放双手的利器:「自动邮件平台」工具助你高效搞定重复通知任务

摘要:自动邮件平台是一款零门槛自动化工具,帮助用户高效处理重复性邮件任务。该平台支持两种调度模式(指定日期和间隔天数),无需编码即可快速设置账单提醒、活动通知等任务。提供免费托管版(小时级调度)和自主部署版(分钟级调度),满足不同精度需求。典型应用场景包括客户跟进、系统监控等周期性任务。用户只需三步即可完成设置,还能扩展定制化功能。该工具让非技术人员也能轻松实现邮件自动化,释放时间专注更重要的工作。

每日出拳老爷子的博客 103

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

上一篇: Python:爬取数据出现response.status_code为418解决方法
下一篇: 【leetcode】栈-最长有效括号
码农研究僧
码农研究僧 优质创作者: 编程框架技术领域 优质创作者: 编程框架技术领域 领域专家: 后端开发技术领域 领域专家: 后端开发技术领域
博客等级 码龄6年 31万+粉丝 1378原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

码农研究僧

你的鼓励将是我创作的动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

