Q学习(Q-learning)入门小例子及python实现

VIPQ学习(Q-learning)入门小例子及python实现
一、从马尔科夫过程到Q学习# 有一定基础的读者可以直接看第二部分Q学习(Q-learning)算法是一种与模型无关的强化学习算法,以马尔科夫决策过程(Markov Decision Processes, MDPs)为理论基础。标准的马尔科夫决策过程可以用一个五元组<S,A,P,R,γ>表示,其中:S是一个离散有界的状态空间; A是一个离散的动作空间; P为状态转...
开通可读全文 ·4.7w 人阅读
最低0.47元/天 解锁文章

一、从马尔科夫过程到Q学习

# 有一定基础的读者可以直接看第二部分

Q学习(Q-learning)算法是一种与模型无关的强化学习算法,以马尔科夫决策过程(Markov Decision Processes, MDPs)为理论基础。

标准的马尔科夫决策过程可以用一个五元组<S,A,P,R,γ> 表示,其中:

  • S是一个离散有界的状态空间;
  • A是一个离散的动作空间; 
  • P为状态转移概率函数,表示agent在状态s下选取动作a后转移到a'的概率;
  • R为回报函数,用于计算agent由当前状态 选取动作 后转移到下一状态 得到的立即回报值,由当前状态和选取的动作决定,体现了马尔科夫性的特点;
  • γ是折扣因子,用于确定延迟回报与立即回报的相对比例, 越大表明延迟回报的重要程度越高。

马尔科夫决策问题的目标是找到一个策略 ,使其回报函数 的长期累积值的数学期望
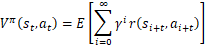
 

最大。其中,策略π只和状态相关,与时间无关(静态的)。  是t时刻的环境状态,  是t时刻选择的动作。

根据Bellman最优准则,得到最优策略 对应的最优指标为:
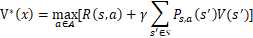
其中, R(s,a)为r(st,at)的数学期望, 为在状态s下选取动作a后转移到下一状态状态s'的概率。由于某些环境中状态之间的转移概率P不容易获得,直接学习 是很困难的,而Q学习不需要获取转移概率P,因而可用来解决此类具有马尔科夫性的问题。

Q学习是一种与环境无关的算法,是一种基于数值迭代的动态规划方法。定义一个Q

VIP Q学习(Q-Learning)详解 Q学习的核心是Q值(Action-Value Function),它表示在特定状态下采取某个动作所能获得的期望回报。QsaERt∣StsAtaQsaERt​∣St​sAt​aQsaQ(s, a)Qsa:在状态sss下采取动作aaa的Q值。RtR_tRt​:在时间步ttt获得的奖励。Q值函数的目标是通过学习来估计在每个状态下采取每个动作的长期回报。 开通可读全文·3.3k 阅读·17 点赞·26 收藏 阅读全文

相关推荐

Q-learning原理及其实现方法

Q_learning原理及其实现方法声明简介Q_learning算法Q_learning算法流程 声明 学习博客快乐的强化学习1——Q_Learning及其实现方法,加之自己的理解写成,同时欢迎大家访问原博客 简介 Q-Learning是一种 value-based 算法,即通过判断每一步 action 的 value来进行下一步的动作,以人物的左右移动为例,Q-Learning的核心Q-Tabl...

zhf的博客 2万+

深度强化学习研究笔记(2)——Q-learning(Q-learning问题描述,Q-table方法,一个Python小例子)

文章目录1. Q-learning2. 1. Q-learning Q-learning是一种典型的基于价值(Value)函数的强化学习方法,其中的Q是一个数值,通常在初始化时有可能被赋予一个任意数值(因问题场景而异),在迭代时刻ttt,我们有状态sts_tst​,此时代理做出动作ata_tat​,然后得到奖励rtr_trt​,从而进入到一个更新的状态st+1s_{t+1}st+1​,从而Q值得到...

越野者的博客 8292

python强化学习之Q-learning算法

强化学习是什么? 简单来说就是通过感知周围环境而行动,以取得最大化收益的一个过程。 其中Q-learning算法的感知状态为离散,无规律。 华丽的分割线--------------------------------------------------------------------------- 一. 组成 首先介绍一下强化学习最重要的几个部分: 智能体(agent):可以是一个简单的算法,通常输入为state,输出为policy(规则) 状态集(states): 为智能体的输入 动作集(action

weixin_45776027的博客 4843

【人工智能】强化学习入门:使用Python实现Q-Learning算法进行迷宫导航

强化学习是机器学习中的一个重要领域,用于训练智能体通过不断尝试和反馈学习最优决策策略。Q-Learning是一种常见的强化学习算法,能够帮助智能体找到一个给定环境(例如迷宫)中的最优路径。本文将详细介绍Q-Learning的数学原理、Q表的构建、Python实现,以及如何在迷宫环境中训练智能体找到最短路径。文章提供丰富的代码示例和详细注释,帮助读者从零开始构建一个Q-Learning模型,并理解其在强化学习任务中的应用。

一个被知识诅咒的人 1486

强化学习Q-learning的理解与python实现

Q-learning介绍 在介绍Q-learning这一基础的强化学习方法之前,首先要知道Q值代表什么。Q值翻译成中文是状态动作价值的意思,通俗一点来讲就是假设有个无所不知的上帝(先验),在凡人(智能体)当前处于某一状态s时,他可以从一定范围的动作(如a、b、c)中选择一个执行,而上帝会根据凡人的选择给出一个分数(因为上帝无所不知,所以知道凡人在选择了动作a之后会发生的所有事情)。比如凡人选择了a,上帝会给出80分,选择b的话上帝会给70分,选择c的话上帝会给60分,那么凡人在当前状态下肯定会选择分数最高的

秋水中的鱼的博客 2737

Q Learning算法实现

Q learning 算法是一种value-based的强化学习算法,Q是quality的缩写,Q函数 Q(state,action)表示在状态state下执行动作action的quality, 也就是能获得的Q value是多少。算法的目标是最大化Q值,通过在状态state下所有可能的动作中选择最好的动作来达到最大化期望reward。Q learning算法使用Q table来记录不同状态下不同动作的预估Q值。

m0_52209879的博客 2148

强化学习Q-Learning解决FrozenLake例子(Python)

import gym import numpy as np import random import matplotlib.pyplot as plt # gym创建冰湖环境 env = gym.make('FrozenLake-v0') # 初始化Q表格,矩阵维度为【S,A】,即状态数*动作数 Q_all = np.zeros([env.observation_space.n,env....

7931

一个完整的 Double Q-Learning示例(python实现)

外层循环:控制训练的总回合数(episodes)内层循环:控制每个回合内的交互步数(steps)智能体 - 环境交互:执行动作 → 接收反馈 → 更新策略数据预处理多轮实验取平均以减少随机性移动平均平滑曲线,突出趋势视觉编码颜色区分不同算法区间填充表示不确定性可读性优化清晰的标题和轴标签适当的网格线和图例此代码通过科学的可视化设计,为强化学习算法对比提供了直观的分析工具,有助于快速识别算法性能差异和稳定性特征。数据预处理确保 Q 表数值范围合理,避免极端值影响整体可视化效果。

搏博的专栏 1585

Q学习算法(Q-learning)

讲述Q学习算法基本原理,并通过几个小例子初步了解q学习算法应用。

从仿真到部署:基于ROS2与Gazebo的UR5e机械臂全流程控制实践

本文详细介绍了基于ROS2与Gazebo的UR5e机械臂全流程控制实践,从环境准备、模型构建到控制器开发和仿真优化,最终实现真实机器人部署。通过实战案例和避坑指南,帮助开发者掌握机器人仿真与控制的关键技术,提升UR5e机械臂在物料分拣等任务中的性能与稳定性。

weixin_29184371的博客 282

STM32+EC800M-CN 4G模块数据透传踩坑实录:从AT指令调试到花生壳内网穿透

本文详细介绍了STM32与移远EC800M-CN 4G模块的数据透传实现过程,包括硬件连接、AT指令调试、TCP连接建立以及花生壳内网穿透配置。通过实战案例和代码示例,帮助开发者快速解决4G通信模块在物联网应用中的常见问题,提升数据传输稳定性。

weixin_42715608的博客 316

SPI为什么不需要加上拉电阻

大家好,我是记得诚。I2C因为其开漏的结构,无法输出高电平,所以外部加上拉电阻。我们在使用SPI的时候,发现是不需要加上拉电阻的。主要因为SPI多为推挽的结构,推挽电路,高低电平都可以输出,所以外部不需要加上拉电阻。推挽电路可以用2个三极管或者2个MOS管搭建而成。

记得诚 2600

基于ESP32 蓝牙游戏手柄设计

介绍使用 ESP32 并通过 BLE 通信的 设计手持游戏手柄,包含原理图与代码

DT程序员的博客 2152

Open3D 使用RANSAC分割平面【2026最新版】

使用RANSAC从点云中分割平面,用segement_plane函数。博客长期更新,本文最新更新时间为:2026年2月28日。

点云侠的博客 37万+

BMS控制板硬件设计核心要点与工程避坑指南

电池管理系统(BMS)硬件设计是保障锂电安全与寿命的关键环节,其本质是模拟前端精度、数字控制可靠性、电源完整性及电磁兼容性四大要素的系统协同。理解AFE芯片(如BQ76920)的物理层约束、MCU与专用监控IC的异构分工逻辑,是构建高鲁棒BMS的基础;而晶振布局、I²C总线匹配、MOSFET体二极管方向、开尔文采样等细节,直接决定量产良率与EMC合规性。在电动工具、储能系统、两轮电动车等中低功耗BMS应用中,成本敏感型方案常采用STM32F0+AFE架构,此时电源滤波电容选型、复位电路ESR控制、TVS/齐

weixin_30591519的博客 254

openclaw 保姆级部署与核心玩法解析:国产DeepSeek模型 + 飞书

OpenClaw是一款功能强大的开源AI个人助理,支持全平台私有化部署,数据完全本地掌控。它不仅可通过聊天窗口直接操控电脑(安装软件、创建项目),还支持接入飞书等主流通讯工具,化身24小时在线的智能助理。本文提供了从零开始的详细部署教程,涵盖基础安装、模型配置(如GLM-4、DeepSeek)到飞书集成的完整实战指南,助你将这款“核动力”AI助手快速融入日常工作流。

甘蓝的专栏 2982

Unity 热更新技术 |(六)xLua框架学习最新系列完整教程

开始学习热更新方面系列知识,就从这一篇开始吧! 本系列教程 会从热更新基本概念出发,详细介绍热更新相关的全套知识点。 如热更新技术基本原理、热更新主流方案、AssetBundle系列教程、Lua语言编程、Lua与Unity交互教程、Xlua框架使用、热更新实战教程等方面。 热更新作为一个开发者必备技能,如果想学习的话,可以从现在开始了哦~ 接下来先从XLua学习使用 开始学习吧!

努力前行,总会成为自己心中的那道光 1万+

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

下一篇: 用R语言实现Q学习

双11狂欢大促

盲盒赢 定制羽绒服

开启惊喜盲盒,抽取你的专属好礼

— 惊喜奖品抢先看 —
葭月丶拾玖
博客等级 码龄8年 25粉丝 3原创
评论 9
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值











