


目录
论文题目:Gold-YOLO: Efficient Object Detector via Gather-and-Distribute Mechanism(Gold-YOLO:高效的基于聚集-分散机制的目标检测器)
论文地址:http://arxiv.org/pdf/2309.11331
论文代码:https://github.com/huawei-noah/EfficientComputing/tree/master/Detection/Gold-YOLO
MindSpore代码:models: Models of MindSpore - Gitee.com
发表时间:2023/10/23
作者单位:华为诺亚方舟实验室
摘要
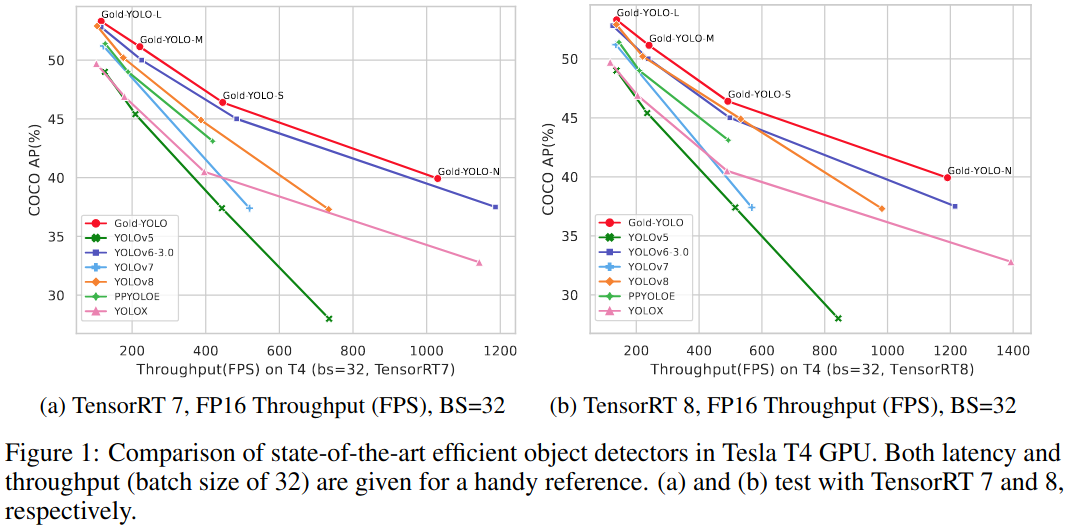
在过去的几年中,YOLO系列模型已经成为实时目标检测领域的主流方法。许多研究通过修改架构、增加数据和设计新的损失将基线推向了更高的水平。然而,尽管特征金字塔网络( Feature Pyramid Network,FPN )和路径聚合网络( Path Aggregation Network,PANet )缓解了这一问题,我们发现之前的模型仍然存在信息融合问题。因此,本研究提供了一种先进的Gatherand-Distribute机制( GD机制),该机制通过卷积和自注意力操作实现。这种新设计的模型被命名为Gold-YOLO,它提高了多尺度特征融合能力,并在所有模型尺度上实现了延迟和精度之间的理想平衡。此外,我们首次在YOLO系列中实现了MAE风格的预训练,使得YOLO系列模型可以从无监督预训练中获益。Gold-YOLO-N在COCO val2017数据集上获得了39.9%的AP,在T4 GPU上获得了1030个FPS,比之前FPS相近的SOTA模型YOLOv6-3.0-N提高了+2.4%。
图2:本文提出的Gold-YOLO的体系结构。

具体来说,GD机制包括两个分支:浅层聚集分布分支和深层聚集分布分支,分别通过基于卷积的块和基于注意力的块提取和融合特征信息。为了进一步促进信息流动,我们引入了一个轻量级的相邻层融合模块,该模块在局部尺度上结合了相邻层的特征。我们的Gold-YOLO架构超越了现有的YOLO系列,有效地证明了我们提出的方法的有效性。
1 相关工作
1.1 实时目标检测器
经过多年的发展,YOLO系列模型已经成为实时目标检测领域的研究热点。YOLOv1-v3构建初始YOLOs,识别单阶段检测架构,由主干-颈部-头部3部分组成的检测结构,通过多尺度分支预测不同大小的目标,成为具有代表性的单阶段目标检测模型。YOLOv4对之前使用的darknet主干结构进行了优化,提出了Mish激活函数、PANet和数据增强方法等一系列改进。YOLOv5继承了YOLOv4的方案,并改进了数据增强策略和更多种类的模型变体。YOLOX将Multi positives、无锚点和Decoupled Head融入到模型结构中,为YOLO模型设计提供了新的范式。YOLOv6首次将重新参数化方法引入到YOLO系列模型中,提出了EfficientRep Backbone和Rep-PAN Neck。YOLOv7重点分析了梯度路径对模型性能的影响,提出了E-ELAN结构,在不破坏原有梯度路径的情况下,增强了模型能力。YOLOv8利用了之前YOLO模型的优点,并将它们集成在一起,实现了当前YOLO家族的SOTA。
1.2 基于Transformer的目标检测
视觉转换器(Vision Transformer,ViT)作为卷积神经网络( Convolutional Neural Networks,CNNs )的竞争性替代者应运而生,被广泛应用于不同的图像识别任务中。DETR 将转换器结构应用于目标检测任务,重构了检测流水线,省去了许多手工设计的部件和NMS组件,简化了模型设计和整体流程。Deformable DETR将可变形卷积的稀疏采样能力与变压器的全局关系建模能力相结合,在提高模型速度和精度的同时提高了收敛速度。DINO首次引入了对比度去噪、混合查询选择和两次向前看方案。最近的RT-DETR改进了编码器-解码器结构以解决慢速DETR-like模型问题,在精度和速度上都优于YOLO-L/X。然而,DETR-like结构的局限性使其在小模型区域中无法表现出足够的优势,而YOLOs保持了精度和速度平衡的SOTA。
1.3 用于目标检测的多尺度特征
传统上,不同层次的特征携带着不同大小物体的位置信息。较大的特征包含低维的纹理细节和较小物体的位置。相比之下,较小的特征包含高维信息和较大物体的位置。提出的特征金字塔网络( Feature Pyramid Networks,FPN )的原始思想是这些多样化的信息可以通过相互协助来增强网络性能。FPN通过跨尺度连接和信息交换为融合多尺度特征提供了一种有效的架构设计,从而提高了不同尺寸目标的检测精度。
在FPN的基础上,路径聚合网络( Path Aggregation Network,PANet )融入了一条自下而上的路径,使得不同层级之间的信息融合更加充分。类似地,EfficientDet提出了一种新的可重复模块(Bi FPN)来提高不同层级之间的信息融合效率。M2Det提出了一种具有U型和特征融合模块的高效MLFPN架构。Ping-Yang Chen利用双向融合模块改善了深、浅层之间的相互作用。与这些层间工作不同,使用集中特征金字塔(Centralized Feature Pyramid,CFP)方法探索个体特征信息。此外,用渐近特征金字塔网络( Asymptotic Feature Pyramid Network,AFPN )扩展了FPN,使其可以跨越不相邻的层进行交互。针对FPN在检测大型物体时的局限性,提出了一种改进的FPN结构。YOLO-F实现具有单层次特征的最先进的性能。SFNet将不同级别的特征与语义流进行对齐,以提高模型中FPN的性能。SAFNet引入了自适应特征融合和自增强模块。文献[ 4 ]提出了一种用于双向融合目标检测的并行FPN结构。然而,由于网络中路径数量过多和间接交互方式较多,以往基于FPN的融合结构在速度慢、跨层信息交换和信息丢失等方面仍存在弊端。
2 方法
2.1 预备知识
如图3所示的YOLO系列颈部结构采用了传统的FPN结构,该结构包含多个用于多尺度特征融合的分支。然而,它只能完全融合来自相邻层的特征,对于其他层的信息只能通过"递归"的方式间接获得。

在图3中,它显示了传统FPN的信息融合结构:其中,现有的1,2和3级从上到下排列。FPN用于不同层次之间的融合。当水平1从另外两个水平获取信息时,存在两种截然不同的情景:
1)如果level-1试图利用level-2的信息,它可以直接访问和融合这些信息。
2)如果level-1要使用level-3信息,则level-1应递归调用相邻层的信息融合模块。具体来说,首先要融合level-2和level-3信息,然后第1层通过融合level-2信息间接获得level-3信息。
这种传递方式会导致计算过程中信息的大量损失。层与层之间的信息交互只能交换被中间层选择的信息,没有被选择的信息在传输过程中被丢弃。这就导致了一种情况,即某一层的信息只能充分地辅助邻近层,削弱了提供给其他全局层的帮助。因此,信息融合的整体效果可能受到限制。
为了避免传统FPN结构在传输过程中的信息丢失,我们摒弃了原有的递归方法,构建了一种新的聚集-分散机制(GD)。通过使用一个统一的模块来收集和融合来自各级的信息,并随后将其分配到不同的级别,不仅避免了传统FPN结构固有的信息丢失,而且在没有显著增加延迟的情况下增强了颈部的部分信息融合能力。因此,我们的方法可以更有效地利用骨干提取的特征,并且可以很容易地集成到任何现有的骨干-颈部-头结构中。
在我们的实现中,聚集和分散过程对应于三个模块:
特征对齐模块(FAM)
信息融合模块(IFM)
信息注入模块(Inject)
▲聚集过程包括两个步骤。首先,FAM从不同层次收集和对齐特征。其次,IFM将对齐后的特征进行融合生成全局信息。
▲在从聚集过程中获得融合的全局信息后,注入模块将这些信息分布在每个层次上,并使用简单的注意力操作进行注入,从而增强分支的检测能力。
为了增强模型对不同大小目标的检测能力,我们开发了两个分支:低级聚集分布分支(Low-GD)和高级聚集分布分支(High-GD)。这些分支分别提取和融合大尺寸和小尺寸的特征图。
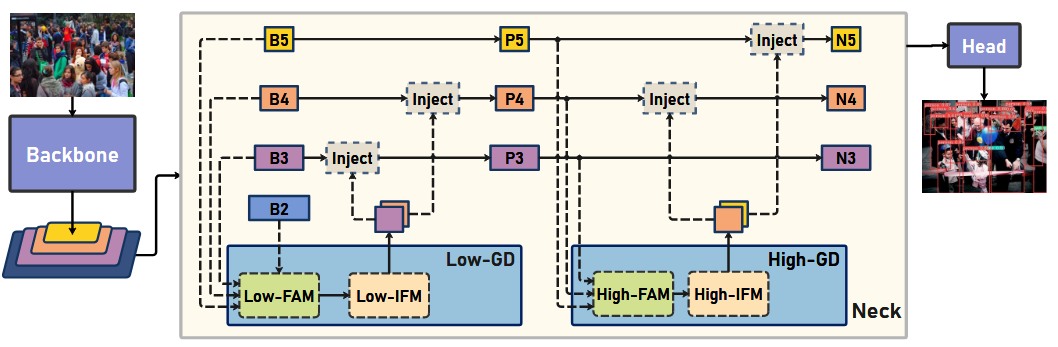
如图2所示,颈部的输入由骨架提取的特征图B2,B3,B4,B5组成,其中,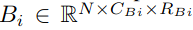 。批次大小用N表示,通道用C表示,尺寸用R=H×W表示。此外,RB2、RB3、RB4和RB5的维度分别为R、1/2R、1/4R和1/8R。
2.2 低级集散分支
该分支选取主干输出的B2、B3、B4、B5特征进行融合,得到保留小目标信息的高分辨率特征。结构见图4(a)。

▲低级特征对齐模块
在低级特征对齐模块(Low-FAM)中,我们使用平均池化(AvgPool)操作对输入特征进行下采样,并实现了统一的尺寸。通过将特征调整到(RB4 = 1/4R)组的最小特征尺寸,我们得到了Falign。Low-FAM技术保证了信息的高效聚合,同时通过Transformer模块最小化了后续处理的计算复杂度。
目标对齐尺寸的选择基于两个相互矛盾的考虑:(1)为了保留更多的低层信息,较大的特征尺寸是可取的;(2)随着特征尺寸的增加,后续块的计算延迟也随之增加。为了控制颈部的延迟,需要保持较小的特征尺寸。
因此,我们选择RB4作为特征对齐的目标尺寸,以达到速度和精度的平衡。
▲低级信息融合模块
低级信息融合模块(Low-IFM)设计包括多层再参数化卷积块( RepBlock )和一个拆分操作。具体而言,RepBlock以Falign ( channel=sum(CB2 , CB3 , CB4 , CB5))为输入,产生Ffuse (channel= CB4 + CB5)。中间通道为可调值(例如, 256 ),以适应不同的模型尺寸。然后将RepBlock生成的特征在通道维度上拆分为Finj_P3和Finj_P4,并与不同层级的特征进行融合。公式如下:
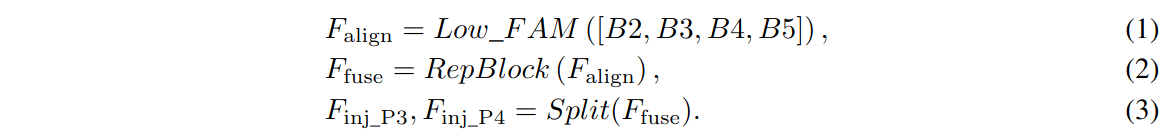
▲信息注入模块
为了更有效地将全局信息注入到不同层次,我们从分割经验中得到启发,并使用注意力操作来融合信息,如图5所示。具体来说,我们同时输入局部信息(它指的是当前水平的特征)和全局注入信息(由IFM生成),分别记为Flocal和Finj。
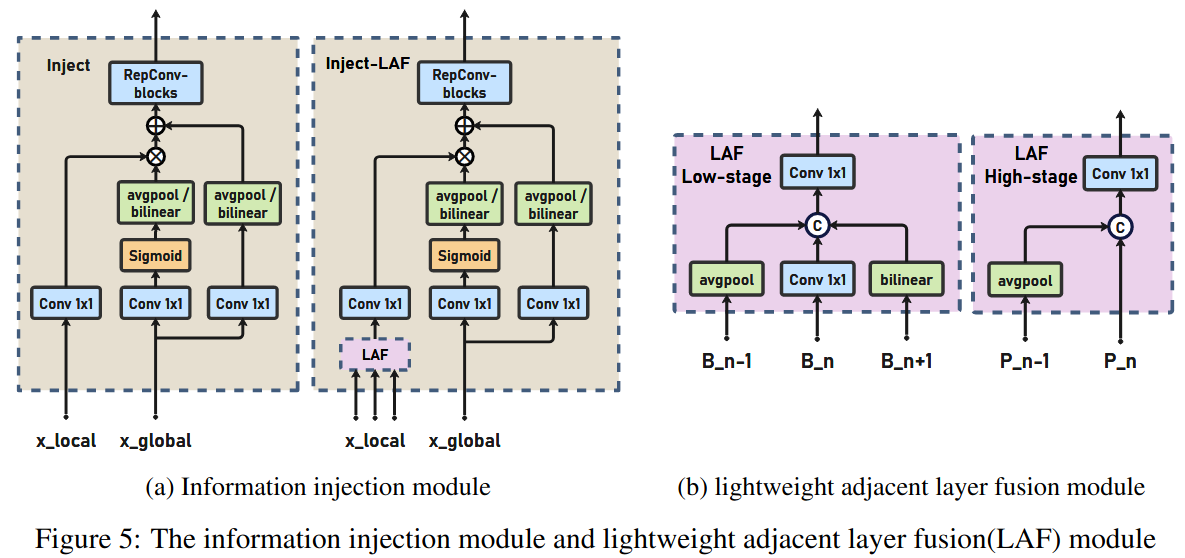
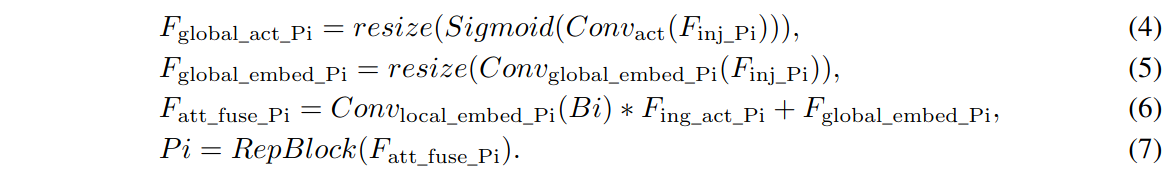
我们使用两个不同的Convs with Finj进行计算,得到Fglobal_embed和Fact。而Flocal_embed是利用Conv的Flocal计算得到的。然后通过注意力计算融合特征Fout。由于Flocal和Fglobal的大小不同,我们采用平均池化或双线性插值的方法,根据Finj的大小对Fglobal_embed和Fact进行缩放,以保证正确的对齐。在每次注意力融合结束后,加入RepBlock对信息进行进一步的提取和融合。
在低阶,Flocal等于Bi,因此公式如下:
2.3 高阶段聚散分支
High-GD融合了Low-GD生成的特征{P3,P4,P5},如图4(b)所示。

▲高阶段特征对齐模块
高级特征对齐模块(High-FAM)由avgpool组成,用于将输入特征降维至统一尺寸。具体来说,当输入特征的大小为{RP3,RP4,RP5}时,avgpool将特征尺寸缩小到特征组(RP5 = 1/8R)内的最小尺寸。由于Transformer模块提取高层信息,池化操作在方便信息聚合的同时降低了Transformer模块后续步骤的计算需求。
▲高阶段信息融合模块
高级别信息融合模块(High-IFM)由变压器模块(下面进行更详细的说明)和分裂操作组成,包含3个步骤:
(1)由High-FAM派生出的Falign利用变压器模块组合得到Ffuse。
(2)通过Conv1×1操作将Ffuse信道简化为sum(CP4、CP5)。
(3)通过分裂操作将Ffuse沿通道维度划分为Finj_N4和Finj_N5,并将其与当前层特征进行融合。
公式如下:
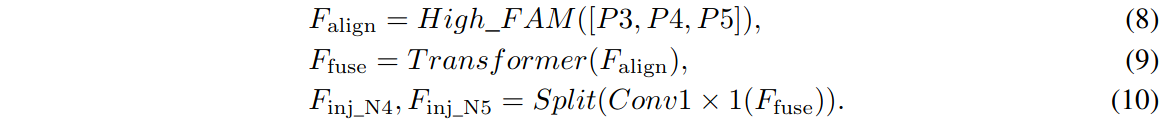
公式8中的变压器融合模块由若干堆叠的Transformer组成,Transformer块的个数记为L。每个Transformer块包括多头注意力块、前馈网络(Feed-Forward Network,FFN)和残差连接。为了配置多头注意力块,采用与LeViT相同的设置,将密钥K和查询Q的头维度分配给D个(例如16 )通道,V=2D个(例如32 )通道。为了加速推理,将速度不友好算子Layer Normalization替换为每个卷积的Batch Normalization,并将所有GELU激活替换为ReLU。这样可以将变压器模块对模型速度的影响降到最低。为了建立我们的前馈网络,我们遵循[ 28、55 ]中提出的方法来构建FFN块。为了增强变压器块的局部连接,在两个1x1卷积层之间引入一个深度卷积层。我们还将FFN的扩展因子设置为2,旨在平衡速度和计算成本。
▲信息注入模块
High-GD中的信息注入模块与Low-GD中的信息注入模块完全相同。在高阶段,Flocal等于Pi,因此公式如下:

2.4 增强的跨层信息流
我们取得了比仅使用全局信息融合结构的现有方法更好的性能。为了进一步提升性能,我们借鉴了YOLOv6中的PAFPN模块,引入了Inject-LAF模块。该模块是对注入模块的增强,包括一个轻量级的相邻层融合(LAF)模块,加入到注入模块的输入位置。为了在速度和精度之间取得平衡,我们设计了两种LAF模型:LAF低层模型和LAF高层模型,分别用于低层注入(合并相邻两层的特征)和高层注入(合并相邻一层的特征)。其结构见图5(b)。

为了确保来自不同层次的特征图与目标尺寸对齐,我们实现的两个LAF模型仅使用了三个算子:双线性插值用于上采样过小的特征,平均池化用于下采样过大的特征,1x1卷积用于调整与目标通道不同的特征。
模型中LAF模块与信息注入模块的结合有效地平衡了精度与速度之间的矛盾。通过使用简化的操作,我们能够增加不同级别之间的信息流路径的数量,从而在不显著增加延迟的情况下提高性能。
综上,一共有7个模块:Low_FAM, High_FAM, Low_IFM, High_IFM,Inject, Low_LAF, High_LAF。
2.5 掩模图像模型预训练
最近的方法,如BEiT,MAE和SimMIM,已经证明了掩模图像建模(MIM)在视觉任务中的有效性。然而,这些方法并不是专门为卷积网络量身定做的(卷积神经网络)。Spar K和Conv Ne Xt-V2是探索卷积神经网络掩模图像建模潜力的先驱。
在这项研究中,我们采用了遵循SparK方法的MIM预训练,成功地识别并克服了将MAE风格预训练成功扩展到MAE风格预训练convnets的两个关键障碍。这些挑战包括卷积操作无法处理不规则和随机遮挡的输入图像,以及BERT预训练的单尺度性质和卷积神经网络的层次结构之间的不一致性。
为了解决第一个问题,未被遮挡的像素被视为三维点云的稀疏体素,并采用稀疏卷积进行编码。对于后一个问题,开发了一个分层解码器,从多尺度编码特征中重建图像。该框架采用UNet风格的架构来解码多尺度稀疏特征图,其中所有的空间位置都被嵌入的掩码填充。我们在ImageNet 1K上针对多个Gold-YOLO模型预训练了模型的主干,取得了显著的提升。
3 实验
表2:GD结构的消融研究。测试模型为Gold-YOLO-S在T4 GPU上进行评估。
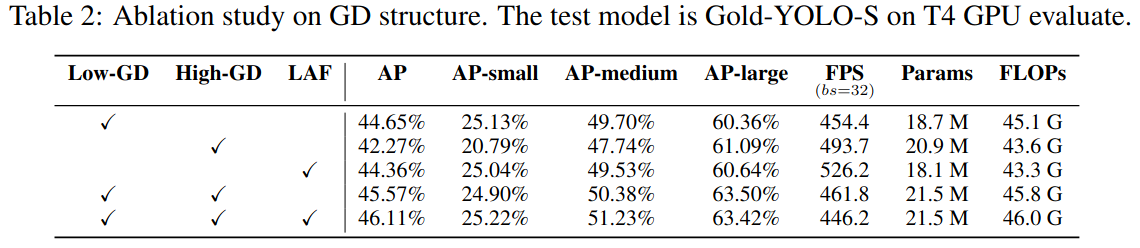
表3:LAF的消融研究。使用T4 GPU上的TensorRT 7进行评估。
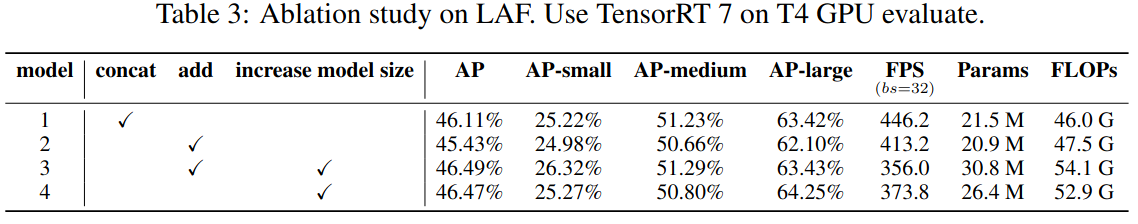
表4:实例分割任务的消融研究。
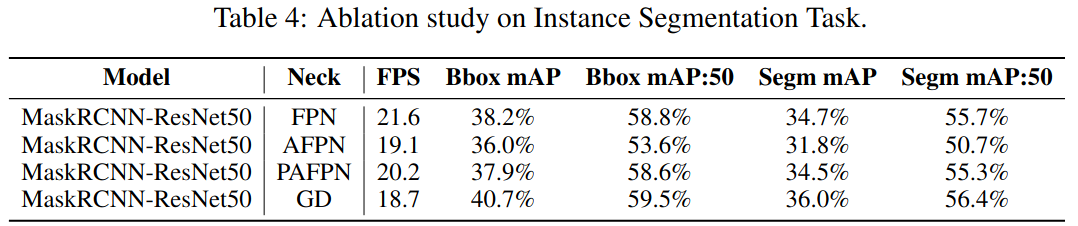
表5:语义分割任务的消融研究。表6:GD机制在其他目标检测模型上的表现。

图6:YOLOv5,YOLOv6,YOLOv7,YOLOv8和Gold-YOLO的颈部CAM可视化结果。
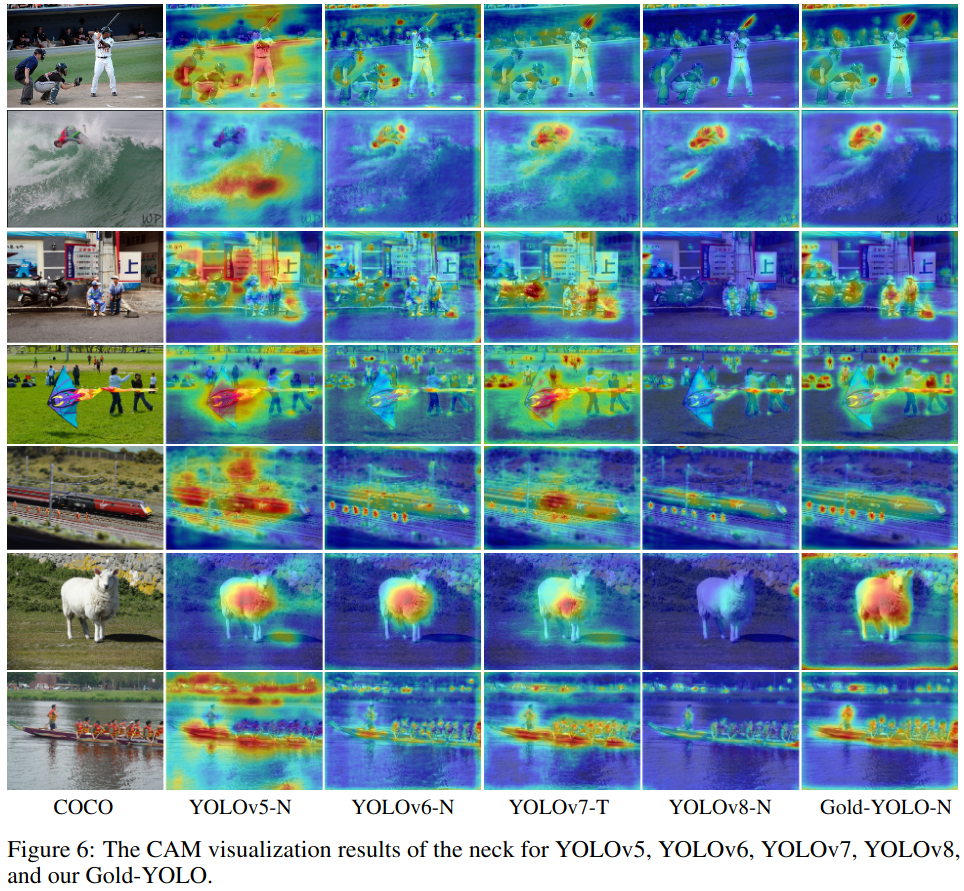
图7:颈部Cam可视化。我们可以观察到,不同层次的特征对不同大小的物体表现出不同的偏好。在传统的网格结构FPN中,随着网络深度的增加和不同层级之间的信息交互,特征图对目标位置的敏感性逐渐减弱,并伴随着信息丢失。提出的GD机制分别对高层和低层信息进行全局融合,从而产生全局融合的特征,这些特征对于各种大小的物体都包含丰富的位置信息。

结论
在本文中,我们重新审视了传统的特征金字塔网络(Feature Pyramid Network,FPN)架构,并批判性地分析了其在信息传输方面的限制。随后,开发了Gold-YOLO系列模型用于目标检测任务,取得了最新的成果。在Gold-YOLO中,引入了一种创新的聚集-分散机制,从战略上设计,以增强信息融合和传输的功效和效率,避免不必要的损失,从而显著提高模型的检测能力。我们真切地希望我们的工作在解决真实世界问题方面有价值,也可能为该领域的研究人员点燃新的思路。
至此,本文的内容就结束了。


 扫一扫


 1767


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


