论文阅读ReLU-KAN和Wav-KAN

Wav-KAN:小波Kolmogorov-Arnold网络 摘要 https://arxiv.org/pdf/2405.12832 在本文中,我们介绍了Wav-KAN,这是一种创新的神经网络架构,它利用Wavelet Kolmogorov-Arnold Networks(Wav-KAN)框架来提高可解释性和性能。传统的多层感知机(MLPs)甚至最近的进展如Spl-KAN[1]在可解释性、训练速度、鲁棒性、计算效率和性能方面都面临挑战。Wav-KAN通过将小波函数融入Kolmogorov-Arnold网络结构,解决了这些局限性,使网络能够高效地捕获输入数据的高频和低频 阅读详情

这是我读KAN系列论文的第三篇,今天把两篇论文放在一起写,分别是:

ReLU-KAN:

https://arxiv.org/abs/2406.02075

Wav-KAN:

https://arxiv.org/abs/2405.12832

之所以放在一起,是因为这两篇论文针对KAN的改进思路是相似的,都是采用新的基函数,来替代KAN中的B样条函数。

(另一个原因是这两篇文章内容都比较少,笑)

1,ReLU-KAN

1.1原理

作者提出了一种新的ReLU激活函数和逐点乘法来简化KAN的基函数设计,从而优化计算过程以实现高效的CUDA计算。通过将整个基函数计算表达为矩阵操作,充分利用了GPU的并行处理能力。此外,运用了类似于Transformer中的定位编码,预生成了非训练参数以加速计算。

作者提出的新基函数如下
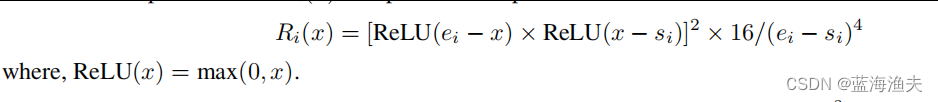
作者直接给出了ReLU-KAN的层的pytorch代码

import numpy as np
import torch
import torch.nn as nn

class ReLUKANLayer(nn.Module):
    def __init__(self, input_size: int, g: int, k: int, output_size: int):
        super().__init__()
        self.g, self.k, self.r = g, k, 4*g*g / ((k+1)*(k+1))
        self.input_size, self.output_size = input_size, output_size
        phase_low = np.arange(-k, g) / g # 计算ReLU函数的下限参数
        phase_height = phase_low + (k+1) / g # 计算ReLU函数的上限参数
        self.phase_low = nn.Parameter(torch.Tensor(np.array([phase_low for i in range(input_size)])), requires_grad=False) # 将phase_low作为不可训练的参数
        self.phase_height = nn.Parameter(torch.Tensor(np.array([phase_height for i in range(input_size)])),requires_grad=False) # 将phase_height作为不可训练的参数
        self.equal_size_conv = nn.Conv2d(1, output_size, (g+k, input_size))

    def forward(self, x):
        x1 = torch.relu(x - self.phase_low) # 第一个ReLU激活,减去phase_low
        x2 = torch.relu(self.phase_height - x) # 第二个ReLU激活,x减去phase_height
        x = x1 * x2 * self.r # ReLU激活结果的逐点乘积,乘以归一化常数r
        x = x * x 
        x = x.reshape((len(x), 1, self.g + self.k, self.input_size))
        x = self.equal_size_conv(x)
        x = x.reshape((len(x), self.output_size, 1))
        return x

1.2实验结果
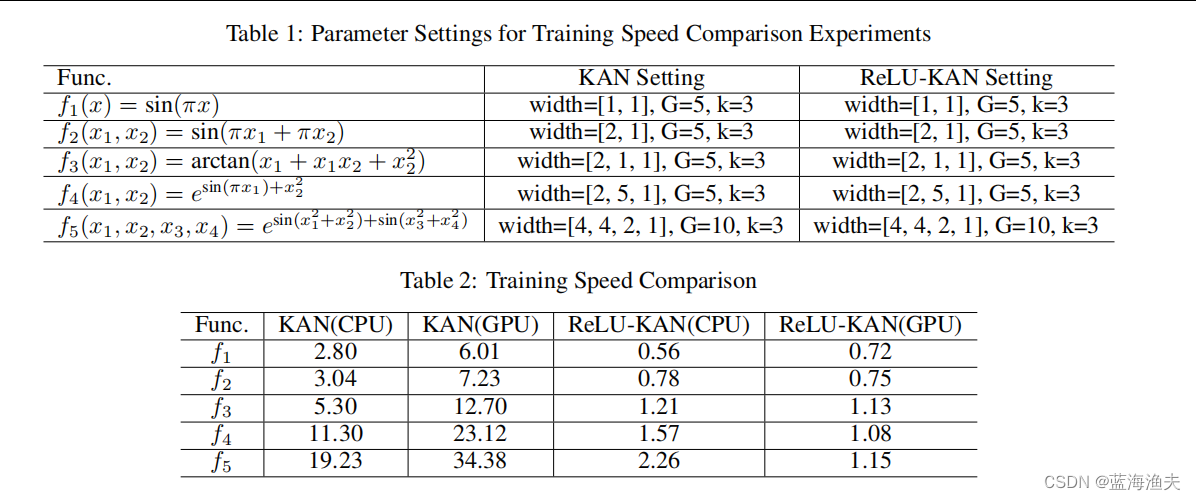
从实验结果看,训练速度确实得到了极大的提升。

2,Wav-KAN

2.1原理

作者用小波函数替换了B样条,从而提高准确性、加快训练速度,并增加鲁棒性。此外,小波函数能够提供多分辨率分析,有效捕捉数据的高频和低频特征。

2.2实验结果

在MNIST上的实验结果:
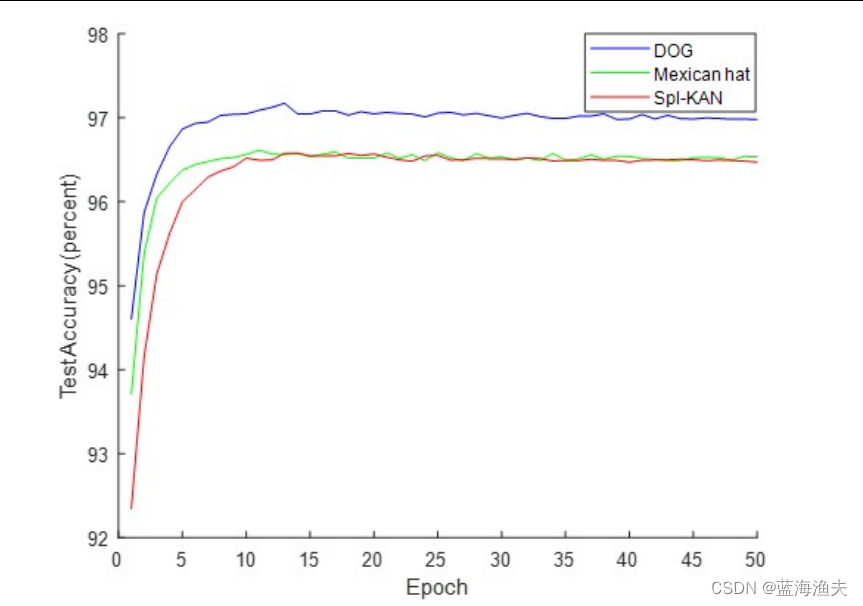
其中Mexican hat和Derivative of Gaussian (DOG)对应的是不同类型的母小波函数。spl-KAN指的就是用B样条的原始KAN

【YOLOv10改进[Conv]】KAN系列 |使用KAGNConv改进C2f + 含全部代码和详细修改方式 + 手撕结构图 阅读详情

相关推荐

YoloV8改进策略:卷积篇|Kan行天下之ReluKan

本文介绍了一种名为ReLU-KAN的新型架构,该架构使用新型基础函数替换了KAN中的B样条。此外,ReLU-KAN实现了全矩阵运算,显著提高了训练速度。实验结果表明,ReLU-KAN在训练速度、拟合能力和稳定性方面均优于KAN。在未来的工作中,我们计划将ReLU-KAN应用于卷积和Transformer架构中,以研究其在不牺牲模型性能的情况下减少参数的潜力。

m0_47867638的博客 1087

又发顶会!小波变换+KAN堪称顶会锦囊

性能提升:在多个高光谱数据集(如Salinas、Pavia、Indian Pines)上,Wav-KAN的平均总体准确率达到92.62%,Kappa系数为0.9157,显著优于传统的MLP和样条基KAN(Spline-KAN)。小波激活函数:通过小波激活函数,Wav-KAN能够更有效地捕捉高光谱数据中的复杂模式,尤其是在Indian Pines数据集上,其准确率比Spline-KAN高出8.23%。性能提升:在MNIST数据集上,Wav-KAN的训练速度比Spline-KAN更快,测试准确率显著提高。

Aimoxin111的博客 1246

2025.03.14【读书笔记】|GWAS分析神器:BOLT-LMM工具介绍与快速安装

在生物信息学领域,全基因组关联分析(GWAS)已成为揭示遗传与疾病关系的强有力工具。BOLT-LMM作为一款专为大规模样本量设计的GWAS分析工具,将极大地提高研究人员的工作效率。大家好,今天我们来聊聊一个非常强大的生物信息学工具——BOLT-LMM。它是基于线性混合模型(LMM)的全基因组关联分析(GWAS)分析工具,通过快速的方差近似方法在计算效率上实现了显著的提升。BOLT-LMM的高效性能使其成为大规模样本GWAS分析的理想选择,它将进一步推动生物信息学和遗传学研究的发展。

1088

ReLU-KAN:仅需要矩阵加法、点乘和ReLU*的新型Kolmogorov-Arnold网络

摘要 由于基函数(B样条)计算的复杂性,Kolmogorov-Arnold网络(KAN)在GPU上的并行计算能力受到限制。本文提出了一种新的ReLU-KAN实现方法,该方法继承了KAN的核心思想。通过采用ReLU(修正线性单元)和逐点乘法,我们简化了KAN基函数的设计,并优化了计算过程以实现高效的CUDA计算。所提出的ReLU-KAN架构可以轻松地部署在现有的深度学习框架(如PyTorch)中,用于推理和训练。实验结果表明,与具有4层网络的传统KAN相比,ReLU-KAN实现了20倍的速度提升。此外,ReL

AI浩 940

基于 AUTOSAR 的域控产品软件开发进阶探索

本文深入探讨了AUTOSAR架构在汽车域控产品开发中的进阶应用。首先从系统设计角度分析了AUTOSAR分层架构原理及其在域控产品中的优化部署策略;其次详细介绍了Davinci和EBTresos等主流工具链的特点与协同使用方法;然后重点阐述了ASPICE流程与功能安全/信息安全标准的实施要点;最后分享了多核车载芯片(如NXP S32G)的适配经验与优化实践。通过架构设计、工具运用、标准遵循和芯片适配四个维度的专业解析,为域控产品的AUTOSAR开发提供了系统性指导。

SiArch的博客 1192

手把手教你用Keil5和Proteus8给51单片机跑个流水灯(附完整源码+安装包)

本文详细介绍了如何使用Keil5和Proteus8为51单片机实现流水灯效果,包括开发环境配置、汇编代码编写、电路设计及仿真调试。通过完整的源码和安装包,帮助初学者快速掌握C51单片机开发的核心流程,适合嵌入式开发入门学习。

weixin_42632434的博客 365

2025一区新风口:小波变换+KAN!定会顶刊轻松发!

通过组合B样条和高斯差分(DoG)的输出,FC-KAN在MNIST数据集上达到了97.93%的验证准确率,在Fashion-MNIST上达到了89.99%的验证准确率,显著优于其他KAN网络和MLP。提出了一种新的Kolmogorov-Arnold网络(FC-KAN),通过在低维数据中组合流行的数学函数(如B样条、小波和径向基函数)来捕捉输入数据的特征。KAN的可学习激活函数使得模型的内部机制和决策过程更加直观,提升了模型在需要高可解释性的领域的适用性,如医学诊断和金融预测。

d22800的博客 941

用Obsidian搭建个人知识库:AI时代如何构建你的第二大脑

AI 时代,真正有价值的不只是获取知识,而是沉淀属于自己的知识体系。本文从 Obsidian 安装、目录设计、双向链接、插件推荐到 AI 联动、多端同步,手把手教你打造高效、可持续进化的个人知识库,让知识真正为你所用。🧠

XiaoqiangClub的博客 441

Wav-KAN:项目的核心功能/场景

Wav-KAN:项目的核心功能/场景 Wav-KAN:一种结合小波变换与Kolmogorov-Arnold网络的神经网络架构。 项目介绍 Wav-KAN是一个创新的神经网络架构,旨在通过引入小波变换增强神经网络的解释性和性能。传统的多层感知机(MLPs)以及最近的Spl-KAN等先进技术,在解释性、训练速度、鲁棒性、计算效率以及性能方面面临诸多挑战。Wav-KAN通过将小波函数融入Kolmogor...

gitblog_00612的博客 297

【SpringBoot 3.x 第92节】Spring Modulith:构建模块化单体架构(基于 Spring Boot 3),一文带你搞透(超详细)!

🏆本文收录于《滚雪球学SpringBoot 3.x》,专门攻坚指数提升,本年度国内最系统+最专业+最详细(永久更新)。    该专栏致力打造最硬核 SpringBoot3 从零基础到进阶系列学习内容,🚀均为全网独家首发,打造精品专栏,专栏持续更新中…欢迎大家订阅持续学习。 如果想快速定位学习,可以看这篇【SpringBoot3教程导航帖】,你想学习的都被收集在内,快速投入学习!!两不误。

**My Coding Family** 987

ican项目四汽车零件智能测量

ican项目四汽车零件智能测量

weixin_72050316的博客 555

Wav-KAN:小波驱动的可解释神经网络新范式

Wav-KAN是一种基于Kolmogorov-Arnold表示定理的新型可解释神经网络范式,它用小波函数替代传统神经网络的权重和固定激活函数。该架构通过可学习的小波变换实现多尺度特征分析,在保持强大函数逼近能力的同时,显著提升了模型的可解释性、参数效率和训练速度,为构建透明、高效的“玻璃盒”式AI模型提供了新思路。

weixin_29095049的博客 109

点云焊缝提取

本文介绍了一个基于PCL库的点云处理流程,包含三个核心模块:MLS平滑处理通过多项式拟合修正点云位置;差异提取通过双向匹配定位源/目标点云的非重叠区域;统计过滤剔除离群噪声点。该流程采用"平滑-筛选-净化"的通用思路,将复杂算法封装为可配置接口,实现了工业级点云预处理。文章重点分析了各模块的原理、PCL接口调用及参数设计逻辑,同时指出参数调优、算法扩展等深入探索方向,展现了PCL在点云处理中的模块化优势与实用价值。

weixin_45196569的博客 240

Atom夜间模式开发终极指南:护眼配色与工作效率提升的10个技巧

在长时间编程工作中,保护视力并提升工作效率是每个开发者的重要需求。Atom编辑器通过其强大的夜间模式主题系统,为开发者提供了完美的解决方案。本文将为您揭示如何通过Atom夜间模式开发实现护眼配色与工作效率的双重提升。 ## 🌙 为什么选择Atom夜间模式? Atom编辑器内置了多款专业的夜间模式主题,包括**One Dark**、**Atom Dark**和**Base16 Tomorrow

gitblog_00358的博客 873

Codex 100个真实案例 - 全系列总结与Codex最佳实践全解析

历经100个案例的淬炼,我们终于来到了终点!本篇是整个系列的压轴之作——全面回顾100个案例的分类统计、提炼Codex使用的核心技巧和最佳实践、总结Prompt工程的精华要点、剖析常见错误及解决方案、展望AI编程的未来趋势,并为不同水平的读者规划学习路径。这不仅是一篇总结,更是一本Codex实战手册!

yueyeguzhuo的专栏 129

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

Spl-kan&Wav-kan代码概览overlook

.....KANLayer继承自nn.Module,是 PyTorch 中的一个自定义层。初始化方法__init__接受多个参数,包括输入维度in_dim、输出维度out_dim、网格间隔数num、多项式阶数k、初始化噪声尺度等。# ... 省略了一些初始化代码 ...KANLinear类继承自nn.Module,是一个自定义的神经网络层,它结合了小波变换和线性变换。和分别是输入和输出特征的维度。是一个字符串,指定了使用哪种类型的小波变换。

m0_68339197的博客 1170

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

P-KAN:基于投影的KAN网络在小样本工业预测中的实践

在机器学习领域,函数逼近是核心基础,旨在通过模型学习数据背后的映射关系。传统神经网络依赖固定激活函数,而Kolmogorov-Arnold Networks(KAN)引入可学习的边函数,提升了表达能力和可解释性。其原理在于用灵活的基函数(如B样条)替代传统激活,但这也带来了参数量大、对噪声敏感等问题,尤其在数据稀缺的工业场景中。P-KAN(Projective KAN)的技术价值在于,通过引入熵驱动的投影机制,将边函数约束到预设的正交函数基(如傅里叶基、切比雪夫多项式基)张成的子空间中,这大幅提升了参数效率

weixin_31476015的博客 330

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

【论文阅读】未配准多对比度 MRI:让网络先对齐,再共享解剖信息

本文提出一种联合配准与重建的深度学习框架,用于欠采样多对比度MRI图像重建。通过引入可微空间变换模块(ST),自动校正参考图像(如T1w)与目标图像(如T2w)间的非对齐问题,实现解剖结构信息的可靠共享。模型在BraTS和MRBrainS数据集上验证,显著优于不使用参考或直接拼接未配准参考的方法,在8×至16×加速下提升PSNR达2.36 dB,证明了配准对跨对比度信息融合的关键作用。

银尘博客 367

【论文阅读】Agent记忆机制(109):MemComposer——用强化学习学会选哪些记忆、选多少以及怎样排序

MemComposer提出将记忆检索重构为查询相关的序列级记忆编排问题,摒弃传统按相似度排序取Top-k的做法。它通过经验策略优化(ExPO)训练一个可学习的“记忆编排层”,联合决策记忆内容、数量与顺序,基于完整任务执行结果(如成功与否)进行端到端优化。实验表明,记忆选择并非越相似越好,数量也非越多越优,顺序更显著影响性能。该方法在不改变记忆库与执行器的前提下,显著提升Agent对历史经验的利用效率,为记忆使用提供了新范式。

weixin_45642847的博客 256

rppg相关论文阅读笔记10.22

RhythmGaussian首次将可泛化高斯模型引入rPPG,通过4D高斯表征显式解耦几何与色度变化,提出“4D虚拟相机”实现无真实参数下的高效建模,并设计显式运动与色度建模(EMM/ECM)在无监督下分离生理信号、运动噪声与镜面反射,显著提升复杂场景下的远程生理测量精度。

m0_74900369的博客 377

【论文阅读】Agent记忆机制(111):FEB-30——别再只用问答准确率评估 Agent Memory

应该保存原始对话、原子事实,还是高层摘要;应该使用向量库、图结构,还是离散语义索引;新信息到来时,应该创建、强化、更新,还是淘汰旧记忆;面对长时间跨度和多会话历史,如何控制延迟、token 与存储成本。我们怎么知道一个 Agent 的记忆系统真的记对了?目前最常见的答案是做问答。把一段长历史交给记忆系统,之后向 Agent 提问;回答正确,就认为记忆有效,回答错误,就认为记忆失败。最终回答记忆状态检索结果生成模型行为。

weixin_45642847的博客 226

office-academic-skill:论文阅读报告和组会PPT怎么生成

•两份文件都能在 Word 和 PowerPoint 里正常打开、能直接编辑;•PPT 每页只有一个核心观点,标题是判断,不是话题标签;•每一条定量结论都能在 PDF 里指到具体位置——第几页、哪个图或哪张表;•所有来源标签都指向真实存在的条目;•局限性那一节里,作者声明的和推断出来的分开写;•单位、坐标轴、图例跟原文一致。最省事的做法是先做阅读报告:把 PDF 和上面那段提示词发过去,删掉 PPT 那两行,拿到 docx 之后先按核对项的六条过一遍。

AcademicIdeas的博客 264

意识障碍--论文阅读5

传统 DBS 主要依据解剖靶点及固定刺激参数进行治疗,未充分考虑患者个体症状差异和动态状态变化,可能是治疗效果不稳定的原因之一。本文研究不同刺激靶点的症状特异性,以及初始状态对刺激响应的影响。

qq_42829312的博客 328

【论文阅读】Agent记忆机制(110):MemCode——用离散语义码突破长期 Agent 记忆的向量检索边界

摘要(148字): MemCode 提出一种双路径记忆访问机制,将长期记忆写入自包含的原子单元(AMU),并为每条记忆生成离散语义指纹。通过结合连续向量近邻与离散码本共现关系,突破传统向量检索在语义关联上的局限。该方法在不依赖显式图结构的前提下,实现跨事件、跨时间的事实连接,显著提升多跳推理性能。异步演化机制保障系统可扩展性,核心创新在于将写入、索引与检索对齐,推动记忆系统从“存得久”迈向“找得准”。

weixin_45642847的博客 383

【多论文阅读笔记】下一阶段,Agent记忆关注什么能力?

本文聚焦于下一代Agent记忆系统的核心目标——维持运行态“心流”,即实现信息的无损、无缝调用。基于此,作者评析了近期三项代表性测评基准:LoCoMo-Plus(测认知记忆)、TriggerBench(测前瞻记忆)与EvalMem。其中,LoCoMo-Plus通过隐含状态与跨场景触发,检验模型对用户价值观、目标等深层记忆的运用能力;TriggerBench则模拟真实提醒场景,测试模型在恰当时机激活记忆的能力。二者均超越传统事实记忆,但前者忽略幻觉与认知错配风险,后者尚待扩展。整体而言,这些工作推动记忆测评向

xian_ren008的博客 195
上一篇: 论文阅读U-KAN Makes Strong Backbone for MedicalImage Segmentation and Generation
下一篇: 论文阅读:H-ViT,一种用于医学图像配准的层级化ViT
蓝海渔夫
博客等级 码龄14年 6134粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝海渔夫

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值