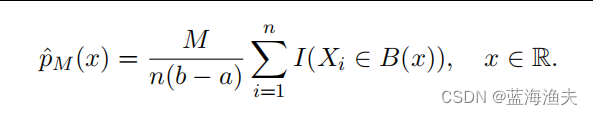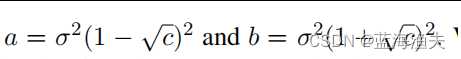论文阅读:基于谱分析的全新早停策略

双11提前购!买周边/年卡,一键领4重福利! 送200元神券包+10%红包返利+最高10年VIP!还能抽iPhone18Pro!仅限1次,速抢>> 阅读详情

来自JMLR的一篇论文,https://www.jmlr.org/papers/volume24/21-1441/21-1441.pdf

这篇文章试图通过分析模型权重矩阵的频谱来解释模型,并在此基础上提出了一种用于早停的频谱标准。

1,分类难度对权重矩阵谱的影响

1.1 相关研究

在最近针对深度模型的可解释性研究中,出现了一种流行的方法,即对DNNs的各种大型特征随机矩阵进行谱分析,所谓大型特征随机矩阵,就是例如反向传播算法的Hessian矩阵、不同层之间的权重矩阵以及输出特征的协方差矩阵等。这样的谱分析有助于深入了解DNNs的行为。

1.2  权重矩阵的谱的类型

权重矩阵的谱在训练的最后阶段被分类为三种类型:轻尾(LT)、块过渡期(BT)和重尾(HT)。

重尾(Heavy Tails)、轻尾(Light Tails)和块过渡(Bulk Transition)是指权重矩阵或Hessian矩阵的特征值分布的不同类型。区别如下:

1)重尾分布指的是在特征值分布的尾部存在较大概率密度,即存在一些非常大的特征值。在深度学习中,重尾可能表明权重矩阵中存在高度相关的条目,这可能导致过拟合或模型的泛化能力下降。

2)轻尾分布的特征是特征值分布的尾部概率密度较低,即特征值普遍较小,没有特别大的异常值。在深度学习中,轻尾可能表示权重矩阵的正则化较好,有助于提高模型的泛化能力。

3)块过渡是一种介于重尾和轻尾之间的状态,特征值分布的主体(块)接近Marcenko-Pastur分布,但可能存在一些异常的“尖峰”或“离群点”。这种状态可能表明模型正在从过拟合状态(重尾)过渡到更好的泛化状态(轻尾),或者是模型训练过程中的一个中间阶段。

1.3 如何计算权重矩阵的谱

对权重矩阵计算其Gram矩阵,接着求解Gram矩阵的特征值。接着将计算出的特征值按降序排列,以便于分析最大的特征值。最后,构建经验谱分布,这是一个经验分布函数,用于估计权重矩阵特征值的分布。ESD可以通过直方图或核密度估计来实现。
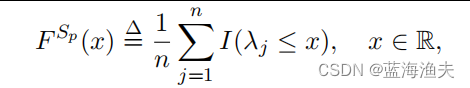
其中I是指示函数,当括号内的表达式为真时,I的值为1;否则为0。

1.4作者的发现

作者发现分类难度是影响权重矩阵谱中出现HT的一个重要因素。分类难度越高,HT出现的几率越大。在合成数据集和真实数据集上进行的实验都支持这一发现。特别是,降低数据集的信噪比或在高斯数据实验中增加类别数量K,都会增加分类难度,并在训练结束时产生重尾。在真实数据实验中,由于CIFAR10具有更复杂的特征和更高的分类难度,因此在CIFAR10的实验中出现重尾的情况比在MNIST的实验中更多。

2,基于权重矩阵谱的早停准则

2.1 内容

本文提出的基于谱的早停策略通过分析深度神经网络(DNN)权重矩阵的谱特性来确定训练过程中的停止时机。

步骤:

1)权重矩阵的谱分析:这涉及到计算权重矩阵的非零特征值.

2)特征值排序与检测:将这些特征值按降序排列,并使用算法自动检测特征值中的“尖峰”(spikes),即那些远离其他特征值的特征值。

3)计算谱准则值:也就是计算权重矩阵的谱与Marcenko-Pastur (MP) 定律的偏差。这涉及到构造一个直方图估计器来近似权重矩阵特征值的联合密度,并与MP定律的密度函数进行比较。

距离的定义是这样的
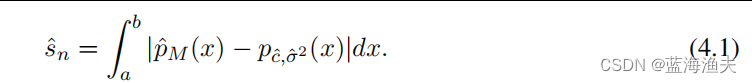
其中P_{M}(x)是ESD的直方图估计,公式如下

其中,,对于一个n×p的随机矩阵,其中n/p→c(c是一个正常数)。\sigma ^{2}是权重矩阵元素的方差。参数 M 通常表示直方图估计中使用的“bins”或“binsize”的数量,用于将数据分成多个区间以估计概率密度函数,本文设置为2[n^{\frac{1}{3}}]。B(x) 表示的是一个函数,它将一个实数 x 映射到包含 x 的“bin”或区间。在频谱分析中,B(x)可以用于计算每个区间内的点的数量,从而估计概率密度函数或特征值分布。

而后一项是MP分布的密度函数,公式如下:
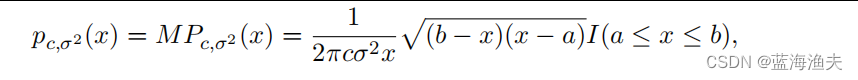
MP分布可用于描述大随机矩阵特征值的分布。MP定律与DNN的泛化能力有关。接近MP分布的谱可能意味着模型具有较好的泛化能力,而偏离MP分布可能指示过拟合或其他问题。

4)设定阈值:该值基于L1距离

5)监控训练过程:在训练过程中,对于每个训练周期,计算权重矩阵的谱准则值

6)判断停止时机:如果在连续的几个训练周期中,谱准则值超过了阈值,则认为达到早停条件。

2.2 相较于传统早停策略的优势

1)不需要测试集:传统早停依赖于对模型在测试集上的准确率或者loss的测量,而本文提出的基于谱分析的早停策略完全不需要测试集。只要分析训练集上的权重矩阵的谱就可以了

2)适应性强:因为是依靠权重矩阵的谱分析而不是测试集,所以数据类型或者数据集组成结构等影响较小

3)鲁棒性更强:实验证明,即使训练准确率还在上升,本方法依然能实现早停。

论文阅读---CASCADING REINFORCEMENT LEARNING 在实验中,CascadingVI与AdaptRM相比,实现了显著较低的遗憾值和运行时间,且随着N的增加,这种优势变得更加明显。在最佳策略识别目标下,CascadingBPI与AdaptBPI相比,具有较低的样本复杂度和运行时间,且随着N的增加,这种优势变得更加明显。qk,h(s',A)和q'k,h(s',A)分别表示在第k个episode的第h步,状态s'选择动作A的吸引概率。然而,如何在不枚举所有的A∈A的情况下关闭√H的差距仍然是一个未解决的问题,这将留待未来的研究。论文中的实验是如何设计的? 阅读详情

相关推荐

论文阅读[268]基于EEM荧光光谱,感知燃烧产生的颗粒物

论文使用PCR-EEM(主成分回归-激发发射矩阵)方法对16种参考PAH(多环芳烃)的浓度进行了预测,R2=0.976。

WalkingComputer的博客 2035

学习成长分享-以近红外光谱分析学习为例

(2) 熟悉分析对象:研究生阶段一般是面向具体任务开展相关工作,可以是具体的对象,例如原油、茶叶、医药等的近红外检测分析,也可以是某一类分析方法的若干个问题,例如近红外光谱分析的基线校正问题、特征选择问题等。(5) 确定分析方法:针对(3)中确定的问题,结合(4)的文献积累,尝试确定自己的分析方法,也可以基于自己的理解去构建面向特定问题的分析方法。(1) 个人博客或网页,现在越来越多的人乐于在自己的博客或网页分享个人的学习知识,可能有些是付费机制,但是我认为是合理的,尊重别人的劳动成果就是尊重自我。

qq_35667901的博客 1249

早停法(Early Stopping)原理与代码实战案例讲解

早停法的基本思想是利用交叉验证的概念,通过将数据集分为训练集和验证集,定期评估模型在验证集上的性能,并在性能达到最佳时停止训练。这种做法能够平衡模型的复杂度和泛化能力,防止过度拟合。早停法作为自动调整训练过程的重要手段,在机器学习和深度学习领域发挥了重要作用,特别是在避免过拟合、提高模型泛化能力和提高训练效率方面显示出显著效果。

AI大模型应用之禅 1503

论文阅读:Unsupervised Deep Embedded Fusion Representation of Single-Cell Transcriptomics (AAAI-23)

细胞聚类是分析单细胞RNA测序(scRNA-seq)数据的关键步骤,它允许在单细胞水平上进行转录谱分析后对细胞异质性进行表征。最近,单细胞深度嵌入表示模型因其可以同时学习特征表示和聚类而受到青睐。然而,这些模型仍然面临着许多重大挑战,包括海量数据、普遍的dropout事件以及转录谱中复杂的噪声模式。本文提出了一种名为单细胞深度嵌入融合表示(scDEFR)模型,它产生了一个深度嵌入融合表示,以学习包含基因水平转录组和细胞拓扑信息的融合异质潜在嵌入。首先逐层融合它们,以获得细胞间关系和转录组信息的压缩表示。

dundunmm的博客 1612

2019年数学建模美赛经验总结

北京时间2019年1月29号上午9时,数模美赛结束。美赛结束已经10多天了,我在这次竞赛中负责建模和编程,趁现在记忆还比较清晰,写下这篇博客记录第一次参加数学建模美赛的经历。 补更:2019年4月20日公布成绩,笔者最终获得了美赛一等奖 目录 1、基本情况 2、选题 3、分工合作 4、论文写作 5、建模 6、编程 7、入门资源 ...

Smallactive 7万+

Shopee滑块验证码太刁钻?手把手教你用Python+Playwright绕过弧形验证(附影刀RPA接入代码)

本文详细介绍了如何使用Python和Playwright结合SadCaptcha第三方服务高效破解Shopee平台的弧形滑块验证码,并集成到影刀RPA工作流中。该方案开发周期短、准确率高(>90%),特别适合跨境电商自动化操作,已在实际项目中验证成功。

weixin_29284657的博客 556

行人重识别论文阅读7-基于图卷积的行人骨架识别

0. 怎么看论文 怎么看论文:带着目的,你是想要解决什么问题,这篇论文的摘要能给你带来什么收获。 摘要、结论:是否和你的研究方向高度相关,或者如果你应用这个模型能解决什么问题。 引言部分:作者为什么额开展这项研究。这篇文章是否值得精读。 深度挖掘结论和讨论部分:如何开展实验获得初始数据、数据分析解读数据内涵等。 做笔记(Endnote、Mendeley):列出对自己有价值核心信息,方便后面定位相关文献。 或者表格列出文献: 序号、文献名称、文献类型、发表年份、关键部分、研究方法、存在

qq_33977080的博客 1373

深入浅出CenterFusion

结合论文和代码理解CenterFusion

Untitled的专栏 5090

arXiv论文周选 (2026-W17)

更新时间: 2026-04-26精选论文,用EasyRader可全文翻译、生成结构化导读、思维导图,节省80%阅读时间。

539

保姆级教程:手把手教你下载和配置Waymo自动驾驶数据集(附百度网盘链接)

本文提供了一份详细的Waymo自动驾驶数据集下载和配置指南,特别针对国内研究者优化了数据获取方案,包括百度网盘链接和Google Cloud CLI配置。文章还涵盖了环境配置、数据处理实战、可视化分析以及进阶技巧,帮助开发者高效利用这一业界黄金标准数据集进行自动驾驶研究。

weixin_42651281的博客 350

Python量化交易:主流回测框架Backtrader入门详解

Python量化交易框架Backtrader入门指南 Backtrader是一个功能强大的Python量化回测框架,可以帮助交易者专注于策略逻辑而非基础设施。本文介绍了Backtrader的核心架构和使用方法: 框架优势:自动处理订单执行、手续费、滑点、仓位管理等复杂问题,采用事件驱动模式接近真实交易场景。 核心组件: Cerebro:控制中心 Strategy:交易策略 Data Feed:数据输入 Broker:模拟经纪商 Indicators:技术指标 使用流程: 安装:pip install bac

Science prince的博客 929

推演 | x86 抱团统一 oneDNN:ACE 2028 才到货,追得上 Arm 的三成份额吗

如果 Arm 到 2027 年真吃掉服务器 CPU 三成份额,而 x86 的第一代 ACE 芯片要 2028 年才到货,AMD 和 Intel 这次握手,到底追不追得上?10 月 20 日那封联合声明没有回答这个问题,它只把牌摊在了桌上。先把时间对一下。10 月 20 日,AMD 和 Intel 宣布把面向 PyTorch 的 x86 CPU 优化合并进 oneDNN,让 oneDNN 成为 PyTorch 里 x86 加速的默认路径。

summerliyang的博客 678

YOLOv11改进 | 损失函数改进篇 | MPDIoU、InnerMPDIoU助力细节涨点(二次创新 + 代码解析)

本文为读者详细介绍了YOLOv11模型的最新改进,带来的改进机制是最新的损失函数MPDIoU和融合了最新的Inner思想的InnerMPDIoU(效果打爆之前的所有的损失函数提升检测精度和处理细节方面的作用。通过深入探讨MPDIoU和InnerMPDIoU(全网首发)的工作原理和实际代码实现,本文旨在指导读者如何将这些先进的损失函数技术应用到YOLOv11模型中,以提高其性能和准确性。文章内容涵盖从理论基础、代码实现,到实际教你如何添加本文的机制到你的模型中。

Snu77的博客 3988

深度学习17:深度神经网络:测试参数优化器效果

nothing。

tellmewhoisi的博客 126

关于React Native Android找不到node的错误

最近,按照官方文档初始化了一个React Native项目,但是在Android端运行的时候,报了如下的一个错误。 org.gradle.api.tasks.TaskExecutionException: Execution failed for task ':app:recordFilesBeforeBundleCommandDebug'. Caused by: org.gradle.process.internal.ExecException: A problem occurred starting p

xiangzhihong8的专栏 4242

179、瑞芯微RK3588在边缘盒子中的多摄同步架构——基于PLL的帧同步与曝光同步的实测调优

第一,RK3588的多摄同步,硬件上确实支持,但软件配置的坑比想象的多。第三,传感器的tPD差异是最大的不确定因素,选型时尽量选同一批次,而且要在量产前做全温测试——我遇到过低温下tPD变化超过3微秒的情况,直接导致同步失效。我遇到过一批IMX415,tPD差异达到±8微秒,直接超出SYNC控制器的补偿范围,最后只能挑芯片,把差异小的装到同一台设备里。别用100MHz,虽然分辨率更高,但高频信号在PCB走线上更容易引入EMI,边缘盒子的结构件往往没有很好的屏蔽,实测100MHz下同步信号边沿抖动明显增大。

zzfmlxs的博客 29

基于炬芯ATS308X的MLP DNN深度学习KWS语音识别实现(单唤醒词版本-谷歌mini Speech Commands数据集)

本文基于ATS3089P平台,使用Google公开的miniSpeechCommands数据集,通过Python训练小型MLP唤醒模型(416→48→24→2),实现英文“yes”唤醒词识别。采用浮点训练后量化(PTQ)生成21592字节INT8模型,经验证在PC与ARM端推理一致,召回率超89%,误触率低于1%。模型部署至板端需复制wake_model.bin至U盘,支持串口指令识别。流程涵盖数据准备、训练、量化、验证及嵌入式部署,可扩展至中文唤醒词定制。

2401_89373706的博客 353

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【论文阅读】未配准多对比度 MRI:让网络先对齐,再共享解剖信息

本文提出一种联合配准与重建的深度学习框架,用于欠采样多对比度MRI图像重建。通过引入可微空间变换模块(ST),自动校正参考图像(如T1w)与目标图像(如T2w)间的非对齐问题,实现解剖结构信息的可靠共享。模型在BraTS和MRBrainS数据集上验证,显著优于不使用参考或直接拼接未配准参考的方法,在8×至16×加速下提升PSNR达2.36 dB,证明了配准对跨对比度信息融合的关键作用。

银尘博客 366

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【论文阅读】Agent记忆机制(109):MemComposer——用强化学习学会选哪些记忆、选多少以及怎样排序

MemComposer提出将记忆检索重构为查询相关的序列级记忆编排问题,摒弃传统按相似度排序取Top-k的做法。它通过经验策略优化(ExPO)训练一个可学习的“记忆编排层”,联合决策记忆内容、数量与顺序,基于完整任务执行结果(如成功与否)进行端到端优化。实验表明,记忆选择并非越相似越好,数量也非越多越优,顺序更显著影响性能。该方法在不改变记忆库与执行器的前提下,显著提升Agent对历史经验的利用效率,为记忆使用提供了新范式。

weixin_45642847的博客 256

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

rppg相关论文阅读笔记10.22

RhythmGaussian首次将可泛化高斯模型引入rPPG,通过4D高斯表征显式解耦几何与色度变化,提出“4D虚拟相机”实现无真实参数下的高效建模,并设计显式运动与色度建模(EMM/ECM)在无监督下分离生理信号、运动噪声与镜面反射,显著提升复杂场景下的远程生理测量精度。

m0_74900369的博客 377

【论文阅读】Agent记忆机制(111):FEB-30——别再只用问答准确率评估 Agent Memory

应该保存原始对话、原子事实,还是高层摘要;应该使用向量库、图结构,还是离散语义索引;新信息到来时,应该创建、强化、更新,还是淘汰旧记忆;面对长时间跨度和多会话历史,如何控制延迟、token 与存储成本。我们怎么知道一个 Agent 的记忆系统真的记对了?目前最常见的答案是做问答。把一段长历史交给记忆系统,之后向 Agent 提问;回答正确,就认为记忆有效,回答错误,就认为记忆失败。最终回答记忆状态检索结果生成模型行为。

weixin_45642847的博客 221

office-academic-skill:论文阅读报告和组会PPT怎么生成

•两份文件都能在 Word 和 PowerPoint 里正常打开、能直接编辑;•PPT 每页只有一个核心观点,标题是判断,不是话题标签;•每一条定量结论都能在 PDF 里指到具体位置——第几页、哪个图或哪张表;•所有来源标签都指向真实存在的条目;•局限性那一节里,作者声明的和推断出来的分开写;•单位、坐标轴、图例跟原文一致。最省事的做法是先做阅读报告:把 PDF 和上面那段提示词发过去,删掉 PPT 那两行,拿到 docx 之后先按核对项的六条过一遍。

AcademicIdeas的博客 263

意识障碍--论文阅读5

传统 DBS 主要依据解剖靶点及固定刺激参数进行治疗,未充分考虑患者个体症状差异和动态状态变化,可能是治疗效果不稳定的原因之一。本文研究不同刺激靶点的症状特异性,以及初始状态对刺激响应的影响。

qq_42829312的博客 166

【论文阅读】Agent记忆机制(110):MemCode——用离散语义码突破长期 Agent 记忆的向量检索边界

摘要(148字): MemCode 提出一种双路径记忆访问机制,将长期记忆写入自包含的原子单元(AMU),并为每条记忆生成离散语义指纹。通过结合连续向量近邻与离散码本共现关系,突破传统向量检索在语义关联上的局限。该方法在不依赖显式图结构的前提下,实现跨事件、跨时间的事实连接,显著提升多跳推理性能。异步演化机制保障系统可扩展性,核心创新在于将写入、索引与检索对齐,推动记忆系统从“存得久”迈向“找得准”。

weixin_45642847的博客 376

【多论文阅读笔记】下一阶段,Agent记忆关注什么能力?

本文聚焦于下一代Agent记忆系统的核心目标——维持运行态“心流”,即实现信息的无损、无缝调用。基于此,作者评析了近期三项代表性测评基准:LoCoMo-Plus(测认知记忆)、TriggerBench(测前瞻记忆)与EvalMem。其中,LoCoMo-Plus通过隐含状态与跨场景触发,检验模型对用户价值观、目标等深层记忆的运用能力;TriggerBench则模拟真实提醒场景,测试模型在恰当时机激活记忆的能力。二者均超越传统事实记忆,但前者忽略幻觉与认知错配风险,后者尚待扩展。整体而言,这些工作推动记忆测评向

xian_ren008的博客 194

【论文阅读】Agent记忆机制(108):系统级剖析长期记忆的构建、检索与部署成本

本文首次将Agent Memory视为具有构建、检索、生成与维护成本的状态化系统工作负载,而非仅以准确率衡量的算法模块。通过对10种代表性系统进行阶段级性能剖析,揭示不同记忆范式在写路径与读路径间对延迟、能耗、一致性与扩展性的权衡。研究提出统一框架,涵盖七阶段执行流程,并提炼出10条部署建议,强调“系统账单”对实际落地的关键意义。

weixin_45642847的博客 322
上一篇: 论文阅读:H-ViT,一种用于医学图像配准的层级化ViT
下一篇: 论文阅读:自适应ViT(A-ViT)
蓝海渔夫
博客等级 码龄14年 6133粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝海渔夫

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值