【Spark亚太研究院系列丛书】Spark实战高手之路-第一章 构建Spark集群(第三步)(1)

限时加码!20+主流AI编程工具免费用 购周边加赠Coding Plan Lite,Claude Code、Cursor等即刻畅享,学习进阶更高效! 阅读详情

第一步:Spark集群需要的软件;

 在1、2讲的从零起步构建好的Hadoop集群的基础上构建Spark集群,我们这里采用2014年5月30日发布的Spark 1.0.0版本,也就是Spark的最新版本,要想基于Spark 1.0.0构建Spark集群,需要的软件如下:


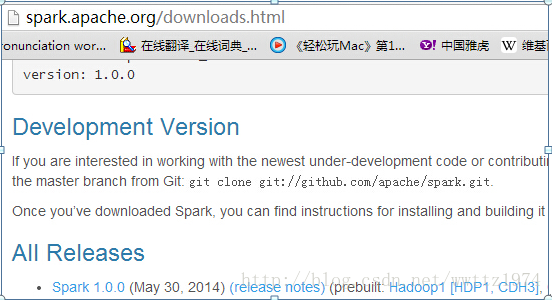
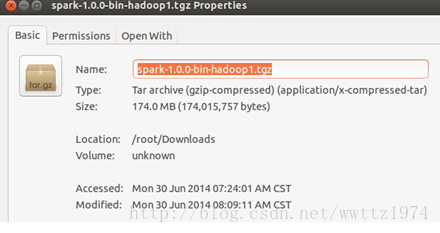
1.Spark 1.0.0,笔者这里使用的是spark-1.0.0-bin-hadoop1.tgz, 具体的下载地址是http://d3kbcqa49mib13.cloudfront.net/spark-1.0.0-bin-hadoop1.tgz

如下图所示:
笔者是保存在了Master节点如下图所示的位置:

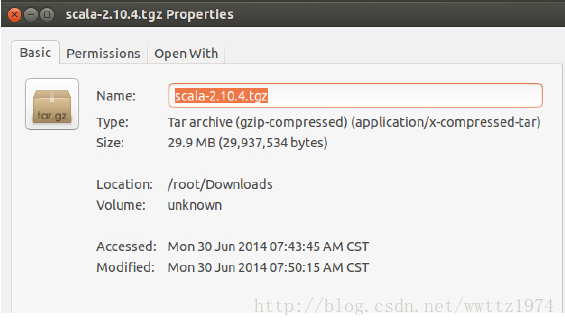
2.下载和Spark 1.0.0对应的Scala版本,官方要求的是Scala必须为Scala 2.10.x:

 笔者下载的是“Scala 2.10.4”,具体官方下载地址为http://www.scala-lang.org/download/2.10.4.html 下载后在Master节点上保存为:

第二步:安装每个软件

 安装Scala

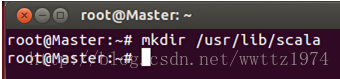
  1. 打开终端,建立新目录“/usr/lib/scala”,如下图所示:


2.解压Scala文件,如下图所示:
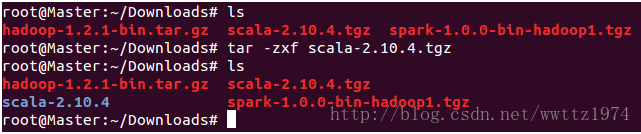

把解压好的Scala移到刚刚创建的“/usr/lib/scala”中,如下图所示
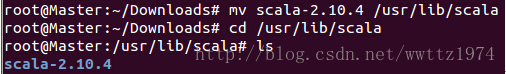

3.修改环境变量:


进入如下图所示的配置文件中:
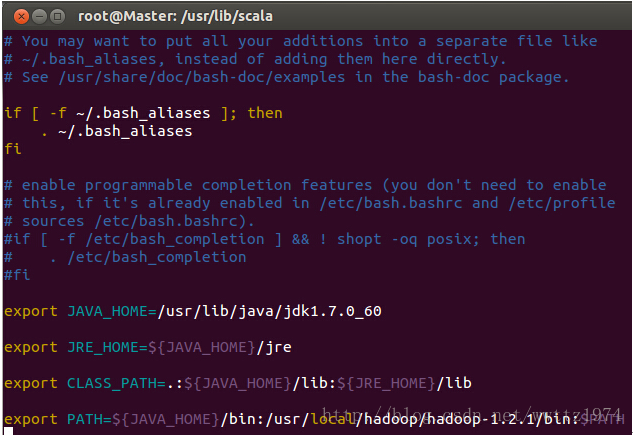

按下“i”进入INSERT模式,把Scala的环境编写信息加入其中,如下图所示:
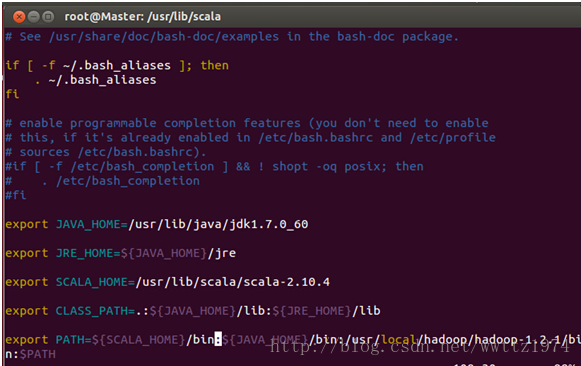

从配置文件中可以看出,我们设置了“SCALA_HOME”并把Scala的bin目录设置到了PATH中。

按下“esc“键回到正常模式,保存并退出配置文件:

执行以下命令是配置文件的修改生效:


4.在终端中显示刚刚安装的Scala版本,如下图所示


发现版本是”2.10.4”,这正是我们期望的。

当我们输入“scala”这个命令的的时候,可以直接进入Scala的命令行交互界面:
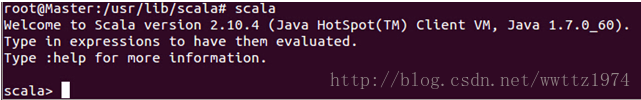

此时我们输入“9*9”这个表达式:
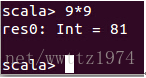

此时我们发现Scala正确的帮我们计算出了结果 。

此时我们完成了Master上Scala的安装;


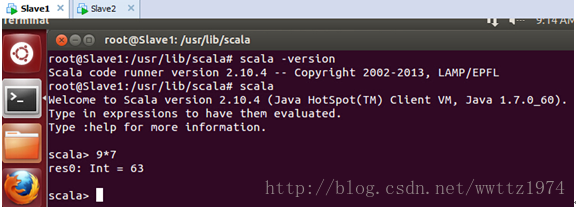
由于我们的 Spark要运行在Master、Slave1、Slave2三台机器上,此时我们需要在Slave1和Slave2上安装同样的Scala,使用scp命令把Scala安装目录和“~/.bashrc”都复制到Slave1和Slave2相同的目录之之下,当然,你也可以按照Master节点的方式手动在Slave1和Slave2上安装。


在Slave1上Scala安装好后的测试效果如下:

在Slave2上Scala安装好后的测试效果如下:
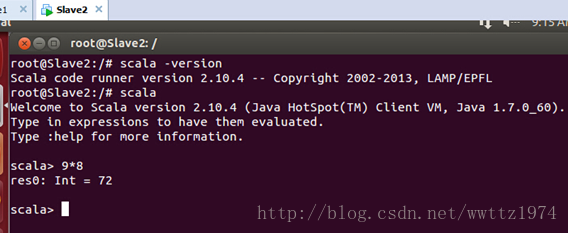

至此,我们在Master、Slave1、Slave2这三台机器上成功部署Scala。

Spark实战高手之路-从零开始 立即下载

相关推荐

Spark实战高手之路

Spark实战

td overflow

<br /><br />文章转自:http://apps.hi.baidu.com/share/detail/16858090<br /> <br />table-layout<br />语法:<br />  table-layout : auto | fixed <br />  参数:<br />  auto : 默认的自动算法。布局将基于各单元格的内容。表格在每一单元格读取计算之后才会显示出来。速度很慢<br />  fixed : 固定布局的算法。在这算法中,水平布局是仅仅基于表格的宽度,表格边框的宽

wwttqq85538649的专栏 7342

大数据Spark实战高手之路1---熟练的掌握Scala语言系列课程

大数据Spark实战高手之路1---熟练的掌握Scala语言系列课程

jquery 操作cookie

<br />参考地址:http://hi.baidu.com/crp8/blog/item/5b856e1ece4ca1f21bd576c1.html<br /> <br />一、什么是Cookie Cookie是在Web上用于存储客户系统信息的对象。所有的信息都 以每行一个Cookie的形式存放在客户端的一个名为cookies.txt的文 件里。Cookie在HTTP头标(客户和服务器用来标识自身的分组)中在客 户机与服务器之间传输。 Cookie由某个WWW网页在某客户机上进行

wwttqq85538649的专栏 953

flexgrid jquery

<br />1下载地址:http://code.google.com/p/flexigrid/<br /> <br />官网:http://www.flexigrid.info/<br /> <br />参考文章:http://w.leadbbs.com/a/a.asp?B=230&ID=2789373

wwttqq85538649的专栏 559

理解C#中的string类型

作者:未知目的 本文的目的在于揭示和DOTNET及C#相关的一些常见的和不常见的问题。在这些问题中我的第一篇文章和string数据类型有关,string数据类型是一种引用类型,但是当和其他引用类型比较的时候,很多开发人员可能并不能完全理解它的行为。 问题 对于常见的引用类型,当改变一个对象别名的值时,这种变化也同样会在一个实际的对象中表现...

aome1470的博客 279

同时获得table中的tr的id和td的id

<br /><br /><!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd"><br /><html xmlns="http://www.w3.org/1999/xhtml"><br /><head><br />    <title></title><br />    <script src="script/jquery-

wwttqq85538649的专栏 2301

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群第三步)(1)...

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34194087的博客 163

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群第三步)(3)

启动并查看集群的状况 第一步:启动Hadoop集群,这个在第二讲中讲解的非常细致,在此不再赘述: 启动之后在Master这台机器上使用jps命令,可以看到如下进程信息: 在Slave1 和Slave2上使用jps会看到如下进程信息: 第二步:启动Spark集群  在Hadoop集群成功启动的基础上,启动Spark集群需要使用Spark的sbin

wwttz1974的专栏 1244

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第五步)(1

第一步:构造分布式Hadoop2.2.0集群 1,在Windows 7(本教程中的Spark集群运行的机器是8G的Windows内存)上安装VMware虚拟机(我们安装的是VMware-workstation-full-9.0.2),本教程中的VMware Workstation下载地址:        https://my.vmware.com/cn/web/vmware/det

wwttz1974的专栏 1739

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第五步)(13)

从控制台可以看到我们的程序成功在集群上运行:   Detail for stage 1

wwttz1974的专栏 581

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第二步)(1

在VMWare 中准备第二、第三台运行Ubuntu系统的机器;   在VMWare中构建第二、三台运行Ubuntu的机器和构建第一台机器完全一样,再次不在赘述。。 与安装第一台Ubuntu机器不同的几点是: 第一点:我们把第二、三台Ubuntu机器命名为了Slave1、Slave2,如下图所示: 创建完的VMware中就有三台虚拟机了: 第二

wwttz1974的专栏 894

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群第三步)(2)

安装Spark   Master、Slave1、Slave2这三台机器上均需要安装Spark。 首先在Master上安装Spark,具体步骤如下: 第一步:把Master上的Spark解压:

wwttz1974的专栏 1299

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第二步)(3)

首先修改Master的core-site.xml文件,此时的文件内容是: 我们把“localhost”域名修改为“Master”:

wwttz1974的专栏 964

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第五步)(9)

第二步:构造分布式的Spark1.0.2集群   1,下载Scala 2.10.4,具体下载地址: http://www.scala-lang.org/download/2.10.4.html  在Ubuntu机器上Scala会帮助我们自动选择“scala-2.10.4.tgz”进行下载;   2,安装和配置Scala 我们需要在SparkMaster、SparkWorker1以及S

wwttz1974的专栏 586

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群(第五步)(10)

SparkWorker1 和SparkWorker2上使用jps会看到如下进程信息: 第二步:启动Spark集群 在Hadoop集群成功启动的基础上,启动Spark集群需要使用Spark的sbin目录下“start-all.sh”:

wwttz1974的专栏 501

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群第三步)(3)...

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34356310的博客 84

Spark亚太研究院系列丛书Spark实战高手之路-第一章 构建Spark集群第三步)(2)...

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34221276的博客 118
上一篇: 【Spark亚太研究院系列丛书】Spark实战高手之路-第一章 构建Spark集群(第二步)(4)
下一篇: 【互动问答分享】第10期决胜云计算大数据时代Spark亚太研究院公益大讲堂
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值