集成学习-bagging算法

Bagging算法 集成学习有两个流派,一个是boosting派系,它的特点是各个弱学习器之间有依赖关系。另一种是bagging流派,它的特点是各个弱学习器之间没有依赖关系,可以并行拟合。 Bagging算法(英语:Bootstrap aggregating,引导聚集算法),又称装袋算法,是机器学习领域的一种团体学习算法。最初由Leo Breiman于1996年提出。Bagging算法可与其他分类、回归算法结合,提高... 阅读详情

目录

集成学习概念

集成学习算法

bagging算法

bagging算法的使用实现


集成学习概念

       集成学习就是组合多个学习器,最后可以得到一个更好的学习器。(就好比当做重要决定时,大家可能都会考虑吸取多个专家而不只是一个人的意见,集成学习亦是如此)

集成学习算法

  1. 个体学习器之间不存在强依赖关系。装袋(bagging)
  2. 随机森林(Random Forest)
  3. 个体学习器之间存在强依赖关系。 提升(boosting)
  4. Stacking

本文先讲解bagging算法:

bagging算法

bagging算法是在原始数据集选择S次后得到S个新数据集的一种技术,是一种有放回抽样。

假设我们有一个数据集D,使用有放回的随机采样的方法取了k个数据子集(子集样本数都相等):D1,D2,…,Dk,作为新的训练集,我们使用这k个子集分别训练一个分类器(使用分类、回归等算法),最后会得到k个分类模型。我们将测试数据输入到这k个分类器,会得到k个分类结果,比如分类结果是0和1,那么这k个结果中谁占比最多,那么预测结果就是谁。

算法思想过程如图:

bagging算法的使用实现

#导入包
from sklearn import neighbors
from sklearn import datasets
from sklearn.ensemble import BaggingClassifier
from sklearn import tree
from sklearn.model_selection import train_test_split
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline

#导入鸢尾花数据
iris = datasets.load_iris()
x_data = iris.data[:,:2]
y_data = iris.target
x_train,x_test,y_train,y_test = train_test_split(x_data,y_data) #分为训练集和测试机

#使用knn算法进行分类
knn = neighbors.KNeighborsClassifier()
knn.fit(x_train,y_train)
#画图
def plot(model):
    #获取数据值所在的范围
    x_min,x_max = x_data[:,0].min()-1,x_data[:,0].max()+1
    y_min,y_max = x_data[:,1].min()-1,x_data[:,1].max()+1
    
    #生成网格矩阵
    xx,yy = np.meshgrid(np.arange(x_min,x_max,0.02),
                       np.arange(y_min,y_max,0.02))
    
    z = model.predict(np.c_[xx.ravel(),yy.ravel()])
    z = z.reshape(xx.shape)
    
    #等高线图
    cs = plt.contourf(xx,yy,z)
#画图
plot(knn)
#画散点图
plt.scatter(x_data[:,0],x_data[:,1],c=y_data)
plt.show()

#准确率
knn.score(x_test,y_test)

#使用决策树算法分类
dtree = tree.DecisionTreeClassifier()
dtree.fit(x_train,y_train)
#画图
#画图
plot(dtree)
#画散点图
plt.scatter(x_data[:,0],x_data[:,1],c=y_data)
plt.show()

#准确率
dtree.score(x_test,y_test)

#KNN算法使用bagging
bagging_knn = BaggingClassifier(knn,n_estimators=100)
#输入数据建立模型
bagging_knn.fit(x_train,y_train)
plot(bagging_knn)
#样本散点图
plt.scatter(x_data[:,0],x_data[:,1],c=y_data)
plt.show()
bagging_knn.score(x_test,y_test)

#决策树算法使用bagging
bagging_dtree = BaggingClassifier(dtree,n_estimators=100)
#输入数据建立模型
bagging_dtree.fit(x_train,y_train)
plot(bagging_dtree)
#样本散点图
plt.scatter(x_data[:,0],x_data[:,1],c=y_data)
plt.show()
bagging_dtree.score(x_test,y_test)

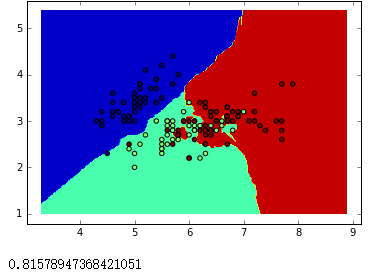
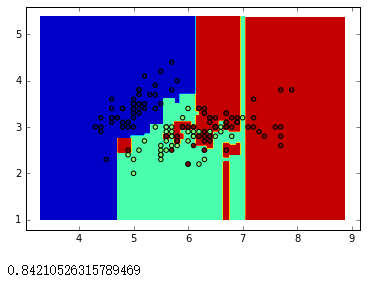
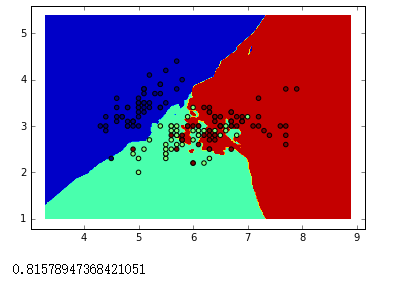
结果如下图:

KNN算法                                                                bagging-KNN
 决策树算法                                                      bagging-决策树
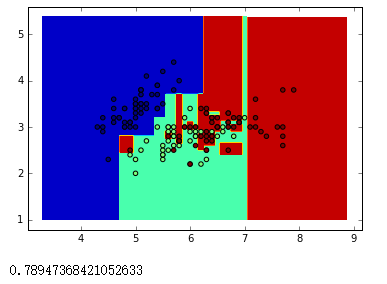
从图中我们可以看出,一般来说使用了bagging会提高算法的效率,是分类更加准确,有的时候也会不起作用。

深度探索:机器学习中的Bagging原理及其应用 Bagging作为一种简单而有效的集成学习策略,通过引入随机性增强个体学习器的多样性,显著提升了模型的稳定性和泛化能力。尽管存在对异常值敏感、解释性较弱等问题,但其在各类机器学习任务中展现出强大的实用性,特别是在处理复杂、非线性、高维数据集时。未来,研究方向可能包括: 改进个体学习器选择:探索更适用于Bagging的个体学习器类型,如深度学习模型、规则列表等,以适应不同领域的应用需求。 动态调整集成参数:研究自适应调整个体学习器数量、自助采样比例等参数的方法,实现模型性能的自动优化。 阅读详情

相关推荐

分类算法 -- 集成学习bagging算法(理论介绍)以及bagging和Adaboost的区别

在前一篇中,我们介绍了集成学习中的Adaboost算法。本文中,我们将介绍集成学习中另一个很有名的算法----bagging算法

海军上将光之翼的博客 5491

bagging算法

Bagging的策略: 从样本集中用Bootstrap采样选出n个样本 在所有属性上 对这n个样本建立分类器(CART or SVM or ) 重复以上两步m次 i e build m个分类器(CART or SVM or ) 将数据放在这m个分类器上跑 最后vote看到底分到哪一类

Matlab实现Bagging集成学习算法

实验环境: Matlab2016a 实验内容: 实现Bagging算法,训练多个分量分类器,比较分量分类器和最后的总分类器的分类准确率。 Bagging算法: 从大小为n的原始数据集中,分别独立随机地选取n’个样本组成自助数据集,并且将这个过程独立进行许多次,直到产生很多个独立的自助数据集。然后,每个自助数据集都被独立地用于训练一个“分量分类器”,最终分类器的判决将根据这些“分量

山高路远坑很深的博客 1万+

集成学习:Boosting和Bagging算法

1. 背景介绍 1.1 集成学习的起源与发展 集成学习作为机器学习领域的重要研究方向,其起源可以追溯到20世纪80年代。最初,研究者们尝试将多个简单的分类器组合起来,以期获得比单个分类器更好的性能。随着研究的深入,集成学习逐渐发展成为一种独立的机器学习方法,并涌现出一系列经典算法,如Baggin

AI天才研究院 1117

bagging算法(随机森林RF算法

bagging算法(随机森林RF算法简介) bagging算法特点是各个弱学习器之间没有依赖关系,可以并行拟合。加快计算速度。那么,bagging算法其实是一种工程思维,真正把这个思维转换成可以应用于工程计算的就是随机森林算法 通过上图我们知道,bagging是每个弱学习器之间的并行计算最后综合预测,但是,有一个问题需要我们注意,在训练集到子训练器的过程叫做“子抽样”。 这个子抽样是一个“随机有...

Thanking The Future 4698

机器学习】集成算法:bagging策略包含详细案例

Bagging是一种基于集成学习算法,是一种广泛使用的机器学习技术。Bagging的全称是Bootstrap Aggregating,其思想是通过将许多相互独立的学习器的结果进行结合,从而提高整体学习器的泛化能力。本篇博客将介绍Bagging算法的工作原理,优点和缺点,以及如何在Python中实现。

qq_61260911的博客 8881

集成学习Bagging算法详解及代码实现

Bagging全称叫做,通过训练多个相同类型的基学习器,并将他们的预测结果进行集成,从而提高模型整体性能的集成学习方法。Bagging的核心思想是通过并行训练多个基学习器,每个基学习器在训练集的不同子集上进行训练,最终通过这些基学习器的预测结果进行平均(回归任务)或投票(分类任务)得到最终预测结果。训练n个模型,每个模型在不同训练子集上独立训练所有基学习器的预测结果进行平均(回归任务)或投票(分类任务)得到最终决策。采用bootstrap。

码农努力学习 3375

集成学习】:bagging和boosting算法及对比

转载于:bagging和boosting算法集成学习算法Bagging算法和Boosting区别和联系 机器学习笔记-集成学习Bagging,Boosting,随机森林三者特性对比 前言 集成学习 定义:集成学习通过构建并结合多个学习器来完成学习任务。 分类:只包含同种类型的个体学习器,这样的集成是“同质”的,例如都...

Mr_health的博客 1万+

集成学习Bagging、Boosting、Stacking)算法原理与算法步骤

you_just_look的博客 5604

机器篇——集成学习(一) 细说 Bagging 算法

返回主目录 返回集成学习目录 上一章:机器篇——决策树(六)细说 评估指标的交叉验证 下一章:机器篇——集成学习(二)细说随机森林(Rondoom Forest)算法 目录内容 机器篇——集成学习(一)细说 Bagging 算法 机器篇——集成学习(二)细说随机森林(Rondoom Forest)算法 机器篇——集成学习(三)细说 提升(Boosting) ...

天下所弃,不过其纪。世间事,在人,在志。 1万+

bagging算法_集成学习算法:Boosting、Bagging | 随机森林、Stacking

集成学习,将多个学习器结合并构建出更优越的泛化性能。单个分类器的分类效果不好,那么我们就把这些分类器结合起来用提升性能。集成学习,又被成为多分类器系统。当系统中都是同种类型的学习器,我们就称为同质(homogeneous)的,同质系统中的学习算法称为基学习算法;当系统中存在不同类型的学习器,我们就称为异质的(heterogeneous)。理论上,我们期望通过结合多个弱学习器得到强学习器。但是在实践...

weixin_39805180的博客 548

集成学习Bagging和Boosting算法总结

一、集成学习综述 集成方法或元算法是对其他算法进行组合的一种方式,下面的博客中主要关注的是AdaBoost元算法。将不同的分类器组合起来,而这种组合结果被称为集成方法/元算法。使用集成算法时会有很多的形式,如: 不同算法的集成 同一种算法在不同设置下的集成 数据集不同部分分配给不同分类器之后的集成 AdaBoost算法优缺点 优点:泛化错误率低,易编码,可以应用在大部分分类器...

CurryCoder的个人博客 1689

机器学习集成学习(Boosting算法Bagging算法、Stacking算法)总结

20190616 1集成学习 集成学习就是组合多个学习器,最后可以得到一个更好的学习器 #集成学习算法 #装袋(bagging):个体学习器之间不存在强依赖关系 #随机森林(Random Forest) #提升(boosting):个体学习器之间存在强依赖关系 #Stacking 2bagging 是一种有放回抽样 ...

~华仔的博客 2508

bagging算法_集成学习方法-bagging-RandomForest

Bagging集成学习的主要想法是将若干个弱分类器,通过线性组合,组成一个较强的模型。bagging集成学习的方式,可以实现模型的并行化训练,并且能有效的降低方差。Bagging算法流程::(1) 从原始样本集中抽取训练集。每轮从原始样本集中使用Bootstraping的方法抽取n个训练样本。共进行k轮抽取,得到k个训练集。(k个训练集之间是相互独立的)Bootstraping也称为自助法,它是...

weixin_39869593的博客 1351

机器学习 集成学习篇——python实现Bagging和AdaBOOST算法

机器学习 集成学习篇——python实现Bagging和AdaBOOST算法摘要Bagging算法Adaboost算法 摘要 本文通过python实现了集成学习中的Bagging和AdaBOOST算法,并将代码进行了封装,方便读者调用。 Bagging算法 import numpy as np import pandas as pd class Cyrus_bagging(object): def __init__(self,estimator,n_estimators = 20):

Cyrus_May的博客 3556

集成学习Bagging、Boosting、Stacking算法详解

集成学习(Ensemble Learning)是一种通过结合多个模型的预测结果来提高整体预测性能的技术。它通过将多个学习器的结果集成起来,使得最终的模型性能更强,具有更好的泛化能力。常见的集成学习框架包括:Bagging、Boosting、Stacking。

码农努力学习 1187

集成学习-Bagging和Boosting算法

本文介绍了集成学习中的Bagging和Bosting算法,包括随机森林、AdaBoost、GDRT、XGBoost的代码应用。

有一分热,发一分光。 2353

集成学习算法-Bagging和Boosting及其相关算法概述

1、集成学习 1.1 简介        在学习树模型的时候,经常听到有关于集成学习的概念。集成学习机器学习中有较高的准确率,不足之处就是模型的训练过程比较复杂,效率不是很高;主要分为两种类型: (1)基于boosting思想的算法,例如:Adaboost、GDBT和XGBOOST。 (2)基于Bagging思想的算法,经典的就是随机森林算法 1.2 集成学习的思想        首先...

u011587322的博客 1953
上一篇: 决策树---ID3算法、C4.5算法、CART算法
下一篇: 随机森林(RF)
xiaoming1999
博客等级 码龄9年 2857粉丝 114原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值