


公众号:dify实验室
基于LLMOps平台-Dify的一站式学习平台。包含不限于:Dify工作流案例、DSL文件分享、模型接入、Dify交流讨论等各类资源分享。
前言
单一信息源往往难以满足双重需求:仅依赖内部知识库可能导致信息滞后,无法回应最新事件或进展;而单纯依赖实时网络搜索,则可能面临信息过载、质量参差不齐、缺乏权威性等问题。为了克服这些挑战,我们可以设计一个能够智能协同内部知识库与外部互联网搜索,并最终由大型语言模型(LLM)进行深度整合与精准回答的高级工作流。
本文将详细拆解该工作流的设计理念、节点配置、数据流转及核心优势,为您呈现一个构建强大智能问答系统的实践蓝图。
工作流核心设计思想
本工作流的核心在于“分而治之”与“合而为一”。首先,通过LLM初步理解用户意图,生成多元化的深度搜索指令数组;其次,并行地、有针对性地从内部知识库和外部互联网这两个互补的信息渠道搜集素材;最后,再次利用LLM的强大理解与生成能力,将搜集到的碎片化信息,结合用户的原始问题,融合成一个高质量、高相关的统一答案。DSL文件见文末。
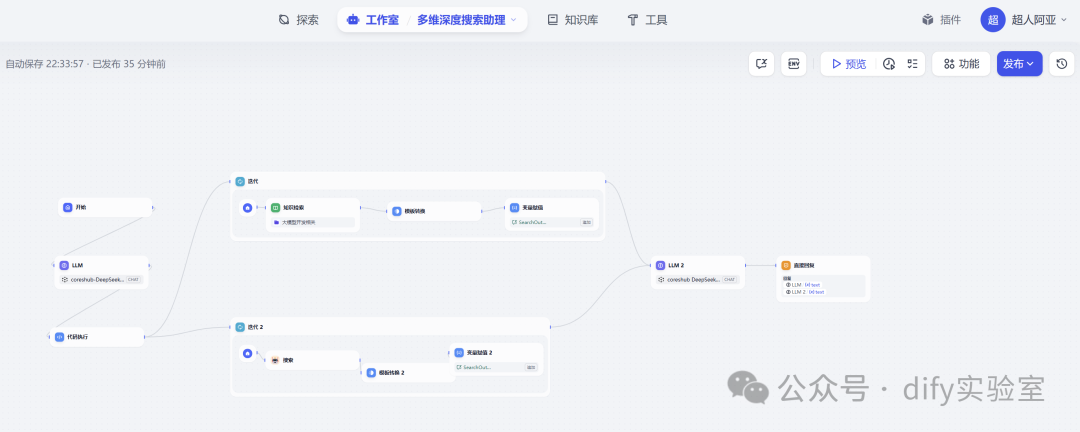
工作流详细步骤拆解
第一步:开始节点 - 用户提问的入口与起点
- 节点类型: 开始
- 功能: 作为整个工作流的触发器,负责接收并承载用户通过界面或API传入的原始问题。这个输入是驱动后续所有处理逻辑的源头。
- 重要性: 用户问题的清晰度与具体性直接影响后续搜索词生成和最终答案的质量。
- 示例输入: 用户可能输入如:“请详细介绍一下近期国家发布的关于人工智能伦理治理的新政策,并分析其可能对AI创业公司带来的机遇与挑战?”
- 输出: 用户的原始提问字符串,将作为变量传递给下一个节点。
第二步:LLM节点 - 智能解析与搜索词策略化构建
- 节点类型: LLM
- 核心任务: 对用户的原始提问进行深度语义理解,并基于此生成一个结构化的、包含多个相关搜索查询词的数组(列表)。这不仅仅是关键词提取,更是一种基于意图理解的查询扩展和细化。
- 输入: 来自「开始」节点的原始用户提问字符串。
- 提示词:
- 根据以下用户提问:'{user_query}',请提取核心概念和查询意图,生成一个包含多个相关搜索查询词的array数组。数组长度不超过5。这些查询词应用于知识库检索和网络搜索。这个array数组需包含用户原始提问。例如:["大模型开发","大语言模型开发","大模型技术开发","AI大模型开发","深度学习大模型开发"]
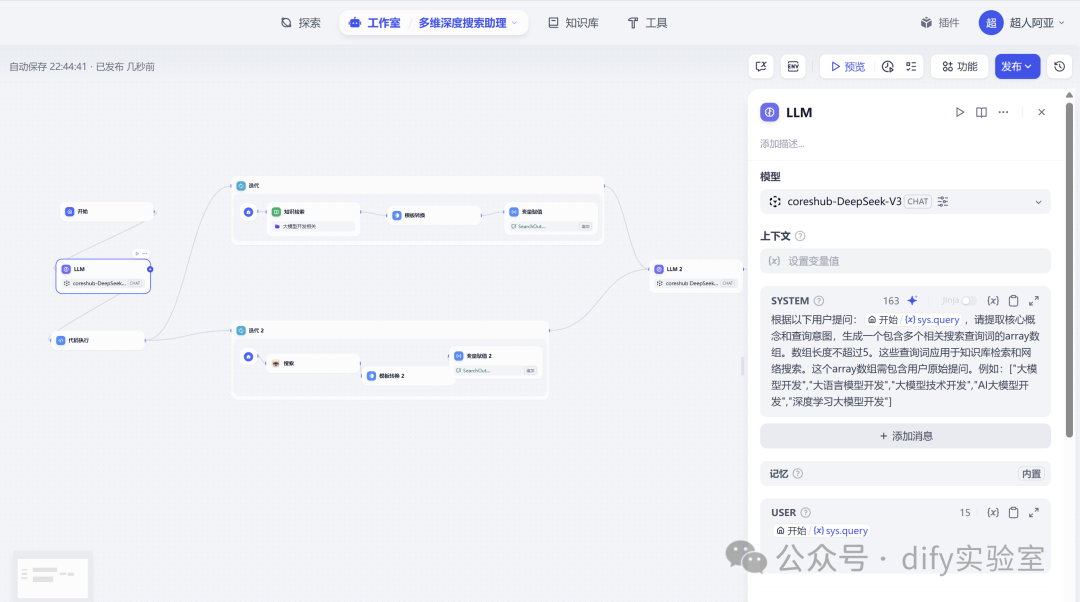
第三步:将代码执行节点将变量类型由string转为array
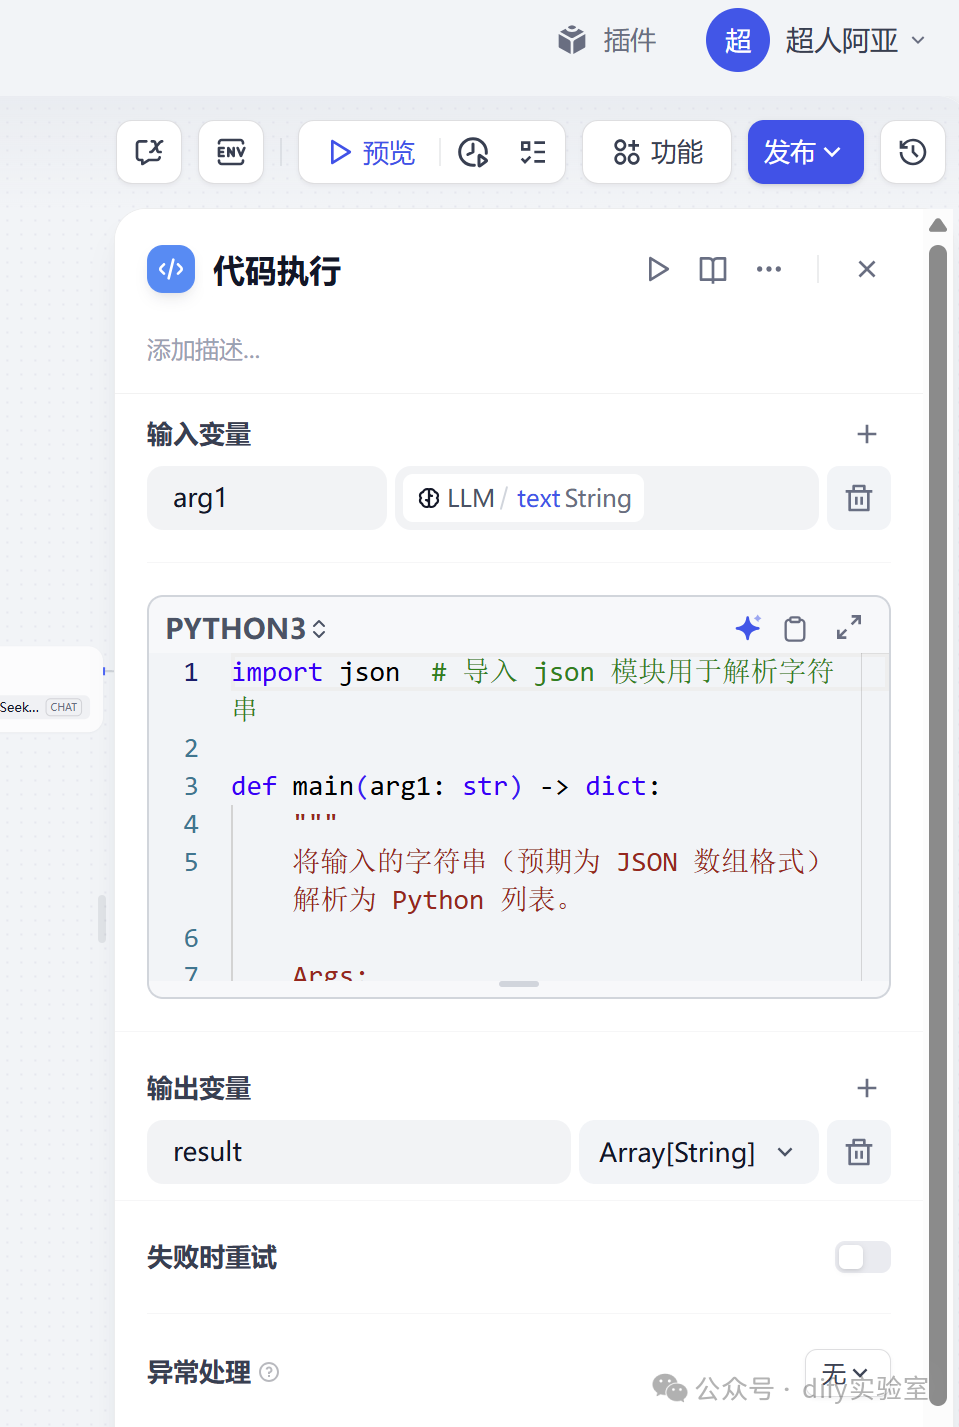
第四步:并行信息获取 - 知识库深度挖掘与网络实时追踪
这是工作流的核心效率体现环节。上一步生成的数组将作为输入,同时流向两个独立的处理分支。




 扫一扫


 4711

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


