python爬取网页内容(一个python文件十几行完成,无废话,几分钟学会)

python 爬虫 自编小项目可实现十几分钟下载网页数十页数据 #!/usr/bin/env python # -*- coding: utf-8 -*- # @Time : 2020/11/24 18:33 # @Author : huni # @File : 多线程+多页爬).py # @Software: PyCharm from threading import Thread # 多线程的包 from queue import Queue # 队列 import requests from lxml impo 阅读详情

以当当网为例:

代码:

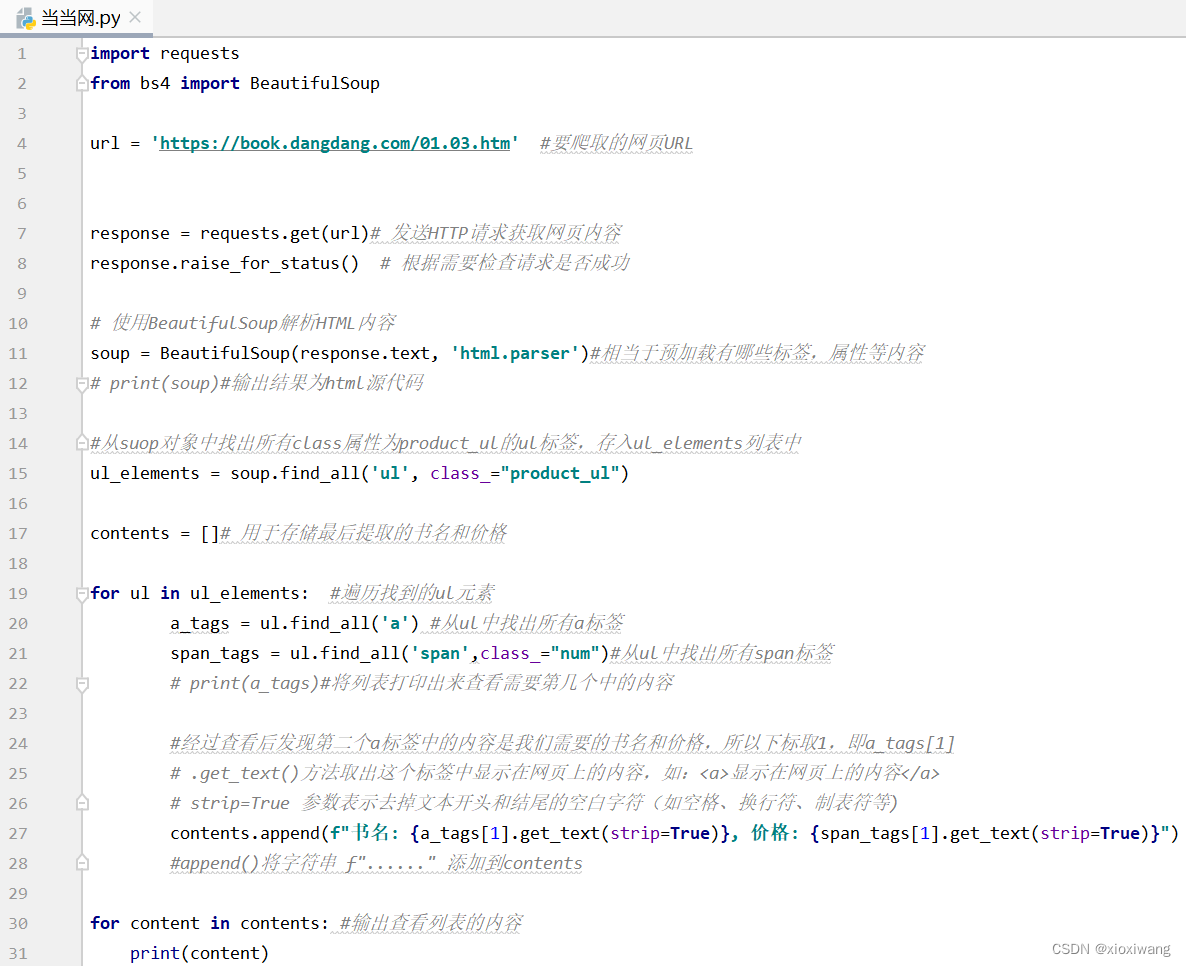
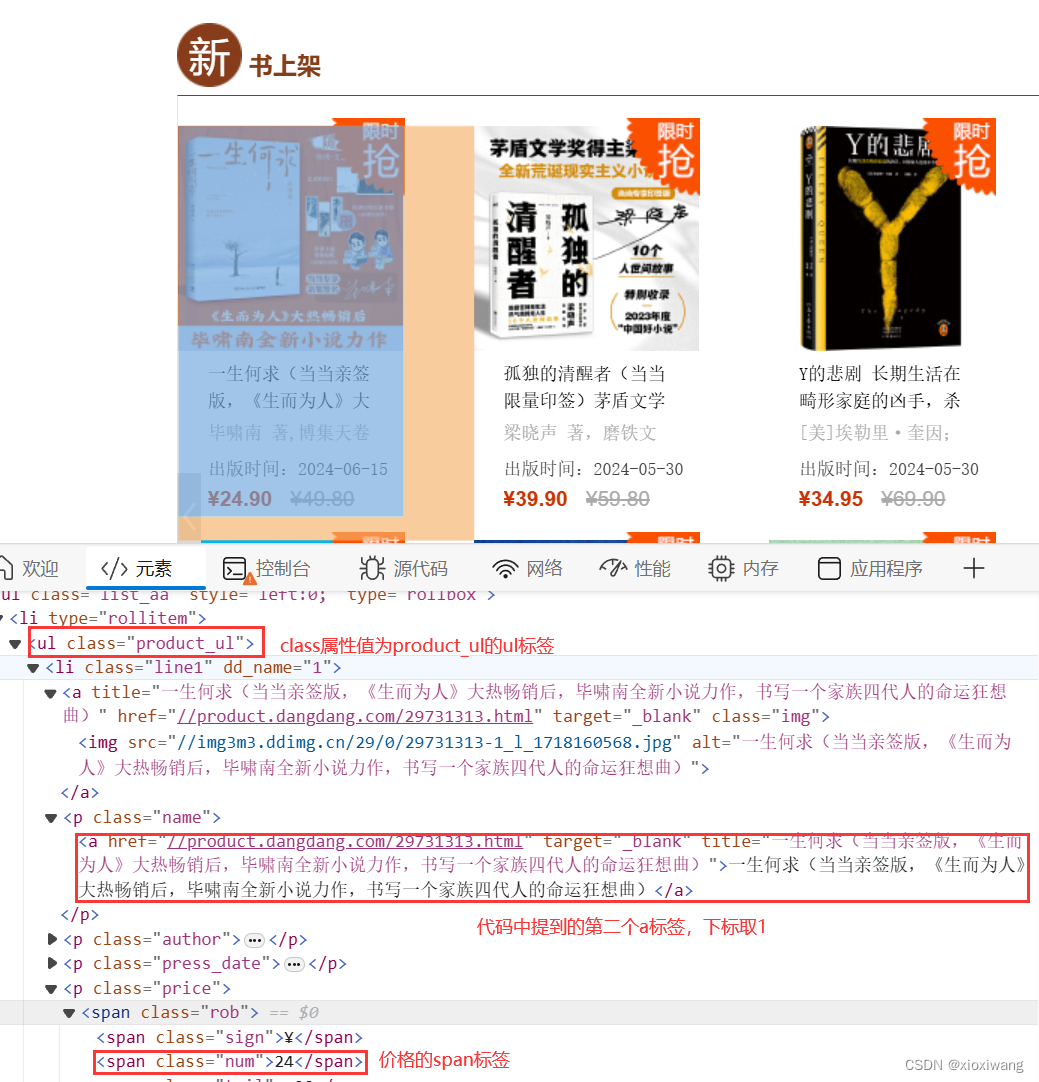
需要修改第一张图片中的第4行的url链接,第15行及后面查找标签的方式

import requests
from bs4 import BeautifulSoup

url = 'https://book.dangdang.com/01.03.htm'  #要爬取的网页URL


response = requests.get(url)# 发送HTTP请求获取网页内容
response.raise_for_status()  # 根据需要检查请求是否成功

# 使用BeautifulSoup解析HTML内容
soup = BeautifulSoup(response.text, 'html.parser')#相当于预加载有哪些标签,属性等内容
# print(soup)#输出结果为html源代码

#从suop对象中找出所有class属性为product_ul的ul标签,存入ul_elements列表中
ul_elements = soup.find_all('ul', class_="product_ul")

contents = []# 用于存储最后提取的书名和价格

for ul in ul_elements:  #遍历找到的ul元素
        a_tags = ul.find_all('a') #从ul中找出所有a标签
        span_tags = ul.find_all('span',class_="num")#从ul中找出所有span标签
        # print(a_tags)#将列表打印出来查看需要第几个中的内容

        #经过查看后发现第二个a标签中的内容是我们需要的书名和价格,所以下标取1,即a_tags[1]
        # .get_text()方法取出这个标签中显示在网页上的内容,如:<a>显示在网页上的内容</a>
        # strip=True 参数表示去掉文本开头和结尾的空白字符(如空格、换行符、制表符等)
        contents.append(f"书名: {a_tags[1].get_text(strip=True)}, 价格: {span_tags[1].get_text(strip=True)}")
        #append()将字符串 f"......" 添加到contents

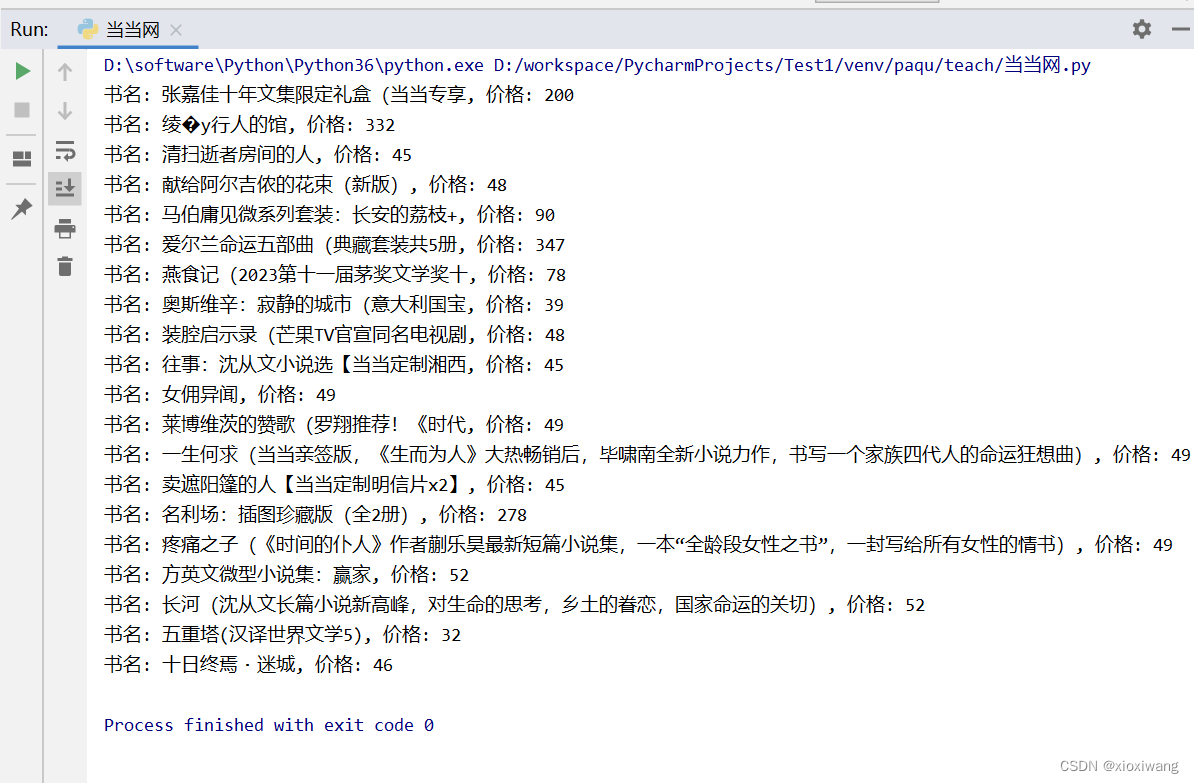
for content in contents: #输出查看列表的内容
    print(content)

需要绘制图标或存入表格的也可以加入QQ群讨论:666347476

如何爬取动态网页的数据?Python实战案例 前言 本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。 一、什么是动态网页 所谓的动态网页,是指跟静态网页相对的一种网页编程技术。静态网页,随着html代码的生成,页面的内容和显示效果就基本上不会发生变化了——除非你修改页面代码。而动态网页则不然,页面代码虽然没有变,但是显示的内容却是可以随着时间、环境或者数据库操作的结果而发生改变的。——来源百度百科 动态网页具有减少工作量、内容更新快、可完成功能多等特点,被很多公司所采用,比如狗东、某 阅读详情

相关推荐

(不看绝对后悔系列一)python网络爬虫爬取长视频并下载

不看后悔!!网络爬虫爬取网页视频功能

Ares称雄 4824

免费教你用PYTHON做的五个小项目~几分钟就学会~

wo来啰~每日准时上线更新!! 感兴趣的宝宝们还不快点击关注????‍♀️????‍♀️????‍♀️ 最近在做python项目开发的时候发现了好多好玩的小项目,并且都是代码量较少容易上手,对新手十分友好。所以今天就来和小可爱们分享一些Python从一行代码到三十行代码的好玩项目!废话不多说啦~上源码???????? 三十行代码爬取任意百度图片 import requests import re import time url = "http://image.baidu.com/search/in

L010409的博客 1816

【Python学习笔记】:Python爬取音频

于是就去搜索页面这种有大量id的网页,通过检查HTML代码的方法,找到了要薅羊毛的这个大集合目标网址的HTML代码,然后写爬虫获取网页源代码,通过CSS解析出当中隐藏的一大堆歌名、id等信息,最后再拿这一大堆id组合成完整歌曲链接,去爬想要的一大堆歌曲并且保存到本地。这块是有一点绕,一会是文字一会是属性的,对HTML比较熟的看起来要容易一些,或者对着老师的教程多看几遍,自己多尝试,不懂的问问Kimi。前面我们根据链接直接下载歌曲文件的时候,就用的content方法,直接获取歌曲的二进制文件并保存。

bailichen800的博客 4146

别再用 Python 写爬虫了!易语言 3 行代码爬取网页,中文指令太爽

通过本文的介绍,相信大家对易语言爬虫有了更深入的了解,无论是简单的网页数据采集,还是复杂的多线程爬虫开发以及应对反爬虫机制,易语言都能提供有效的解决方案。除了正则表达式,易语言还可以通过第三方库来实现更复杂的 HTML 解析,例如使用 “精易模块” 中的相关函数,能够像 Python 中的 BeautifulSoup 一样,通过 DOM 树遍历的方式更加精准地定位和提取网页中的数据。易语言同样支持多线程编程,通过创建多个线程,每个线程负责一个网页的请求和处理,从而实现并发操作,大大缩短了数据采集的时间。

2509_93051135的博客 1152

Web Scraper——轻量数据爬取利器

日常学习工作中,我们多多少少都会遇到一些数据爬取的需求,比如说写论文时要收集相关课题下的论文列表,运营活动时收集用户评价,竞品分析时收集友商数据。 当我们着手准备收集数据时,面对低效的复制黏贴工作,一般都会萌生一个想法:我要是会爬虫就好了,分分钟就把数据爬取下来了。可是当我们搜索相关教程时,往往会被高昂的学习成本所劝退。拿现在最通用的 python 爬虫来说,对于小白来说往往要跨过下面几座大山: 学习一门编程语言:python 学习网页的基础构成——HTML 标签和 CSS 选择器,有时候还要了解一些.

卤蛋实验室 1717

我用Python爬取美食网站3032个菜谱并分析,真香!

这是巨变的中国,人和食物,比任何时候走的更快。近日,J哥为了寻味中国,奔走于某五线城市的大街小巷,结果除了累,啥也没寻到。 于是,J哥默默打开了各大美食网站,如豆果美食、下厨房、美食天下等。经过甄选,最终爬取了豆果网最新发布的中国菜系共3032个菜谱,然后清洗数据并做可视化分析,试图走上美食博主的康庄大道。 数据获取 豆果美食网的数据爬取比较简单,如果您对爬虫感兴趣,可查看J哥往期原创文章「实战|手把手教你用Python爬虫(附详细源码)」,思路一致。 本文爬取的数据范围为川菜、粤菜、湘菜等八个中国菜系.

菜J学Python的博客 4132

使用Python3爬虫爬取图片

Python3爬虫爬取美女图片 最近看完了崔庆才先生的《Python3网络爬虫开发实战》,了解了不少的新知识。现在打算找几个项目练手。但是我也没什么可以爬的,那么就先从美女图开始爬起吧! 以下是基本思路: ...

Nanaras的博客 2822

Python爬虫教程012:scrapy爬取电影天堂数据

scrapy爬取电影天堂数据。

WwLK123的博客 637

Python--爬虫爬取优美图库--bs4(BeatifulSoup)入门

Python--爬虫(爬取3)--bs4(BeatifulSoup)入门

qq_57663276的博客 3637

虚拟机器人平台CoppeliaSim(Vrep)的逆运动学教学

相信看这篇博客的人都知道CoppeliaSim是做什么的,因此这里不多赘述。CoppeliaSim从最早的Vrep到现在已经更新了N个版本,从过去Vrep3.x开始使用的我这里小小地吐槽一下这个软件。CoppeliaSim每一个版本都有更新,问题是这些更新有时候不能向前兼容,而且时不时更新地让人不知所措(对于有紧急任务的时候真的很火大啊)。 以本文所展示地逆运动学来说,CoppeliaSim在4.0.0之后又大变,推翻了过往所有的拖动模块链接之类的构建方式,转而采用直接通过代码来实现逆运动学。 简单版逆运动

qq_39243015的博客 6690

激光甲烷传感器DIY指南:从DFB激光器选型到Herriott池光路搭建

本文详细介绍了如何DIY激光甲烷传感器,从DFB激光器选型到Herriott池光路搭建的全过程。通过TDLAS技术实现ppm级甲烷检测,适用于家用燃气泄漏监测和农业沼气监测等场景。文章包含核心器件选型、光路搭建技巧、信号调理方案及系统集成优化,为创客提供实用指南。

f9g0h的博客 587

05、Python -- 爬取ts文件格式视频思路

Python -- 爬取ts文件格式视频思路

Java 领域技术分享 3852

从零构建智能ai语音助手:ESP32s3+Python+大语言模型实战指南

本文详细介绍了基于ESP32S3硬件和Python后端的智能语音助手系统开发指南。系统采用ESP32S3采集语音,通过WebSocket实时传输到Python后端处理,利用大语言模型实现自然语言理解和意图识别,再通过TTS合成语音返回。文章从系统架构、工作流程、技术实现(包括OPUS编码、WebSocket通信、ESP32音频处理)等方面进行了详细讲解,并提供了分阶段学习路线和常见问题解决方案。该项目展示了物联网技术与AI技术的融合应用,相比传统语音系统具有更高的灵活性和智能性,为开发者提供了完整的实现方案

Despacito0o的博客 2617

python爬取图片_用Python爬取知乎妹子图片

用Python爬取知乎妹子图片这次呢,笔者给大家分享的是爬取知乎的妹子图,嗯,你懂的。话不多说,直接看战果。嗯,还是很不错的,值得我们去爬取。下面说一下整个过程的实现。页面分析本次爬取的是知乎话题下所有回答的所有图片,如下我们可以看到这个话题有811个回答,所以呢,爬取的图片也是很多的,共爬取了1996张图片。我们知道我们要爬取的是图片,然后图片呢是嵌套在内容当中的,所以我们只要能找到怎么获取到内...

weixin_39951181的博客 258

史上最小白之RNN详解

1.前言 网上目前已经有诸多优秀的RNN相关博客,但是我写博客的出发点主要是为了加深和巩固自己的理解,所以还是决定自己再进行一下总结和描述,如有不正确的地方欢迎指正~ 2.区分RNN 循环神经网络(Recurrent Neural Network),递归神经网络(Recursive Neural Network),你有没有发现他们的缩写都是RNN,那他们两个是同一回事儿吗?网上有一些博客把这两就当...

Tink1995的博客 4万+

从零配置ORB-SLAM3:TUM-VI数据集yaml文件参数调优指南

本文深入解析了ORB-SLAM3在TUM-VI数据集上的yaml配置文件参数调优方法。针对双目惯性模式,详细拆解了相机标定、IMU噪声模型和ORB特征提取三大模块的关键参数,解释了其原理与影响,并通过实战案例展示了如何通过调整特征点数量、FAST阈值及IMU噪声参数,有效提升系统在低纹理环境下的鲁棒性和轨迹精度。

weixin_29071809的博客 146

python爬取app中的音频_喜马拉雅app 爬取音频文件

============== 2019-10-28更新 =================因为喜马拉雅的源码格式改了,所以爬虫代码也更新了一波# -*- coding: utf-8 -*-# website: http://30daydo.com# @Time : 2019/6/30 12:03# @File : main.pyimport requestsimport reimport osur...

weixin_39580042的博客 517

FPGA_AD9361实战

1.参考网站。

Pual_Georg的博客 744

给刚入行Python的福利,一个Python高效薅羊毛工具,请低调使用。

mac和猴米系统不兼容? 网盘最近不好用了,还有什么好用的获取资源的途径? 有什么软件能秒抢限量数码产品吗? 不知道有多少朋友是想要借助工具和软件来提升自己获取资源的速度,以及获得免费资源。 但有句话说得好,授人以鱼不如授人以渔。 今天就想和大家分享一个一劳永逸的工具,学会了你绝对就是未来资源届的“王者”。 影视\小说\动漫资源获取 一些国外或者一些小众电影,找起来总是很麻烦,各种网站都翻遍了还不一定找得到。 但用这个叫Python的黑科技去搜,绝对都是小意思。 那天我想看找国外的电影,通过Python.

libaiup的博客 6170

影像组学文章复现:ITHscore:通过多尺度放射学特征全面定量NSCLC肿瘤内异质性 ----小细胞肺癌肿瘤异质性评分

目的:通过计算机断层扫描(CT)图像量化非小细胞肺癌(NSCLC)的肿瘤内异质性(ITH)。 方法:整合局部辐射特征和全局像素分布模式,开发定量ITH测量-ITHscore。在六个患者队列(n = 1399)中检查ITHscore与肿瘤表型,基因型和患者预后的关联,以验证其在表征ITH方面的有效性。

xxx 1018

两万字硬核指南!Python爬虫requests库从入门到精通:新手也能搞定所有爬取场景(附实战案例+避坑大全)

请求头是客户端发送给服务器的额外信息,比如User-Agent(浏览器类型)、Referer(来源页面)、Cookie(登录凭证)、(编码方式)等。Cookie是服务器存储在客户端的小型文本文件,包含用户的登录凭证、偏好设置等信息。浏览器会在每次请求时自动携带Cookie,服务器通过Cookie识别用户身份。代理IP是一个中间服务器,你的请求先发送到代理IP,再由代理IP发送到目标网站,目标网站只能看到代理IP的地址,看不到你的真实IP。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1494

Python学得好,升职加薪下班早

临下班前,微信群突然“活跃”起来: “小张,下班前把第二季度的销售报表给我。” “小李,找一下最近2年的行业案例。” “小赵,给这300个客户发一下中秋祝福邮件。” ...... 这些话,身在职场的你一定并不陌生。在领导眼里,仿佛你10分钟就能搞定8小时才能完成的工作。 直到有一天,同事又开启了“重复性工作浪费时间”的话题,于是我没忍住插了一句:你们不知道所有需要重复做两次的事情,都可以用Python完成吗? 寂静,死一般的寂静......刚才还满腹牢骚的同事瞬间安静下来了,甚..

370

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

python如何用xpath爬取指定内容_python爬虫:用request最简单的代码爬取图片,以及XpathHelper的使用...

最近这段时间自己一直在学习数据分析这一块,其中关于数据收集方面就可以用到爬虫。那么自己也想把最近所学的一些知识分享给大家。爬虫的方式有很多种,我觉得比较方便的selenium和request,这篇文章介绍request的方式,末尾附上代码。首先来看爬取图片的布骤:1、抓取网页url2、找到自己想要爬取的内容,并解析内容(这里是所有布骤最难的)3、保存图片包括(文件夹的路径,图片名称)4、翻页爬取学...

weixin_39915210的博客 797

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

学会Python对金融学生有多重要?

按耐不住心中的好奇,主页君去采访了一下Zyra。Zyra说,在面试之前,她运用Python快速爬取数据,筛选信息,做了精细准备。有了准备,被问到行研信息Zyra就侃侃而谈,遇到财务问题,她能用Python快速解决,让面试官好感倍增,还被当场夸奖。 得知还有Python助攻后,面试官更是两眼放光。尝到了甜头,Zyra每次面试之前都会刷刷代码题,并且有Python这个帮手,筛选有帮助的面试信息真是又快又准,简直如鱼得水。 就这样,她在秋招中披荆斩棘,狠狠收割6个offer,最后选择了自己最想去的公司。兴奋之余

xiaoganbuaiuk的博客 2040

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

破防了!传统RAG开发太痛苦?这个工具让部署时间从数周缩至几分钟!

NyRAG是一款基于Python的开源RAG开发框架,通过零代码配置式开发模式,彻底简化了传统RAG开发的复杂流程。它集成了网络爬取、文档处理、向量嵌入、检索生成等全流程能力,支持Docker和Vespa云部署,几分钟内即可完成智能聊天机器人或语义搜索系统的搭建。无论是客户支持、企业知识管理还是科研辅助,NyRAG都能大幅降低开发门槛,加速从创意到落地的全流程效率。

Python_cocola的博客 580

python3多进程+协程异步爬取小说爬虫

前言 之前写了一篇关于用多线程爬小说的博客,但是发现爬取16M的小说需要十几分钟,所以今天更新了一篇用多进程外加使用单线程异步的协程同样爬取之前用多线程爬取的同一篇小说,并进行两者效率的对比 本篇测试爬取的小说为《大主宰》1551章 约16M大小 步骤 全局数据列表 urls = [] #储存各章节的URL htmls = []#储存各章节页面HTML titles = []#储存各章节名字 pr...

weixin_43853097的博客 2284
上一篇: 使用nginx将服务器的http协议代理成https协议
下一篇: 不会vue怎么修改vue项目页面的样式
xioxiwang
博客等级 码龄3年 58粉丝 32原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值