


论文精读——A Comprehensive Survey of Continual Learning: Theory, Method and Application
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
Abstract
为了应对现实世界的动态性,智能系统需要在其整个生命周期中逐步获取、更新、积累并利用知识。这种能力被称为Continue Learning(持续学习)。从广义上讲,持续学习明显受到catastrophic forgetting(灾难性遗忘)的限制,即学习新任务通常会导致旧任务的性能急剧下降。Continue Learning的核心目的有二,其一为ensuring a proper stability-plasticity trade-off(稳定性与可塑性间的权衡),其二为an adequate intra/inter-task generalizability(足够的任务内/任务间泛化能力)。随后提出了一种前沿且精细的分类法,深入分析了代表性策略如何应对持续学习,以及它们如何适应不同应用中的特定挑战。
``
一、Introduction
Continue Learning的一种典型设置是按顺序逐一学习一系列内容,并表现得如同这些内容是同时被观察到的(见图 1(a))。这些内容可以是新技能、旧技能的新示例、不同的环境、不同的上下文等,并且包含了特定的实际挑战 [2], [4]。由于这些内容是随着时间逐渐提供的,持续学习在许多文献中也被称为增量学习或终身学习
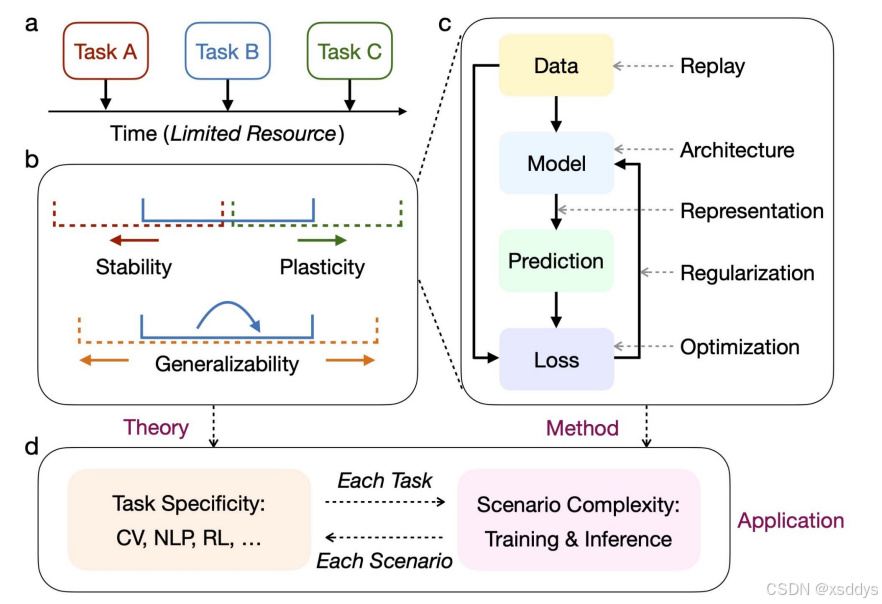
与基于捕捉静态数据分布的传统机器学习模型不同,持续学习的特征是学习动态数据分布。一个主要的挑战被称为catastrophic forgetting灾难性遗忘 [6], [7],适应新分布通常会导致对旧分布的捕捉能力大幅下降。这种困境是学习可塑性与记忆稳定性之间权衡的一个方面:一方面过多的可塑性会干扰稳定性,另一方面过多的稳定性会干扰可塑性。除了简单地平衡这两个方面的“比例”之外,持续学习的理想解决方案应该具有强大的泛化能力,以适应任务内部和任务之间的分布差异(图 1(b))。作为一个简单的基线,重复使用所有旧的训练样本(如果允许的话)可以很容易地解决上述挑战,但会带来巨大的计算和存储开销,以及潜在的隐私问题。事实上,持续学习的主要目的是确保模型更新的资源效率,最好接近于只学习新的训练样本。
挑战:
1.stability-plasticity的平衡
2.泛化能力的提高——泛化能力指的是模型能够将从旧任务中学到的知识应用到新任务上,同时不丧失对旧任务的识别能力。baseline为使用旧任务的数据继续对模型进行新任务的训练,保留所有旧任务使得计算开销巨大但是不至于造成灾难性遗忘
3.持续学习需要被应用与少样本、半监督、无监督场景
近年来机器学习的持续学习方法可分为五类:基于旧模型添加正则化项(regularization-based approach-正则化方法);近似和恢复旧数据分布(replay-based approach-重放方法);显式操作优化程序(optimization-based approach-优化方法);学习稳健且泛化良好的表示(representation-based approach-表示方法);以及通过合理设计的架构构建特定任务的参数(architecture-based approach-架构方法)。特别是,这些方法彼此紧密联系,例如正则化和重放最终都作用于优化中的梯度方向修正,并且高度协同,例如通过从旧模型提取知识可以增强重放的效果。
实际应用为持续学习带来了特定的挑战,这些挑战可以分为场景复杂性和任务特异性(见图 1(d))。对于前者,例如,在训练和测试中可能缺少任务标识,训练样本可能以极小批量甚至一次性的方式引入。由于数据**标记的成本和稀缺性,持续学习需要在少样本、半监督甚至无监督场景中有效。**对于后者,尽管当前的研究进展主要集中在视觉分类上,但其他具有代表性的视觉领域,如目标检测和语义分割,以及相关的领域,如条件生成、强化学习(RL)和自然语言处理(NLP),也因其自身特点而受到越来越多的关注。我们总结了这些特定的挑战,并分析了持续学习方法如何适应它们。
半监督学习(自训练伪标签:用少部分标签数据训练出来的模型打标签补充训练集;对比学习等,)
二、Setup
根据增量批次的划分和任务标识的可用性,我们详细说明以下典型场景
| 实例增量学习(Instance-Incremental Learning, IIL) | 所有训练样本都属于同一个任务,数据逐渐提供 |
|---|---|
| 领域增量学习(Domain-Incremental Learning, DIL) | 同任务具有相同的数据标签空间,但输入分布不同(图像分类,但数据来源是卫星图像和医疗影像) |
| 任务增量学习(Task-Incremental Learning, TIL) | 任务具有不相交的数据标签空间,多任务独立数据集 |
| 类别增量学习(Class-Incremental Learning, CIL) | 任务具有不相交的数据标签空间。只在训练中提供任务标识。 |
| 无任务持续学习(Task-Free Continual Learning, TFCL) | 任务具有不相交的数据标签空间。在训练或测试中均不提供任务标识 |
| 在线持续学习(Online Continual Learning, OCL) | 任务具有不相交的数据标签空间。不同任务的每个训练样本只能被看见一次 |
| 持续预训练(Continual Pre-training, CPT) | 模型进行预训练,然后再逐步学习特定任务的情况,常见于迁移学习场景 |
两个性能指标分别为Average Accuracy, AA-平均准确率和Average Incremental Accuracy, AIA-平均增量准确率, a k , j ∈ [ 0 , 1 ] a_{k,j} \in [0,1] ak,j∈[0,1]表示学习到第 k k k个任务时,任务 j j j的准确率。则:
A A k = 1 k ∑ j = 1 k a k , j AA_k = \frac{1}{k} \sum_{j=1}^{k} a_{k,j} AAk=k1j=1∑kak,j
A I A k = 1 k ∑ i = 1 k A A i AIA_k = \frac{1}{k} \sum_{i=1}^{k} AA_i AIAk=k1i=1∑kAAi
三、Theory
3.1. Stability-Plasticity Trade-Off稳定性与可塑性权衡
D t = { X t , Y t } , t = 1 , 2 , . . . k D_t=\{X_t,Y_t\},t=1,2,...k Dt={
Xt,Yt},t=1,2,...k表示有各任务租成的数据集,持续学习的核心挑战通常源于学习的顺序性质:在学习第 k k k个任务 D k D_k Dk时,旧的训练集 { D 1 , . . . , D k − 1 } \{D_1, ..., D_{k−1}\} {
D1,...,Dk−1}是不可访问的。因此,以平衡的方式捕捉新旧任务的分布是至关重要但极具挑战性的,即确保适当的稳定性-可塑性权衡,其中过多的学习可塑性或记忆稳定性会大大妥协彼此。
一个直接的想法是通过存储一些旧的训练样本或训练一个生成模型来近似和恢复旧数据分布,这被称为基于重放的方法.根据监督学习的学习理论[1],通过重放更多近似其分布的旧训练样本可以提高旧任务的性能,但这会导致潜在的隐私问题和资源开销的线性增加。
另一种选择是通过在贝叶斯框架中制定持续学习来在更新参数时传播旧数据分布。 p ( Θ ) p(\Theta) p(Θ)表示基于网络参数 θ \theta θ的先验概率,在观察到第k个任务后可以利用贝叶斯规则计算后验:
p ( θ ∣ D 1 : k ) ∝ p ( θ ) ∏ t = 1 k p ( D t ∣ θ


 60


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


