


随着AI大模型的普及,RAG(检索增强生成)已经成为AI面试、算法岗、后端集成岗的“必考题”——无论是大厂的AI工程师面试,还是Java/Go后端岗的AI集成考察,RAG都是高频考点,甚至很多产品岗、测试岗也会涉及基础提问。
很多开发者和求职者,要么对RAG一知半解,只知道“检索+生成”的表面含义,被面试官追问底层逻辑时哑口无言;要么背了一堆概念,却分不清“RAG和微调的区别”“向量数据库的选型”等核心问题,最终错失offer。
本文专为面试备考设计,先用通俗语言讲透RAG基本原理(零基础也能看懂),再梳理2026年面试最高频的14个问题,每个问题均搭配“标准答案+面试加分点+避坑提示”,帮你快速吃透、直接套用,高效备战各类AI相关面试。
(全文干货无冗余,建议收藏,面试前30分钟快速复盘,轻松应对面试官追问)
一、RAG基本介绍(通俗版,面试基础必背)
先明确核心:RAG 全称 Retrieval-Augmented Generation(检索增强生成),本质是“给大模型装一个‘外挂知识库’”——让大模型在生成回答前,先从指定的知识库中检索相关信息,再结合自身能力生成准确、可控、可溯源的回答。
不用死记硬背复杂定义,记住一句话:RAG =检索(找资料)+****生成(写答案),核心解决大模型的3个核心痛点:
•知识滞后:大模型的训练数据有截止日期(比如GPT-4截止2023年4月),无法回答最新信息(如2024-2026年的行业动态、公司内部文档);
•答案不可控:大模型容易“一本正经地胡说八道”(幻觉),RAG通过检索真实资料,让答案有依据、可溯源;
•个性化不足:大模型的通用回答无法适配企业内部文档、行业专属知识,RAG可接入自定义知识库,实现个性化回答。
1. RAG的核心工作流程(面试必答,记4****步即可)
面试时,面试官大概率会让你“简述RAG的工作流程”,无需说复杂术语,按以下4步表述,清晰又准确(配合通俗解释,加分):
1.知识库构建(离线阶段):将自定义资料(文档、PDF、网页等)拆分成语义片段,通过Embedding模型(如BERT、Sentence-BERT)转换成向量,存入向量数据库;
2.用户提问(输入阶段):用户输入问题后,同样通过Embedding模型转换成向量;
3.相似检索(核心阶段):用用户问题的向量,在向量数据库中检索出“最相似”的Top N个语义片段(即相关资料);
4.生成回答(输出阶段):将检索到的相关片段和用户问题,一起输入大模型(如GPT、LLaMA),让大模型结合资料生成回答,同时保留资料来源(可溯源)。
补充:用一个生活化例子理解——你要写一篇关于“2026年Java面试趋势”的文章,先去知网、博客检索相关资料(检索),再结合自己的经验整理成文章(生成),这就是RAG的核心逻辑。
2. RAG的核心组件(面试高频考点,记5****个核心)
RAG的核心组件无需记太多,重点掌握5个,每个组件的作用用“一句话总结”,避免冗长,面试时直接回答即可:
•文档加载器(Loader):负责读取各种格式的文档(PDF、Word、TXT、网页等),将其转换成可处理的文本(比如用Apache Tika、LangChain的FileLoader);
•文本分割器(Splitter):将长文档拆分成短的语义片段(避免单次检索内容过长),核心是“语义连贯”,常用按字符长度分割、按段落分割;
•Embedding模型:将文本片段和用户问题转换成“向量”(计算机能理解的语义表示),常用模型有Sentence-BERT、m3e-base(中文场景)、text-embedding-ada-002(OpenAI);
•向量数据库:存储文本向量,支持“相似性检索”,核心作用是快速找到和用户问题最相关的片段(常用:Milvus、Pinecone、Chroma、FAISS);
•大模型(LLM):负责最终的回答生成,输入是“用户问题+检索到的相关片段”,输出是结构化、准确的回答(常用:GPT-3.5/4、LLaMA 2、通义千问)。
3. RAG****的适用场景(面试加分项,体现落地思维)
面试官不仅会问“是什么”,还会问“用在哪”,记住3个高频适用场景,体现你对RAG的实际应用认知:
•企业知识库问答:比如公司内部文档、员工手册、产品手册,用户提问后,快速检索相关内容并生成回答(如客服机器人、内部智能助手);
•行业专属问答:比如医疗、法律、金融等领域,接入行业知识库,让大模型生成符合行业规范的回答(如医疗问诊助手、法律条款咨询);
•最新信息问答:比如新闻资讯、赛事结果、政策更新等,通过实时检索最新资料,解决大模型知识滞后的问题(如实时资讯助手)。
二、RAG面试高频问题(2026版,含标准答案**+**避坑)
以下问题按“考察频率”排序,覆盖基础岗到中高级岗,每个问题的“标准答案”可直接背诵,“加分点”能帮你拉开差距,“避坑提示”帮你避免低级错误,重点标注的是大厂高频题。
基础类(必答,基础岗高频)
问题1:请简述什么是RAG?它的核心作用是什么?(必考)
标准答案:RAG全称检索增强生成,是将“检索”和“生成”结合的技术,核心是让大模型在生成回答前,先从自定义知识库中检索相关信息,再结合自身能力生成回答。核心作用有3点:解决大模型知识滞后、避免幻觉、实现个性化/专属知识问答。
加分点:补充一句——RAG无需对大模型进行微调,就能快速接入自定义知识库,成本低、落地快,适合中小公司快速实现AI问答场景。
避坑提示:不要只说“检索+生成”,一定要补充核心作用,否则会显得理解不深入;不要和“微调”混淆(很多面试官会追问两者区别,见下文)。
问题2:RAG的核心工作流程是什么?(必考)
标准答案:分4个步骤,离线阶段1步,在线阶段3步:① 离线构建知识库:文档加载→文本分割→Embedding转换→向量存入向量数据库;② 在线阶段:用户提问→问题Embedding转换→向量数据库相似检索→结合检索结果和大模型生成回答。
加分点:补充每个步骤的核心工具(如文本分割用LangChain的RecursiveCharacterTextSplitter,向量数据库用Milvus),体现实操能力。
避坑提示:不要遗漏“离线阶段”,很多求职者只说在线的3步,忽略知识库构建,扣分严重。
问题3:RAG和大模型微调(Fine-tuning)的区别是什么?(高频)
标准答案:核心区别在“知识存储位置”和“落地成本”,用表格对比更清晰(面试时可直接口述,无需画图):
•RAG:知识存储在“外部知识库(向量数据库)”,无需修改大模型参数,成本低、更新快(修改知识库即可),适合知识频繁更新的场景;
•微调:知识“融入大模型参数”,需要大量标注数据和计算资源,成本高、更新慢(需重新微调),适合知识固定、需要深度适配的场景。
加分点:补充一句——实际落地中,常采用“RAG+微调”结合的方式:用RAG处理高频更新的知识,用微调优化大模型的回答风格和准确性。
避坑提示:不要说“RAG比微调好”,两者没有优劣,要结合场景判断,否则会显得思维片面。
问题4:向量数据库在RAG中的作用是什么?常用的向量数据库有哪些?(高频)
标准答案:核心作用是“高效存储文本向量”和“快速相似性检索”——将文本片段转换成向量后,存入向量数据库,用户提问时,能快速检索出和问题最相关的Top N个片段,为大模型生成回答提供依据。常用向量数据库:
•开源:Milvus(最常用,支持大规模向量,适合企业级场景)、Chroma(轻量,适合开发测试)、FAISS(Facebook开源,适合小规模向量);
•云服务:Pinecone(易用,无需部署)、AWS OpenSearch Service(结合搜索功能)。
加分点:补充——向量数据库的核心是“相似性度量”,常用的度量方式有欧氏距离、余弦相似度(最常用,衡量语义相似性)。
避坑提示:不要只说数据库名称,一定要补充各自的适用场景,体现你对工具的了解。
进阶类(中高级岗高频,大厂重点)
问题5:RAG的检索效果如何优化?(大厂高频,必考)
标准答案:核心从“检索前、检索中、检索后”三个维度优化,每个维度说1-2个具体方法,避免空泛:
1.检索前优化:优化文本分割(按语义分割,避免拆分完整句子)、选择合适的Embedding模型(中文场景用m3e-base,英文用text-embedding-ada-002);
2.检索中优化:调整检索参数(如Top N的数量,一般取3-5个,过多会增加冗余,过少会遗漏关键信息)、采用混合检索(向量检索+关键词检索,兼顾语义和精确匹配);
3.检索后优化:对检索到的片段进行重排序(按相关性得分排序)、过滤冗余/无关片段,提升大模型生成回答的准确性。
加分点:补充具体的优化工具或方法,比如用“BM25算法”做关键词检索,和向量检索结合;用LangChain的Retriever组件实现重排序。
避坑提示:不要只说“优化Embedding模型”,要从全流程给出具体方法,体现系统思维。
问题6:文本分割的核心原则是什么?常用的分割方式有哪些?(高频)
标准答案:核心原则是“语义连贯、不拆分完整语义单元”——分割后的片段要能独立表达一个完整的意思,避免出现“断章取义”,同时片段长度要适配Embedding模型的输入限制(一般200-500字符)。
常用分割方式:
•按字符长度分割(最基础):固定每段的字符数,设置重叠部分(如每段300字符,重叠50字符),避免拆分完整句子;
•按语义分割(最优):按段落、句子分割,结合标点符号(如句号、分号),确保片段语义完整(常用LangChain的RecursiveCharacterTextSplitter);
•按文档结构分割:针对PDF、Word等有结构的文档,按标题、章节分割,保留文档的层级关系。
加分点:补充——分割时要考虑“检索精度”和“检索效率”,片段过短会导致语义不完整,过长会增加检索耗时。
问题7:Embedding模型的作用是什么?如何选择合适的Embedding模型?(高频)
标准答案:Embedding模型的核心作用是“将文本(文本片段、用户问题)转换成向量”,让计算机能理解文本的语义,从而实现相似性检索——向量之间的相似度越高,对应的文本语义越相近。
选择原则(结合场景):
•语言场景:中文场景优先选m3e-base、ernie-3.0-base(百度),英文场景优先选text-embedding-ada-002、Sentence-BERT;
•部署场景:本地部署优先选轻量级模型(如m3e-small),云部署可选择性能更强的模型(如text-embedding-ada-002);
•精度需求:高精度场景(如医疗、法律)选大尺寸向量模型(如text-embedding-ada-002,1536维),普通场景选小尺寸向量模型(如m3e-base,768维)。
问题8:RAG中常见的**“幻觉”**问题如何解决?(大厂高频)
标准答案:RAG的幻觉主要分为“检索幻觉”(检索到无关片段)和“生成幻觉”(大模型基于无关片段生成错误回答),解决方法从3个层面入手:
•检索层面:优化检索效果(如混合检索、重排序),过滤无关片段,确保检索到的片段和用户问题高度相关;
•提示词层面:优化Prompt,明确要求大模型“只基于检索到的片段生成回答,没有相关信息时直接说明‘未找到相关内容’”;
•后处理层面:对大模型的回答进行校验,对比检索到的片段,删除和片段无关的内容,确保回答可溯源。
实战落地类(大厂重点,区分普通求职者和资深者)
问题9:如何用LangChain实现一个简单的RAG系统?(必考,实操类)
标准答案:分5步实现,结合LangChain的核心组件,清晰说明每一步的作用(面试时可简述,无需写完整代码,若面试官要求可补充关键代码):
1.文档加载:用LangChain的FileLoader(如TextLoader、PyPDFLoader)加载文档,读取文本内容;
2.文本分割:用RecursiveCharacterTextSplitter将文档拆分成语义片段;
3.Embedding转换:用HuggingFaceEmbeddings(加载m3e-base模型)或OpenAIEmbeddings,将片段转换成向量;
4.向量存储:将向量存入Chroma(轻量,适合测试)或Milvus,构建知识库;
5.检索生成:用Retriever从向量数据库中检索相关片段,结合ChatOpenAI/GPT4All等大模型,生成回答。
加分点:补充关键代码片段(如文本分割、检索生成的核心代码),体现实操能力;说明如何优化检索效果(如调整分割参数、混合检索)。
问题10:RAG在高并发场景下如何优化性能?(大厂高频)
标准答案:核心从“检索性能、模型性能、缓存优化”三个维度优化,结合实际落地场景:
•检索性能:向量数据库优化(如Milvus的分区索引、向量量化),减少检索耗时;限制Top N的数量(3-5个即可);
•模型性能:大模型采用异步调用,避免阻塞;使用轻量级大模型(如LLaMA 2-7B)本地部署,减少网络请求耗时;
•缓存优化:用Redis缓存高频问题的检索结果和大模型回答,避免重复检索和重复调用大模型;
•批量处理:对多个用户的相似问题,进行批量检索和批量生成,提升效率。
问题11:RAG的知识库如何维护和更新?(落地类高频)
标准答案:核心是“增量更新+定期优化”,避免知识库过期或冗余:
•增量更新:新增文档时,无需重新构建整个知识库,只对新增文档进行分割、Embedding转换,批量插入向量数据库;
•定期优化:定期删除过期、冗余的文档片段;重新评估Embedding模型和分割参数,优化检索效果;
•版本管理:对知识库进行版本控制,记录每次更新的内容,便于回滚(如出现检索错误时,回滚到上一版本)。
拓展类(加分项,提升竞争力)
问题12:什么是增强型RAG(Enhanced RAG)?有哪些常见的增强方式?
标准答案:增强型RAG是在基础RAG的基础上,通过各种技术提升检索精度和生成质量,常见增强方式有3种:
•查询增强(Query Enhancement):对用户问题进行改写、扩写,生成多个相似查询,提升检索的全面性;
•检索增强:采用多阶段检索(如先粗检索、再精检索),结合关键词检索和向量检索,提升检索精度;
•生成增强:优化Prompt工程,让大模型更好地结合检索片段生成回答;加入知识图谱,补充结构化知识,提升回答的准确性。
问题13:RAG在中文场景下有哪些特殊的优化点?
标准答案:中文场景的核心优化点的是“语义理解和文本处理”,主要有3点:
•Embedding模型选择:优先选用中文优化的模型(如m3e-base、ernie-3.0-base),避免用英文模型导致语义理解偏差;
•文本分割优化:结合中文的语义特点,按逗号、句号、顿号分割,避免拆分完整的词语或短语(如“人工智能”不能拆分成“人工”和“智能”);
•关键词优化:中文存在多音字、同义词,可加入同义词词典,优化检索的准确性(如“手机”和“移动电话”视为同一语义)。
问题14:RAG的局限性有哪些?如何解决?
标准答案:RAG的核心局限性的是“依赖检索质量”和“无法处理复杂逻辑推理”,解决方法对应如下:
•局限性1:检索质量决定回答质量,若检索不到相关片段,大模型无法生成准确回答 → 解决:优化检索策略(混合检索、多阶段检索),完善知识库;
•局限性2:无法处理复杂的逻辑推理(如数学计算、多步骤推理) → 解决:结合思维链(CoT)Prompt,让大模型分步推理;结合微调,优化大模型的推理能力;
•局限性3:知识库维护成本高,尤其是知识频繁更新的场景 → 解决:实现自动化更新(如对接企业内部文档系统,自动同步新增文档)。
三、面试避坑指南(必看,避免扣分)
很多求职者知识点掌握扎实,但因踩坑导致扣分,重点规避以下5个误区(结合大厂面试经验总结):
1.误区1:只记概念,不懂实操 → 面试时,被追问“如何用LangChain实现RAG”“如何优化检索效果”时答不上来,直接扣分;建议提前熟悉核心工具的使用(LangChain、Milvus);
2.误区2:混淆RAG和微调的区别 → 不要说“RAG可以替代微调”,两者是互补关系,结合场景选择,体现思维的全面性;
3.误区3:对向量数据库只知其名,不知其用 → 不要只罗列向量数据库的名称,一定要补充各自的适用场景和核心优势;
4.误区4:忽略RAG的落地细节 → 被追问“高并发场景如何优化”“知识库如何维护”时,无法给出具体方案,体现不出落地思维;
5.误区5:回答过于冗长,没有重点 → 面试时,每个问题的回答控制在1-2分钟,先讲标准答案,再补充加分点,避免废话。
四、总结(面试快速复盘重点)
RAG面试的核心考察逻辑是“基础认知+实操能力+落地思维”——无需深入研究复杂的算法原理,重点掌握“是什么、怎么工作、怎么落地、怎么优化”,就能应对80%以上的面试问题。
2026年RAG的面试趋势是“侧重实操和落地”,面试官不再只考察概念记忆,更看重你能否结合工具(LangChain、Milvus)实现RAG系统,能否解决实际落地中的问题(如检索优化、高并发、幻觉)。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
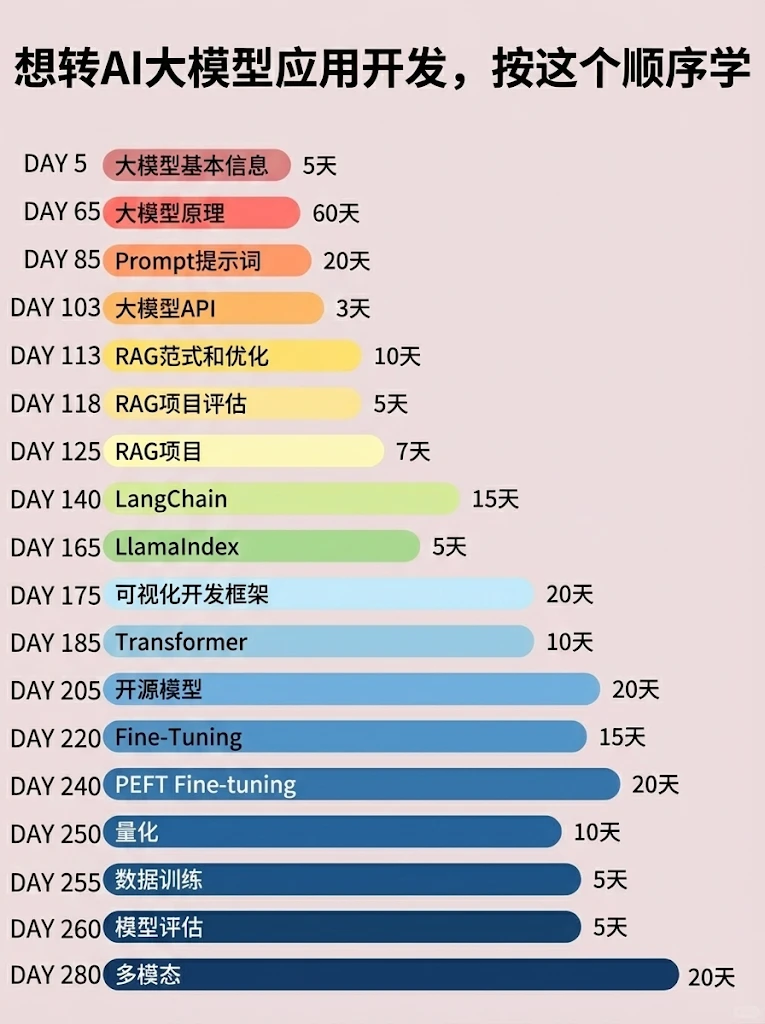
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

 803


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


