


一位企业 CTO 的私有化项目:老板在 AI 大会上听完拍板,买八台 GPU 服务器,“数据就不用出去了”。三个月后机器到货、模型跑通,项目群里最热的话题却变成了:电费走哪个部门预算?模型月更谁来升级?利用率不到三成,CFO 开始追问 ROI。
这不是个例。多数预算表里,私有化部署的成本只有一行:GPU 服务器 × N。这一行,恰恰是整个项目里最便宜的部分。
就像买车:裸车价只是入场券,养车才是大头。私有化的真实账单分三层——算力、模型、运维。
一、算力:你买的算力,七成在睡觉
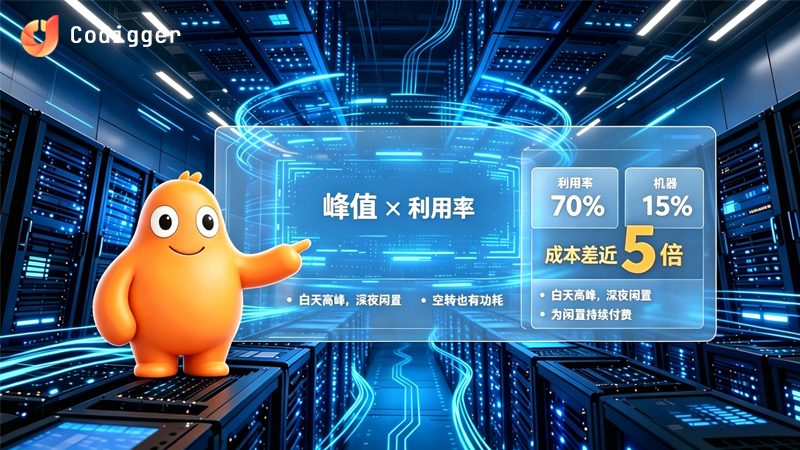
成本公式的分母不是峰值算力,是“峰值 × 利用率”。推理负载天然不均:白天高峰、深夜闲置;即便 7×24 对外服务的集群,GPU 有效利用率通常也只有六七成,企业内部应用更低。利用率 70% 和 15% 的机器,每百万 token 综合成本能差近 5 倍——你为峰值买单,却一直在为闲置付费。
再算电费:500W 级设备 7×24 跑一年,电费数千元起;而且模型常驻显存,没有请求也有约三成功耗烧在“等”上。加上 3 年折旧——新一代卡的能效比每年抬升,手里的算力既是资产,也是不断缩水的成本中心。
还有一笔反直觉的账:我们按公开规格与社区实测做过测算——消费级 AI 主机跑 72B 级开源模型(4bit 量化)、7×24 高利用率运行,每百万 token 综合成本约为旗舰云端 API 的 1/8,折旧完成后不足百分之一;但把 400B+ 旗舰搬进双机私有集群,账本反转——成本反而是同级云端 API 的数倍。私有化的成本甜区在“主力开源模型 + 高利用率”,不是越大越好。
二、模型:机器是你的,模型不是
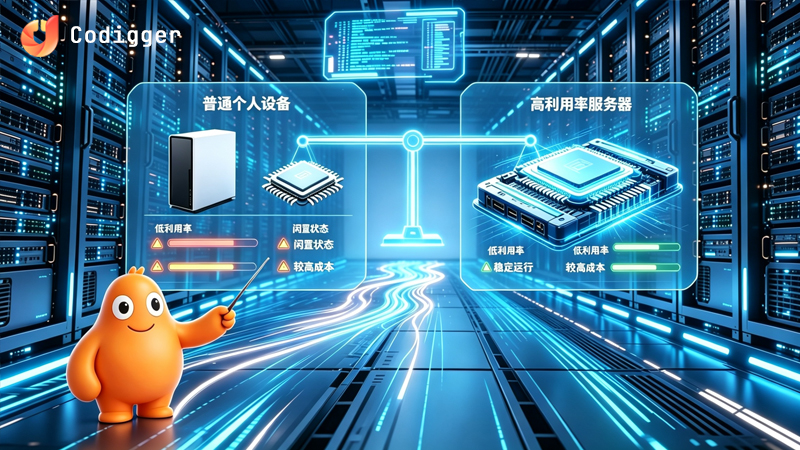
选型错配最坑:32B 模型跑在低利用率的个人级设备上,每百万 token 成本可能高于 72B 模型的高利用率服务器——模型大小是变量,利用率才是杠杆。
量化还有隐形税:旗舰压到 3-4bit,能力折损后“私有化的旗舰”未必打得过云端满血中杯。更麻烦的是迭代锁定:硬件折旧 3 年,开源模型月更,每次升级都是评测+回归+调优的工程。云厂商的 prefix caching 已把重复前缀的输入成本打到几十分之一,私有化默认拿不到。微调数据、评测集、安全护栏,也都是预算表外的项目。
三、运维:7×24 不是形容词,是排班表
谁盯着显存溢出?能独立处理 GPU 服务器故障的工程师,从来不止一个 headcount 的事。驱动、CUDA、推理框架、量化方案四层依赖互相咬合,每次升级都是小型发布工程。业务涨了,采购以月计;业务缩了,机器照常折旧——私有化的供给弹性天然为负。断电恢复、模型文件校验、接口越权防护,都是上线后才还的债。
四、通行做法:混合路由
成熟团队早已不二选一,而是分层:高频低敏任务 → 本地小模型(成本低、数据不出门);复杂推理 → 云端旗舰 API(满血能力、峰值弹性);强敏感任务 → 私有化模型。工程化载体是多模型统一路由网关:按任务特征、成本预算、数据级别自动调度,失败自动降级。再进一步,让闲置算力进入算力共享市场流通——持有成本变成可回血的资产。
五、把清单变成架构
Codigger 的实践踩过这张清单的每一项,最后收敛成一句话:让算力跟着成本走,而不是让业务跟着硬件走。在 Codigger 体系里,开发环境与算力解耦:本地 AI 电脑提供数据不出本机的推理,旗舰能力由模型路由调度云端,夜间闲置算力可进算力与模型交易市场流通,按 Token 付费让成本随用量浮动。私有化的定位由此清晰:它是数据主权的技术手段,不是一次性买断的财务动作。
回到那位 CTO。重做的预算表多了三列:预期利用率、模型年迭代工时、单位推理成本。签字前的问题从“服务器几时到货”变成了“我们的推理流量画像长什么样”。
私有化部署是算术题,不是表态题。买台 GPU 服务器只写完第一行——算力、模型、运维三张清单都算平,数字才会替你做决定。


 扫一扫


 231

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


