


一只蜂鸟体重不过几克,翅膀振动频率高到肉眼难辨,却能悬停在空中整日穿梭于千百朵花丛之间。Colibrì 这个项目名取自意大利语里的"蜂鸟",背后藏着开发者一个近乎偏执的执念:用消费级PC上那点可怜的资源,驮起一头7440亿参数的巨兽。
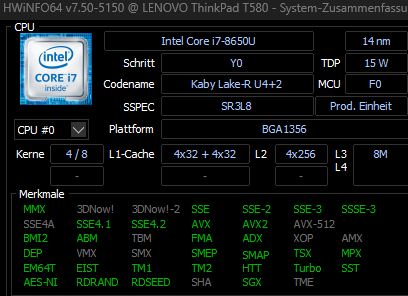
在大多数人眼里,运行 GLM-5.2 这种级别的模型需要整排的服务机柜、成吨的显存和动辄百万的硬件预算。Colibrì 却偏不。它只需要一台装着25GB内存的普通电脑,一块容量够大的NVMe固态硬盘,再加上一颗不愿向硬件妥协的心。整个引擎塞进一个约2400行的C文件,零依赖,零Python运行时,甚至不需要GPU——当然,如果你手头有张显卡,它也能笑着接纳。
把内存、显存和磁盘当成同一块蛋糕
传统的大模型推理框架往往把VRAM、RAM和磁盘看作三个老死不相往来的世界。模型太大装不进显存?要么量化到面目全非,要么切片切到支离破碎。Colibrì 的做法干脆得多:它把这三层存储视为一个统一的整体,让数据像水一样自然流动。
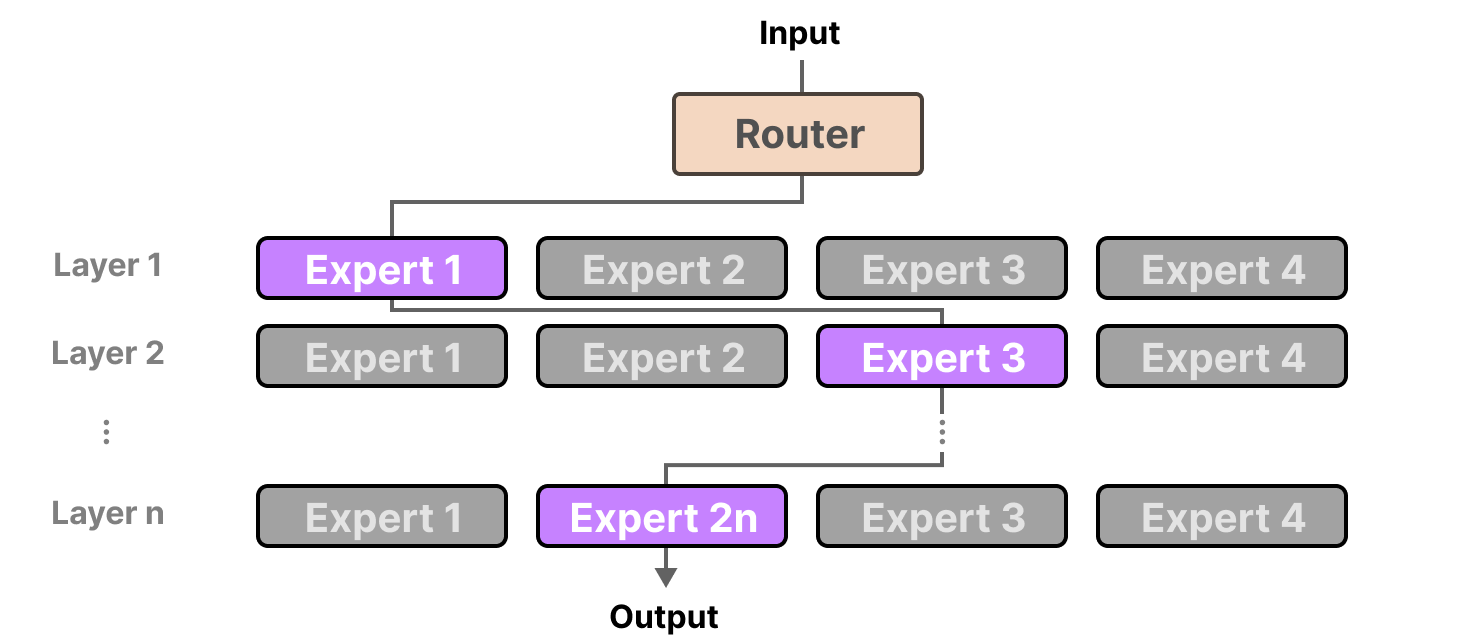
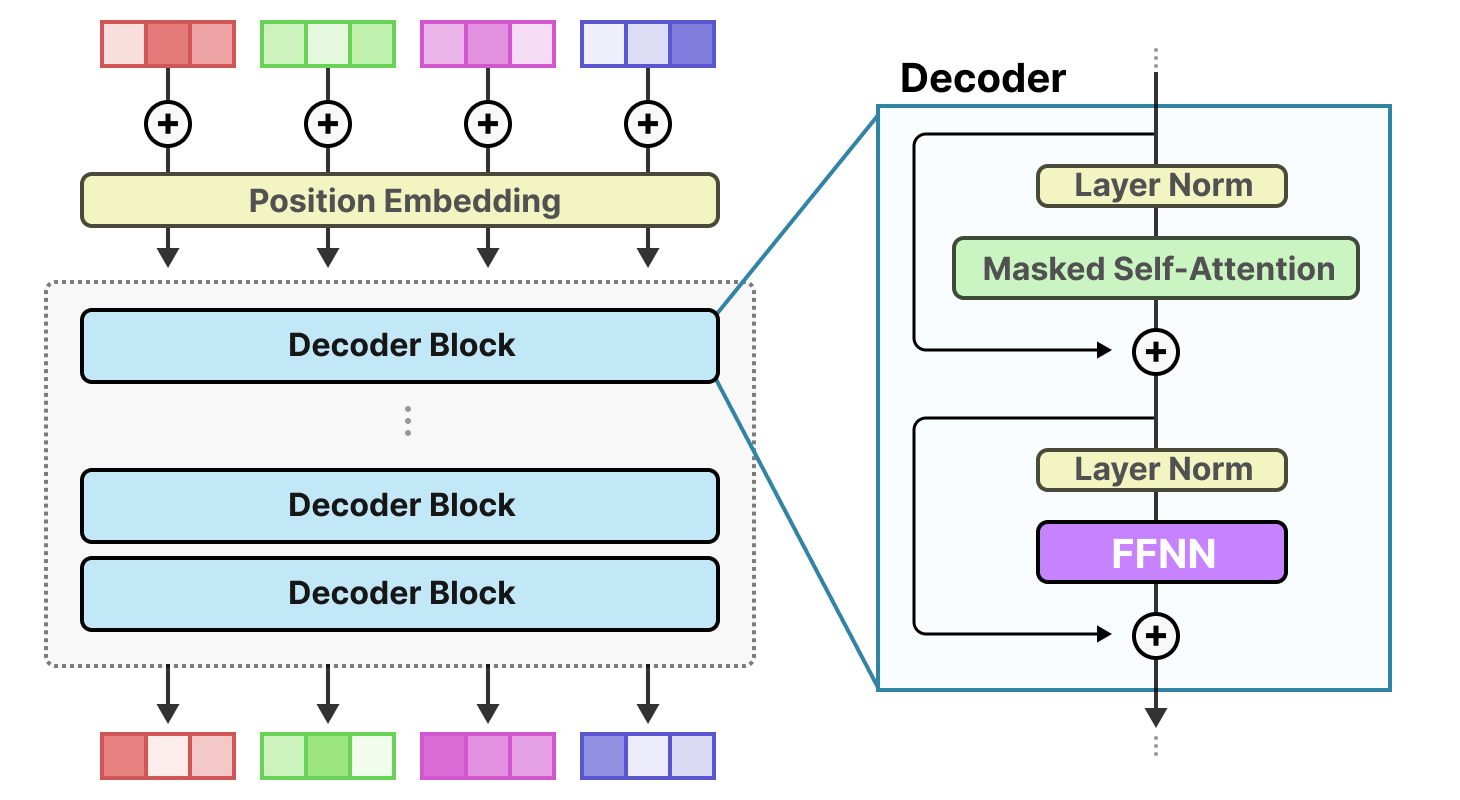
GLM-5.2 是个典型的MoE架构,7440亿参数听起来吓人,但每个token实际激活的只有约400亿参数。更妙的是,真正随输入变化的那部分——也就是路由专家——大约只占11GB。Colibrì 把这11GB的"可变部分"留在磁盘上,按需流式读取;而注意力机制、共享专家、嵌入层这些"固定班底"约170亿参数,以int4精度常驻内存,吃掉不到10GB空间。剩下的,交给操作系统页面缓存和每层独立的LRU策略去操心。
这种设计意味着你的磁盘不再是冷板凳,而是整个推理流水线的一级缓存。21504个路由专家平摊在75层里,每个专家int4量化后约19MB,总量约370GB。每次推理时,引擎像翻阅图书馆的索引卡一样,精准调取当前需要的几本"书",而不是把整个图书馆搬进客厅。
冷启动与热缓存的辩证法
第一次运行总是最慢的。冷启动状态下,每生成一个token大约要从磁盘读取11GB数据。如果你的NVMe顺序读写能到1GB/s,那大概每秒能挤出0.05到0.1个token——这速度确实谈不上快,但别忘了,这是一台7440亿参数的前沿模型在价格还不如H100一块风扇的电脑上正确运行。
真正让 Colibrì 越用越快的是它的学习缓存机制。引擎会默默记录你实际调用了哪些专家,生成一份.coli_usage画像。下次启动时,最热门的专家会被自动锁定在空闲内存里。社区实测数据很有意思:一台128GB内存的Ryzen AI 9笔记本,经过几轮对话后专家命中率从28%爬到66%,token生成速度从0.29 tok/s跃升至0.37 tok/s。而在一台配备了430GB内存的EPYC服务器上,命中率更是飙到98%,磁盘等待时间几乎被消灭,速度稳定在1.00 tok/s。
更激进的是"热钉"(PIN)策略。你可以把历史使用数据喂给引擎,让它把最活跃的专家批量钉在内存里。一台256GB内存的主机若拿出77GB做热钉,再配合MTP推测解码,体验会完全不同。
推测解码:让模型自己给自己打草稿
Colibrì 对GLM-5.2原生MTP头的支持堪称精妙。多token预测头会在主模型验证之前先生成草稿,一次批量前向传播就能消化掉多个候选token。这里有个关键细节:MTP头必须是int8精度。如果误用了int4,草稿接受率会直接跌到0%,推测机制形同虚设;而int8版本在社区环境里能维持39%到59%的接受率,每次前向传播平均处理2.2到2.8个token。
语法强制草稿则是另一个让人眼前一亮的巧思。当你需要模型输出严格的JSON、NDJSON或函数调用时,GBNF语法规则本身就成了第三个草稿源。只要语法只允许一个合法字节,这个强制跨度就会被直接注入验证批次,接受率接近1.0。它不会限制采样自由——错误的语法草稿会在验证阶段被自然拒绝,最坏的情况不过是回退到正常生成。
纯C语言的浪漫与偏执
在这个Python和CUDA主导的时代,Colibrì 选择用纯C语言手写整个推理内核,本身就是一种宣言。没有BLAS库绑架你的矩阵乘法,没有Python GIL拖慢你的线程调度,没有PyTorch的抽象层在你和硬件之间添油加醋。
量化内核全是手写的:int8、打包int4、打包int2,逐行缩放,AVX2指令集优化。MLA注意力机制实现了权重吸收技巧,解码时不需要逐token重构键值。DSA稀疏注意力忠实还原了GLM-5.2的闪电索引器,每层只保留2048个因果键,把KV缓存压缩到576个浮点数每token,相比原始需求缩小了57倍。
异步预读、内存安全预算、崩溃安全的KV缓存持久化——这些工程细节堆叠起来,让 Colibrì 不像一个仓促的玩具,而像一把精心打磨的瑞士军刀。它甚至能在你关闭聊天窗口后,把压缩的MLA KV状态增量追加到磁盘,下次打开时对话上下文毫发无损。
从WSL2到Apple Silicon的跨界之旅
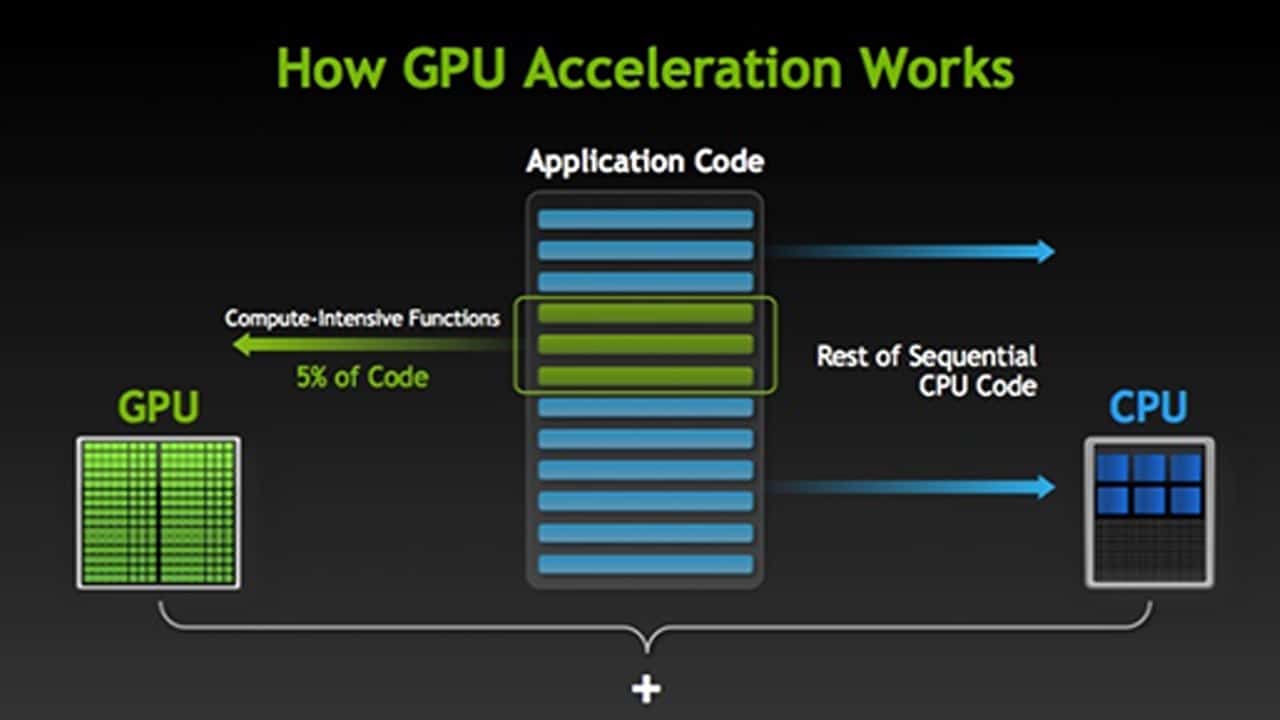
Colibrì 的野心不止于Linux。Windows 11原生支持通过MinGW-w64编译运行,作者甚至为Windows写了一套兼容层,把POSIX I/O映射到Windows API。NVIDIA GPU支持以运行时DLL方式加载,主机永不直接链接CUDA运行时——DLL不存在就优雅回退CPU路径,绝不报错退出。
Apple Silicon用户也有专属待遇。Metal后端在M4 Max上测得0.42 tok/s,比纯CPU路径的0.30 tok/s快了约40%。虽然绝对数值不算惊艳,但别忘了这是在统一内存架构上运行7440亿参数模型。所有运算批处理到每层的少量命令缓冲区,磁盘读取和GPU计算尽可能重叠,设计思路透着浓浓的Apple式精致。
社区里最快的数据点来自M5 Max:Metal后端开启、46.9GB热钉、1024token上下文,持续输出2.06 tok/s,专家命中率72.5%。而在x86阵营,一颗Ryzen 9 9950X3D配合PCIe 5.0 NVMe和avx512-vnni指令集,在关闭MTP的情况下跑到了1.23 tok/s,这是目前非苹果平台的最优成绩。
它适合谁?
Colibrì 不是给追求每秒百token的商用场景准备的。它的舞台属于那些想在本地彻底掌控模型的极客、研究者和小团队。不需要云端API的隐私焦虑,不需要订阅费用的持续失血,更不需要为了跑一个7440亿参数模型去贷款买服务器。
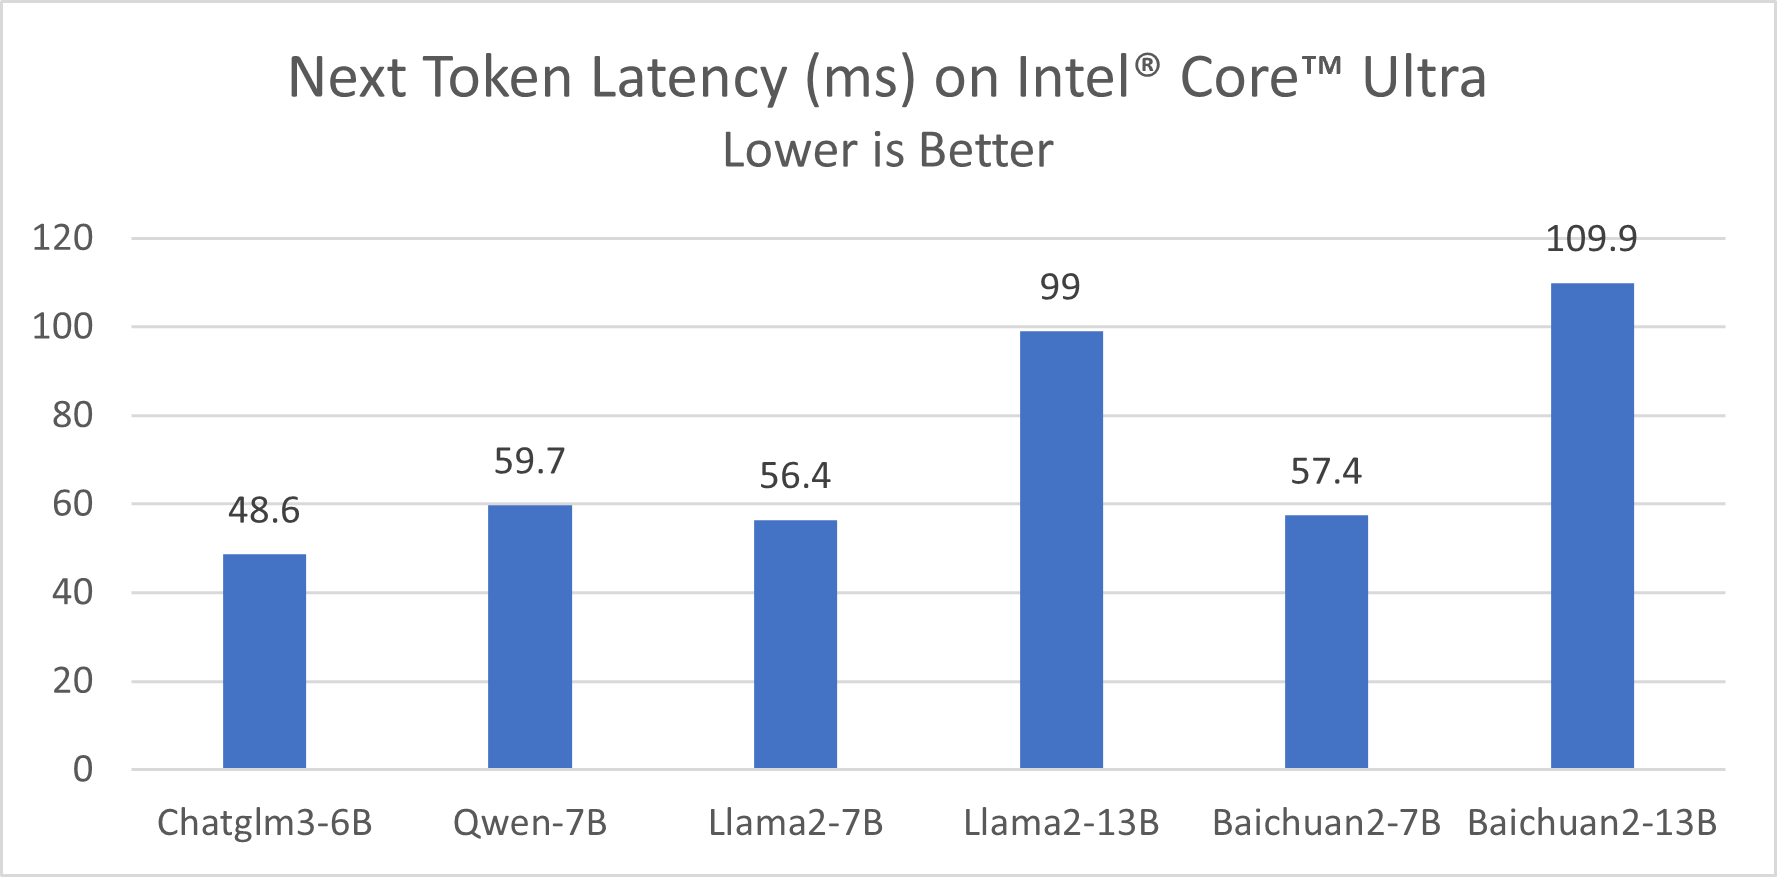
如果你有一台32GB内存、PCIe 4.0 NVMe的电脑,大概能体验到0.5到1 tok/s的交互速度;若是64GB内存配上RAID0双盘,2到4 tok/s并非奢望。128GB以上内存配合热钉策略,模型的大部分"肌肉记忆"都会被锁在RAM里,磁盘只负责偶尔唤醒几个冷门专家。
这台引擎最动人的地方在于诚实。它不会偷偷降低模型精度来粉饰速度,不会在后台篡改路由语义来假装流畅。快就是快,慢就是慢,每个吐出的token都是正经argmax的结果。就像那只悬停在花前的蜂鸟,翅膀扇得再快,每一口花蜜都吃得实实在在。
开发者在一台12核、25GB内存、老旧NVMe的笔记本上写出了这一切。他留下的话很朴素:更好的测试硬件能直接转化为更快的引擎,而每一个数据点、每一块磁盘,都会把上限往上抬一寸。Colibrì 证明了一件事——巨兽未必需要巨笼,有时候,一只蜂鸟的翅膀就够了。


 扫一扫


 380


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


