



26年9月来自湾区创业公司Figure AI的博客新闻“Helix 2.5: Zero-Shot 30-Home Generalization”:https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization。
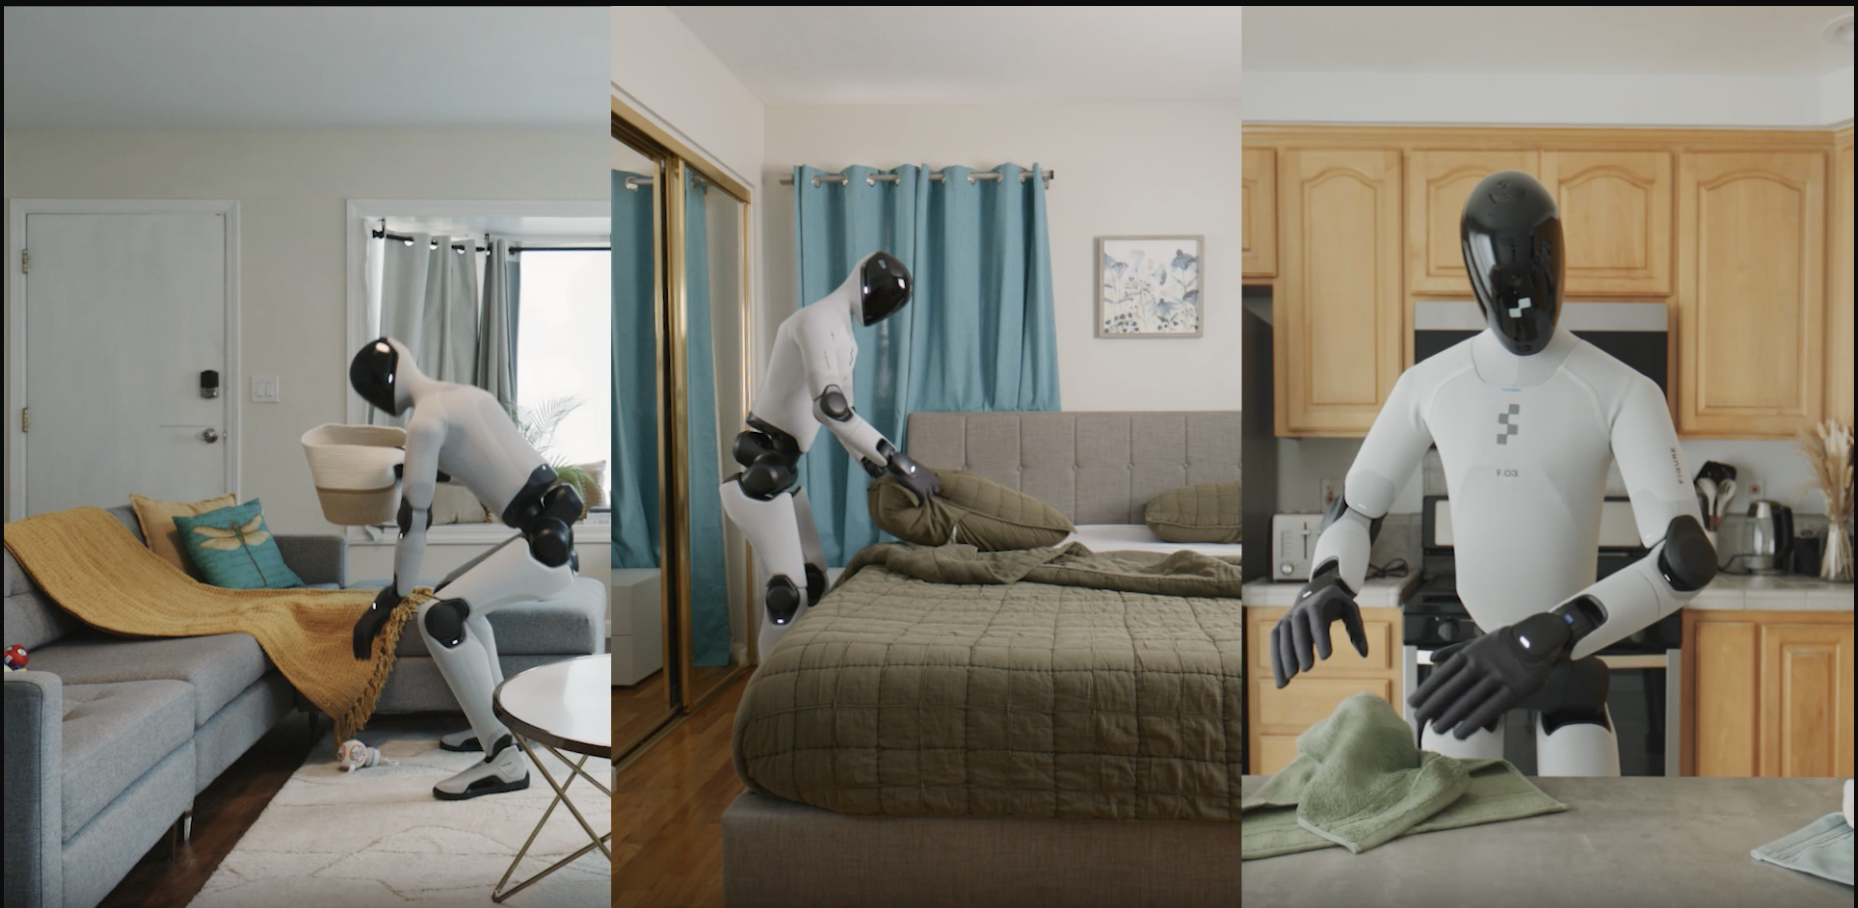
这篇博客的核心进展是:Helix 2.5 能把从人类行为中学到的能力,迁移到陌生家庭,在无需现场训练的情况下完成部分家务。 重点在于跨环境泛化能力。以下是 Figure 官方披露的关键内容。
- 测试覆盖 30 个陌生家庭、三类任务
任务包括收拾客厅玩具、折叠毛巾、整理床铺,要求机器人协调行走、感知、双手操作和全身控制。 - 最关键的数据:成功率从 9% 提升到 56%
在架构、任务训练数据和评估条件一致时,使用人类行为数据集 Index 预训练,完整任务成功率提升超过 6 倍。需要人工安全干预的试验计为失败。 - “零样本”有明确边界
它指的是未见过的家庭和物品;三种任务本身仍通过其他地点采集的数据微调得到。一个基础模型分别适配三种行为,并非未经任务训练就能做任意家务。 - 数据效率与扩展性
在文中选取的同任务对比中,Helix 2.5 用一半适配数据达到旧版成功率,并泛化到陌生家庭。增加 Index 数据也能可预测地降低机器人动作预测误差,但这不等于实际任务成功率会同比增长。
详细评估标准
在盲测评估期间,针对所有三项任务,每次试验(trial)都采用评估流程中规定的独特初始配置。在这些配置中,环境内的所有物体均以任意且自然的方式进行摆放和定向。为确保公平比较,所有被评估的策略均适用相同的试验重置条件。
以下是提供给所有操作员的详细评估准则:
玩具(Toy):评估员记录以下指标
拾取并放入篮筐的玩具数量
每个玩具的尝试次数
每个玩具限时 1 分钟。若超过此时间,则终止该次操作流程(rollout)。
毛巾(Towel):评估员针对每条毛巾判定“通过”或“失败”,并对所有已折叠的毛巾进行评分。
通过:毛巾被拾取、折叠并成功放入篮筐。
A:毛巾的 4 个角几乎重合(间距在 1 英寸以内),折叠整洁。
B:仅有 2 个角在 1 英寸间距范围内。
C:没有任何角在 1 英寸间距范围内,折叠杂乱。
失败:无法完整完成任务。无法成功抓取、折叠或放入篮筐。
若毛巾已折叠但放入篮筐失败,则该毛巾被标记为“失败”,但折叠质量仍按上述准则评分。
每条毛巾限时 3 分钟。若超过此时间,则该毛巾被标记为“失败”。
床铺(Bed):评估员针对每个枕头和被子判定“通过”或“失败”,并对所有经过整理的寝具进行评分。
枕头标准
通过:枕头被拾取并放置在床铺的上 1/3 区域。
良好:枕头水平放置且对齐(顺时针/逆时针方向偏差 <15 度)。
较差:枕头水平放置,顺时针/逆时针方向偏差 <45 度。
失败:枕头未被拾取,或未放置在床铺的上 1/3 区域。
被子标准
通过:被子两侧被拾取,且两个角均到达床铺的上 1/3 区域。
良好:两角相互对齐(间距 <6 英寸)且相对平整。
较差:两角间距为 6-12 英寸,略显平整。
失败:无法完成任务。至少有一侧的被子未被提起,或未到达床铺上部的三分之一处。
每个枕头和被子的每一侧都有 1 分钟的超时限制。若超过此时间,展开操作将终止并被标记为失败。
若出于安全考虑需要人工干预,该展开操作将终止并被标记为失败。
Index 分类
通过两种方式对 Index 中的任务进行表征:一是针对每个片段生成视频嵌入(video embeddings),二是利用视觉-语言模型生成针对各片段的活动与物体描述并提取文本嵌入(text embeddings)。随后,我们将这些内容聚类为语义群组的嵌套层级结构,并分析任意数据集或训练快照中的时长在这些群组中的分布情况。
总结:它支持“大规模人类经验预训练能改善机器人泛化”这条技术路线;但 56% 的成功率、三类任务和企业自报评估,还不足以证明通用家务机器人已经成熟。


 扫一扫


 470

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


