


 本文探讨了PyTorch 1.6中如何利用torch.cuda.amp模块进行自动混合精度(AMP)训练,包括FP16与FP32的混合原理,为何使用AMP、FP16的优缺点以及如何通过动态损失放大和GradScaler解决NAN问题。重点介绍了autocast和GradScaler的使用方法,以及如何在实际项目中提升训练效率和精度.
相关问题:解决pytorch半精度amp训练nan问题 - 知乎
pytorch模型训练之fp16、apm、多GPU模型、梯度检查点(gradient checkpointing)显存优化等 - 知乎
pytorch从1.6版本开始,已经内置了torch.cuda.amp,采用自动混合精度训练就不需要加载第三方NVIDIA的apex库了。AMP -- (automatic mixed-precision training)
一 什么是自动混合精度训练(AMP)
默认情况下,大多数深度学习框架都采用32位浮点算法进行训练。2017年,NVIDIA研究了一种用于混合精度训练的方法,该方法在训练网络时将单精度(FP32)与半精度(FP16)结合在一起,并使用相同的超参数实现了与FP32几乎相同的精度。
1.1、FP16理论基础:
在介绍AMP之前,先来理解下FP16与FP32,FP16也即半精度是一种计算机使用的二进制浮点数据类型,使用2字节存储。而FLOAT就是FP32。
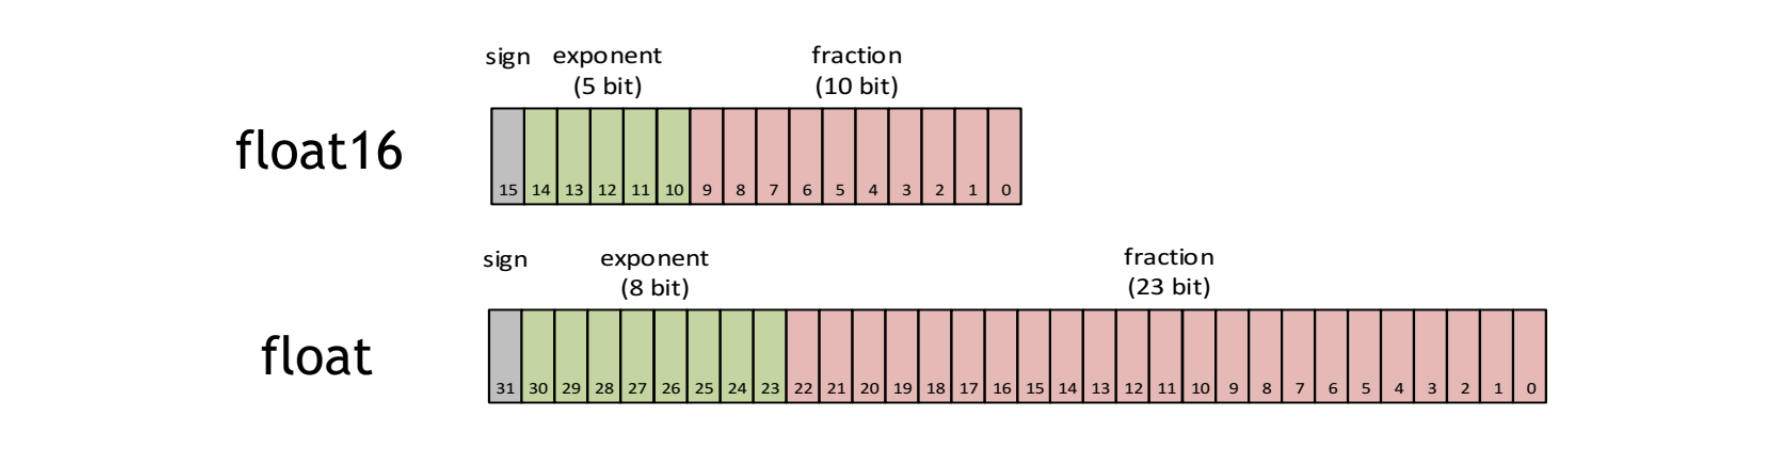
在上图可以看到,与单精度float(32bit,4个字节)相比,半进度float16仅有16bit,2个字节组成。天然的存储空间是float的一半。 其中,float16的组成分为了三个部分:
- 最高位表示符号位,sign 位表示正负
- 有5位表示exponent位, exponent 位表示指数
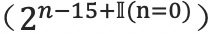
- 有10位表示fraction位, fraction 位表示的是分数

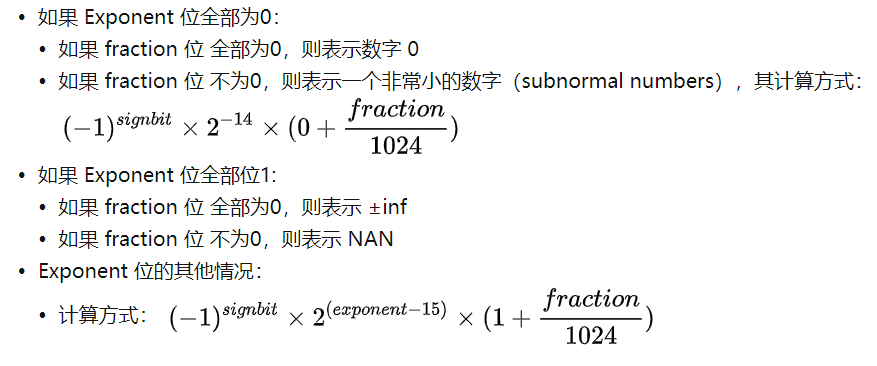
根据 wikipedia 上的介绍,我总结下float16的这几个位置的使用,以及如何从其bitmap计算出表示的数字:
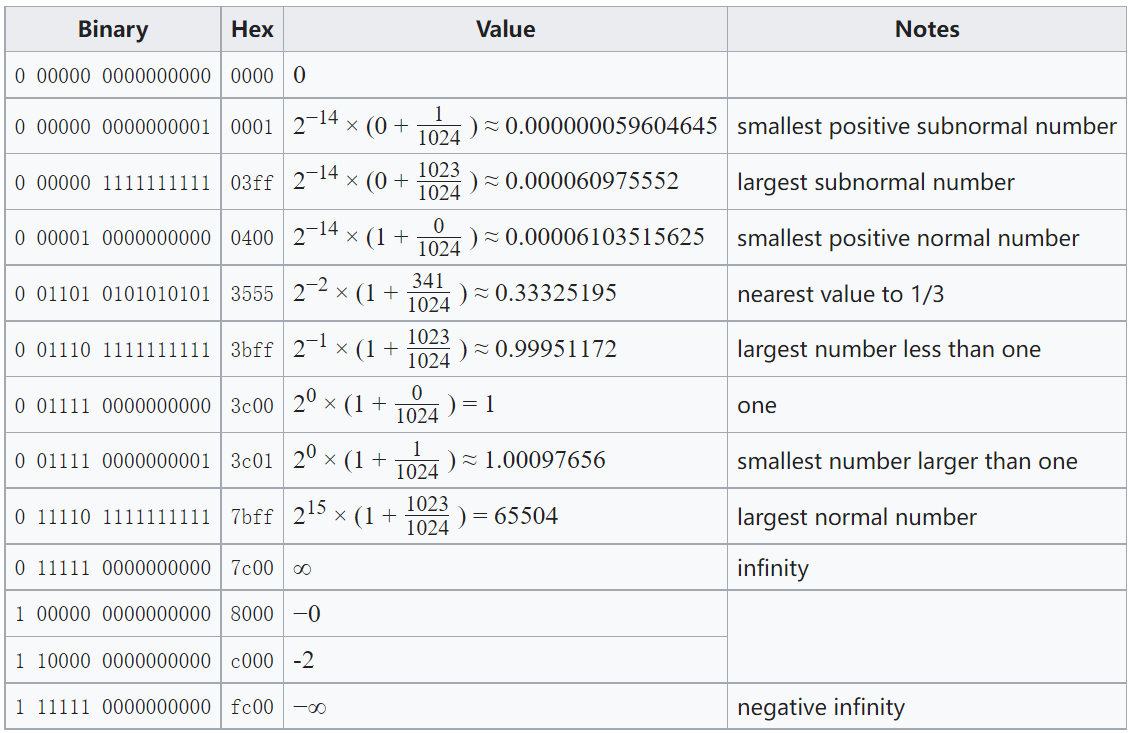
 结合上面的讲解,那么就可以顺利的理解下面的这些半精度例子:
总结:
FP16值动态区间
FP32值动态区间:
float16 最大范围是 [-65504,66504],float16 能表示的精度范围是 ,超过这个数值的数字会被直接置0;




 扫一扫


 4万+


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


