


【摘要】AI内容检测在技术上已然失效。教育体系应停止封堵,转向以课堂监督评估为核心的结构性重构,旨在培养学生熟练驾驭AI与独立思考的“双重胜任力”。
引言
技术浪潮从不以人的意志为转移。当生成式人工智能(Generative AI)渗透到社会生产的各个环节,教育领域正面临一场深刻的范式革命。前OpenAI研究员安德烈·卡帕西(Andrej Karpathy)近期提出的观点,并非仅仅是一种教育理念的探讨,更像是一份基于技术现实的架构重构方案。他主张停止监管学生使用AI完成课外作业,并彻底改革评估体系。这一论断的背后,是对当前AI技术本质、人机协同模式以及未来人才模型的深刻洞察。
传统的教育模式建立在信息稀缺与知识获取门槛高的前提下。教师是知识的主要传递者,作业与考试是检验学生知识掌握程度的核心手段。AI的出现,彻底颠覆了这一基础。它将知识的获取成本降至近乎为零,却对知识的应用、验证与创新能力提出了前所未有的要求。
因此,卡帕西的观点并非简单的“开闸放水”,而是对教育目标与实现路径的一次重新校准。本文将从AI内容检测的技术困境出发,深入剖析其提出的以“课堂评估”为核心的解决方案,解构“双重胜任力”这一未来人才模型的技术内涵,并探讨“AI原生学校”这一实践探索的架构与愿景。这不仅是对一场教育辩论的回应,更是对技术从业者如何看待AI与人类智力协同发展的一次深度思考。
💡 一、AI内容检测的技术困境与范式终结
在讨论任何教育对策之前,必须首先厘清一个基础的技术事实,即对AI生成内容的检测,在当前及可预见的未来,都是一条注定失败的路径。试图通过技术工具来区分人类作业与AI作业,无异于构建一座无法抵御潮汐的沙堡。这种困境源于技术原理、攻防博弈和实践成本三个层面。
1.1 原理性失效:概率模型的对抗本质
要理解检测的失效,需回归大型语言模型(LLM)的本质。LLM并非一个存储知识的数据库,而是一个基于海量数据训练的、极其复杂的概率分布模型。其核心任务是在给定上文(context)的条件下,预测下一个词元(token)出现的概率。它生成的每一句话,都是一次概率采样的结果。
AI内容检测工具的工作原理与此类似。它们同样基于模型,试图识别出文本中符合AI生成模式的“概率指纹”。常用的判断指标包括:
-
困惑度(Perplexity):衡量模型对一段文本的“意外”程度。通常认为,由AI生成的文本对其自身模型而言,困惑度较低,行文流畅但缺乏“惊喜”。
-
突发性(Burstiness):分析词汇选择和句子长度的波动性。人类写作通常表现出更高的突发性,而AI则倾向于更均匀、平滑的分布。
问题在于,这两种模型本质上是同源的。检测模型试图寻找的“AI痕迹”,生成模型可以轻易地通过调整参数或增加扰动来抹除。例如,通过提高采样过程中的温度(temperature)参数,LLM可以生成更具随机性、困惑度更高的文本,从而模拟人类的“意外感”。
这构成了一场生成模型与检测模型的底层对抗。只要生成技术在进步,它总能找到方法模拟出更不像“AI”的文本,使得任何基于固定模式的检测器从原理上就处于被动地位。
1.2 技术性规避:“反检测”的军备竞赛
即便抛开底层原理,从应用层面看,规避AI检测的技术手段也层出不穷,且门槛极低。这已经演变成一场不断升级的“军备竞赛”。
|
检测技术/指标 |
核心原理 |
常见规避手段 |
规避效果 |
|---|---|---|---|
|
困惑度分析 |
AI生成的文本对其自身模型来说通常更“顺畅”,困惑度低。 |
1. 指令注入:要求AI使用不常见的词汇或句式。 |
高。简单调整即可显著提高文本的复杂度与不可预测性。 |
|
突发性分析 |
AI文本的句子长度和词汇分布更均匀,缺乏人类写作的“波峰波谷”。 |
1. 人工干预:手动合并或拆分句子,刻意制造长短句。 |
高。极易通过简单的编辑操作打破AI的均匀分布模式。 |
|
模型指纹识别 |
某些模型在特定语料上可能留下微弱的、可识别的重复模式或偏好。 |
1. 模型迭代:生成模型更新速度远快于检测模型,旧指纹迅速失效。 |
极高。模型指纹的生命周期极短,依赖此方法的检测工具几乎没有实用价值。 |
这场竞赛的结局是注定的。攻击(规避)的成本远低于防御(检测)的成本。学生只需掌握简单的指令或使用现成的在线工具,就能让最先进的检测器失效。而教育机构若要跟上这场竞赛,则需要投入无尽的资源进行技术升级,这在现实中完全不可行。OpenAI自身在2023年就已下线其AI文本分类器,这本身就是对该技术路线前景的明确表态。
1.3 实践性困境:高昂的误判成本
技术上的不可行性,最终会传导至教育实践中,并带来毁灭性的后果,其中最严重的就是误判(False Positive)的代价。
当一个检测工具将学生独立完成的作业标记为“AI生成”时,会发生什么?
-
举证责任倒置:学生被迫需要“自证清白”,证明自己的思想是自己的。这在逻辑上和实践上都极其困难,甚至荒谬。
-
信任体系崩溃:师生关系从合作育人,异化为“警察与小偷”的对立关系。教师耗费大量精力在“鉴伪”上,而学生则将才智用于如何更“聪明”地使用工具而不被发现。
-
扼杀特定写作风格:一些学生,特别是逻辑思维强、表达严谨的学生,其写作风格可能天然地具有低困惑度和结构清晰的特点。检测工具可能对这些学生形成系统性的偏见和打击。
这种高昂的误判成本,使得任何一个负责任的教育机构都无法将AI检测结果作为惩戒学生的决定性证据。一个准确率无法达到99.99%以上的检测系统,在教育这种高风险场景下,几乎没有应用价值。而这个准确率,在技术上是无法达到的。
因此,卡帕西的结论是清晰且坚定的。继续在AI内容检测上投入精力,不仅是技术上的徒劳,更是对教育资源的巨大浪费和对师生关系的严重侵蚀。教育体系必须接受“课外作业无法有效监管”这一新常态,并将改革的焦点从徒劳的“封堵”转向体系的“重构”。
💡 二、从“封堵”到“疏导”:评估体系的结构性重构
承认AI检测失效,是教育变革的起点,而非终点。卡帕西提出的核心解决方案,是将教育的重心从防范技术滥用,转移到构建一个能够与AI共存、并能有效评估学生真实能力的全新框架。这个框架的核心,是评估场域的迁移与评估模式的重塑。
2.1 评估场域迁移:课堂监督的价值回归
既然无法保证课外环境的“纯净”,那么最直接的解决方案就是将决定学生成绩的关键评估环节,全部移回教师能够直接监督的课堂环境中。
这一转变意味着对“作业”和“考试”的传统角色进行重新划分。
-
课外作业(Homework):其角色从“评估工具”转变为“练习工具”和“探索工具”。学校应默认所有课外作业都可能在AI的辅助下完成。教师布置作业的目的,不再是检验学生是否独立解决了某个问题,而是引导他们学习如何利用AI作为强大的学习伙伴,去探索更复杂的问题、验证不同的思路、生成初步的草稿。作业的完成度可以作为过程性参考,但不应占据最终成绩的主要权重。
-
课堂评估(In-Class Assessment):这成为衡量学生真实能力的核心场域。在教师的监督下,学生需要独立或在规定条件下完成任务。这种评估能够最大程度地排除AI的直接代笔,确保结果的真实性和公平性。
这种场域迁移,本质上是从信任模糊的异步环境,回归到信任清晰的同步环境。它迫使学生明白,无论在课外借助AI学到了多少,最终都需要在没有“拐杖”的情况下,独立展示自己的知识和技能。这为学生的学习动机提供了清晰的导向。
2.2 评估模式的灵活性设计
将评估搬回课堂,并不意味着倒退回单一的闭卷考试模式。相反,卡帕西倡导一种高度灵活的“面对面评估”矩阵。教师可以根据课程目标和能力要求,设计不同的评估模式。
|
评估模式 |
工具使用权限 |
核心考察能力 |
适用场景举例 |
|---|---|---|---|
|
无工具模式(Closed-Book) |
禁止使用任何外部工具,包括计算器、网络和AI。 |
基础知识的记忆与理解、核心算法的手动实现、第一性原理的推导。 |
数学基础定理证明、编程语言语法考核、历史事件默写。 |
|
携带资料模式(Open-Book) |
允许携带指定的笔记、提纲或书籍,但禁止使用电子设备。 |
信息的快速检索与整合能力、知识的组织与应用能力、开卷环境下的逻辑推理。 |
法律案例分析、复杂的工程问题求解、文献综述撰写。 |
|
开放网络模式(Open-Web) |
允许使用搜索引擎等网络资源,但禁止使用生成式AI。 |
高级信息筛选与甄别能力、跨领域知识的连接能力、面对海量信息的自主学习。 |
市场研究报告撰写、对一个新技术进行可行性分析。 |
|
开放AI模式(Open-AI) |
允许在教师监督下,现场使用指定的AI工具。 |
人机协同能力:有效的指令工程(Prompt Engineering)、对AI输出的批判性评估与验证、利用AI进行快速迭代与创新的能力。 |
AI辅助代码生成与调试、利用AI进行数据分析与可视化、创意文案的头脑风暴与生成。 |
这种灵活的评估矩阵,将评估的重点从“你知道什么”(What you know)转向了“你能做什么”(What you can do),并且进一步细化为**“你能独立做什么”和“你能借助工具做什么”**。这直接呼应了未来社会对人才能力的核心要求。
2.3 课外作业角色的重新定义
在新的评估体系下,课外作业的价值得到了重塑。它不再是学生与教师之间关于“是否作弊”的博弈,而成为学生构建“双重胜任力”的主战场。
教师可以设计全新的作业形式,例如:
-
AI对比分析作业:要求学生就同一问题,分别使用两个不同的LLM进行提问,并分析、对比其回答的优劣、偏见和事实性错误。
-
AI迭代优化作业:要求学生记录自己与AI的完整对话历史,展示他们是如何通过不断调整指令,引导AI生成一个高质量解决方案的。
-
AI纠错验证作业:教师提供一段由AI生成的、包含隐藏错误的代码或文章,要求学生找出并修正所有错误,并解释错误的原因。
这些作业形式,不再考察最终结果的“原创性”,而是考察学生在与AI互动过程中的思维深度、批判性能力和主导能力。这使得课外学习的过程本身变得比结果更加重要。
通过评估场域的迁移和评估模式的重塑,教育体系可以从根本上化解AI带来的监管难题。它不再试图逆转技术潮流,而是顺应潮流,构建了一个更能反映真实世界需求的、更具韧性的能力评估框架。
💡 三、“双重胜任力”:AI时代的核心人才模型
卡帕西所有论述的最终指向,是定义并培养一种适应AI时代的全新人才模型。他将其凝练为**“双重胜任力”(Dual Competency)**。这个模型摒弃了将人类与AI对立起来的陈旧观念,强调人与AI是共生演化的伙伴关系。一个合格的未来人才,必须同时在两个能力象限中达到高水平。
3.1 能力象限一:AI工具的熟练驾驭
这是“双重胜任力”的第一个支柱。它要求个体不仅仅是AI的被动使用者,更是其主动的、高效的、富有创造力的驾驭者。这绝非“会用ChatGPT聊天”那么简单,而是涵盖了多个层次的技术素养。
3.1.1 精准的指令工程(Prompt Engineering)
这是与AI高效协作的基础。它要求用户能够设计出清晰、明确、富有上下文、能够最大限度激发模型潜力的指令。这包括:
-
角色扮演(Role-Playing):赋予AI一个专家角色。
-
思维链(Chain-of-Thought, CoT):引导AI分步思考。
-
少量样本(Few-Shot Learning):提供范例供AI学习。
-
输出格式约束:精确定义AI返回结果的结构。
一个优秀的工程师或分析师,其指令设计能力将直接决定其生产力。
3.1.2 批判性的输出评估
这是驾驭AI最关键的一环。由于当前LLM存在“幻觉”(Hallucination)、事实性错误、偏见等问题,盲目信任AI的输出是极其危险的。熟练的驾驭者必须具备一套快速验证和评估AI生成内容的能力。
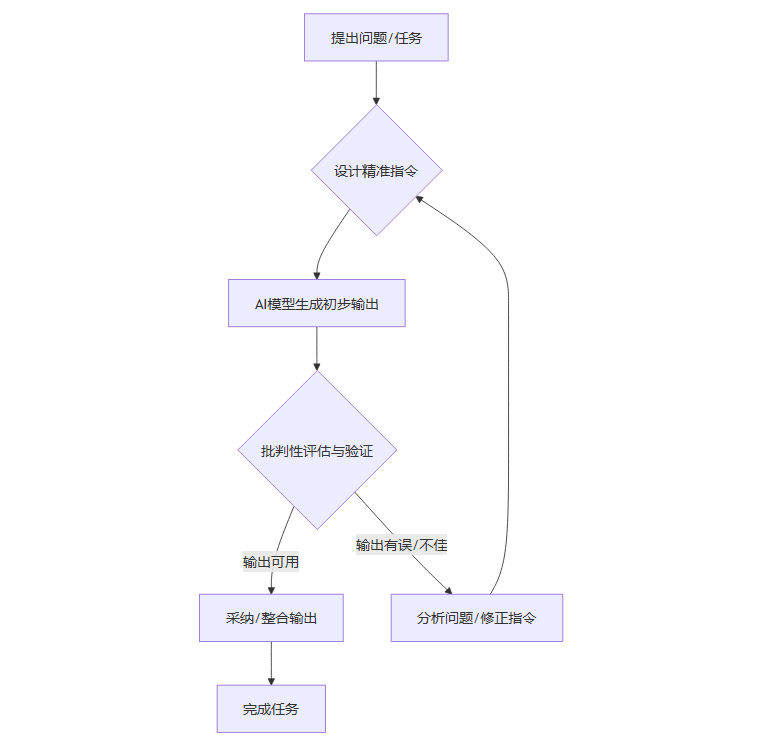
上图:人机协同的关键验证闭环
这个闭环中的“批判性评估”环节,是人类价值的核心体现。它要求使用者对自己所在领域的知识有足够深刻的理解,才能识别出AI输出中那些看似合理、实则谬误的“一本正经的胡说八道”。
3.1.3 协同的工具链整合
高级的AI应用,往往不是单一模型的独角戏,而是一个由多个工具组成的协同工作流。例如,一个数据分析师可能会:
-
使用LLM生成Python代码来进行数据清洗。
-
在Jupyter环境中执行代码,并观察结果。
-
将代码的报错信息反馈给LLM,让其进行调试。
-
使用LLM对清洗后的数据进行初步的洞察分析。
-
利用AI生成数据可视化图表的代码。
在这种模式下,AI是嵌入在专业工作流中的一个或多个“智能组件”。熟练驾驭AI,意味着懂得如何构建和优化这样的工具链,实现效率的倍增。
3.2 能力象限二:非AI环境下的独立解决能力
这是“双重胜任力”的压舱石。它强调,即使剥离所有先进的AI工具,个体依然具备独立思考和解决问题的核心能力。这是防止人类在智力上被AI“掏空”的根本保障。
卡帕西用了一个绝佳的比喻,AI之于思维,如同计算器之于算术。我们允许学生在解决复杂工程问题时使用计算器,但前提是他们必须首先掌握基本的四则运算和数学原理。因为只有这样,当计算器因为按键错误或设备故障给出一个离谱的答案时(比如 25 * 25 = 62.5),他们才能凭借心算和数感立刻识别出错误。
对于AI,这种独立验证能力的重要性被放大了百倍。因为LLM的错误远比计算器更隐蔽、更多样、更具欺骗性。
|
对比维度 |
计算器 |
大型语言模型 (LLM) |
|---|---|---|
|
错误类型 |
确定性错误。通常由输入错误导致,结果是明确的、可复现的错误。 |
概率性错误。包括事实错误、逻辑谬误、知识幻觉、偏见等,结果往往看似合理。 |
|
错误表现 |
结果通常在数量级上明显错误,易于通过常识或估算发现。 |
错误被包裹在流畅、自信的语言中,极具迷惑性,难以通过表面阅读发现。 |
|
验证要求 |
基础算术能力和数感。 |
第一性原理思考、批判性思维、交叉验证能力和深厚的领域知识。 |
因此,教育体系必须加倍重视对学生基础能力的培养。这些能力包括:
-
逻辑推理能力:能够独立地进行演绎、归纳和溯因推理。
-
系统性思维:能够理解复杂系统的各个组成部分及其相互关系。
-
第一性原理思考:能够回归事物的本质去分析问题,而不是依赖现成的经验或答案。
-
创造性思维:能够在没有外部提示的情况下,产生新颖、独特的想法。
这些能力,是人类智慧的基石,也是在与AI协同中保持主导地位的前提。一个不具备独立思考能力的人,在使用AI时,将无法提出深刻的问题,也无法判断答案的真伪,最终只会沦为AI的“提线木偶”。
3.3 “双重胜任力”的培养路径
实现“双重胜任力”的唯一路径,就是卡帕西所倡导的教育模式重构。
-
通过开放的课外探索,培养AI驾驭能力。让学生在没有评分压力的情况下,自由地使用AI作为学习和研究的工具,鼓励他们探索AI的能力边界,并学会与AI高效协作。
-
通过严格的课堂评估,夯实独立解决能力。通过各种模式的课堂内、有监督的评估,确保学生真正掌握了学科的核心知识和底层能力,能够在没有AI辅助时独立完成挑战。
这两个环节相辅相成,共同构成了“双重胜任力”的培养闭环。它既拥抱了技术的进步,又坚守了教育的本质。
💡 四、实践探索:“AI原生学校”的架构与愿景
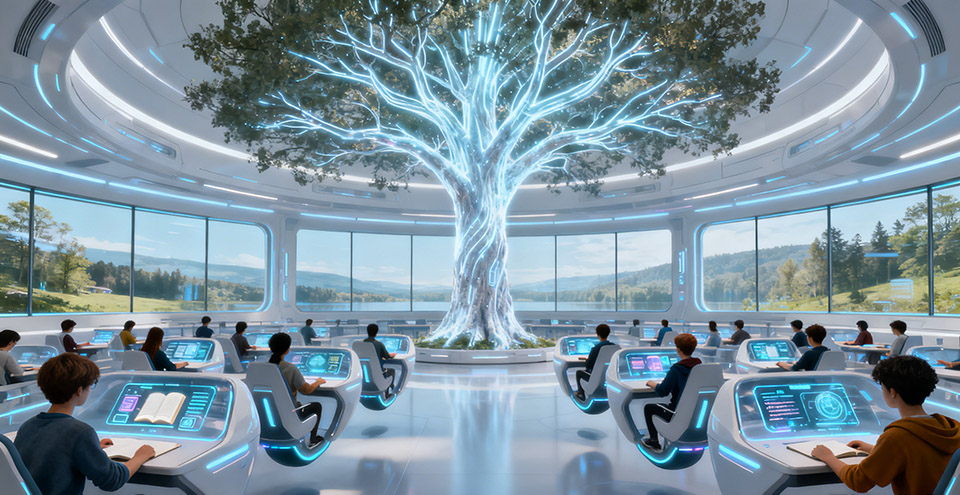
理论的价值最终体现在实践中。卡帕西并未停留在思想的倡导,而是通过创办名为Eureka Labs的初创公司,着手构建他心目中的“AI原生学校”。这不仅是一个商业项目,更像是一个探索未来教育形态的实验室。其核心理念,是对传统教育模式中“教师”和“教学”角色的重新架构。
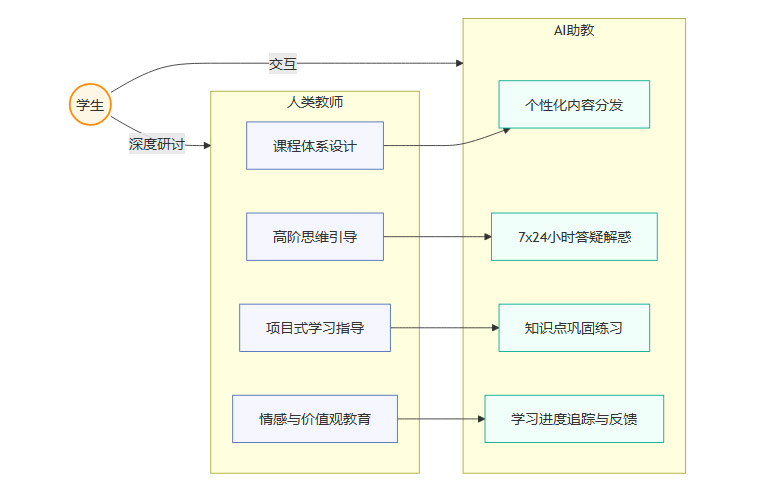
4.1 角色分工:人类教师与AI助教的协同
在“AI原生学校”的设想中,教育工作被分解为两个核心部分,并由最适合的角色来承担。
-
人类教师 (Curriculum Architect & Mentor):
-
职责:不再是知识的“广播站”,而是升级为课程的设计师、高阶思维的引导者和学生成长的陪伴者。他们负责设计整个学习蓝图,创造富有启发性的项目,组织深度的课堂讨论,并提供情感支持和价值观引导。这些是AI短期内无法替代的、高度依赖人类智慧和共情能力的工作。
-
价值:将教师从重复性的知识传授和批改作业中解放出来,专注于“育人”的本质。
-
-
AI助教 (Personalized Tutor at Scale):
-
职责:承担所有可规模化、个性化的教学任务。它能够根据每个学生的知识图谱和学习进度,推送最适合他的学习内容、生成无穷无尽的练习题、并提供7x24小时的即时答疑。
-
价值:以极低的边际成本,实现真正意义上的“因材施教”。它解决了传统教育中,一个老师难以兼顾几十个学生个性化需求的根本矛盾。
-
这种人机协同的模式,旨在融合人类教师的深度与AI助教的广度,实现教育质量与效率的最大化。
4.2 技术架构:个性化学习路径的实现
要支撑起“AI原生学校”的运行,背后需要一套复杂的、以数据驱动的技术架构。其核心组件可能包括:
-
学生知识图谱(Student Knowledge Graph):
-
这是系统的基础。它会为每个学生建立一个动态更新的知识模型,精细地记录学生对每一个知识点的掌握程度(例如:未学习、初步了解、掌握、精通)。
-
-
自适应学习引擎(Adaptive Learning Engine):
-
这是系统的大脑。它会根据学生的知识图谱、学习目标和实时表现,动态规划出最优的学习路径。当检测到学生在某个知识点上遇到困难时,引擎会自动推送相关的补充材料、视频讲解或基础练习。
-
-
模块化内容库(Modular Content Repository):
-
这是系统的资源中心。所有课程内容都被拆解成最小的、可复用的“知识原子”(如一个定义、一个公式、一个案例)。AI助教可以根据学习引擎的指令,动态地将这些原子组合成适合当前学生的个性化“学习包”。
-
-
多模态交互接口(Multimodal Interaction Interface):
-
这是系统的交互层。学生可以通过文本、语音甚至图像与AI助教互动。AI助教不仅能解答问题,还能分析学生提交的代码、批改论文草稿,并提供实时反馈。
-
这个架构的目标,是为每个学生配备一个不知疲倦、无所不知、且永远耐心的私人导师。
4.3 教育公平性的新解法
卡帕西的探索,也为解决一个长期存在的社会难题——教育资源不均,提供了新的可能性。
在传统模式下,优质的教师资源是稀缺且昂贵的,往往集中在少数发达地区和顶尖学校。而“AI原生学校”的模式,具备将顶尖教学能力规模化的潜力。
-
顶尖教师的设计,AI的规模化分发:可以由全球最顶尖的一批教育专家来设计核心课程体系和教学法。然后,通过AI助教,将这种高质量的教学模式,以极低的成本分发到任何一个有网络连接的角落。
-
突破师资瓶颈:对于师资力量薄弱的地区,AI助教可以扮演一个合格的“基础教练”角色,帮助学生打下坚实的知识基础,让当地有限的人类教师能更专注于高阶能力的培养。
当然,这并非一个乌托邦式的完美方案。它依然面临着数字鸿沟、数据隐私、算法偏见等诸多挑战。但它无疑为我们思考如何利用技术来促进教育公平,打开了一个全新的、极具想象力的窗口。
结论
安德烈·卡帕西提出的教育变革框架,是一个逻辑严密且高度自洽的系统。它始于对“AI内容检测不可行”这一技术现实的坦诚,继而推导出“评估必须回归课堂”的结构性调整,最终落脚于培养“双重胜任力”这一核心教育目标。他创办的“AI原生学校”,则是将这一理论付诸实践的勇敢尝试。
这一整套思想,为身处AI浪潮中的教育者、技术专家和政策制定者提供了清晰的行动指南。它告诉我们,面对颠覆性技术,最佳策略不是防御和封堵,而是理解和重构。教育的未来,不在于如何防止学生使用AI,而在于如何设计一个全新的教育体系,让学生在AI的加持下,成为更强大、更完整的人。
这场变革已经开始。我们需要做的,是放弃幻想,拥抱现实,并立即着手重新设计我们的课堂、我们的评估方式以及我们对“人才”的定义。
📢💻 【省心锐评】
放弃抓AI作弊的徒劳游戏。教育的核心应转向重构评估体系,将关键考核置于课堂监督之下,旨在锻造既能驾驭AI、又能独立思考的“双重胜任力”人才。


 84


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


