



简介
本文基于上一篇,需要先安装大模型nomic-embed-text,text-embedding-3-small的前提下进行。完全使用的本地模型,因此无需注册和付费的公钥key就可以使用。
在上一篇的基础上我们实现一个基于一篇PDF短文的小型RAG知识库。整个流程基本讲到了常用的组件和需要完成的工作细节。以小见大,为深入了解后续问题提供可实现的小目标。
LangChain 的重要模块包括:
LLM:大语言模型接口(如 OpenAI、ChatGLM、Tongyi)
Embeddings:文本向量化模型
VectorStore:向量数据库封装(Chroma、FAISS 等)
Retriever:检索器组件
Chains:链式调用(支持流水线组合)
RAG组件交互流程
项目结构
最终的项目结构如下:
my-rag/
├── data/
│   └── your_document.pdf    # 你的测试文档
├── rag.py                   # 主程序
└── requirements.txt         # 依赖
安装依赖
创建 requirements.txt:
langchain>=0.2
langchain-community>=0.2
chromadb>=0.5
pypdf>=4.0
安装:
pip install -r requirements.txt
各库的作用:
| 库 | 作用 |
|---|---|
| langchain | RAG 流程编排框架 |
| langchain-community | 向量数据库(ChromaDB)和文档加载器(PyPDF)的集成 |
| chromadb | 向量数据库,负责存储和检索向量 |
| pypdf | PDF 文档解析 |
pypdf
仅对“含可提取文本对象”的机器生成 PDF 有效,无法处理纯图像扫描件(无文本层);核心擅长文件结构操作(合并/拆分/旋转/加密/水印/元数据)及基础文本提取。
核心适用场景
- 文件级操作:多文档合并、按页拆分、页面重排/旋转/裁剪、添加水印、加密解密(需 pypdf[crypto])、读写元数据与书签 。
文本提取:针对网页导出、Office 转存等纯文本 PDF,支持基础提取及布局模式(extraction_mode=“layout”)保留大致格式 。 - 表单处理:读取 AcroForm 字段结构、批量填充文本框/复选框等交互式表单数据 。
- 图像提取:安装 pypdf[image] 后可导出嵌入的图片资源(非渲染页面)。
无效或受限场景 - 扫描件/图片型 PDF:若 PDF 由扫描产生且无隐藏文本层,extract_text() 返回空或乱码,必须配合 OCR 工具(如 pytesseract+pdf2image)。
复杂表格精准提取:虽能读文本,但无法像 pdfplumber 那样基于线条自动重构合并单元格表格结构。 - 渲染与生成:不支持将 PDF 转为图片(渲染),也不支持从零绘制矢量内容生成新 PDF(需 reportlab 或 PyMuPDF)。
选型建议
若需求是批量重组文档、加解密、简单文本抓取,首选 pypdf(纯 Python、无 C 依赖);若需高精度表格解析、扫描件识别或页面渲染,请搭配 pdfplumber、pytesseract 或 PyMuPDF 使用
把上面的文字放入word中转为PDF如下图
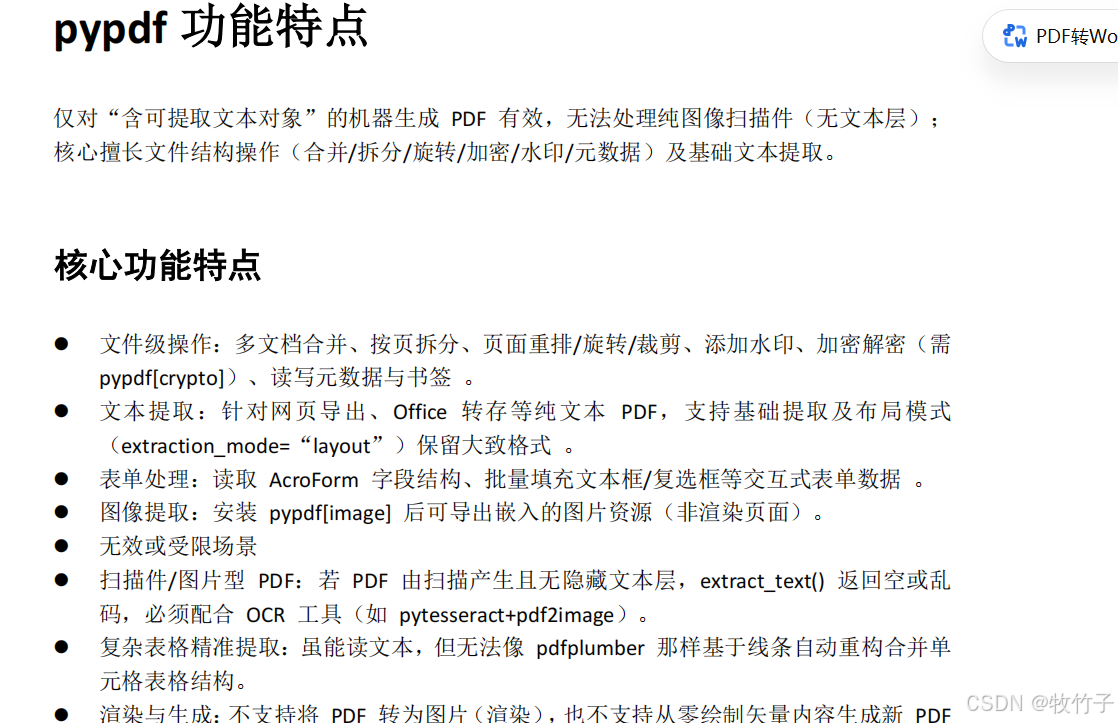
这里保存到data文件夹,并文件名称为 your_document.pdf
data/your_document.pdf
文档加载
使用PyPDFLoader加载pdf文件,输出文件内容和页数
from langchain_community.document_loaders import PyPDFLoader

# 1. 初始化加载器(传入PDF文件路径,支持相对路径/绝对路径)
# 相对路径:相对于当前代码文件的路径(如data/test.pdf)
# 绝对路径:如"C:/docs/test.pdf"(Windows)或"/home/user/docs/test.pdf"(Linux)
loader = PyPDFLoader("data/your_document.pdf")

# 2. 加载所有页面(返回Document对象列表)
pages = loader.load()

# 3. 查看基础信息
print(f" PDF总页数:{len(pages)}")  # 输出总页数
print(f"\n 第一页元数据:{pages[0].metadata}")  # 元数据(source、page等)
print(f"\n 第一页前200字符预览:\n{pages[0].page_content[:200]}...")  # 文本预览
文档切分
为什么这么分割:大模型有上下文长度限制,需要把长文档切成小块。重叠部分确保关键信息不会在分割点丢失
关键参数配置
| 参数 | 类型 | 默认值 | 作用 | 优化建议 |
|---|---|---|---|---|
| chunk_size | int | 1000 | 单块最大字符数 | 根据模型token限制调整 |
| chunk_overlap | int | 200 | 块间重叠字符数 | 保持语义连续性 |
| separators | List[str] | [“\n\n”, “\n”, " ", “”] | 分割符优先级 | 按文档结构调整 |
通过多级分隔符递归尝试:
- 优先尝试段落分隔符\n\n
- 其次尝试换行符\n
- 最后尝试空格和空字符
这种设计能有效处理结构化文档(如Markdown)和非结构化文本的混合场景。
def split_documents(docs):
    """切分文档"""
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=CHUNK_SIZE,
        chunk_overlap=CHUNK_OVERLAP,
        separators=["\n\n", "\n", "。", "!", "?", ",", " "],
    )

    chunks = splitter.split_documents(docs)
    print(f"✓ 切分为 {len(chunks)} 个片段")

    for i in chunks:
        print('----------------------------------------')
        print(i)

    return chunks
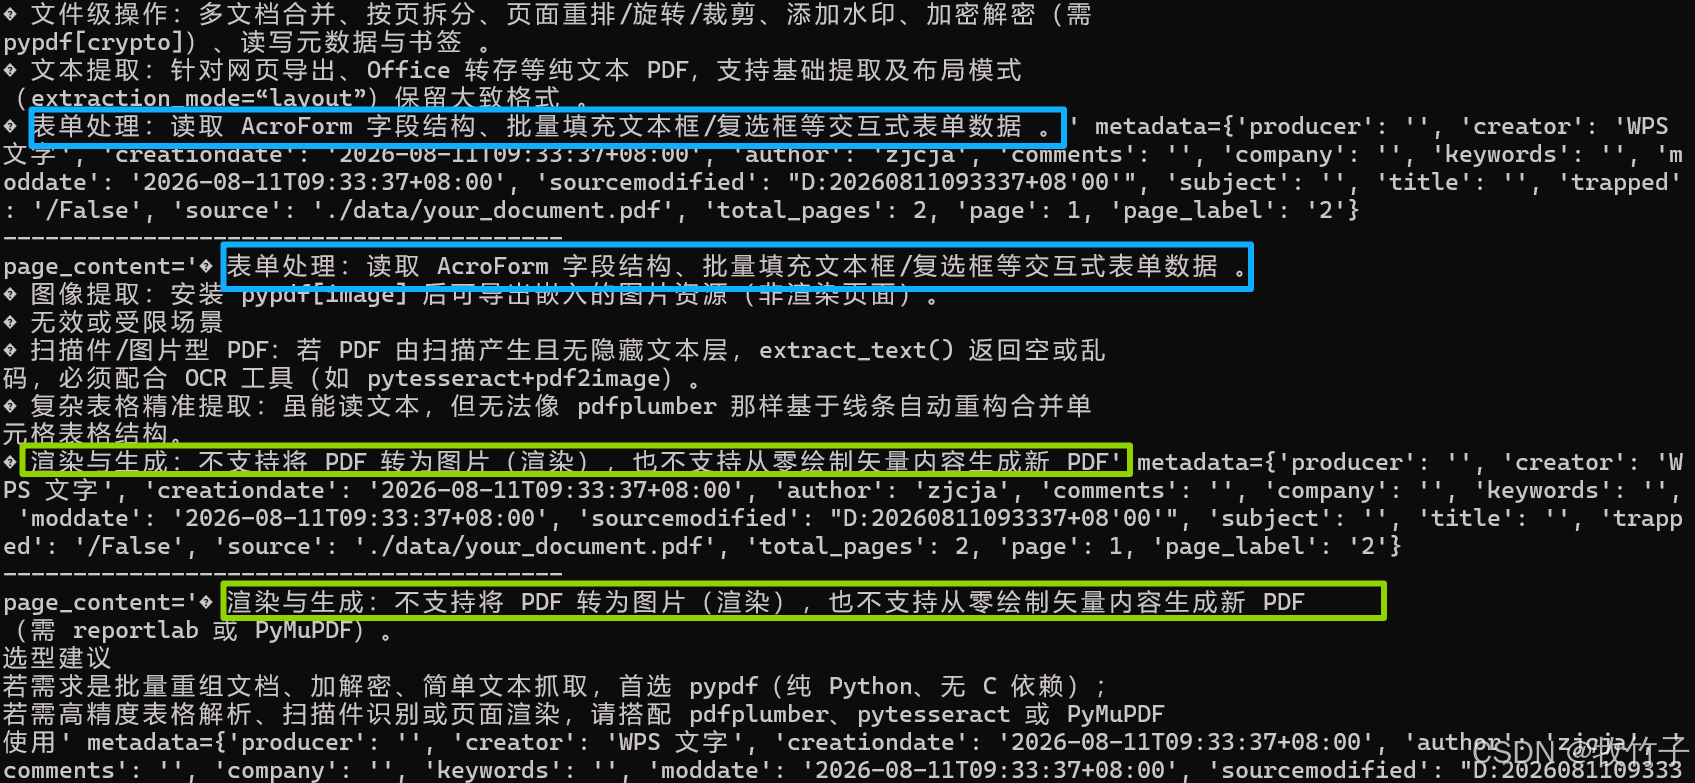
原PDF拆分后内容的拆分块内容如下,可以看到有每个块的分割先后有部分是重合的,目的就是为了防止上下文断开保持语义连续性
文档块向量化并存入向量数据库
大模型很强,但它有一个致命弱点:记忆有限。你公司的内部文档、产品手册、客户历史记录——这些数据模型统统不知道。怎么让模型在海量私有数据中快速找到相关信息?
答案是两个关键技术:Embedding(嵌入) 和 向量数据库。Embedding 负责把文本转换成数字向量(语义相似 = 向量接近),向量数据库负责在百万级向量中毫秒级找到最相似的。
这两者是 RAG、语义搜索、推荐系统的底层基石
 """
使用向量数据库构建一个语义搜索系统
"""


import chromadb
from langchain_ollama import OllamaEmbeddings


# 初始化嵌入模型
embedServer = OllamaEmbeddings(
    model="nomic-embed-text",  # 指定已下载的模型名称
    base_url="http://localhost:11434"  # Ollama 服务地址
)


# 2. 准备数据
documents = [
    "Python 是一种解释型、面向对象的高级编程语言",
    "机器学习是人工智能的一个分支,通过数据训练模型",
    "Docker 是一个开源的容器化平台,用于自动化部署应用",
    "React 是 Facebook 开发的 JavaScript 前端框架",
    "深度学习使用多层神经网络来学习数据的层次表示",
    "Kubernetes 是一个开源的容器编排平台",
    "自然语言处理是计算机科学和 AI 的交叉领域",
    "PostgreSQL 是一个强大的开源关系型数据库",
]

# 3. 生成 Embedding 并存入
def get_embeddings(texts):
    response = embedServer.embed_documents(texts)
    return response

embeddings = get_embeddings(documents)
# print("向量结果:", embeddings)


# # 4. 语义搜索
query = "怎么用 AI 处理文本数据?"
query_embedding = get_embeddings([query])[0]

# print("向量结果2:", query_embedding)


# 1. 初始化 Chroma
chroma_client = chromadb.Client()
collection = chroma_client.create_collection(
    name="knowledge_base",
    metadata={"hnsw:space": "cosine"}  # 使用余弦相似度
)

#保存到向量数据库
collection.add(
    documents=documents,
    embeddings=embeddings,
    ids=[f"doc_{i}" for i in range(len(documents))],
)

#使用数据库查询
results = collection.query(
    query_embeddings=[query_embedding],
    n_results=3,
)
#
print("查询:", query)
print("最相关的文档:")
for i, doc in enumerate(results["documents"][0]):
    dist = results["distances"][0][i]
    print(f"  {i+1}. [{dist:.4f}] {doc}")

# 输出:
# 查询: 怎么用 AI 处理文本数据?
# 最相关的文档:
# 1. [0.2267] 自然语言处理是计算机科学和 AI 的交叉领域
# 2. [0.4030] 深度学习使用多层神经网络来学习数据的层次表示
# 3. [0.4219] 机器学习是人工智能的一个分支,通过数据训练模型
向量相似度搜索:原理与算法
3.1 距离度量
| 度量方式 | 公式 | 适用场景 | 值域 |
|---|---|---|---|
| 余弦相似度 | cos(�,�)=�⋅� | � | ⋅ |
| 欧氏距离 | �(�,�)= | �−� | 2 |
| 点积 | �⋅� | 归一化后的向量 | (−∞,+∞) |
实践中余弦相似度用得最多——它只关心方向不关心大小,更符合"语义相似"的直觉。
这里我们使用上一章节中下载的向量模型nomic-embed-text看看常见的向量化和查询操作
from langchain_ollama import OllamaEmbeddings
import numpy as np
# 初始化嵌入模型,转为向量
embeddings = OllamaEmbeddings(
    model="nomic-embed-text",  # 指定已下载的模型名称
    base_url="http://localhost:11434"  # Ollama 服务地址
)

#单个文本向量化 (embed_query)
vector = embeddings.embed_query("如何重置密码?")
print(f"向量维度:  {len(vector)}")


#批量文档向量化
texts = ["文档片段 1", "文档片段 2", "文档片段 3"]
vectors = embeddings.embed_documents(texts)
print(f"生成向量数量:{len(vectors)} \n {vectors[0]} ")


print("---------转换为向量并对比相似度------------")

def get_embedding(text):
    response = embeddings.embed_query(text)
    return response

# 生成 Embedding
emb1 = get_embedding("猫在沙发上睡觉")
emb2 = get_embedding("小猫躺在沙发上打盹")
emb3 = get_embedding("今天股市大涨")
emb4 = get_embedding("今天股市如何")

# 计算余弦相似度
def cosine_similarity(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

print(f"猫睡觉 vs 猫打盹: {cosine_similarity(emb1, emb2):.4f}")  # ~0.95 高相似
print(f"猫睡觉 vs 股市大涨: {cosine_similarity(emb1, emb3):.4f}")  # ~0.15 低相似
print(f"今天股市如何 vs 今天股市大涨: {cosine_similarity(emb4, emb3):.4f}")  # ~0.15 高相似
print(f"今天股市如何 vs 今天股市如何: {cosine_similarity(emb4, emb4):.4f}")  # ~0.15 高相似

# 相似度如下越接近1越像
# ---------转换为向量并对比相似度------------
# 猫睡觉 vs 猫打盹: 0.8875
# 猫睡觉 vs 股市大涨: 0.6510
# 今天股市如何 vs 今天股市大涨: 0.8874
# 今天股市如何 vs 今天股市如何: 1.0000
使用LLM生成答案
其实就是用提出的问题转为向量,和存储在向量库中的向量进行相似度对比。相识度高的向量对应的文本数据返回后交给LLM进行文本的修饰后返回给提问人。
"""RAG 系统 - 基于 PDF 文档的知识问答
新版langchain_community>0.2已经把原有模块进行新的拆分,注意版本问题

这里使用的是本地模型服务ollama

"""

from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain.embeddings.base import Embeddings

from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
# from langchain.prompts import ChatPromptTemplate
# from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
# from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.llms import Ollama
from langchain_ollama import OllamaEmbeddings
from langchain_core.prompts import PromptTemplate
from langchain_ollama import OllamaEmbeddings

# --- 配置 ---
DATA_PATH = "./data/your_document.pdf"
DB_PATH = "./chroma_db"
EMBEDDING_MODEL = "text-embedding-3-small"
LLM_MODEL = "llama3.1:8b"
CHUNK_SIZE = 300
CHUNK_OVERLAP = 50
TOP_K = 5


# 3. 生成 Embedding
def get_embeddings(texts):
    # 初始化嵌入模型
    embedServer = OllamaEmbeddings(
        model="nomic-embed-text",  # 指定已下载的模型名称
        base_url="http://localhost:11434"  # Ollama 服务地址
    )
    response = embedServer.embed_documents(texts)
    return response


def load_documents(path):
    """加载 PDF 文档"""
    loader = PyPDFLoader(path)
    docs = loader.load()
    print(f"✓ 加载了 {len(docs)} 页")
    return docs


def split_documents(docs):
    """切分文档"""
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=CHUNK_SIZE,
        chunk_overlap=CHUNK_OVERLAP,
        separators=["\n\n", "\n", "。", "!", "?", ",", " "],
    )

    chunks = splitter.split_documents(docs)
    print(f"✓ 切分为 {len(chunks)} 个片段")
    my_doc = []


    for page in chunks:
        print('----------------------------------------')
        print(page.page_content)
        my_doc.append(page.page_content)

    return chunks


def build_vectorstore(chunks):
    """向量化并存入 ChromaDB 返回 存储实例 """
    # embeddings = OpenAIEmbeddings(model=EMBEDDING_MODEL)
    # 1. 初始化嵌入模型(确保本地 Ollama 服务已启动且模型已拉取)
    embeddings = OllamaEmbeddings(model="nomic-embed-text",base_url="http://localhost:11434")

    vectorstore = Chroma.from_documents(
        documents=chunks,
        embedding=embeddings,
        persist_directory=DB_PATH,
    )
    print(f"✓ 已存入 {vectorstore._collection.count()} 个向量")
    return vectorstore


def create_rag_chain(vectorstore):
    #检索器,把存储实例作为检索基础相当于一个实例表连接
    retriever = vectorstore.as_retriever(
        search_type="similarity",
        search_kwargs={"k": TOP_K}, #返回相识度高的 前K条记录
    )


    #提示词模板
    prompt = PromptTemplate(
        input_variables=["context", "question"],
        template="""
            你是一个知识问答助手。请基于以下参考资料回答用户的问题。

            要求:
            1. 只基于参考资料回答,不要编造信息
            2. 如果参考资料中没有相关信息,明确告知"找不到相关信息"
            3. 在回答中标注引用来源(如 [1]、[2])

            ---
            参考资料:
            {context}
            ---

            用户问题:{question}
        """.strip()
    )


    # llm = ChatOpenAI(model=LLM_MODEL, temperature=0)
    # 初始llm服务
    llm = Ollama(model="llama3.1:8b", base_url="http://localhost:11434")

    def format_docs(docs):
        formatted = []
        for i, doc in enumerate(docs):
            page = doc.metadata.get("page", "N/A")
            formatted.append(f"[{i+1}] (第{page}页)\n{doc.page_content}")
        return "\n\n".join(formatted)

    chain = (
            {
                "context": retriever | format_docs,
                "question": RunnablePassthrough(),
            }
            | prompt
            | llm
            | StrOutputParser()
    )

    return chain


def main():
    # 1. 加载文档
    docs = load_documents(DATA_PATH)

    # 2. 切分文档
    chunks = split_documents(docs)

    # 3. 向量化并存储
    vectorstore = build_vectorstore(chunks)

    # 4. 使用存储的向量作为基础知识,创建 RAG Chain
    chain = create_rag_chain(vectorstore)


    # 5. 交互式问答
    print("\n" + "=" * 50)
    print("RAG 系统已就绪!输入问题开始对话,输入 q 退出。")
    print("=" * 50)

    while True:
        question = input("\n你:")
        if question.lower() in ("q", "quit", "exit"):
            break
        if not question.strip():
            continue

        answer = chain.invoke(question)
        print(f"\nAI:{answer}")


if __name__ == "__main__":
    main()
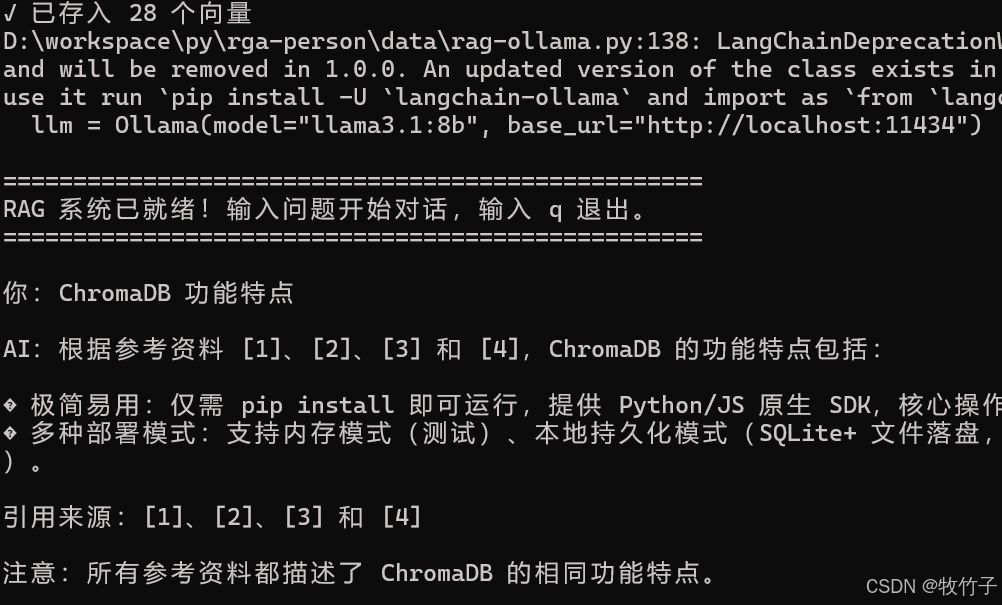
效果如下
总结
本章节承上启下,解开实现RAG的基础功能的基础细节,为小型演示和深入学习有个初步的了解。简要来说一切的基石是向量的使用,作为开发者如果在这个基础上构建一个可用的调用链从而实现一系列的数据处理后能够实现RAG功能。


 扫一扫


 437

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


