GEO生信数据挖掘(三)芯片探针ID与基因名映射处理

GEO芯片数据下载和探针ID转换(保姆级教程) R语言安装、GEO芯片数据下载、探针ID转换 阅读详情

检索到目标数据集后,开始数据挖掘,本文以阿尔兹海默症数据集GSE1297为例

目录

处理一个探针对应多个基因

1.删除该行

2.保留////分割符号前面的第一个基因

处理多个探针对应一个基因

详细代码案例一删除法

详细代码案例二 多个基因名时保留第一个基因名

小结

更新版本的代码全文


上节我们下载了基因芯片平台文件并注释,我们发现存在一个芯片探针ID匹配到多个基因的情况,本节来介绍处理方案。
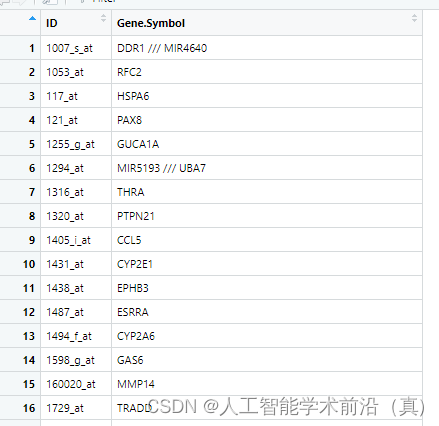
处理一个探针对应多个基因

我们通过简单检索发现两种方法:1.删除操作 2.保留////分割符号前面的第一个基因

1.删除该行

#处理一个探针对应多个基因
#方案一:【删除该行】

explan_final <- data.frame(explan_final[-grep("///",explan_final$"Gene.Symbol"),]) 

#去一对多,grep是包含的意思,-就是不包含

2.保留////分割符号前面的第一个基因

#方案二:【保留第一个基因名】
ids = platform_file_set #探针列名和基因名两列
library(tidyverse)
test_function <- apply(ids,
               1,
               function(x){
                 paste(x[1],
                       str_split(x[2],'///',simplify=T),
                       sep = "...")
               })
x = tibble(unlist(test_function))

colnames(x) <- "ttt" 
ids <- separate(x,ttt,c("ID","Gene.Symbol"),sep = "\\...")
dim(ids) #探针列名和基因名两列

显然,第一个发现非常简单,在使用merge函数匹配时,会剔除更多的基因。第二个方法,会保留更多基因。

处理多个探针对应一个基因

表达矩阵中还有一个问题,如下图所示,很多探针指向同一个基因。
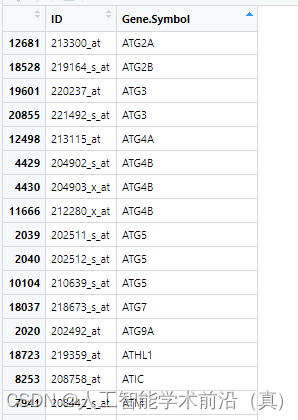
#把重复的Symbol 取每个基因所有探针的平均值或最大值作为基因的表达量
matrix <- aggregate(.~Gene.Symbol, matrix, mean)  ##把重复的Symbol取平均值

matrix <- aggregate(.~Gene.Symbol, matrix, max)  ##把重复的Symbol取最大值

详细代码案例一删除法

# 安装并加载GEOquery包
library(GEOquery)

# 指定GEO数据集的ID
gse_id <- "GSE1297"

# 使用getGEO函数获取数据集的基础信息
gse_info <- getGEO(gse_id, destdir = ".", AnnotGPL = 
GEO生信数据挖掘(二)下载基因芯片平台文件及注释 检索到目标数据集后,开始数据挖掘,本文以阿尔兹海默症数据集GSE1297为例上节我们,但是矩阵行名称是芯片探针需要转换为基因名。 阅读详情

相关推荐

GPL6466芯片平台的ID转换及数据挖掘

做了一个GPL6466平台的芯片数据处理。没找到辅助R包,用clusterProfiler包和GPL文件做了ID转换。并进行了后续处理

m0_61606680的博客 3190

GEO生信数据挖掘(六)实践案例——四分类结核病基因数据预处理分析

由于,在数据分析过程,你拿的数据样式可能会有不同,本节我们以结核病基因表达数据(GSE107994)为例,做一个实践案例。该数据集的临床形状数据和基因表达数据是单独分开的,读取,和处理都需自己改动代码。

zzh1464501547的博客 5887

GEO数据挖掘(一)基础介绍

GEO数据挖掘,火山图,热图,主成分分析

doctor_yuxiang的博客 2万+

GEO生信数据挖掘(四)探针与基因映射优化策略对比

本文深入探讨了GEO生信数据挖掘中芯片探针ID与基因名映射的优化策略。针对常见的“一对多”和“多对一”映射难题,详细对比了直接删除法、保留首个基因名法以及平均值/最大值整合法三种处理方案的R代码实现、数据影响及适用场景,并以阿尔兹海默症数据集GSE1297为例进行实战对比,为研究者根据具体分析目的选择最合适的基因名映射策略提供决策指南。

weixin_29229261的博客 259

GEO生信数据挖掘实战:基因芯片注释与探针ID转换全攻略

本文详细解析GEO生信数据挖掘中基因芯片注释与探针ID转换的完整流程,涵盖平台文件获取、表达矩阵处理及Bioconductor注释包使用等关键步骤。针对常见问题如注释缺失、数据不匹配等提供实用解决方案,帮助科研人员高效完成基因芯片数据分析,特别适合生物信息学初学者和需要处理GEO数据库的研究者。

weixin_29313547的博客 395

GEO数据挖掘避坑指南:国内网络环境下如何搞定芯片平台文件下载与注释(以GPL96为例)

本文详细介绍了在国内网络环境下高效处理GEO芯片平台文件(以GPL96为例)的实用方案,涵盖数据下载、注释加速和本地化策略。通过多路径并行获取、Bioconductor包精确定位及混合策略应用,解决生信分析中的网络困境,提升GEO数据挖掘效率。特别适合基因芯片研究者优化工作流程。

weixin_30839881的博客 462

生信实战——GEO数据挖掘从入门到发表

本文详细介绍了GEO数据挖掘的全流程,从数据获取、预处理到差异表达分析和功能富集分析,帮助生信初学者快速掌握从入门到发表的关键技术。通过实战案例和常见问题解决方案,提升数据分析效率,助力科研成果产出。

weixin_30673611的博客 295

GEO数据挖掘实战:用R语言从GSE42872数据集中找到关键差异基因(附完整代码)

本文详细介绍了使用R语言从GSE42872数据集中挖掘关键差异基因的完整流程,包括数据下载、探针ID转换、差异表达分析和功能富集分析。通过实战代码演示,帮助生信研究者掌握GEO数据挖掘的核心技术,快速识别疾病相关基因并理解其生物学功能。

weixin_42625070的博客 358

R语言实战:用GEOquery和AnnoProbe搞定GEO芯片数据下载与ID转换(附避坑指南)

本文详细介绍了使用R语言的GEOquery和AnnoProbe包进行GEO芯片数据下载与探针ID转换的实战方法,包括环境配置、数据下载优化、注释获取、表达矩阵匹配、临床信息整合等关键步骤,并提供了避坑指南和自动化处理方案,帮助生物信息学研究者高效处理基因表达数据。

weixin_28465009的博客 341

避坑指南:GEO数据挖掘中那些新手常踩的雷——从探针注释到limma差异分析

本文详细解析了GEO数据挖掘中从探针注释到limma差异分析的常见陷阱与解决方案,特别针对生信分析新手易犯的错误提供了实用避坑指南。内容包括探针注释方法选择、多探针处理技巧、limma设计矩阵构建要点,以及差异分析结果的可视化与验证策略,帮助读者提升GEO数据挖掘的准确性和效率。

weixin_30835649的博客 391

GEOquery实战:从GSE、GPL到GDS,不同ID号的数据下载与处理全解析

本文详细解析了如何使用GEOquery包从GEO数据库下载和处理不同ID号(GSE、GPL、GDS)的数据。文章通过实战代码,重点阐述了针对GSE、GPL和GDS数据的差异化下载策略、数据结构解析方法,并提供了从数据获取到清洗注释的完整工作流,帮助生物信息学研究者高效利用这一公共数据宝库。

weixin_29070721的博客 487

R语言提取GEO数据库数据全流程:从GSE编号到表达矩阵

生物信息学研究中,基因表达数据的获取与预处理是下游分析的基石。GEO(Gene Expression Omnibus)作为全球权威的公共基因表达数据库,存储了海量芯片与测序数据。R语言结合Bioconductor生态的GEOquery包,能够以脚本化方式高效下载并解析GEO数据,自动提取表达矩阵、样本信息和平台注释,将繁琐的网页手动操作转化为可复现的分析流程。这种技术方案不仅大幅提升数据处理效率,也保障了科研结果的可靠性,广泛应用于疾病机制研究、生物标志物筛选等场景。理解GSE、GSM、GPL等编号体系,以

weixin_33600816的博客 370

【R语言-生存分析之观察生存率计算】

全人群肿瘤登记资料常用的统计分析指标包括发病率、死亡率、现患率以及生存率等,其中肿瘤生存率是评估肿瘤治疗效果和肿瘤负担的必要指标,其计算涉及肿瘤患者的发病、 死亡和随访三个方面的资料, 数据整理和计算过程均较为复杂, 如何及时、 准确地计算肿瘤生存率, 并使其可以在不同地区、 不同人群、不同时期间被客观公正地比较和评价,仍然是统计学家们一直在研究的主题。

weixin_46579654的博客 5432

全差分运放+开关电容共模反馈

设计一种CMOS全差分折叠式共源共栅结构的运放,其共模反馈用的是开关电容(SC-CMFB)。 下面分别是主运放、偏置电路和开关电容共模反馈电路图 在设计时碰到的问题: 1、增益怎么测? 2、输出波形不平滑? 3、开关的时序频率设置多高? 解答: 1、先设计好主运放和偏置电路,使得运放的输出接近VDD/2,且主运放的管子都工作在饱和区,然后再参考何乐年的《模拟集成电路设计与仿真》仿增益。 2、增益仿完后,仿真瞬态,看电路的工作情况,于是将偏置电路上接Vb4与主运放断开,接到共模反馈上的Vbia上,然后就

qq_36686804的博客 1万+

RV1106的ISP配置实战:MIPI与LVDS接口的硬件连接与设备树优化

本文详细解析了RV1106芯片的ISP配置实战,重点对比了MIPI CSI-2与LVDS两种主流接口的硬件连接方案与数据流差异。通过手把手的设备树代码示例,深入讲解了单路MIPI与双路LVDS摄像头的配置要点、关键属性设置及常见避坑指南,并提供了从驱动加载检查到Media Controller工具使用的系统化调试方法,帮助开发者快速打通图像采集与处理全链路。

terraform7cloud的博客 465

基于卷积神经网络的人脸识别算法

摘要:近年来,随着科学技术的不断发展,人脸识别技术日渐成熟,使得人脸识别技术的使用率不断增大。例如:门禁、ATM机、公安系统以及新兴起的人机交互等领域,都应用到了人脸识别系统。在人脸识别研究领域中,深度学习扮演着重要的角色。由于深度学习的人脸识别技术凭借其识别率高、识别快等特点,逐渐成为整个领域的主流技术。在众多深度学习算法中,以卷积神经网络为代表的人脸识别系统得到了广泛应用,主要研究内容如下:首先,通过对经典损失函数进行研究,对比每种损失函数的特点,然后根据A-Softmax函数进行改进,借助Margin

yyq2263511327的博客 1万+

用Excel或WPS做两独立样本的T检验

一般情况下收集数据时常用的是Excel或者WPS,但统计时却用SPSS等软件进行统计学分析,经常很多人找不到SPSS的安装包,或者苦于正版激活或忘记教程,其实Excel或WPS自带函数就足够了,均数、标准差以及统计检验都是一个函数而已。解释:先做F检验,如果F>0.05就做T检验,Ttset里的数据为两组的数据的比较,结果如下。A组的均数计算 =AVERAGE(B2:B6)A组的标准差计算 =STDEV(B2:B6)B组的标准差计算=STDEV(B7:B19)分组 数值 A组均数 A组标准差 p值。

Mrrunsen的博客 6747

YOLOv11改进策略【损失函数篇】| WIoU v3:针对低质量样本的边界框回归损失函数

是一种基于IoU的损失函数,旨在解决目标检测中边界框回归损失函数在处理低质量训练数据时的问题。论文链接:https://arxiv.org/pdf/2301.10051 源码链接:https://github.com/Instinct323/wiou此处需要查看的文件是中定义了模型的损失函数和计算方法,我们想要加入新的损失函数就只需要将代码放到这个文件内即可将下方的函数替换原本的函数即可: 用于计算各种损失。在内修改如下代码,使模型调用此损失函数。 tal.py中是一些损失函数的功能应用。在内修改如下代码,

Limiiiing的博客 3774

时间序列预测 | Python实现LSTM时间序列数据预测

目录LSTM神经网络LSTM原理LSTM数据下载LSTM程序设计导入Python包时序数据处理LSTM模块定义模型训练模型评估参数设定运行结果参考资料致谢 LSTM神经网络 长短期记忆网络——通常简称为“LSTM”——是一种特殊的 RNN,能够学习长期依赖关系。它们由Hochreiter & Schmidhuber (1997)引入,并在后续工作中被许多人提炼和推广。1它们在处理各种各样的问题时效果非常好,现在被广泛使用。LSTM 被明确设计为避免长期依赖问题。长时间记住信息实际上是他们的默认行为

前程算法屋的博客 3907

使用MATLAB中的Simulink工具来构建一个微电网系统的仿真平台

微电网是指由分布式电源(如太阳能、风能等)、储能装置、负载以及控制和保护装置组成的局部电力系统。它可以独立于主电网运行,也可以与主电网并联运行。本示例将以一个简单的微电网为例,展示如何利用Simulink进行微电网接入与孤岛运行策略的设计与仿真。分布式电源:模拟太阳能光伏板或风力发电机等分布式电源。储能装置:用于存储多余能量或补充不足能量。负载:模拟实际用电需求。双向变流器:实现直流与交流之间的转换,并支持并网和孤岛模式切换。控制器:负责管理微电网的运行模式,包括并网控制和孤岛控制。

xiaoheshang_123的博客 342

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

上一篇: GEO生信数据挖掘(二)下载基因芯片平台文件及注释
下一篇: GEO生信数据挖掘(四)数据清洗(离群值处理、低表达基因、归一化、log2处理)
人工智能学术前沿(真)
博客等级 码龄9年 540粉丝 56原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
