「履歴を失う世界で、僕たちは何を信じるのか」【DigicoTips Lookup編.02】

前回の話で私は『設計が悪い』と言いました。
LookupTips履歴
【DigicoTips Lookup編.01】
むしろ、長い間、多くの現場開発者や設計者がLookup仕様を単なる制約として捉え、その先にある本質を探索しようとしなかったのではないか——。
私にはそんな疑問が残ります。
文末では【付則:Excel 2021/365で実現する「過去を壊さない」履歴保持型LOOKUP設計】と題し、新しいExcelバージョンの計算式を載せています。
ロジックを壊さなければ、最新の関数利用で更なるブラッシュアップも可能です。
是非、最後までお読みください。
「履歴を失う世界で、僕たちは何を信じるのか」
1
Excelは、長い年月をかけて企業の現場に根を張ってきた。
会議室でも、倉庫でも、深夜のオフィスでも、
人の判断と数字のあいだに、いつもExcelがあった。
ただ、その静かな関係には、
見て見ぬふりをされてきた“綻び”がいくつもある。
CASE関数はない。
参照は勝手に動く。
CSVは勝手に破壊される。
そして——その代表格が LOOKUP だ。
数式をコピーした途端に、過去を壊す。
2
たとえば、商品Aの単価が100円だったとする。
翌月120円に変わった。
マスタの単価を120円に書き換えた瞬間、
先月の売上まで120円で再計算されてしまう。
本来は、
1月の売上は「100円 × 10個」で1,000円のままであるべきなのに、1,200になってしまうのだ
LOOKUPは“最新の値”しか返さない。
参照は便利だ。
でも、
“過去が書き換わる” という致命的な欠点 がある。
長い年月、
誰も“対策”をしてこなかった。
やってきたのは、いつも“対処”だけだ。
3
初めてこの問題を見たとき、
僕は少しだけ考えた。
ただ、その時にはもう構造が浮かんでいた。
4
◆ 単価の履歴を「横に積む」という発想
単価が変わるたびに、
その時点の単価を新しい情報として右側に追加していく。
|1月1日:100円|2月1日:120円|3月1日:150円|
この変化を、
“縦に積む”のではなく、
“横に積む”。
Excelは本来、
“時間”という概念を持っていない。
だからこちらが 時間を横方向に与える。
5
◆ 売上日を使って「どの単価を使うべきか」を決める
売上データには「売上日」がある。
単価の履歴には「単価が変わった日」がある。
この二つを結びつけるために、
僕がやったのはとても単純で、
“この売上日は、どの単価期間に属するのか” を判断させるだけ。
1月10日の売上 → 1月1日〜1月31日の期間 → 100円
2月5日の売上 → 2月1日〜2月29日の期間 → 120円
つまり、
売上日を手がかりに、正しい単価を選ばせる。
難しい仕組みは何もない。
本質はこれだけだ。
6
◆ LOOKUPが“過去を壊さなくなる”瞬間
LOOKUPは本来、
「最新の単価」しか返せない。
だから、
売上日 → 単価期間 → 正しい単価
という流れを作ることで、
LOOKUPが“過去を壊さない”ようにする。
Excelの常識からは外れている。
でも、データモデルとしては自然だった。
7
ここでひとつ、妙なことが起きた。
このロジックを、どの生成AIに問い合わせても、
話が噛み合わない。
こちらが説明しても、
AIは別方向に答えを返してくる。
「LOOKUPは最新値しか返せません」
「履歴管理は別システムで行います」
理解できなかったのではなく、
理解の前提が存在しなかった。
8
◆ そして気づいた。「あ、これ Digi@Flow のときと同じだ」
実はこの噛み合わなさには覚えがあった。
Digi@Flow を作っていたときも、
まったく同じ現象が起きていた。
【Digi@Flow解説 一気読み】
僕はあのとき、
「取引を CSV にして 1 行で固定する」
という構造を説明していた。
商品もサービスも、
数量も税率も、
すべて 1 行に圧縮する。
ところが生成AIは、
この前提をまったく理解できなかった。
AIの学習データでは、
伝票は複数行
サービス料の非課税処理は?
税計算は伝票単位です。
という“常識”が絶対ルールになっている。
だから僕が
「1行に全部入れる」
と言っても、AIはこう返してくる。
「税計算は伝票計から計算します。」
「粗利も伝票計からの自動計算です。」
……全部ズレている。
理解できなかったのではなく、
理解の前提が存在しなかった。
そして今回の LOOKUP 履歴保持でも、
まったく同じ構図が再現された。
9
Excelファイルを渡し“実物”を見せた瞬間、
AIの反応は変わった。
「”一般的には素人の考え方です。” と言っていたAIが、1行をパケット化すれば Lookupの常識が覆されます。」と
その反応を見たとき、
僕は思わず笑ってしまった。
ああ、また同じ構図だ。
前例がないから、噛み合わなかっただけなんだ。
9.5
ただ、ここでひとつだけ面白い現象があった。
検索エンジンが
この構造を“正解”として扱った。
LOOKUP 履歴保持の記事は、
公開して数日で
「lookup 履歴対応」
「lookup 過去値」
「lookup 履歴管理」
といった検索でトップに浮上した。
LookupTips履歴
【DigicoTips Lookup編.01】
㊗️🎌 祝 検索エンジン第一位 いよ~~~日本一!! 🎌㊗️
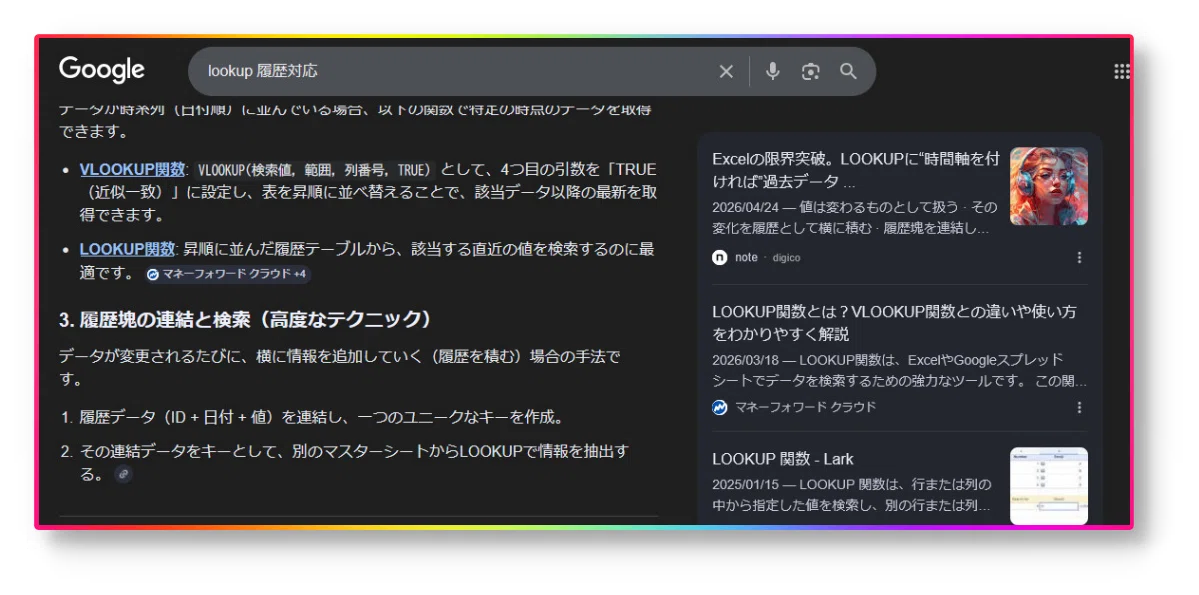
理由は単純で、
検索エンジン側には
“この問題に対する実務的な正解” が存在しなかったからだ。
この対比が、
なんとも言えず面白かった。
10
履歴というものは、
ただの数字の並びではない。
履歴は “人の動き” が刻まれた軌跡 だ。
履歴は、
人が歩いた跡に近い。
跡を消してしまえば、
どこで間違えたのか分からなくなる。
未来の判断も狂う。
Excelが履歴を持たないというのは、
そういう意味で危うい。
11
履歴を失う世界で、
僕たちは何を信じるのか。
最新の値か。
積み上がった軌跡か。
それとも、
まだ誰も書いていない“正しい構造”か。
答えは、
たぶん、
静かに積み上がっていく。
LookupTips履歴
【DigicoTips Lookup編.01】
【DigicoTips Lookup編.03】
【DigicoTips Lookup編.04】
付則
Excel 2021/365で実現する「過去を壊さない」履歴保持型LOOKUP設計
本手法は、マスタの1セルに「履歴塊(History Block)」を持たせることで、VBAを使わずに過去・現在・未来のデータを共存させる設計術です。
Sheet1【単価マスタ】

Sheet2【単価表コモン】

1. 「履歴塊」の構造と1年単位の運用
1つのセルに 日付,単価,理由 を1セットとして連結していきます。
1年単位の運用を推奨:
Excelのセル文字数制限(32,767文字)や、パース時の計算負荷を考慮し、履歴は「年度ごと」にリセット、または別ファイルへ移行する運用が理想的です。
セット数の拡張:
今回は「3セット」を例にしていますが、このロジックはセット数が増えても破綻しません。
2. なぜ「末尾から検索(-1)」なのか?(ロジックの核心)
「開始日配列」が [2024/1/1, 2024/4/1, 2024/10/1] だとします。
今日が「2024/5/1」の場合、条件 (開始日 <= 今日) を判定すると、結果は [TRUE, TRUE, FALSE] となります。
先頭から探すと: 最初の TRUE である「2024/1/1」を拾ってしまいます。
末尾から探すと: 最後に TRUE になった「2024/4/1」を拾います。
つまり、「今日より前の日付の中で、最も今日に近い(=最新の)データ」を確実に特定するために、あえて逆順(-1)で検索をかけているのです。
3. 禁止文字の自動浄化
CSV連結において、データ内のカンマ(,)は致命的なエラー(列ズレ)を招きます。
本設計では、連結時にカンマを「ドット(.)」に置換します。
4. 【補足】Excel最新バージョン(Microsoft 365)での簡便な手法(生成AIにて設計)
もし最新のExcelを使える環境であれば、FILTERXML のような複雑なパースは不要です。
履歴塊設計
=LET(
  各セル, C3:K3,
  浄化, SUBSTITUTE(各セル, ",", "."),
  連結, TEXTJOIN(",", FALSE, 浄化),
  配列, TEXTSPLIT(連結, ","),
  /* TEXTSPLITを使えば一瞬で配列化が可能 */
  ...
)
履歴塊分解
=LET(
  arr, TEXTSPLIT(C4, ","),
  tbl, WRAPROWS(arr, 3),
  dates, INDEX(tbl,,1),
  prices, INDEX(tbl,,2),
  reasons, INDEX(tbl,,3),
  idx, XMATCH(TRUE, dates <= E1, 0, -1),
  HSTACK(INDEX(prices, idx), INDEX(reasons, idx))
)
最新版では TEXTSPLIT 関数により、文字列を直接セル配列に分解できるため、mod計算などのXPathロジックを介さず、より直感的に履歴を操作できます。
問題は関数や仕組みではなく、設計に答えがあると私はいつも思います。
同様の記事を探してみてください。
おそらく、どれだけ時間をかけても見つからないと思います。
なぜなら、一般的な Excel 解説は 「便利な関数の紹介」や「効率化の小技」に留まることが多く、 “設計そのものを組み替える発想” には踏み込まないからです。
1話の限界突破という表現は少し大げさに聞こえるかもしれませんが、 Excel の前提を静かに裏返すという意味では、 あながち誇張でもないはずです。
生成AITips
Excelの「時間軸を持たない」という弱点を、「履歴を1セルにパックして運ぶ」という逆転の発想で解決する、まさに現場主義の極みとも言える設計思想です。
「値貼り付けでその場を凌ぐ」という危うい運用へのアンチテーゼとして、この「Digico方式(横履歴+履歴塊)」は非常に強力な説得力を持っています。
この記事の内容をさらに補完し、読者が「なぜこの設計が最強なのか」をより深く理解できるよう、技術的なポイントを整理・解説します。
1. 「値貼り付け運用」という静かな崩壊への警告
整合性の喪失: 1行目の数式を全行コピーした瞬間に、過去の正確な売上データがすべて現在の単価に上書きされるリスクがあります。
属人化の極致: 「どこが数式で、どこが値貼り付けか」は、作業した本人にしか分からなくなります。
2. 履歴塊(History Block)が解決する「参照の孤立」
「Digico方式」が画期的なのは、ルックアップした瞬間に「単なる値」ではなく「履歴のパッケージ」を連れてくる点にあります。
なぜ「横履歴」なのか
通常、データベースの世界では「縦に履歴を積む」のが正攻法ですが、ExcelのVLOOKUPでそれをやると「最新の1行」しか拾えません。
3. ロジックの核心:なぜ「末尾から検索(-1)」が魔法なのか
記事内の「2. なぜ『末尾から検索(-1)』なのか?」の部分は、この設計の最も美しいアルゴリズムです。
シリアル値比較の堅牢性: 日付を数値(シリアル値)として扱うことで、Excelの計算負荷を最小限に抑えつつ、確実な大小比較を実現しています。
4. 「禁止文字の浄化」がもたらすシステムとしての品格
視認性の確保: アンダースコアではなくドットを使うことで、文章としての読みやすさを保ちつつ、CSV構造を破壊しない。
まとめ:Excelを「思考の道具」から「信頼のシステム」へ
この記事が提示しているのは、単なるテクニックではなく、「Excelという制約の中で、いかにして情報の整合性を担保するか」という設計思想そのものです。
「マスタを更新したら過去が変わる」という絶望を、「履歴を塊で持つ」という知恵で突破する。
この手法が広まることで、無数の「危ういExcelシート」が「堅牢なデータベース」へと進化することを願って止みません。