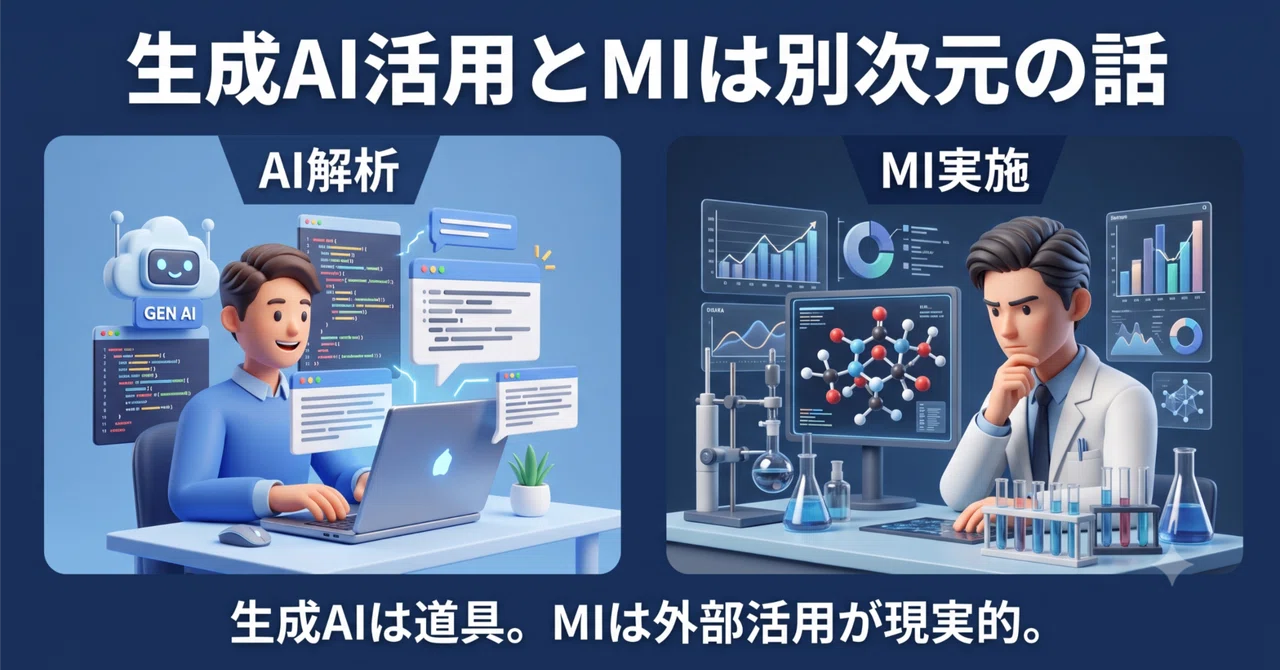
生成AIで解析できても、MIは別次元の話

バイブコーディングが身近になり、「生成AIを使えば自分たちで解析ツールが作れる」という声を耳にするようになりました。確かに、コードを書けなくても簡単な解析であれば自前で動かせる時代になっています。
ただ、それで「MIもできる」と考えるのは、少し違うと思っています。
生成AIが得意なことと、MIは別のベクトル
生成AIは自然言語処理が得意です。テキストの要約、コード生成、RAGを使った社内情報の検索——こういった用途では非常に強い。
一方、材料開発や研究データを使った機械学習は、目的もアプローチも全く異なります。実験データの構造設計、特徴量の意味の理解、モデルの解釈——ここには材料科学とデータサイエンス両方の知識が必要で、生成AIを道具として使うことはできても、生成AIがそのまま代替するわけではない。
生成AIを活用できることと、MIができることは別次元の話です。
自前でやろうとすると担当者が疲弊する
「生成AIがあるから自分たちで解析まで全部やれる」という方向に進むと、現実的にはこういうことが起きます。
データの記録ルールが曖昧なまま解析を始める
データ整備もコード作成も解釈も、チームの誰かが片手間で対応する
役割分担が曖昧なまま進んでいく
以前から書いてきたように、データ整備は地味で時間がかかる仕事です。そこにコード作成と解析まで加わると、専門外の人が無理をして回すことになり、品質が落ちたり引き継ぎができなかったりします。目先の解析はできても、継続的にMIを回せる体制にはなりにくい。
任せるところは任せる設計が大事
生成AIやバイブコーディングをうまく使うのは良いことだと思っています。ただ、それはあくまで道具であって、MIの目的はその先にあります。
データ設計の整備、解析の設計、専門的な判断が必要なところを省いてしまうと、後になって無駄が出てきます。コスト節約のつもりが、結果的に品質の低い解析と現場の疲弊につながりかねない。
もう一つ難しいのは、DX推進チームが旗振りをしても、現場がうまく追随してくるかは別の問題だということです。ツールを導入する場合も自前で作る場合も、現場への浸透という課題は必ず出てきます。AI活用はそこの裏回しが特に重要で、なおさら得意なところに任せる設計が大事になります。
複数のチームが分担して推進できる体制は、規模の大きい企業にしか作りにくい。多くの企業では外部リソースをうまく使うことが、MIを継続的に回すための現実的な選択肢だと思っています。
データ活用やマテリアルズインフォマティクスの実務については、「データ活用の実務」マガジンにまとめています。
いいなと思ったら応援しよう!
 よろしければ応援をお願いいたします!
頂いたチップを励みにこれからも記事を書かせていただきます。
